Mit CometAPI entwickelnEine API für mehrere Modelle erforderlich?Teste den Workflow im Playground und erstelle anschließend einen API-Schlüssel, sobald Modell und Kosten zu deinem Anwendungsfall passen.
Gemini API Free Tier 2026: Kostenlose Modelle, Limits & Preisleitfaden
Sehen Sie, welche Gemini API-Modelle im Jahr 2026 kostenlos sind, verstehen Sie die Grenzwerte für RPM, TPM und RPD, erhalten Sie einen Leitfaden zur Python-Einrichtung und zur Abrechnung, vergleichen Sie die Preisgestaltung von Google mit CometAPI.
Der Gemini-API-Free-Tier ist im Oktober 2026 für ausgewählte Modelle verfügbar, darunter Gemini 3.8 Flash, Gemini 3.6 Flash, Gemini 3.5 Flash-Lite und Gemini 3.1 Flash-Lite. Sie können ohne Abrechnungseinrichtung starten, aber das Ihrem Projekt zugewiesene Kontingent bestimmt, wie viel Sie tatsächlich ausführen können.
Beginnen Sie mit Gemini 3.8 Flash für anspruchsvolle Coding- und Reasoning-Experimente oder mit einem Flash-Lite-Modell für Routine-Extraktion und -Klassifikation. Prüfen Sie vor dem Einsatz echter Kundendaten die geltenden Datennutzungsbedingungen. Wenn Sie kostenpflichtige Kapazität benötigen, vergleichen Sie Googles native Preise mit dem separat abgerechneten Zugriff über CometAPI.
Wichtigste Punkte
Gemini 3.8 Flash ist die neueste hier abgedeckte Flash-Option, mit multimodaler Eingabe und anpassbarem Reasoning-Aufwand.
Gemini 3.6 Flash bleibt für bestehende Integrationen eine unterstützte Option; Gemini 3.5 Flash-Lite und Gemini 3.1 Flash-Lite zielen auf leichtere Workloads.
Weiterlernen
Diesen Artikel mit der nächsten Entscheidung verknüpfen.
Auf Klarheit, Quellenangabe und aktuelle API-Terminologie geprüft.
Gemini 4 Argon erfordert kostenpflichtigen API-Zugriff. Eine kostenlose Verfügbarkeit in einem anderen Google-Produkt begründet keine kostenlose API-Berechtigung.
Quoten in AI Studio prüfen. Das Kontextfenster eines Modells unterscheidet sich vom Anfragen- und Token-Kontingent Ihres Projekts.
Zugriffswege vergleichen. Googles Free-Quota und CometAPIs Preise, Credits und Kontolimits sind voneinander getrennt.
Ist die Gemini API im Jahr 2026 kostenlos?
Google bietet kostenlose Eingabe- und Ausgabe-Token für ausgewählte Gemini-API-Modelle, vorbehaltlich projektspezifischer Quoten. Sie können starten, ohne die Abrechnung zu aktivieren. Es handelt sich um einen quotas-basierten Free-Tier und nicht um ein einmaliges Promotion-Guthaben.
Wichtig ist die Unterscheidung, dass Google AI Studio, die Gemini API und private Gemini-Abos separate Zugangswege sind. Ein in einer Oberfläche verfügbares Modell ist nicht automatisch auch in einer anderen kostenlos zugänglich.
Welche Gemini-API-Modelle sind im Oktober 2026 kostenlos?
Die vier folgenden Modelle sind sinnvolle Ausgangspunkte für Text- und multimodale Anwendungen. Sie sind keine vollständige Liste aller kostenlos berechtigten Endpunkte. Folgen Sie den Modellenlinks für den CometAPI-Zugriff; die Google-Spezifikationen sind unter der Tabelle verlinkt.
Modell
Modell-ID
Praktischer Startanwendungsfall
Gemini 3.8 Flash
gemini-3.8-flash
Komplexes Codieren, Reasoning und toolgestützte Workflows
Gemini 3.6 Flash
gemini-3.6-flash
Bestehende Flash-Anwendungen und allgemeine Automatisierung
Gemini 3.5 Flash-Lite
gemini-3.5-flash-lite
Dokumenten-Parsing und leichte Agentenaufgaben
Gemini 3.1 Flash-Lite
gemini-3.1-flash-lite
Klassifizierung, Übersetzung und einfache Extraktion
Alle vier akzeptieren Text-, Bild-, Video-, Audio- und PDF-Eingaben und geben Text aus. Das veröffentlichte Eingabelimit liegt bei 1,048,576 Token, mit bis zu 65,536 Ausgabe-Token. Diese Modellgrenzen garantieren nicht, dass Ihr Free-Tier-Projekt eine Anfrage in dieser Größe senden kann.
Audio, Embeddings und Bildgenerierung: Zugriff und Limits
Google führt auch kostenlosen Zugriff für ausgewählte Spezialmodelle auf, z. B. Gemini 3.8 Live, Gemini 3.8 Flash TTS und Gemini Embedding 2. Prüfen Sie den Pricing-Eintrag für das genaue Modell und den Endpunkt, bevor Sie integrieren: Das Verstehen eines Bilds oder Audioclips ist eine andere Fähigkeit als das Generieren eines Bilds oder einer Sprachausgabe.
API-Methoden, Anfrageformate und Limits variieren je nach Fähigkeit. Prüfen Sie die Dokumentation für das spezifische Modell und die beabsichtigte Operation.
Kostenloser Zugriff erstreckt sich nicht auf jedes Gemini-Modell oder jeden Generierungs-Endpunkt. Gemini 4 Argon erfordert kostenpflichtigen Gemini-API-Zugriff, während Premium-Endpunkte für Bild- und Videoerzeugung eigene Berechtigungsregeln haben. Bevor Sie eine Funktion integrieren, prüfen Sie das exakte Modell und die Operation, statt anzunehmen, dass sie dasselbe Free-Tier-Kontingent teilen.
Wie schneidet Gemini 3.8 Flash ab?
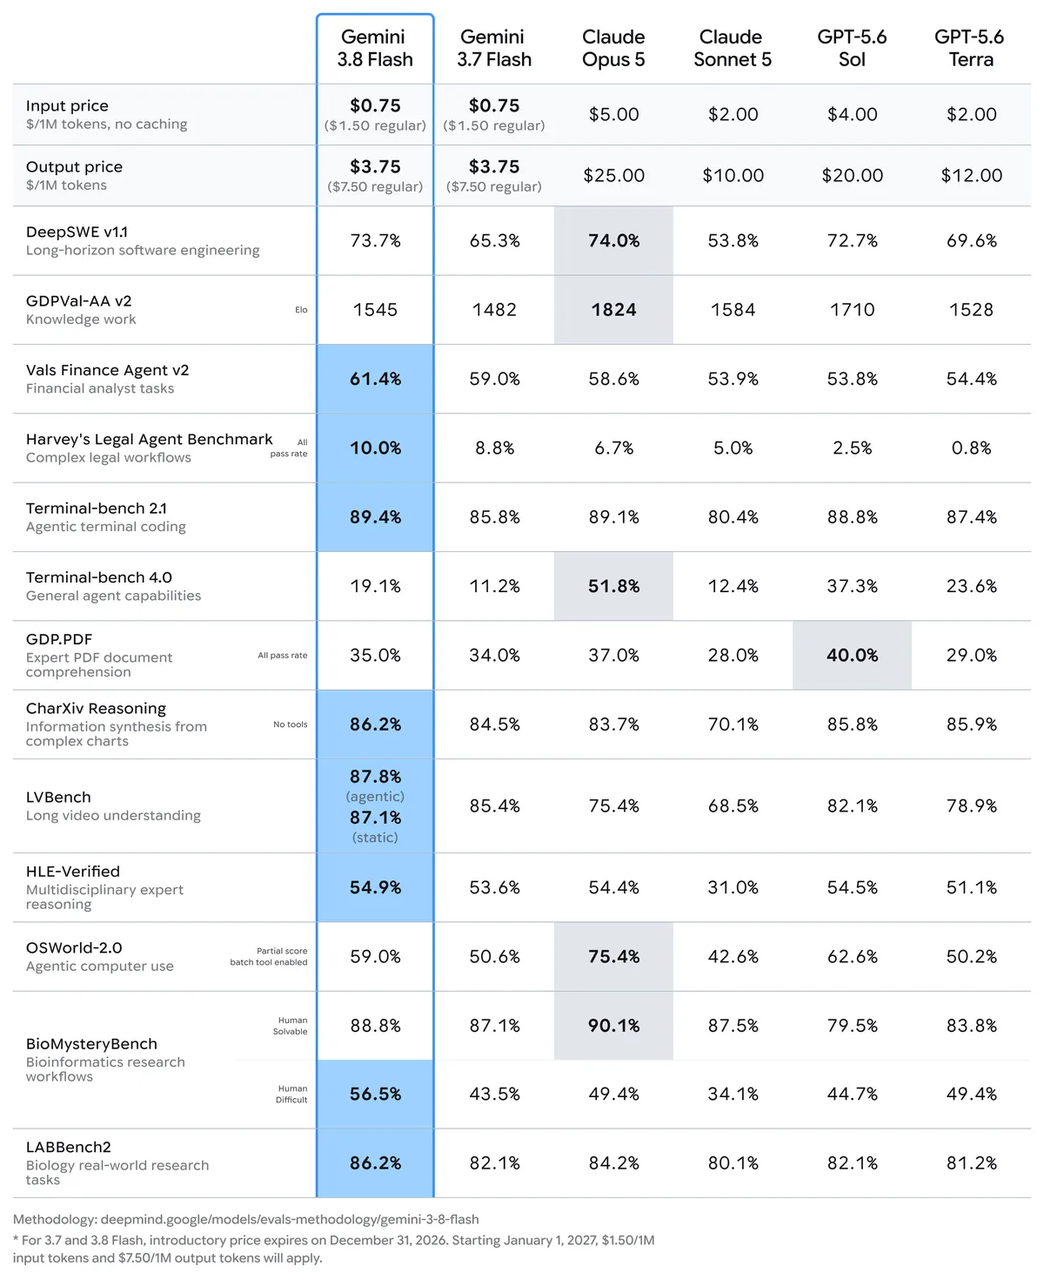
Googles veröffentlichte Auswertung vergleicht Gemini 3.8 Flash mit Gemini 3.7 Flash und anderen Modellen. Berichtet werden 73,7% auf DeepSWE v1.1 gegenüber 65,3% für 3.7 Flash — ein Anstieg um 8,4 Prozentpunkte. Auf HLE-Verified steigt der berichtete Score von 53,6% auf 54,9%.
Nutzen Sie diese Ergebnisse, um ein Modell für Tests auszuwählen, und evaluieren Sie es dann anhand von Beispielen aus Ihrer eigenen Anwendung. Für einen Dokumenten-Extractor sind korrekte Felder und stabiles Ausgabeformat unter Umständen wichtiger als ein Coding-Benchmark. Für einen Coding-Assistenten messen Sie, ob die vorgeschlagene Änderung funktioniert, wie lange sie dauert und wie viele Token sie verbraucht.
Welche Rate Limits gelten 2026 im Gemini-API-Free-Tier?
Der größte Irrtum über das Free-Tier von Gemini ist, dass jedes Konto dieselbe feste Anzahl an Anfragen erhält.
Öffnen Sie Google AI Studio, wählen Sie das Projekt hinter Ihrem API-Schlüssel und prüfen Sie die aktiven Limits für Ihr gewähltes Modell. Googles Leitfaden zu Rate Limits erklärt die Quotendimensionen; das Dashboard zeigt die für Ihr Konto geltende Zuteilung.
RPM (requests per minute): Begrenzt, wie viele Anfragen Sie pro Minute senden können. Achten Sie auf kurze Bursts und parallele Worker, die zu viele Anfragen auf einmal senden.
TPM (input tokens per minute): Begrenzt das Volumen der Eingabe-Token pro Minute. Große Prompts, Gesprächshistorien und Dokumente verbrauchen dieses Kontingent auch bei niedriger Anfragenzahl.
RPD (requests per day): Begrenzt Ihre gesamte tägliche Anfragenzahl. Planen Sie Ihren Workload anhand des täglichen Kontingents und seiner Reset-Zeit.
Ein Eingabelimit von einer Million Token beschreibt die maximal unterstützte Eingabegröße des Modells. Es garantiert nicht, dass ein Free-Tier-Projekt über genügend TPM-Kapazität verfügt, um eine Million Token in einer einzelnen Anfrage zu übermitteln. Kontextkapazität und Rate-Limit-Kapazität müssen getrennt bewertet werden.
Tägliche Anfragekontingente werden um Mitternacht Pacific Time zurückgesetzt. Mehrere Schlüssel in einem Projekt teilen sich dessen Nutzungslimits; das Erstellen eines weiteren Schlüssels erhöht die Kapazität nicht. Weitere Limits können für Spezialmodelle oder -operationen gelten.
Umgang mit Gemini-API-429-Fehlern
Lesen Sie den Fehlertext, bevor Sie erneut versuchen. In der aktuellen Interactions API kann ein 429 zwischen einem kurzfristigen Anfragen- oder Token-Limit und einem erschöpften Tageskontingent unterscheiden. Bei einem kurzfristigen Limit drosseln Sie die Queue und verwenden exponentielles Backoff mit Jitter. Bei täglicher Erschöpfung warten Sie auf den Reset oder ändern den Kapazitätsplan der Anwendung. Ein 503 signalisiert stattdessen vorübergehende Dienstnichtverfügbarkeit. Siehe Googles API-Fehlerreferenz.
Wie vergleichen sich die Preise von Google und CometAPI?
Wann die Abrechnung der Gemini API beginnt
Das Ausschöpfen Ihres kostenlosen Kontingents schaltet Ihr Projekt nicht automatisch auf kostenpflichtige Nutzung um. Ohne aktives Abrechnungskonto stoßen Anfragen, die das verfügbare Free-Tier überschreiten, auf Zugriffs- oder Kapazitätsbeschränkungen statt auf Standardkosten für bezahlte Token.
Für kostenpflichtige Kapazität müssen Sie die Abrechnung verknüpfen. Wenn Ihrem Konto ein Prepaid-Tarif zugewiesen ist, müssen Sie zudem Guthaben aufladen, beginnend bei $5 oder dem lokalen Gegenwert. Prüfen Sie Ihren zugewiesenen Tarif und Ausgabensteuerungen in AI Studio, bevor Sie upgraden. Salden und Verbrauchsabrechnung können mit Verzögerung aktualisiert werden; ein angezeigtes Prepaid-Guthaben ist kein sofortiger Ausgabenstopp.
Googles $300 Cloud-Willkommensguthaben ist vom Gemini-API-Free-Tier getrennt. Konten, die nach dem 2. März 2026 eröffnet wurden, können dieses Guthaben nicht für Gemini-API- oder AI-Studio-Gebühren verwenden. Prüfen Sie den Abrechnungsleitfaden für die für Ihr Konto geltenden Regeln.
Tokenpreise bei Google und CometAPI
Die Tabelle vergleicht Googles Standard-Tokenpreise mit den veröffentlichten Modellpreisen von CometAPI, geprüft am 26. Oktober 2026. Alle Beträge sind USD pro eine Million Token; die Ausgabe enthält abrechenbares Reasoning, soweit zutreffend. Googles kostenlose Eingabe und Ausgabe gilt nur für berechtigte Anfragen innerhalb des Projektkontingents.
Modell
Google kostenlose Eingabe/Ausgabe
Google kostenpflichtige Eingabe / Ausgabe
CometAPI Eingabe / Ausgabe
Gemini 3.8 Flash
Kostenlos
$0.75 / $3.75
$0.60 / $3.00
Gemini 3.6 Flash
Kostenlos
$0.75 / $3.75
$0.60 / $3.00
Gemini 3.5 Flash-Lite
Kostenlos
$0.30 / $2.50
Aktuelles Katalogangebot prüfen
Gemini 3.1 Flash-Lite
Kostenlos
$0.25 / $1.50
$0.20 / $1.20
Gemini 4 Argon
Nicht verfügbar
$2.00 / $10.00
$1.60 / $8.00
Die obigen Einführungspreise für Flash bei Google enden am 31. Dezember 2026; 3.8 Flash und 3.6 Flash steigen dann auf $1.50 Eingabe und $7.50 Ausgabe. Argons Einführungspreis endet am 30. November 2026, danach gelten $4 Eingabe und $20 Ausgabe. CometAPI-Raten sollten separat geprüft werden, wenn sich diese Promotions ändern. Tools, Caching, Storage, Steuern und andere Dienste können zusätzliche Kosten verursachen.
Ein kleines Workload-Beispiel
Angenommen, Sie senden 1,000 Textanfragen, jeweils mit 2,000 Eingabe-Token und 500 Ausgabe-Token. Das sind zwei Millionen Eingabe-Token und eine halbe Million Ausgabe-Token. Zu den oben genannten Tarifen kostet Gemini 3.8 Flash über Google $3.375 (rund $3.38) und über CometAPI $2.70. Eine berechtigte Google-Free-Tier-Last kostet $0 nur, wenn sie in die verfügbaren Quoten passt. Dies sind Token-Kostenschätzungen, keine gemessenen Rechnungen.
Wie starten Sie mit dem Gemini-API-Free-Tier?
Sie benötigen ein berechtigtes Google-Konto und eine Region, einen API-Schlüssel sowie Python mit verfügbarem pip. Das folgende Beispiel folgt Googles aktuellem Getting-Started-Leitfaden und verwendet die Interactions API.
Schlüssel erstellen und SDK installieren
Kopieren oder erstellen Sie in Google AI Studio einen API-Schlüssel für ein Projekt, das keine kostenpflichtige Abrechnung aktiviert hat. Installieren Sie das SDK und setzen Sie dann den Schlüssel in Ihrer Terminal-Umgebung. Bewahren Sie den Schlüssel auf Ihrem Server auf, statt ihn im Browsercode einzubetten.
pip install -U google-genai
Unter macOS oder Linux:
export GEMINI_API_KEY="your_api_key"
In Windows PowerShell:
$env:GEMINI_API_KEY="your_api_key"
Eine Anfrage senden und das Ergebnis prüfen
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="Explain vector databases in 100 words."
)
print(interaction.output_text)
Speichern Sie dies als Python-Datei und führen Sie sie in derselben Umgebung aus. Eine erfolgreiche Anfrage druckt eine kurze Erklärung. Prüfen Sie anschließend das Nutzungs-Dashboard in AI Studio, um Projekt und Modell zu bestätigen, die den Traffic erhalten. Falls es fehlschlägt, prüfen Sie den Fehlercode und verifizieren Sie Schlüssel, Modellzugriff, Quoten und Abrechnungsstatus, bevor Sie den Code ändern.
Wie können Entwickler über CometAPI auf Gemini-API-Modelle zugreifen?
CometAPI bietet einen separaten Zugangsweg für unterstützte Gemini-Modelle und andere KI-Anbieter.
Wählen Sie diesen Weg, wenn eine gemeinsame Schnittstelle über Anbieter hinweg Ihre Anwendung vereinfacht. Verwenden Sie einen CometAPI-Schlüssel mit dessen Endpunkt und prüfen Sie anschließend die unterstützte Modell-ID und Kontolimits. Googles Free-Quota wird nicht auf diesen Dienst übertragen. Das folgende Beispiel verwendet die OpenAI-kompatible Schnittstelle, dokumentiert von CometAPI.
pip install -U openai
Setzen Sie COMETAPI_KEY in Ihrer Umgebung mit derselben shellspezifischen Methode wie oben und führen Sie dann aus:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)
response = client.chat.completions.create(
    model="gemini-3.8-flash",
    messages=[{
        "role": "user",
        "content": "Summarize the benefits of RAG."
    }]
)
print(response.choices[0].message.content)
Bestätigen Sie vor dem Deployment, dass die beabsichtigte Modell-ID von Ihrem CometAPI-Konto unterstützt wird. Google-native Bezeichner und anbieterspezifische Aliasse stimmen nicht für jedes Modell garantiert überein.
Welche Datenschutzbeschränkungen gelten für das Gemini-API-Free-Tier?
Unter Googles Gemini-API-Zusatzbedingungen dürfen Prompts und Ausgaben unentgeltlicher Dienste zur Verbesserung von Google-Produkten verwendet werden, und menschliche Prüfer können sie einsehen. Übermitteln Sie keine sensiblen, vertraulichen oder personenbezogenen Informationen an unentgeltliche Dienste. Kostenpflichtige API-Dienste haben andere Datenverwendungsbedingungen.
Regionale Regeln sind wichtig: Datenverwendungsbestimmungen für kostenpflichtige Dienste gelten für bestimmte unentgeltliche Nutzung im EWR, in der Schweiz und im Vereinigten Königreich, aber die Bereitstellung eines API-Clients für Nutzer in diesen Regionen erfordert Paid Services. Das sind getrennte Bedingungen. Prüfen Sie vor dem Release die aktuellen Bedingungen für Ihre Nutzer und den Einsatzort.
Wie optimieren Sie die Nutzung des Gemini-API-Free-Tier?
Bauen Sie um das gemessene Kontingent herum. Halten Sie einen kleinen Satz repräsentativer Aufgaben vor und protokollieren Sie Aufgabenerfolg, Latenz, Eingabe- und Ausgabe-Token sowie Retries. Ändern Sie dann jeweils nur einen Teil des Workloads:
Nach Schwierigkeit routen. Testen Sie Flash-Lite bei routinemäßiger Extraktion und verwenden Sie ein größeres Modell nur dort, wo es das Ergebnis verbessert.
Eingabe beschneiden. Senden Sie den relevanten Dokumentabschnitt und die notwendige Gesprächshistorie statt wiederholt alles erneut zu senden.
Generierung steuern. Fordern Sie eine zweckmäßige Ausgabelänge an und passen Sie den Reasoning-Aufwand nur dort an, wo Modell und API dies unterstützen.
Arbeit wiederverwenden. Speichern Sie wiederkehrende Anwendungsergebnisse und prüfen Sie modellspezifische Caching-Berechtigung, statt kostenloses API-Caching vorauszusetzen.
Parallelität budgetieren. Halten Sie Worker hinter einer gemeinsamen Queue, damit unabhängige Aufgaben keinen vermeidbaren Burst erzeugen.
Überwachen Sie schließlich Qualität ebenso wie Verbrauch. Ein günstigeres Modell, das häufig scheitert oder mehrere Versuche benötigt, kann mehr Arbeit verursachen als ein etwas teureres Modell, das beim ersten Mal gelingt.
Eine nützliche interne Bewertungskennzahl lautet:
Effektive Kosten pro erfolgreicher Aufgabe = Gesamte Inferenzkosten / Anzahl erfolgreicher Aufgaben
Für Free-Tier-Experimente ist eine zusätzliche operative Kennzahl erfolgreiche Aufgaben pro verfügbarem Quotafenster.
FAQ
Wie kann ich erkennen, ob ein Quotenproblem durch Anfragen-Bursts oder große Dokumente verursacht wird?
Vergleichen Sie die Zeitstempel der Fehler mit Anfragenzahl und Eingabe-Token-Volumen. Ein Burst kurzer Prompts deutet auf Anfragenfrequenz hin; einige lange Dokumente können die Token-Kapazität auch bei niedrigen RPM erschöpfen. Prüfen Sie in der Interactions API den maschinenlesbaren Fehlercode und unterscheiden Sie tägliche Kontingenterschöpfung von einem kurzfristigen Limit. Protokollieren Sie Tokenverbrauch und Worker-Parallelität gemeinsam, damit Sie den relevanten Teil der Queue ändern können.
Was soll ich tun, wenn eine Anfrage nach dem Absenden in einen Timeout läuft?
Ein Timeout sagt nicht immer, ob eine Remote-Operation abgeschlossen wurde. Prüfen Sie für eine Interaktion, für die Sie eine ID haben, deren Status, bevor Sie eine weitere teure Aufgabe starten. Geben Sie Ihrem Workflow eine anwendungsweite Task-ID und deduplizieren Sie nachgelagerte Aktionen, insbesondere E-Mails, Datenbankschreibvorgänge und Tool-Aufrufe. Ein Retry der Textgenerierung sollte nicht stillschweigend eine Geschäftsaktion wiederholen. Die Interactions-Dokumentation von Google beschreibt Interaktionsabruf und Ausführungszustände.
Wie sollte ich Flash und Flash-Lite für die Dokumentenextraktion vergleichen?
Verwenden Sie dieselben Dokumente, erforderlichen Felder und Abnahmeregeln für beide Modelle. Beziehen Sie verrauschte Scans, fehlende Felder und mehrdeutige Werte ein. Bewerten Sie die faktische Feldgenauigkeit und die Gültigkeit der Ausgabe, zählen Sie dann Retries und manuelle Korrekturen. Ein Modell, das weniger Token produziert, kann dennoch mehr Aufwand verursachen, wenn seine Fehler eine weitere Anfrage erfordern. Halten Sie einen separaten Testsatz zurück, damit Prompt-Änderungen nicht nur an bereits getunten Beispielen bewertet werden.
Was sollte ich prüfen, bevor ich eine Anwendung von Google auf CometAPI umstelle?
Testen Sie den exakten Endpunkt, die Modell-ID, das Nachrichtenformat und die Features, die Ihre Anwendung nutzt. Eine kompatible Chat-Completions-Anfrage garantiert keine identische Unterstützung für Dateien, Tools, Caching oder Reasoning-Einstellungen. Vergleichen Sie zurückgegebene Usage-Felder und Fehlerbehandlung ebenso wie die Textantwort und prüfen Sie die Datenschutzrichtlinien des Intermediärs und des Upstream-Anbieters. Beginnen Sie mit einem kleinen, nicht sensiblen Workload, bevor Sie den restlichen Traffic umleiten.
Wie halte ich eine Integration stabil, während sich Modelle und Preise ändern?
Halten Sie Modell-IDs, Endpunkteinstellungen und Preisannahmen in der Konfiguration. Erfassen Sie Modell und Datum bei Evaluationsergebnissen, überwachen Sie Deprecation-Hinweise und führen Sie repräsentative Aufgaben noch einmal aus, bevor Sie ein Modell ändern. Setzen Sie Budgetwarnungen und prüfen Sie Promotionsraten, bevor sie enden. Halten Sie für essentielle Workloads einen getesteten Fallback bereit, statt sich darauf zu verlassen, dass ein Free-Quota oder ein bestimmter Modellalias unbegrenzt verfügbar bleibt.
Schlussfolgerung
Das Gemini-API-Free-Tier ist eine sinnvolle Möglichkeit, eine Anwendung zu validieren, bevor Sie für Kapazität bezahlen. Wählen Sie ein Modell für die Aufgabe, messen Sie das Ihrem Projekt verfügbare Kontingent und prüfen Sie die Datenbedingungen, bevor Sie Produktionsdaten verwenden.
Für ein erstes Experiment senden Sie eine kleine Anfrage und bestätigen Sie sie in AI Studio. Messen Sie anschließend einen repräsentativen Workload. Wird die freie Kapazität zum Engpass, vergleichen Sie Googles kostenpflichtige API mit CometAPI — mit denselben Prompts, Qualitätsanforderungen und vollständigen Tokenkosten.