Mit CometAPI entwickelnEine API für mehrere Modelle erforderlich?Teste den Workflow im Playground und erstelle anschließend einen API-Schlüssel, sobald Modell und Kosten zu deinem Anwendungsfall passen.
GLM-5.3 Flash ist für die meisten Produktions-Workloads die bessere Voreinstellung: Es ergänzt native visuelle Eingaben und ein 1M-Token-Kontextfenster, während sein Standardlistenpreis deutlich niedriger ist. GLM-5.3 bleibt die stärkere Wahl, wenn maximale Codetiefe, schwieriges Langzeit-Reasoning oder Cybersecurity-Leistung wichtiger sind als Stückkosten.
Dies ist keine „kleines Modell vs. großes Modell“-Geschichte. Flash ist ein 320B total/18B aktiv MoE, trainiert auf einer neuen multimodalen Basis mit hybrider sparsamer und linearer Attention. Das Flaggschiff ist ein , dessen GLM-5.3-Gewinne aus skaliertem Post-Training auf der GLM-5.2-Basis stammen.
Weiterlernen
Diesen Artikel mit der nächsten Entscheidung verknüpfen.
Wählen Sie Flash für multimodales Coding, Dokumentenverständnis, Browser- oder GUI-Agenten, hochvolumige Automatisierung und kostenkritische Anwendungen.
Wählen Sie das Flaggschiff für die härtesten Engineering-Aufgaben im Repository-Maßstab, tieferes toolgestütztes Reasoning und defensive Sicherheitsforschung.
Beide Modelle unterstützen 1M-Token-Kontext, Always-on-Reasoning, Function Calling, Streaming und Open-Weight-Bereitstellung.
In abgeglichenen, von Z.ai gemeldeten Benchmarks führt das Flaggschiff DeepSWE, NL2Repo, HLE mit Tools und Agents’ Last Exam; Flash führt AutomationBench, Toolathlon und GDPval-AA v2 an.
Unabhängige Tests geben dem Flaggschiff einen höheren Intelligence Index und schnellere Ausgabe, während Flash eine etwas bessere Zeit bis zum ersten Token und deutlich niedrigere Mischkosten aufweist.
GLM-5.3 Flash vs GLM-5.3 auf einen Blick
Dimension
GLM-5.3 Flash
GLM-5.3
Praktisches Ergebnis
Positionierung
Effizientes nativ-multimodales Coding- und Agentenmodell
Flaggschiff für Text-Reasoning, Coding, Long-Horizon-Agenten, Cybersecurity
Abhängig vom Workload
Modellgröße
320B total / 18B aktiv
744B total / 40B aktiv
Flash aktiviert 55% weniger Parameter
Basismodell
Neu trainierte 30T-Token-multimodale Basis
Gleiche Basis wie GLM-5.2; Gewinne durch Post-Training
Z.ai positioniert Flash als das erste native multimodale Modell der GLM-5-Serie. Es hat 320B Gesamtparameter und 18B aktive Parameter, aber „Flash“ sollte nicht als „klein“ verstanden werden. Das vollständige Checkpoint ist weiterhin ein sehr großes Modell; seine Effizienz entsteht durch die Aktivierung einer kleineren Expertenteilmenge und eine neu gestaltete Attention-Architektur.
Sein Basismodell wurde auf einem 30-Billionen-Token-multimodalen Korpus trainiert. Native Vision ist in die Coding-Schleife integriert, wodurch das Modell Screenshots, gerenderte Interfaces, Diagramme, Seitenlayouts und andere visuelle Rückmeldungen inspizieren kann, bevor es seine nächste Aktion verfeinert.
GLM-5.3 Flash Spezifikationen
Spezifikation
GLM-5.3 Flash
Entwickler
Z.ai / Zhipu AI
Modell-ID
glm-5.3-flash
Modelltyp
Natives multimodales Mixture-of-Experts
Gesamt- / aktive Parameter
320B / 18B
Schichten
45
Architektur
Hybride Sparse Attention + Linear Attention; mHC; MTP
Trainingskorpus
30T-Token multimodaler Pre-Training-Korpus
Eingabemodalitäten
Text und visuelle Eingaben, inkl. Bilder sowie unterstützte Video-/Datei-Workflows
Ausgabemodalität
Text
Kontext / maximale Ausgabe
1M / 128K Tokens
Reasoning
Immer aktiviert; low, high, max effort
Tools
Function Calling, Streaming-Toolcalls, strukturierte Workflows
Gewichte / Lizenz
Open Weights; Apache-2.0 im offiziellen Repository
Das Flaggschiffmodell ist für komplexe Softwareentwicklung, Long-Horizon-Agenten und Cybersecurity optimiert. Z.ai sagt, es nutzt das gleiche Basismodell wie GLM-5.2; das Upgrade kommt aus skaliertem Post-Training statt einem neuen Pre-Training-Lauf.
Das offizielle Repository listet das Checkpoint mit 744B Gesamtparametern und 40B aktiv. Im Vergleich zu Flash aktiviert es pro Token mehr als doppelt so viele Parameter und weist schwierigen mehrstufigen Reasoning-Aufgaben mehr Kapazität zu.
GLM-5.3 Spezifikationen
Spezifikation
GLM-5.3
Entwickler
Z.ai / Zhipu AI
Modell-ID
glm-5.3
Modelltyp
Flaggschiff-Text-Mixture-of-Experts-Modell
Gesamt- / aktive Parameter
744B / 40B
Basismodell
GLM-5.2 Basis; alle GLM-5.3-Gewinne aus Post-Training
Eingabe / Ausgabe
Text / Text
Kontext / maximale Ausgabe
1M / 128K Tokens
Reasoning
Immer aktiviert; low, high, max effort
Tools
Function Calling, Streaming-Toolcalls, Context Caching, strukturierte Ausgabe
Dies sind Architekturebene-Vergleiche, keine garantierten End-to-End-Latenz-Multiplikatoren. Die reale API-Geschwindigkeit hängt auch von Hardware, Quantisierung, Batching, Reasoning-Länge, Serving-Software und Provider-Auslastung ab.
Hybride Attention-Architektur von GLM-5.3-Flash und Vergleich von Rechenaufwand/KV-Cache bei langem Kontext.
Quelle: Offizielle Architektur-Dokumentation von Z.ai
Benchmark-Leistung: Wo jedes Modell gewinnt
Der sauberste Vergleich trennt vom Anbieter gemeldete Aufgabenbenchmarks von unabhängigen API-Messungen. Selbst wenn die Benchmark-Namen übereinstimmen, können Harness-Versionen, Tool-Konfigurationen, Kontextmanagement und Reasoning-Aufwand variieren. Die Tabelle unten nutzt die am besten abgeglichenen Werte in der Flaggschiff-Evaluierung und der Flash-Evaluierung und betrachtet kleine Abweichungen als richtungsweisend statt endgültig.
Benchmark
GLM-5.3 Flash
GLM-5.3
Höherer Wert
Was getestet wird
Terminal-Bench 2.1
84.3
88.2
GLM-5.3
Terminal- und agentisches Coding
DeepSWE v1.1
63.4
66.9
GLM-5.3
Software-Engineering
NL2Repo
56.3
58.0
GLM-5.3
Repository-Generierung
Toolathlon Verified
78.4
73.0
Flash
Toolnutzung
AutomationBench
48.8
48.2
Beinahe Gleichstand / Flash
Computer-Use-Automatisierung
Agents’ Last Exam
26.3
28.5
GLM-5.3
Long-Horizon-Agenten-Reasoning
HLE mit Tools
55.3
62.5
GLM-5.3
Schwieriges toolgestütztes Reasoning
GDPval-AA v2
1773 Elo
1769 Elo
Beinahe Gleichstand / Flash
Professionelle Wissensarbeit
Quellen: Flaggschiff-Evaluierung und Flash-Evaluierung. Vergleich richtungsweisend, da Evaluierungs-Setups variieren können.
Programmierung und Repository-Engineering
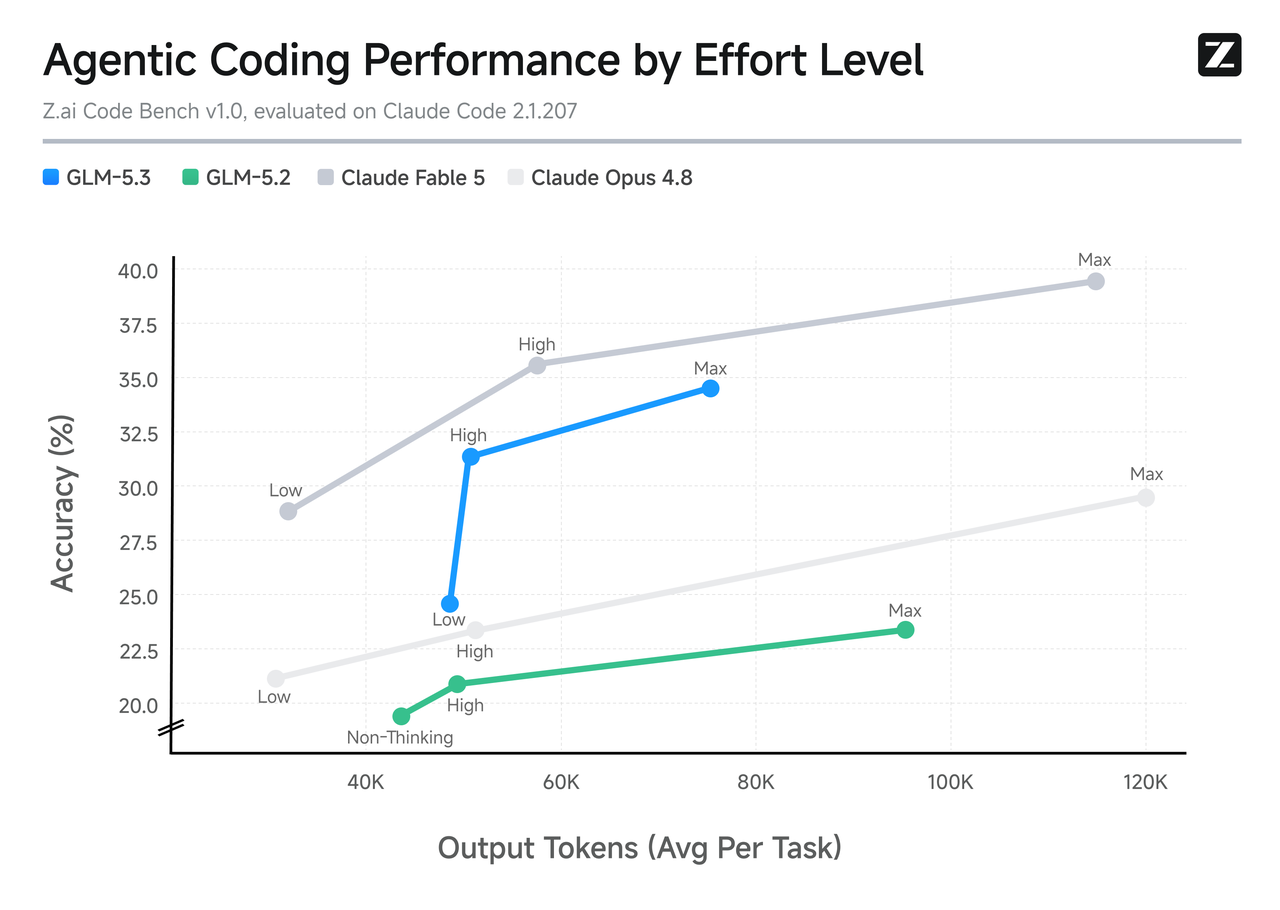
Das Flaggschiff hat die höhere Leistungsgrenze. Es liegt 3.5 Punkte vor Flash bei DeepSWE und 1.7 Punkte bei NL2Repo. Auf dem Z.ai Code Bench v1.0, mit beiden Modellen evaluiert unter Claude Code 2.1.207, erreicht das Flaggschiff 34.5% bei maximalem Aufwand, während Flash 29.0% erreicht — ein Vorsprung von 5.5 Punkten.
Flash bleibt dennoch wettbewerbsfähig genug, um als erstes Modell für Routine-Repository-Wartung, Testgenerierung, Debugging, Refactoring und hochvolumige Coding-Agenten ausprobiert zu werden. Eskalieren Sie nur die härtesten Aufgaben oder fehlgeschlagenen Trajektorien an das Flaggschiff.
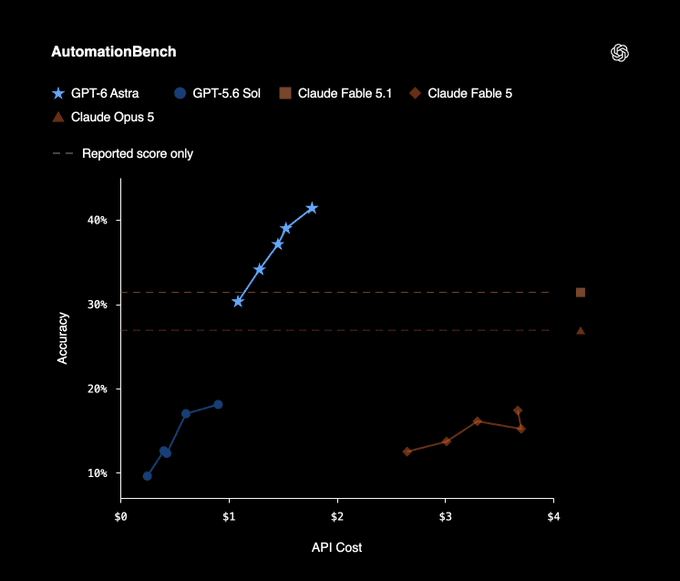
Z.ais Sechs-Benchmark-Evaluierung von GLM-5.3-Flash und anderen Coding-/Agenten-Modellen.
Quelle: Offizielle Flash-Dokumentation von Z.ai
Agentische Coding-Genauigkeit und Ausgabetoken-Verbrauch von GLM-5.3 über Reasoning-Aufwandsstufen hinweg.
Quelle: Offizielle Flaggschiff-Dokumentation von Z.ai
Toolnutzung, Automatisierung und Wissensarbeit
Flash ist nicht durchgängig schwächer. Es erzielt 78.4 auf Toolathlon Verified gegenüber 73.0 beim Flaggschiff und liegt bei AutomationBench mit 48.8 zu 48.2 knapp vorn. Bei GDPval-AA v2 ist es praktisch gleichauf. Das macht Flash besonders attraktiv, wenn die Aufgabe weniger aus einer extrem schwierigen Reasoning-Kette besteht und mehr aus der zuverlässigen Koordination von Tools über viele kostengünstige Anfragen.
Unabhängige Intelligenz, Geschwindigkeit und Latenz
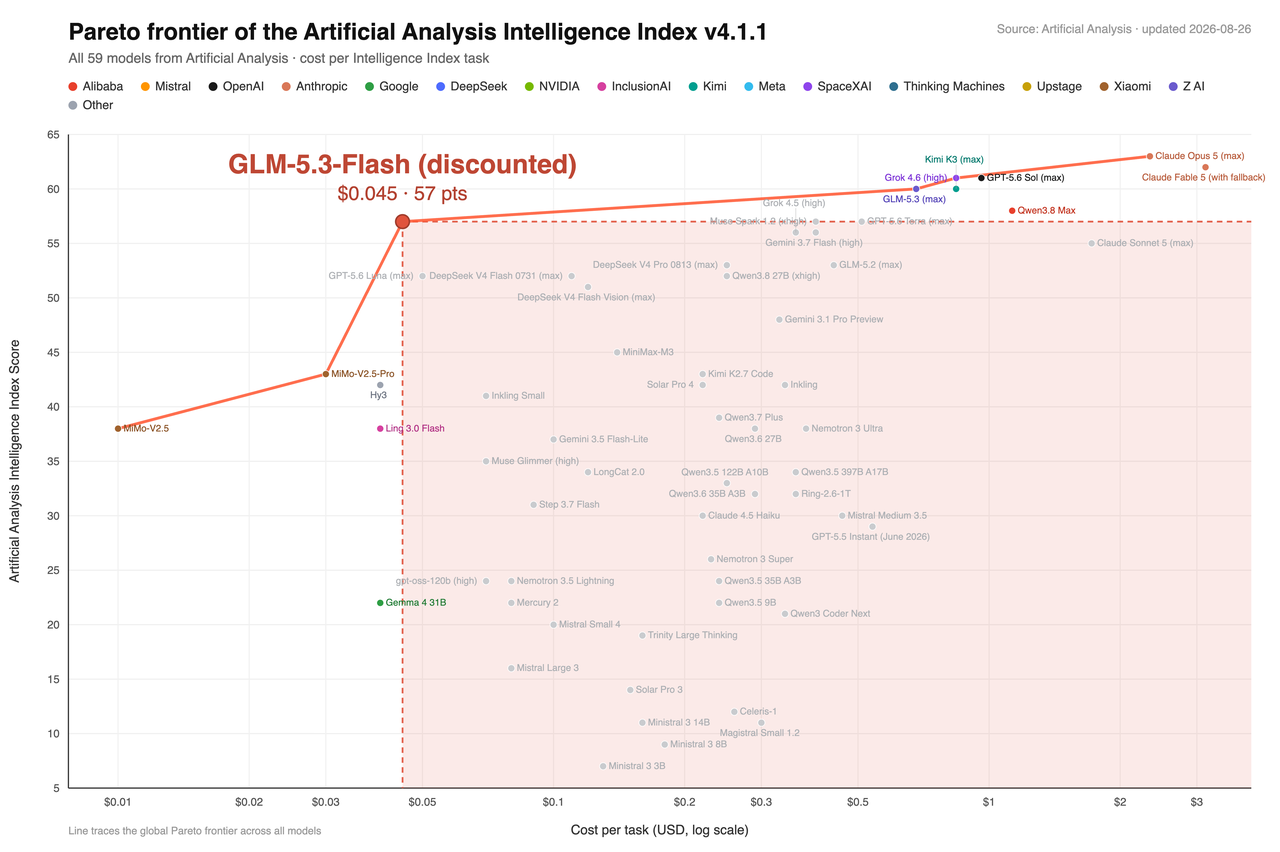
Das unabhängige Ergebnis ergänzt eine wichtige Korrektur zur Annahme „Flash bedeutet schneller“. Flash antwortet etwas früher, aber der getestete Flaggschiff-Endpunkt generiert Tokens schneller, sobald die Ausgabe beginnt. Betrachten Sie diese Messungen als anbieterspezifische Momentaufnahmen, nicht als unveränderliche Modelleigenschaften.
Kosten–Intelligenz-Frontier von Artificial Analysis, reproduziert in Z.ais offizieller Flash-Dokumentation.
Quelle: Offizielle Flash-Dokumentation von Z.ai
Multimodalität: Flash hat den klaren Vorteil
Flash akzeptiert visuelle Eingaben und integriert sie in agentische Workflows. Es kann Screenshots, Seitenbilder, Diagramme, Interface-Zustände, Bildschirmaufnahmen und unterstützte Dateien inspizieren und die visuellen Belege beim Coding oder der Toolbedienung nutzen. Das Flaggschiff unterstützt derzeit nur Texteingaben.
Frontend und Design-to-Code: Flash kann einen Referenz-Screenshot inspizieren und die gerenderte Implementierung validieren.
Dokument- und Office-Workflows: Flash kann über Seitenstruktur, Diagramme, Layout und Bildplatzierung schlussfolgern.
Browser- und Computerbedienung: Flash kann visuellen Zustand mit Toolcalls und iterativen Korrekturen kombinieren.
Text-only Repository-Arbeit: Das Flaggschiff ist vorzuziehen, wenn die Eingabe aus Code und Text besteht und maximale Reasoning-Tiefe erforderlich ist.
Langer Kontext und Reasoning-Steuerung
GLM-5.3 Flash unterstützt ein 1M-Token-Kontextfenster und bis zu 128K Ausgabetokens; GLM-5.3 bietet die gleichen Grenzen. Beide halten Reasoning aktiviert und akzeptieren die Stufen low, high und max. Z.ai empfiehlt max für schwieriges Coding und die Reproduktion von Benchmarks.
Die Kontextkapazität ist daher nicht der Hauptunterschied. Der Unterschied liegt darin, wie wirtschaftlich jedes Modell lange Sequenzen bedient und wie viel Reasoning-Kapazität es bei den härtesten Aufgaben aufbringen kann. Flash ist architektonisch günstiger bei langem Kontext; das Flaggschiff hat die stärkere Qualitätsobergrenze.
Cybersecurity: GLM-5.3 ist der Spezialist
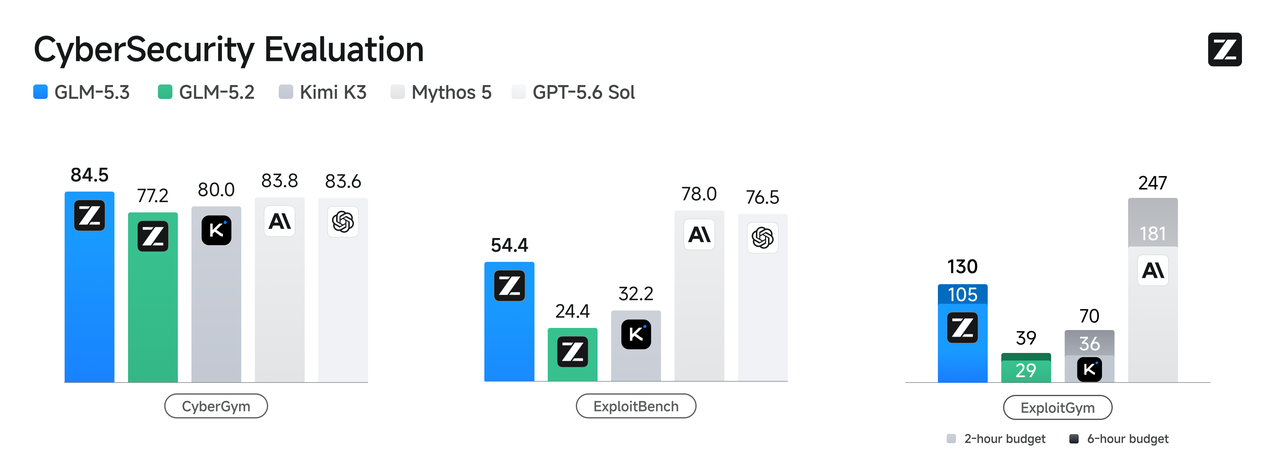
Cybersecurity ist die markanteste Fähigkeit des Flaggschiffs. Z.ai berichtet 84.5 auf CyberGym und 54.4 auf ExploitBench. Unter normalisierten Budgets von zwei bzw. sechs Stunden wurden 105 bzw. 130 ExploitGym-Aufgaben abgeschlossen.
Flash hat keinen entsprechenden Launch-Fokus oder eine passende öffentliche Cyber-Suite. Für Code-Review, sichere Entwicklung und autorisierte Schwachstellenfindung verwenden Sie das Flaggschiff als Primärmodell und behalten menschliche Freigabe, isolierte Tools, Audit-Logs und Offenlegungsprozesse im Workflow.
GLM-5.3-Leistung über Benchmarks zur Schwachstellenentdeckung und Exploit-Ketten.
Quelle: Offizielle Cybersecurity-Dokumentation von Z.ai
Kosten und Bereitstellung
API-Preise
Z.ai listet Flash mit $0.15 pro Million Eingabetokens und $0.50 pro Million Ausgabetokens vor Aktionen, verglichen mit $1.40 und $4.40 für das Flaggschiff.
Zugangsweg
Flash Eingabe
Flash gecached
Flash Ausgabe
5.3 Eingabe
5.3 gecached
5.3 Ausgabe
Z.ai Standardliste
$0.15
$0.03
$0.50
$1.40
$0.26
$4.40
Z.ai Aktionspreis für Flash
$0.075
$0.015
$0.25
$1.40
$0.26
$4.40
CometAPI-Route
$0.06
Live-Route prüfen
$0.20
$1.12
Live-Route prüfen
$3.528
Preise in USD pro 1M Tokens. Quellen: Z.ai Preisangaben, Flash-Route und GLM-5.3-Route. Aktionen können sich ändern.
Beispielhafte Monatskosten
Für einen Workload mit 100M Eingabetokens und 20M Ausgabetokens ergeben die aktuellen CometAPI-Raten geschätzte $10.00 für Flash gegenüber $182.56 für das Flaggschiff, vor Cache-Effekten oder Tool-Gebühren. Flash reduziert die Token-Rechnung in diesem Beispiel um etwa 94.5%.
Flash ist einfacher zu serven als das Flaggschiff, aber kein Consumer-GPU-Modell. Das 320B-Checkpoint, multimodale Komponenten, KV-Cache und 1M-Kontext erfordern weiterhin ernsthafte Infrastruktur. Self-Hosting ist besonders attraktiv, wenn Datenkontrolle, kundenspezifisches Serving oder dauerhaft hohe Auslastung die Betriebskosten rechtfertigen.
Welches Modell sollten Sie wählen?
Wählen Sie GLM-5.3 Flash, wenn?
Sie Bild-, Screenshot-, Diagramm-, Dokument-, Browser- oder GUI-Verständnis benötigen.
Sie hochvolumige Coding-Agenten, Forschungs-Workflows oder Business-Automatisierung betreiben.
Sie starke Toolnutzung und Wissensarbeitsleistung zum niedrigsten Tokenpreis wollen.
Sie ein 1M-Kontextfenster brauchen, aber nicht bei jeder Anfrage Flaggschiff-Ökonomie möchten.
Sie Self-Hosting planen und 320B/18B praktischer ist als 744B/40B.
Wählen Sie GLM-5.3, wenn?
Sie die härtesten Repository-Scale-Coding- oder Long-Horizon-Engineering-Aufgaben lösen.
Ihre Evaluierung tieferes Reasoning höher gewichtet als niedrige Stückkosten.
Sie das stärkere Ergebnis auf DeepSWE, HLE mit Tools oder Agents’ Last Exam benötigen.
Sie autorisierte defensive Sicherheits- oder Schwachstellenerkennungs-Workflows aufbauen.
Eine höhere Erfolgsquote die ungefähr ordnungsmäßige Token-Prämie ausgleichen kann.
Entscheidungsmatrix nach Anwendungsfall
Workload
Empfohlenes Startmodell
Warum
Hochvolumiger Chat und Automatisierung
GLM-5.3 Flash
Deutlich geringere Kosten; starke Toolnutzung
Visuelles Coding und UI-Debugging
GLM-5.3 Flash
Native visuelle Eingabe
Dokument-, Diagramm- und Office-Analyse
GLM-5.3 Flash
Multimodale professionelle Workflows
Routine-Repository-Wartung
Mit Flash beginnen
Fehlgeschlagene oder ungewöhnlich harte Aufgaben eskalieren
Schwieriges Repository-Scale-Engineering
GLM-5.3
Höhere Coding-Decke
Long-Horizon-Forschung mit Tools
GLM-5.3
Stärkeres HLE-mit-Tools-Ergebnis
Defensive Sicherheit und Schwachstellensuche
GLM-5.3
Dediziertes Cyber-Training und Benchmarks
Kostenempfindliches Self-Hosting
GLM-5.3 Flash
Kleinere aktive und Gesamt-Footprints
Unklarer gemischter Workload
Hybrides Routing
Flash als Standard; Flaggschiff-Eskalation
Eine bessere Produktionsstrategie: Routen, nicht ersetzen
Für die meisten Teams ist die stärkste Architektur keine exklusive Wahl. Verwenden Sie Flash als Standard-Route und eskalieren Sie nur Aufgaben mit hoher Komplexität, fehlgeschlagener Validierung, Sicherheitsrelevanz oder erwartetem wirtschaftlichem Wert, der die Flaggschiff-Prämie rechtfertigt.
Senden Sie visuelle, Routine- und hochvolumige Aufgaben an Flash.
Messen Sie Akzeptanzrate, Tokens, Latenz, Toolfehler und menschliche Eingriffe.
Eskalieren Sie fehlgeschlagene oder risikoreiche Textaufgaben an das Flaggschiff.
Leiten Sie sicherheitsrelevante Arbeit über zusätzliche Autorisierung und Sandbox-Kontrollen.
Optimieren Sie auf Kosten pro akzeptiertem Ergebnis statt nur auf Benchmark-Rang oder Preis.
So testen Sie beide Modelle über CometAPI
CometAPI listet die GLM-5.3 Flash-Route und die GLM-5.3-Route hinter derselben OpenAI-kompatiblen Basis-URL. Erstellen Sie einen API-Schlüssel und führen Sie dann die gleiche Textaufgabe über beide Modell-IDs aus. Für einen fairen Test halten Sie Prompt, Reasoning-Aufwand, Tooldefinitionen, maximale Ausgabe und Akzeptanzkriterien konstant.
Python
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["glm-5.3-flash", "glm-5.3"]

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "user",
                "content": "Review this migration plan and identify its three highest-risk assumptions.",
            }
        ],
    )
    print(model, response.choices[0].message.content)
Für multimodale Evaluation verwenden Sie die Live-Flash-Routendokumentation, um das unterstützte Bild-Content-Schema zu verifizieren. Der Flaggschiff-Vergleich sollte ein textäquivalentes Setup nutzen, da es keine visuellen Eingaben akzeptiert.
Einschränkungen dieses Vergleichs
Mehrere Coding- und Agenten-Scores sind vom Anbieter gemeldet. Unabhängige Reproduktion kann andere Tools, Prompts und Inferenz-Settings verwenden.
Übereinstimmende Benchmark-Namen garantieren nicht immer identische Harness-Versionen oder Kontext-Management-Strategien.
Reduktionen des Attention-Computes und KV-Caches auf Architekturebene sagen die API-Latenz nicht direkt voraus.
Preise, Aktionen, Modellverfügbarkeit, Ratenlimits und Routenfähigkeiten können sich ändern; prüfen Sie Live-Modellseiten vor dem Einsatz.
Open Weights machen keines der Checkpoints bei voller Kontextlänge günstig im Self-Hosting.
Cybersecurity-Fähigkeiten sind Dual-Use und erfordern Autorisierung, Sandboxen, Logging, Expertenreview und verantwortungsvolle Offenlegung.
Fazit
GLM-5.3 Flash ist die praktische Voreinstellung. Es erhält langen Kontext, ergänzt native Vision, performt stark bei Toolnutzung und professioneller Arbeit und verändert die Ökonomie so, dass deutlich breitere Einsätze möglich werden. GLM-5.3 ist das spezialisierte Eskalationsmodell: teurer, text-only, aber stärker bei den härtesten Aufgaben in Coding, Reasoning und Cybersecurity.
Das endgültige Urteil ist daher workloadbasiert: Starten Sie mit Flash, messen Sie die reale Akzeptanzrate und leiten Sie nur dann an das Flaggschiff weiter, wenn dessen zusätzliche Reasoning-Kapazität genügend zusätzliche erfolgreiche Ergebnisse liefert, um die Prämie zu rechtfertigen.
Häufig gestellte Fragen
Ist GLM-5.3 Flash besser als GLM-5.3?
Nicht universell. Flash ist besser bei Preis, Multimodalität und mehreren Tool-/Automatisierungsbenchmarks. Das Flaggschiff ist stärker bei den härtesten Coding-, toolgestützten Reasoning- und Cybersecurity-Workloads.
Ist GLM-5.3 Flash ein kleines Modell?
Nein. Es hat 320B Gesamtparameter und aktiviert 18B pro Token. Es ist effizienter als das 744B/40B-Flaggschiff, benötigt aber für Self-Hosting weiterhin beträchtliche Hardware.
Welches Modell ist günstiger?
Flash ist deutlich günstiger. Z.ais Standardlistenpreis liegt etwa bei einem Zehntel des Flaggschiff-Preises, und aktuelle CometAPI-Routen zeigen eine noch größere Lücke, solange Aktionspreise aktiv sind.
Welches Modell ist schneller?
Es hängt von Metrik und Anbieter ab. Artificial Analysis hat eine etwas geringere Zeit bis zum ersten Token für Flash gemessen, aber eine höhere Ausgabegeschwindigkeit für das Flaggschiff.
Welches Modell unterstützt Bilder?
Flash unterstützt native visuelle Eingaben. Das Flaggschiff unterstützt derzeit nur Texteingaben.
Unterstützen beide Modelle einen 1M-Token-Kontext?
Ja. Flash unterstützt 1M Kontext und bis zu 128K Ausgabe; das Flaggschiff bietet die gleichen Grenzen.
Welches Modell ist besser fürs Coding?
Verwenden Sie Flash für Routine- und hochvolumige Coding-Agenten. Nutzen Sie das Flaggschiff für die schwierigsten Engineering-Aufgaben im Repository-Maßstab oder wenn Fehlkosten den Preisunterschied übersteigen.
Welches Modell ist besser für Cybersecurity?
Das Flaggschiff. Z.ai hat es speziell für Schwachstellenerkennung und Exploit-Ketten-Reasoning trainiert und evaluiert. Verwenden Sie es nur in autorisierten, kontrollierten Umgebungen.
Können beide Modelle selbst gehostet werden?
Ja. Z.ais Repository listet herunterladbare Checkpoints und unterstützte Serving-Frameworks, aber beide bleiben große Infrastrukturprojekte.
Was ist die beste Bereitstellungsstrategie?
Verwenden Sie Flash als Standard-Route und eskalieren Sie schwierige, fehlgeschlagene oder sicherheitsrelevante Textaufgaben an das Flaggschiff. Messen Sie die Kosten pro akzeptiertem Ergebnis.
Am besten geeignet
Standard-Routing, multimodale Agenten, Skalierung
Höchstrisiko, komplexe Text- und Sicherheitsaufgaben