
TL;DR
GLM 5.4 ist ein Community-Name für einen möglichen Nachfolger in Z.ai’s GLM-Familie. Stand 14. Oktober 2026 begründen die für diesen Artikel geprüften offiziellen Modelldokumentationen und Release-Aufzeichnungen weder einen GLM‑5.4‑Launch noch ein Datenblatt oder eine API-Kennung. Union Alpha ist ein Gerüchthinweis, während ein Start im Oktober als taktbasierte Möglichkeit gilt. Die nützliche Frage ist, ob eine zukünftige Veröffentlichung die Zuverlässigkeit beim Codieren und die Kosten pro abgeschlossener Aufgabe verbessert; bestehende GLM-Modelle liefern dafür die Baseline.
Key Takeaways
- Release-Status: Die am 14. Oktober 2026 geprüften offiziellen Quellen bestätigen GLM‑5.4 nicht; es gibt kein festes Launch-Datum.
- Gerüchtslage: Die Verbindung von Union Alpha zu GLM‑5.4 ist unbestätigt, und die zitierte Übersicht verweist nicht auf einen ursprünglichen Attribution-Post.
- Leistungsbaseline: Bestehende GLM‑5.3‑Ergebnisse sind nützlicher Kontext, aber keine Messungen von GLM‑5.4.
- Architektur: GLM‑5.3‑Flash demonstriert eine andere Effizienz- und Multimodalitätsrichtung; ob GLM‑5.4 dies erbt, ist offen.
- Entwickler-Handlungsempfehlung: Jetzt verfügbare Modelle evaluieren und vor einem Upgrade verifizierte Modell-IDs, Kompatibilität und Task-Level-Messungen verlangen.
Has GLM 5.4 Been Released?
GLM 5.4 ist ein inoffizieller Name für einen potenziellen GLM-Nachfolger. Der offizielle Dokumentationsindex und die Release-Aufzeichnungen, die am 14. Oktober 2026 geprüft wurden, identifizieren bestehende GLM-Modelle, begründen jedoch keinen GLM‑5.4‑Produktrelease. Dies ist eine datierte Quellenprüfung, kein Beweis dafür, dass es keine private Entwicklung gibt.
Zwei dokumentierte Entwicklungspfade erklären, warum ein möglicher Nachfolger Aufmerksamkeit erregt.
Z.ai bestätigt, dass GLM‑5.3 das GLM‑5.2‑Basismodell wiederverwendet und seine Verbesserungen durch Post-Training erzielt. GLM‑5.3‑Flash verwendet dagegen eine neue multimodale Basis und eine hybride Attention-Architektur. Diese Fakten beschreiben bestehende Modelle, nicht ein offengelegtes GLM‑5.4‑Design.
Praktisch bedeutet das: Der eine Pfad verbessert ein bestehendes Modell durch zusätzliches Training, während der andere die Architektur neu entwirft, um Rechenkosten zu senken und neue Fähigkeiten zu unterstützen.
Ein zukünftiges GLM‑5.4 könnte auf beiden Richtungen aufbauen, doch es gibt noch nicht genügend Belege, um festzustellen, welchen Ansatz Z.ai wählen wird.
How Reliable Are the GLM-5.4 Rumors and Leaks?
Confirmed Information
Die bestätigte technische Baseline stammt von GLM‑5.3 und GLM‑5.3‑Flash, nicht von GLM‑5.4. Name, endgültige Spezifikationen, Veröffentlichungsdatum und Benchmark-Ergebnisse von GLM‑5.4 bleiben in den für diesen Artikel geprüften offiziellen Quellen unbestätigt.
Community Reports / Leaks
Ein X-Post vom 8. Oktober 2026 von @NFT_Chen (https://x.com/NFT_Chen/status/2108131637502628341) schreibt eine mögliche GLM‑5.4/5.5‑Entwicklungsrichtung Kommentaren von Tang Jie zu. Der Post beschreibt drei Skalierungsprioritäten: Ausbau des Pre-Trainings, Stärkung des Post-Trainings durch SFT, RLHF und RLVR sowie Erweiterung von Reasoning und Agentenausführung über schwierigere, längere Aufgaben.
Der Autor interpretiert die nächste Richtung als längere autonome Agenten und rekursive Selbstverbesserung (RSI). Dies ist ein Community-Bericht über einen Vortrag, keine Z.ai‑Release-Ankündigung. Versionsnamen und Entwicklungsbehauptungen bleiben dem Post zugeschrieben; sie begründen kein Launch-Datum, keine endgültige Architektur, keine Parameterzahl und keine nachgewiesene Selbstverbesserungsfähigkeit für GLM‑5.4.
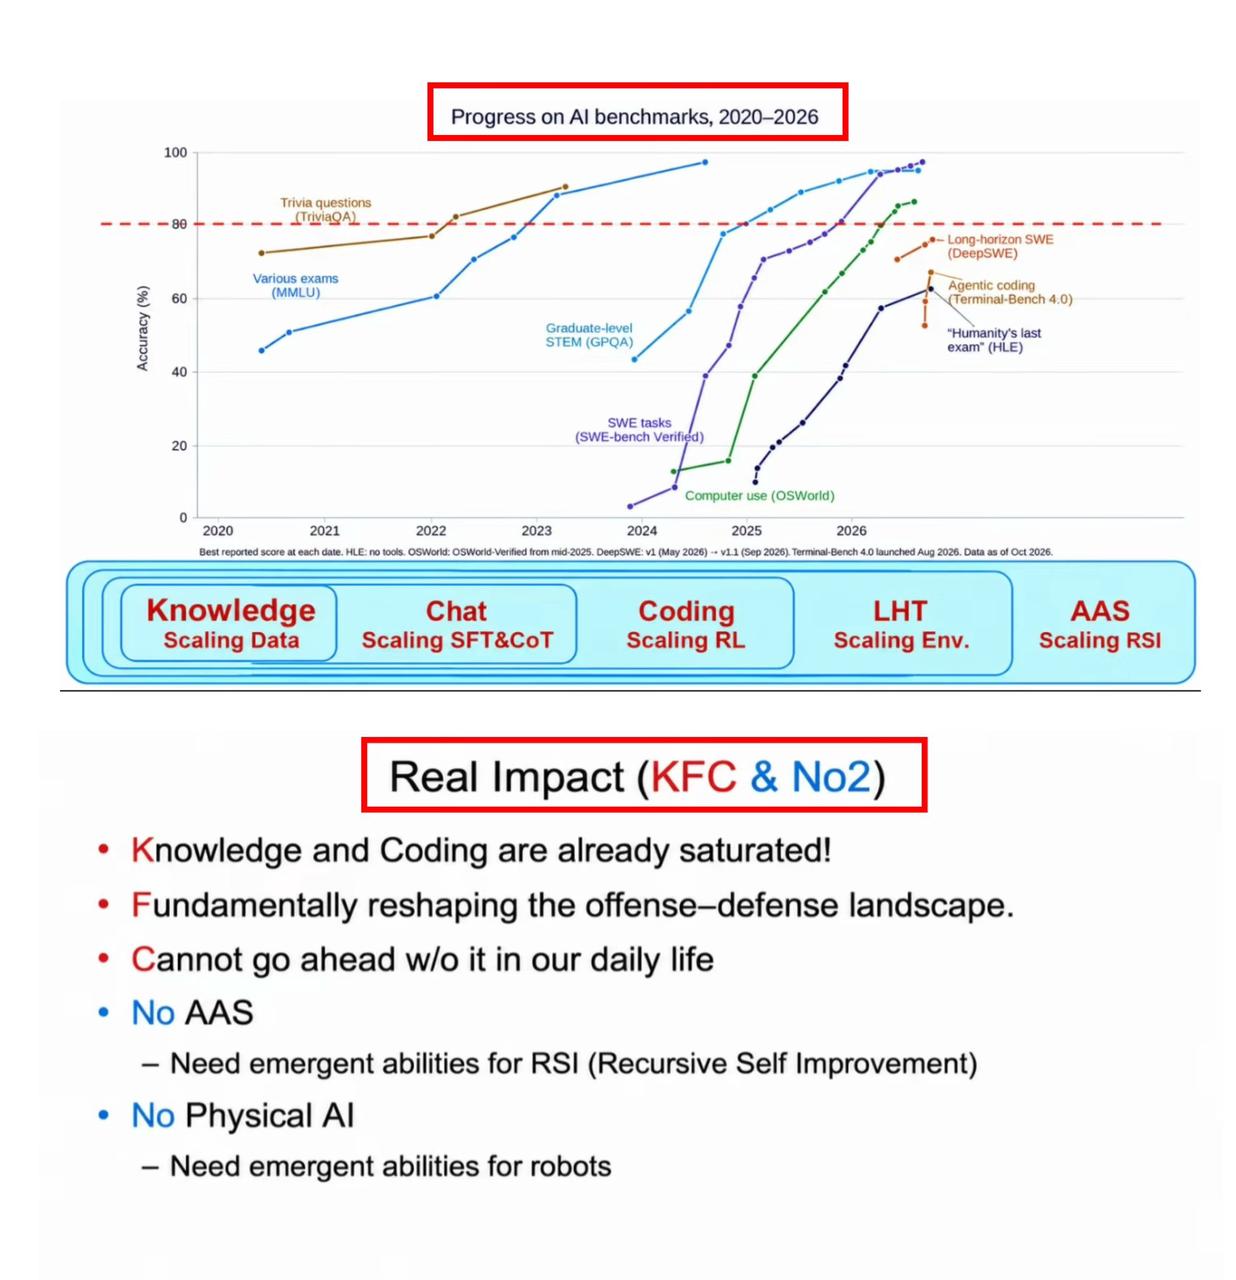
Präsentationsfolien-Bild, das dem ursprünglichen X-Post von @NFT_Chen vom 8. Oktober 2026 beigefügt ist. Es diskutiert Benchmark-Fortschritte und RSI als zukünftige Richtung; es ist kein GLM‑5.4‑Benchmarkbericht.
Foto des Vortrags, angehängt an den ursprünglichen X-Post von @NFT_Chen, 8. Oktober 2026.
Analysis
Eine nützliche Gerüchteanalyse fragt, welche Beobachtung die Schlussfolgerung ändern würde. Eine offizielle Modellkennung, eine Release-Ankündigung oder eine offengelegte Zuordnung von einem anonymen Alias würde den Fall materiell stärken. Ein ähnliches Namensmuster oder nur ein Veröffentlichungsintervall kann das nicht leisten. Ältere Spekulationen über andere zukünftige GLM‑Versionsnummern begründen keine Spezifikationen für GLM‑5.4.
When Could GLM 5.4 Be Released?
Z.ai’s Release-Note-Zeitachse verzeichnet GLM‑5 am 12. Februar, GLM‑5.1 am 7. April, GLM‑5.2 am 16. Juni, GLM‑5.3 am 18. August und GLM‑5.3‑Flash am 26. August 2026. Dies sind in den Release Notes erfasste Daten; sie sollten nicht mit jeder Forschungsankündigung oder Anbieter-Verfügbarkeitsdatum verwechselt werden.
Die ungefähr zweimonatige Progression der Hauptversionen macht Oktober zu einem sinnvollen analytischen Beobachtungsfenster. Sie begründet jedoch weder einen Oktober-Start noch einen spezifischen Tag oder gar den nächsten Versionsnamen. Ohne eine nachvollziehbare Prognosequelle und ihre Methodik würde eine exakte Vorhersage wie 20. Oktober oder 23. Oktober eine Präzision implizieren, die die Evidenz nicht trägt.
Ein späterer Start, ein anderer Name oder eine separate Produktvariante bleibt möglich. Entwickler sollten ihre Planung an derzeit verfügbaren APIs ausrichten statt an einem Kalenderschätzwert.
What Are GLM 5.4's Expected Specs?
Es gibt kein verlässliches GLM‑5.4‑Spezifikationsblatt. Statt Gerüchten zu Hardware und Modellparametern für ein unveröffentlichtes Produkt zu folgen, ist es aussagekräftiger, die neuesten dokumentierten GLM-Modelle zu vergleichen und festzustellen, was unbekannt bleibt.
| Specification | GLM-5.3 | GLM-5.3-Flash | GLM-5.4 |
|---|---|---|---|
| Release | August 18, 2026 | August 26, 2026 | Unannounced |
| Model foundation | GLM-5.2 base; further post-training | New multimodal base | Unknown |
| Architecture | MoE foundation | MoE; hybrid sparse-linear attention | Unknown |
| Context support | 1M documented API context | 1M | Unknown |
| Native multimodality | Text-only input | Text, image, video, and file inputs | Unknown |
| Primary emphasis | Coding, agents, cybersecurity | Efficiency, coding, multimodality | Unknown |
| Published benchmarks | Available | Available | Not available |
| Model weights | Released | Released | Not available |
Die Tabelle berichtet dokumentierte Fähigkeiten bestehender Modelle. Einträge zu GLM‑5.4 bleiben unbekannt, statt Werte von einem der Vorgänger zu übernehmen. Der Evaluationskontext eines Modells, das API-Kontextfenster und die maximale Ausgabelänge sind unterschiedliche Grenzen.
Die GLM‑5.3‑Flash‑Architekturübersicht berichtet 320B Gesamtparameter, 18B aktivierte Parameter und hybride Sparse-Linear-Attention. Dies sind offengelegte Flash-Spezifikationen und sollten GLM‑5.4 nicht zugeschrieben werden.
Agentisches Codieren als mögliche Upgrade-Richtung
Agentisches Codieren ist eine der glaubwürdigsten Richtungen, die man beobachten sollte. GLM‑5.3 hat bereits gezeigt, dass die Skalierung des Post-Trainings die Leistung bei mehrstufigen Engineering-Aufgaben erheblich verbessern kann. Die Entwickler betonten komplexe Repository-Arbeiten, längere Ausführungshorizonte und verbessertes, toolgestütztes Problemlösen.
Ein zukünftiges Modell könnte diese Fähigkeiten durch bessere Umgebungsinteraktion, zuverlässigere Planung und weniger fehlgeschlagene Tool-Aufrufe erweitern.
Die nützlichste Bewertung würde nicht einfach den Prozentsatz korrekt beantworteter Coding-Fragen messen. Sie würde messen, ob ein Agent komplizierte Aufgaben Ende-zu-Ende abschließen kann, einschließlich Debugging, Testen, Überarbeitung und Wiederherstellung nach Fehlern.
Effiziente multimodale Architektur als mögliche Richtung
GLM‑5.3‑Flash bietet einen architektonischen Referenzpunkt für die zukünftige Entwicklung, während keine geprüfte offizielle Quelle dessen Einsatz in GLM‑5.4 belegt.
Z.ai beschreibt ein multimodales Pre-Training-Korpus von 30T Tokens als Teil des effizienzorientierten Designs von GLM‑5.3‑Flash. Dies beschreibt den Trainingsdatenscale eines bestehenden Modells und ist keine Roadmap-Zusage für GLM‑5.4.
Die offizielle Flash-Übersicht berichtet 3.01× geringere Attention-Berechnung und 4.44× geringere KV-Cache-Anforderungen gegenüber GLM‑5.3 unter der angegebenen Vergleichsbasis. Dies sind Effizienzresultate auf Komponentenebene, keine garantierte Anwendungsbeschleunigung oder API-Verbilligung.
Dies sind bedeutsame technische Verbesserungen, doch es gibt keine Bestätigung, dass GLM‑5.4 dieselbe Architektur erben wird. Ein größeres Next-Gen-Modell könnte maximale Reasoning-Performance priorisieren, während eine separate Flash-Variante weiterhin Latenz und Kosten optimiert.
GLM 5.4 vs GLM-5.3 vs GLM-5.3-Flash
GLM-5.3 Benchmark-Basis
Die verfügbaren Benchmark-Daten unterstützen eine Analyse der Leistungstrajektorie von GLM‑5.3, nicht eine direkte Messung von GLM‑5.4. Die folgenden Werte sind von Z.ai gemeldete Bewertungen bestehender Modelle. Sie wurden für diesen Artikel nicht unabhängig reproduziert und messen GLM‑5.4 nicht. Jeder Benchmark verwendet seinen eigenen Aufgabensatz und seine eigene Bewertungsmethode; Punktedifferenzen dürfen nicht als gleichwertige Zugewinne über Aufgaben hinweg interpretiert werden.
| Benchmark and methodology | GLM-5.2 | GLM-5.3 | GLM-5.3-Flash | GLM-5.3 vs GLM-5.2 difference |
|---|---|---|---|---|
| Terminal Bench 3.0 | 4.6 | 28.3 | Not reported in the cited Flash comparison | +23.7 points |
| DeepSWE v1.1 | 46.2 | 66.9 | 63.4 | +20.7 points |
| AutomationBench v1.0.6 | 26.2 | 48.2 | 48.8 | +22.0 points |
| CyberGym | 77.2 | 84.5 | Not reported in the cited Flash comparison | +7.3 points |
| ExploitBench | 24.4 | 54.4 | Not reported in the cited Flash comparison | +30.0 points |
| HLE with Tools | 54.7 | 62.5 | 55.3 | +7.8 points |
| GDPval-AA v2 | 1508 | 1769 | Not reported in the cited Flash comparison | +261 Elo |
| Toolathlon Verified | 59.9 | Not reported in the cited GLM-5.3 comparison | 78.4 | Not available |
Die kombinierte Tabelle stellt die Ergebnisse bestehender Modelle nebeneinander; sie enthält keine Messwerte für GLM‑5.4. Ein nicht gemeldeter Wert ist kein Nullscore. Behalten Sie die Evaluationsbedingungen jedes Benchmarks im Blick, und behandeln Sie GDPval-AA‑Differenzen als Elo statt als Prozentpunkte.
Methodik: DeepSWE v1.1 verwendet mini-swe-agent, Temperatur 0.95, top_p 1.0, einen Timeout von sechs Stunden und 400K Kontext. AutomationBench verwendet v1.0.6. HLE with Tools verwendet Temperatur 1.0, top_p 0.95, ein Generationslimit von 163.840 Tokens und ein Kontextlimit von 300K mit Kontextmanagement. GDPval-AA v2 verwendet eine Elo-Skala, daher ist die Differenz kein prozentualer Zugewinn.
Für CyberGym und ExploitBench berichtet Z.ai Claude Code 2.1.207 mit maximalem Reasoning-Aufwand, ohne Web-Tools, Temperatur 1.0, top_p 1.0 und einem Ausgabelimit von 128.000 Tokens. CyberGym berichtet pass@1 in einem einzelnen Durchlauf über 1.507 Aufgaben mit unbegrenztem Timeout pro Aufgabe. ExploitBench nutzt bis zu 300 Interaktionsrunden und mittelt die Abdeckung über 41 Aufgaben über drei Revisionen. Die Fußnoten in der Model-Card liefern die benchmark-spezifischen Umgebungsdetails.
Flash-Methodik: DeepSWE verwendet mini-swe-agent, 400K Kontext und einen Timeout von sechs Stunden; AutomationBench verwendet v1.0.6. Toolathlon Verified berichtet pass@1 gemittelt über drei unabhängige Durchläufe über den offiziellen Evaluationsservice. HLE verwendet die oben beschriebenen Sampling- und Kontextmanagement-Einstellungen. Siehe die Flash-Model-Card-Methodik. Diese Benchmark-Ergebnisse begründen keine Produktionslatenz oder -kosten.
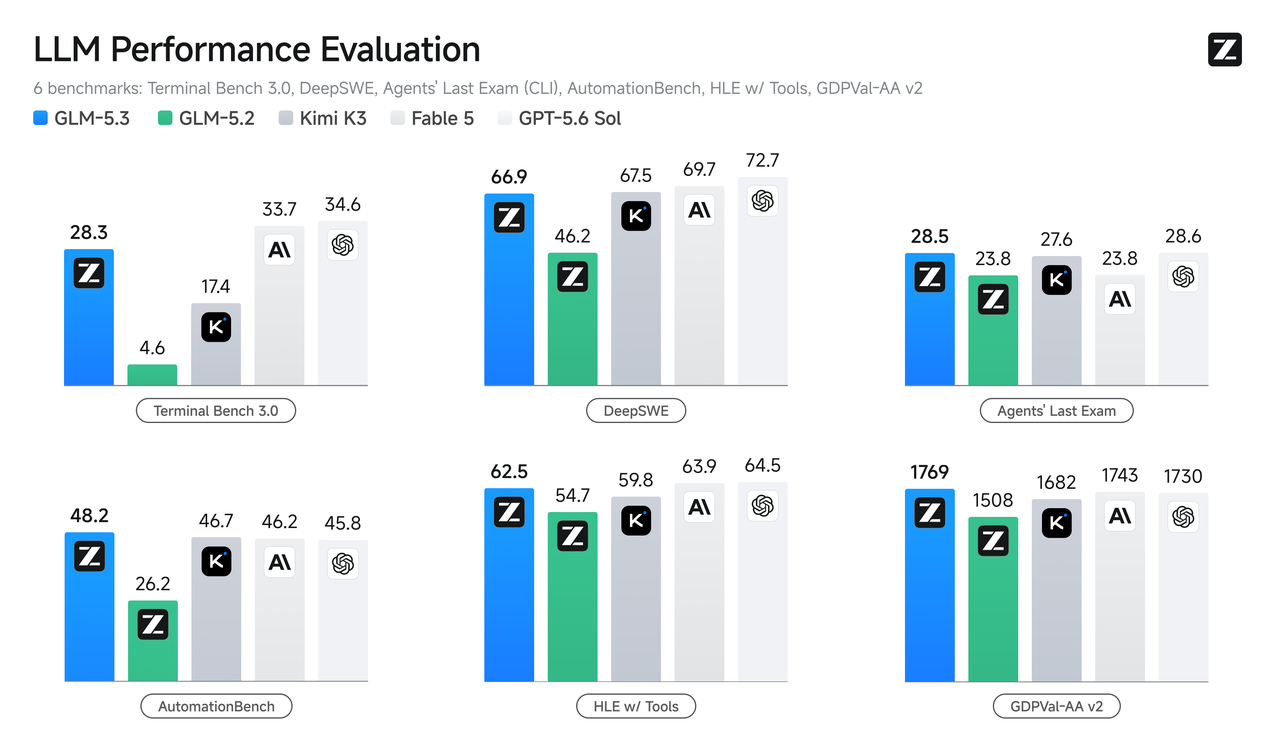
Offizielle GLM‑5.3‑Performancegrafik, reproduziert aus Z.ai’s Benchmark-Ankündigung. Die Abbildung zeigt Bewertungen von Vorgängermodellen; sie enthält keine GLM‑5.4‑Ergebnisse.
Die größten Verbesserungen erscheinen bei Aufgaben, die eine anhaltende Interaktion mit einer Umgebung erfordern. Terminal Bench 3.0 stieg von 4.6 auf 28.3, während ExploitBench von 24.4 auf 54.4 verbesserte.
Diese Zugewinne deuten darauf hin, dass Post-Training und agentenorientierte Umgebungen die Performance eines Modells ohne Änderung der zugrunde liegenden Basisarchitektur drastisch verändern können. Sie sollten jedoch nicht zu einer numerischen Vorhersage für GLM‑5.4 extrapoliert werden.
Fähigkeiten und Eignung für die Produktion
Für die Produktion ist GLM‑5.3 die stärkere Referenz für komplexes Codieren, langhorizontiges Engineering und Cybersicherheitsbewertung. GLM‑5.3‑Flash fügt native visuelle Eingaben hinzu und betont effiziente Tool-Nutzung. Die bestehenden Angebote GLM‑5.2, GLM‑5.3 und Flash liefern eine Baseline; in den für diesen Artikel geprüften Quellen ist keine gleichwertige GLM‑5.4‑Fähigkeit oder Verfügbarkeit etabliert.
Die dokumentierten Modelle unterstützen bis zu 1M Kontext, aber diese Grenze garantiert nicht identische nutzbare Kontexte oder Task-Performance auf jedem Endpoint. Wählen Sie zwischen ihnen anhand repräsentativer Workloads und der Kosten pro erfolgreich abgeschlossener Aufgabe.
Ein zukünftiges GLM‑5.4 müsste eine messbare Verbesserung bieten, um eine Migration zu rechtfertigen. Eine Verbesserung der Benchmark-Genauigkeit bei gleichzeitiger Verdopplung der Abschlusskosten kann für Produktionsumgebungen unattraktiv sein. Umgekehrt könnte ein moderater Genauigkeitsgewinn bei deutlich weniger Tool-Aufrufen im großen Maßstab wertvoll sein.
Vergleichen Sie Erfolgsquote, Eingabe- und Ausgabe-Tokens, Latenz, fehlgeschlagene Tool-Aufrufe und Kosten pro erfolgreicher Aufgabe unter demselben Evaluations-Harness. Qualitative Modellbeschreibungen sind kein kontrollierter Head-to-Head-Test.
What Is the Current GLM-5.4 API Status on CometAPI?
CometAPI hat eine dedizierte GLM‑5.4‑Modellseite mit einem stabilen Modelleintrags-Identifier erstellt. Die Seite kennzeichnet das Modell jedoch weiterhin als „Coming soon“ und beschreibt es als Pre-Launch-Modell. Entwickler sollten die tatsächliche Modell-ID, Kontozugriff, Endpoint-Verfügbarkeit, unterstützte Parameter, Kontextgrenzen und Preise verifizieren, bevor sie einen Produktionseinsatz versuchen.
Für eine aktuell dokumentierte Integration verwenden Sie ein verfügbares GLM-Modell wie GLM‑5.2 oder GLM‑5.3. Die GLM‑5.4‑Seite von CometAPI sollte derzeit als Pre-Launch-Katalogeintrag behandelt werden, bis Modell-ID und Endpoint als aufrufbar bestätigt sind.
Preparing for GLM 5.4 API Integration
Die praktischste Vorbereitung besteht darin, die Anwendungslogik nicht an eine einzelne Modellversion zu koppeln. Eine konfigurierbare Modellkennung erleichtert die Bewertung von Upgrades, ohne die Request-Pipeline neu zu schreiben.
Halten Sie die Modellkennung konfigurierbar und verwenden Sie ein verfügbares GLM-Modell, um eine funktionierende Baseline zu etablieren. Bestätigen Sie vor dem Wechsel zu GLM‑5.4 eine aufrufbare Modell-ID, Kontozugriff, unterstützte Request-Parameter, Kontext- und Ausgabelimits, Streaming-Verhalten und Tool-Call-Kompatibilität. Halten Sie eine Rollback-Option bereit.
Sobald GLM‑5.4 offiziell verfügbar ist, verifizieren Sie Modell-ID, unterstützte Parameter, Kontextgrenzen und Endpoint-Kompatibilität. Führen Sie das alte und das neue Modell gegen denselben Evaluationsdatensatz aus und verfolgen Sie Erfolgsrate, Latenz, Ausgabetokens, Tool-Call-Fehler und Kosten pro erfolgreicher Ausführung.
What Could GLM 5.4 API Pricing Look Like?
Es wurde kein offizieller GLM‑5.4‑API‑Preis angekündigt. Es wäre daher irreführend, einen spezifischen Eingabe- oder Ausgabe-Token-Satz als angeblichen Leak zu veröffentlichen.
Die aktuelle GLM-Familie illustriert, warum die Modellgröße allein die Preisgestaltung nicht vorhersagt. GLM‑5.3‑Flash führte architektonische Optimierungen ein, die darauf ausgelegt sind, wettbewerbsfähige Intelligenz bei deutlich geringeren Inferenzkosten zu liefern.
Z.ai’s Artificial Analysis Intelligence Index v4.1.1‑Vergleich berichtet einen Score von 57 zu geschätzten rabattierten 0.045 $ pro Aufgabe für GLM‑5.3‑Flash. Diese Evaluationskosten sind kein Input/Output-Token-Tarif und prognostizieren nicht die GLM‑5.4‑Preisgestaltung.
Die zukünftige GLM‑5.4‑Preisgestaltung könnte von Architektur, Reasoning-Aufwand, Rabatten für gecachte Tokens, Hosting-Infrastruktur und Varianten abhängen. Für die Produktionsplanung ist die Kostenkennzahl pro erfolgreich abgeschlossener Aufgabe oft wertvoller als der niedrigste Schlagzeilen-Input-Token-Satz.
Should Developers Wait for GLM 5.4?
Für die meisten Entwickler ist das Warten auf ein nicht angekündigtes Modell unnötig. Bestehende GLM-Modelle bieten dokumentierte Coding- und agentische Fähigkeiten, die in realen Anwendungen getestet werden können.
Teams, die Coding-Assistenten oder mehrstufige Engineering-Agenten bauen, können mit GLM‑5.3 eine Baseline etablieren. Anwendungen mit Schwerpunkt auf visueller Wahrnehmung, langem Kontext und effizient wiederholten Aufrufen können GLM‑5.3‑Flash evaluieren.
Bauen Sie jetzt ein Evaluations-Harness und reservieren Sie einen zukünftigen Vergleichsslot für GLM‑5.4. Sobald verfügbar, ist dessen Release relevant, wenn es Ergebnisse verbessert, die für eine bestimmte Anwendung zählen.
Forscher sollten auf neue Basisarchitekturen, Veränderungen in Langhorizont-Benchmarks und End-to-End-Zuverlässigkeit achten. Unternehmen sollten Verfügbarkeit, Kosten, Latenz, Kompatibilität und Qualität an repräsentativen Produktionsdaten priorisieren.
Conclusion
GLM 5.4 ist ein plausibler nächster Schritt in Z.ai’s sich schnell entwickelnder Modellfamilie, doch die aktuelle Erzählung bleibt eher spekulativ als bestätigt.
Union Alpha ist ein unbestätigter Identitätshinweis, und der Veröffentlichungsrhythmus stützt nur eine grobe Timing-Hypothese. Beides begründet kein Launch-Datum. Die am 14. Oktober 2026 geprüften offiziellen Quellen liefern eine Baseline für bestehende Modelle statt eines bestätigten GLM‑5.4‑Releases.
Verifizierbar ist der bereits erzielte Fortschritt von GLM‑5.3 und GLM‑5.3‑Flash. Bedeutende Zugewinne beim agentischen Codieren, in Cybersicherheitsbewertungen und bei der Inferenz-Effizienz setzen eine anspruchsvolle Baseline für jeden Nachfolger.
Die Schlüsselfrage ist, ob Z.ai zuverlässige autonome Ausführung, stärkeres Reasoning und wettbewerbsfähige Kosten pro abgeschlossener Aufgabe liefern kann. Bis offizielle Spezifikationen und Benchmarks erscheinen, sollte GLM‑5.4 als potenzieller Release statt als verfügbares Produkt behandelt werden.
FAQ
How can I verify a GLM 5.4 API listing?
Prüfen Sie, ob der Anbieter eine aufrufbare Modellkennung, einen unterstützten Endpoint, Zugriffsbedingungen und aktuelle Preise bereitstellt. Vergleichen Sie anschließend die Identität mit einer offiziellen Z.ai‑Ankündigung oder Dokumentation. Ein Anbietereintrag kann das Angebot dieses Anbieters etablieren, authentifiziert jedoch nicht für sich genommen den zugrundeliegenden Entwickler eines anonymen Modells.
Which compatibility checks matter before a GLM 5.4 migration?
Validieren Sie Request-Parameter, Reasoning-Einstellungen, Tool-Call-Schema, strukturierte Ausgaben, Streaming-Verhalten, Kontextgrenzen und maximale Ausgabe auf Ihrem tatsächlichen Endpoint. Inklusive Negativtests für nicht unterstützte Parameter und halten Sie das bestehende Modell für ein Rollback verfügbar. OpenAI-Kompatibilität beschreibt eine Schnittstelle; sie garantiert kein identisches Modellverhalten.
How should I evaluate GLM 5.4 for coding agents?
Verwenden Sie einen festen Satz repräsentativer Repository-Aufgaben mit denselben Tools, Berechtigungen, Timeouts und demselben Harness für beide Modelle. Zählen Sie erfolgreiche verifizierte Änderungen, Wiederherstellung nach Tool-Fehlern, Tokenverbrauch, Latenz und Gesamtkosten. Protokollieren Sie jeden Lauf und wiederholen Sie Aufgaben ausreichend oft, um Variabilität sichtbar zu machen, statt ein einzelnes günstiges Beispiel herauszustellen.
What would justify waiting for GLM 5.4?
Warten ist nur dann gerechtfertigt, wenn eine dokumentierte, bevorstehende Fähigkeit eine Anforderung adressiert, die verfügbare Modelle nicht erfüllen können, und die Verzögerung zu Ihrem Lieferplan passt. Bei bloßen Gerüchten sollten Sie gegen ein verfügbares Modell entwickeln und die Modellauswahl konfigurierbar halten. Definieren Sie die Fähigkeits- und Kostenschwellen, die ein späterer Release erfüllen muss, bevor er Ihre Baseline ersetzt.