TL;DR
GPT-6.1 Sol ist kein größerer‑Kontext oder teurerer Ersatz für GPT-6 Sol. Es behält das gleiche 1.05‑Millionen‑Token‑Kontextfenster, 128K maximale Ausgabe und $2/$10 Standard‑API‑Preise bei, während Codierung, Computerbedienung, professionelle Workflows, faktische Zuverlässigkeit und Agent‑Verhalten verbessert werden. Die klarste Preisänderung betrifft Prompt‑Caching: der Preis für gecachten Input sinkt von $0.20 auf $0.10 pro Million Tokens.
Praktisch bedeutet das, dass GPT-6.1 Sol weniger die Form der API verändert und mehr deutlich nützlichere Arbeit bei ungefähr gleichem Token‑Budget liefert.
Key Takeaways
- GPT-6.1 Sol ist ein Fähigkeits‑Upgrade zu GPT-6 Sol mit demselben 1,050,000‑Token‑Kontextfenster und einer 128,000‑Token‑Ausgabeobergrenze.
- Standard‑API‑Input‑ und Output‑Preise bleiben bei $2/M und $10/M; gecachter Input sinkt von $0.20/M auf $0.10/M.
- Offizielle Evaluierungen zeigen stärkere Codierung, Computerbenutzung, Geschäftsautomatisierung und wissenschaftliche Workflows; Ergebnisse hängen vom Benchmark und der Reasoning‑Einstellung ab.
- Migration erfordert Prüfung sowohl des Reasoning‑Aufwands als auch der API‑Endpoint‑Kompatibilität: GPT-6.1 Sol entfernt nichts und erfordert für Tool‑Aufrufe die Responses‑API.
- Validieren Sie Aufgabenerfolg, Latenz, tatsächliche Cache‑Treffer und End‑to‑End‑Kosten, bevor Sie eine stabile GPT-6‑Sol‑Bereitstellung ersetzen.
What Is GPT-6.1 Sol, and Why Did It Arrive So Soon After GPT-6 Sol?
OpenAI stellte GPT-6 Sol am 22. September 2026 vor. Eine Woche später kündigte das System‑Card‑Addendum vom 29. September GPT-6.1 Sol an. OpenAI präsentiert die neue Version als Upgrade zu GPT-6 Sol statt als separate Preisstufe.
Das kurze Veröffentlichungsintervall ist wichtig, weil GPT-6.1 Sol nicht als neue Produktstufe positioniert ist. OpenAI behielt die Sol‑Preisstufe bei und konzentrierte das Update auf die Fähigkeit bei schwierigen Aufgaben, Kosteneffizienz und Agent‑Zuverlässigkeit.
OpenAI positioniert GPT-6.1 Sol rund um agentisches Coding, Computerbenutzung und professionelle Arbeit. Der wichtige Vergleich ist der Aufgabenerfolg bei gegebenen Kosten, nicht der Modellname allein. Die offizielle Benchmark‑Zusammenfassung unten trennt Fähigkeitsgewinne von unveränderten API‑Spezifikationen.
Das macht den Vergleich ungewöhnlich einfach: GPT-6.1 Sol ist in erster Linie ein Fähigkeits‑ und Effizienz‑Upgrade und kein Upgrade beim Kontextfenster oder Basispreis.
GPT-6.1 Sol vs. GPT-6 Sol: What Stays the Same?
Beide Modelle behalten dieselben Kapazitäts‑Kennzahlen, unterstützten Ein-/Ausgabe‑Modalitäten und Standard‑Input/Output‑Preise. Die Tabelle verzeichnet auch Unterschiede in Cutoff‑Daten, Reasoning‑Optionen, Tool‑Aufrufen und gecachten Input‑Sätzen; diese Unterschiede sollten nicht mit gemeinsamen Spezifikationen verwechselt werden.
Shared Specifications and Compatibility Differences
| Specification | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Model ID | gpt-6.1-sol | gpt-6-sol |
| Release date | Sep. 29, 2026 | Sep. 22, 2026 |
| Context window | 1,050,000 tokens | 1,050,000 tokens |
| Maximum output | 128,000 tokens | 128,000 tokens |
| Knowledge cutoff | Apr. 30, 2026 | Apr. 20, 2026 |
| Text input / output | Yes / Yes | Yes / Yes |
| Image input | Yes | Yes |
| Standard input price | $2.00 / 1M | $2.00 / 1M |
| Cached input | $0.10 / 1M | $0.20 / 1M |
| Cache write | $2.50 / 1M | $2.50 / 1M |
| Output price | $10.00 / 1M | $10.00 / 1M |
| Reasoning effort | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Structured outputs | Yes | Yes |
| Function calling | Yes through Responses API; unavailable through Chat Completions | Yes through Responses API; Chat Completions only with reasoning_effort=none |
| Fine-tuning | No | No |
| Audio / video input | Not supported | Not supported |
| Native image output | Not supported; image generation is a separate tool | Not supported; image generation is a separate tool |
Die beiden offiziellen Modellspalten oben dokumentieren identische Kontext‑ und Ausgabegrenzen. Diese Zahlen beschreiben die Kapazität; sie belegen nicht dieselbe Abrufgenauigkeit oder Latenz über alle Long‑Context‑Workloads hinweg.
Der Wissens‑Cutoff verschiebt sich leicht von 20. April auf 30. April 2026. Wichtiger ist, dass GPT-6.1 Sol nicht länger reasoning.effort="none" unterstützt; die verfügbaren Reasoning‑Einstellungen beginnen bei low.
Für Entwickler mit Minimal‑Latenz‑Anforderungen lohnt sich dieser Kompatibilitäts‑Aspekt zu testen, da GPT-6 Sol weiterhin reasoning effort none unterstützt.
Architecture: What Remains Undisclosed
Keine der für diesen Vergleich genutzten Modellseiten nennt eine Parameterzahl oder eine detaillierte Architekturaufgliederung. Das offizielle System‑Card‑Addendum sagt, GPT-6.1 Sol nutze dieselben Datentypen und Trainings wie Astra; das beweist nicht, dass Sol und Astra identische Architekturen haben. Architektur‑ und Parameter‑Skalenunterschiede bleiben in den zitierten Materialien daher unoffenlegt.
Base Pricing Is Unchanged; Cached Reads Are Cheaper
Für gewöhnliche, ungecachte Tokens: nein. Standard‑Input‑ und Output‑Sätze sind unverändert. Die wichtigste Preisverbesserung betrifft gecachten Input.
| Official API pricing — USD per 1M tokens | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Input / 1M tokens | $2.00 | $2.00 |
| Cached input / 1M | $0.10 | $0.20 |
| Cache write / 1M | $2.50 | $2.50 |
| Output / 1M tokens | $10.00 | $10.00 |
GPT-6.1 Sol senkt gecachten Input auf $0.10 pro Million Tokens, also 5% des ungecachten Input‑Satzes.
Beispielsweise kostet die Wiederverwendung von 100 Millionen gecachten Input‑Tokens etwa $10 auf GPT-6.1 Sol gegenüber $20 auf GPT-6 Sol. Dieser Unterschied ist bei einmaligen Prompts moderat, aber bedeutender für Hochvolumen‑Agenten mit stabilen Prompt‑Präfixen.
Die offiziellen Preisbedingungen in der Modelldokumentation gelten ebenfalls: Anfragen über 272K Input‑Tokens verwenden 2x Input‑ und Cache‑Sätze und 1.5x Output‑Preise für die gesamte Anfrage. Der Fast‑Modus von GPT-6.1 Sol kostet 2x Standard; Batch und Flex liegen 50% unter Standard. Regionale Verarbeitung fügt, wo verfügbar, 10% Aufschlag hinzu, und Fast ist mit EU‑Datenresidenz nicht verfügbar. Separate Tool‑Gebühren können anfallen. Planen Sie mit dem gewählten Verarbeitungsmodus, der Region und den tatsächlichen Cache‑Treffern.
What Has Improved in GPT-6.1 Sol?
Das Upgrade lässt sich am besten über Codierung, Agent‑Workflows, professionelle Dokumente, Wissenschaft, Faktentreue und Fehlertoleranz beurteilen. Die folgenden Abschnitte gruppieren diese Verbesserungen und behalten die ursprünglichen Benchmark‑Bedingungen und ‑Einschränkungen bei.
Benchmark Overview: Reported Gains and Evaluation Conditions
Das stärkste Argument für GPT-6.1 Sol kommt von der Aufgabenleistung statt von Rohspezifikationen. OpenAI berichtet Verbesserungen in Software Engineering, Geschäftsautomatisierung, Computerinteraktion, wissenschaftlichen Workflows, Faktentreue und Agent‑Alignment.
| Official benchmark / evaluation results | GPT-6.1 Sol vs. GPT-6 Sol | What the Change Means |
|---|---|---|
| DeepSWE v1.1 | +6.4 Prozentpunkte gegenüber dem besten Ergebnis von GPT-6 Sol, bei geringerem Reasoning‑Aufwand und Task‑Kosten; kein Match‑Effort‑Vergleich | Stärkeres Software Engineering über lange Horizonte |
| AutomationBench 1.0.6 | +4.8 Prozentpunkte bei medium effort für beide Sol‑Modelle; +2.2 Punkte gegenüber Opus 5.5 bei medium effort | Bessere mehrstufige Business‑Agent‑Ausführung |
| OSWorld 2.0 offline | +7 Prozentpunkte bei max effort; Teilbelohnung auf dem Offline‑Set, Release v2026.08.08; weniger als die Hälfte der Task‑Kosten | Bessere Computer‑Workflows |
| Terminal-Bench Science 0.1 | Mehr als doppelte Punktzahl von GPT-6 Sol bei max effort, mit weniger als der Hälfte der Kosten pro Aufgabe | Großer Gewinn in wissenschaftlichen Agent‑Workflows |
| Difficult factuality evaluation | Bei low effort sinken Antworten mit Fehlern von 11.4% auf 7.7%; ausgewählte schwierige Prompt‑Evaluation | Weniger faktische Fehler bei schwierigen Prompts |
| Broken-search alignment test | Bei maximalem Aufwand sinkt die Nichtoffenlegung defekter Suche von 4.9% auf 2.1%; absichtlich adversarielle Aufgaben | Bessere Erkennung von Tool‑Fehlern |
Dies sind von OpenAI berichtete Ergebnisse, keine unabhängigen CometAPI‑Messungen. OpenAI evaluierte seine Modelle in seiner Forschungsumgebung oder über seine API; Produktionsverhalten kann sich mit Systemprompts und verfügbaren Tools unterscheiden. Wettbewerbszahlen stammen aus öffentlichen Berichten. Task‑Kosten spiegeln die getestete Konfiguration wider und entsprechen nicht dem Token‑Preis. Nicht gemeldete Details wie pro‑Run‑Budgets oder Gerüste sollten nicht unterstellt werden.
Das offizielle Ergebnis in der Benchmark‑Tabelle vergleicht GPT-6.1 Sol bei geringerem Reasoning‑Aufwand mit der Bestpunktzahl von GPT-6 Sol. Es sollte nicht als kontrollierter Speed‑Vergleich bei gleichem Aufwand beschrieben werden. DeepSWE v1.1 bewertet originale, langhorizontige Software‑Engineering‑Aufgaben in realen Codebasen.
Zum Kontext berichtete der ursprüngliche GPT-6‑Sol‑Launch 68.8% bei maximalem Aufwand auf DeepSWE v1.1.
Coding: Stronger Long-Horizon Software Engineering
Codierung ist vermutlich das klarste Upgrade. DeepSWE v1.1 bewertet Agenten bei originalen Software‑Engineering‑Aufgaben in realen Codebasen, die nachhaltige, mehrstufige Arbeit erfordern.
Die oben zusammengefasste DeepSWE‑Verbesserung ist relevant, wenn ein Agent ein Repository inspizieren, Änderungen planen, Tools nutzen und Fehler über viele Schritte hinweg beheben muss. Entwickler können dieses Upgrade mit der GPT-6 Astra API in CometAPI vergleichen, um zu entscheiden, ob die härtesten Aufgaben ein höherpreisiges Modell rechtfertigen.
Das ist wichtiger als ein kurzer Coding‑Benchmark, weil lang laufende Coding‑Agenten Kosten durch wiederholtes Reasoning, Tool‑Aufrufe, Dateilesen, Patches und Kontextwiederverwendung akkumulieren. GPT-6.1 Sol verbessert sowohl die Aufgabenerfüllung als auch die Ökonomie wiederholten Kontexts, ohne den Standard‑$2/$10‑Token‑Satz zu erhöhen.
Die GPT-6 Sol API in CometAPI bleibt für bestehende Bereitstellungen nützlich und bietet einen OpenAI‑kompatiblen Pfad für Coding‑ und agentische Workloads.
AI Agents and Business Workflows: Automation and Computer Use
Ja, und die Verbesserung geht über Codierung hinaus. AutomationBench bewertet, ob ein Agent End‑to‑End‑Workflows mit vielen Tools über Vertrieb, Marketing, Betrieb, Support, Finanzen und HR hinweg abschließen kann.
Das Ergebnis bei matched medium in der Benchmark‑Zusammenfassung ist relevant für tool‑intensive Business‑Workflows. Es bleibt ein Benchmark‑Ergebnis und ist keine Erfolgsgarantie im eigenen Tool‑Stack eines Unternehmens. Der Vergleich umfasst auch die Claude Opus 5.5 API in CometAPI; evaluieren Sie alle Kandidaten mit denselben Tools und Erfolgskriterien, bevor Sie einen auswählen.
Für Computerbenutzung nutzt das oben erwähnte OSWorld‑Ergebnis das Offline‑Set und Teilbelohnung. Eine höhere Teilbelohnungs‑Punktzahl bedeutet nicht unbedingt, dass jede Aufgabe Ende‑zu‑Ende abgeschlossen wurde. Browserzustand, Berechtigungen, Wiederherstellungsverhalten und die Qualität der Tool‑Integration beeinflussen weiterhin die Ergebnisse in der Produktion.
Professional Documents and Science: Broader Complex-Task Capability
GPT-6.1 Sol schiebt die Sol‑Stufe auch weiter in professionelle Wissensarbeit. OpenAI evaluiert komplexes Dokumentenverständnis mit GDP.pdf, wo Modelle realistische Fragen basierend auf PDFs mit Tabellen, Diagrammen, Schaubildern, dichter Formatierung und Kleingedrucktem aus Bereichen wie Finanzen, Gesundheitswesen und Recht beantworten.
GDP.pdf liefert Evidenz für professionelle PDF‑Analyse über gewöhnliche textbasierte Fragebeantwortung hinaus. Behandeln Sie das Ergebnis in der Launch‑Ankündigung als Evaluation des Dokumentenverständnisses, nicht als Garantie, dass jedes Diagramm, jede Fußnote oder jede gescannte Seite korrekt interpretiert wird.
Das Terminal‑Bench‑Science‑Ergebnis in der offiziellen Benchmark‑Zusammenfassung umfasst Workflows wie Datenanalyse, Simulation und Theorembeweise. Eine sinnvolle lokale Evaluation sollte Korrektheit und Reproduzierbarkeit des Endoutputs bewerten und dabei Gesamt‑Tool‑ und Modellkosten messen.
Das bedeutet nicht, dass GPT-6.1 Sol Astra universell ersetzt. OpenAI positioniert Astra weiterhin als sein leistungsfähigstes Modell für die schwierigste End‑to‑End‑Arbeit. Wichtig ist, dass sich die Leistungslücke zwischen Sol und Astra verengt, während ihre Token‑Preis‑Lücke groß bleibt.
Factuality and Agent Reliability: Fewer Errors and Better Failure Handling
Die Faktentreue‑Daten von OpenAI weisen in diese Richtung, auch wenn die Evaluation nicht als universelle Halluzinationsrate interpretiert werden sollte.
Die offizielle Ankündigung berichtet direkt eine Faktentreue‑Verbesserung bei geringem Aufwand: Antworten mit Fehlern sinken von 11.4% bei GPT-6 Sol auf 7.7% bei GPT-6.1 Sol, ein Rückgang um 3.7 Prozentpunkte oder ungefähr 32% relativ. Diese ausgewählten Konversationen lösten zuvor Fehler aus; die Zahlen sind keine universelle Halluzinationsrate.
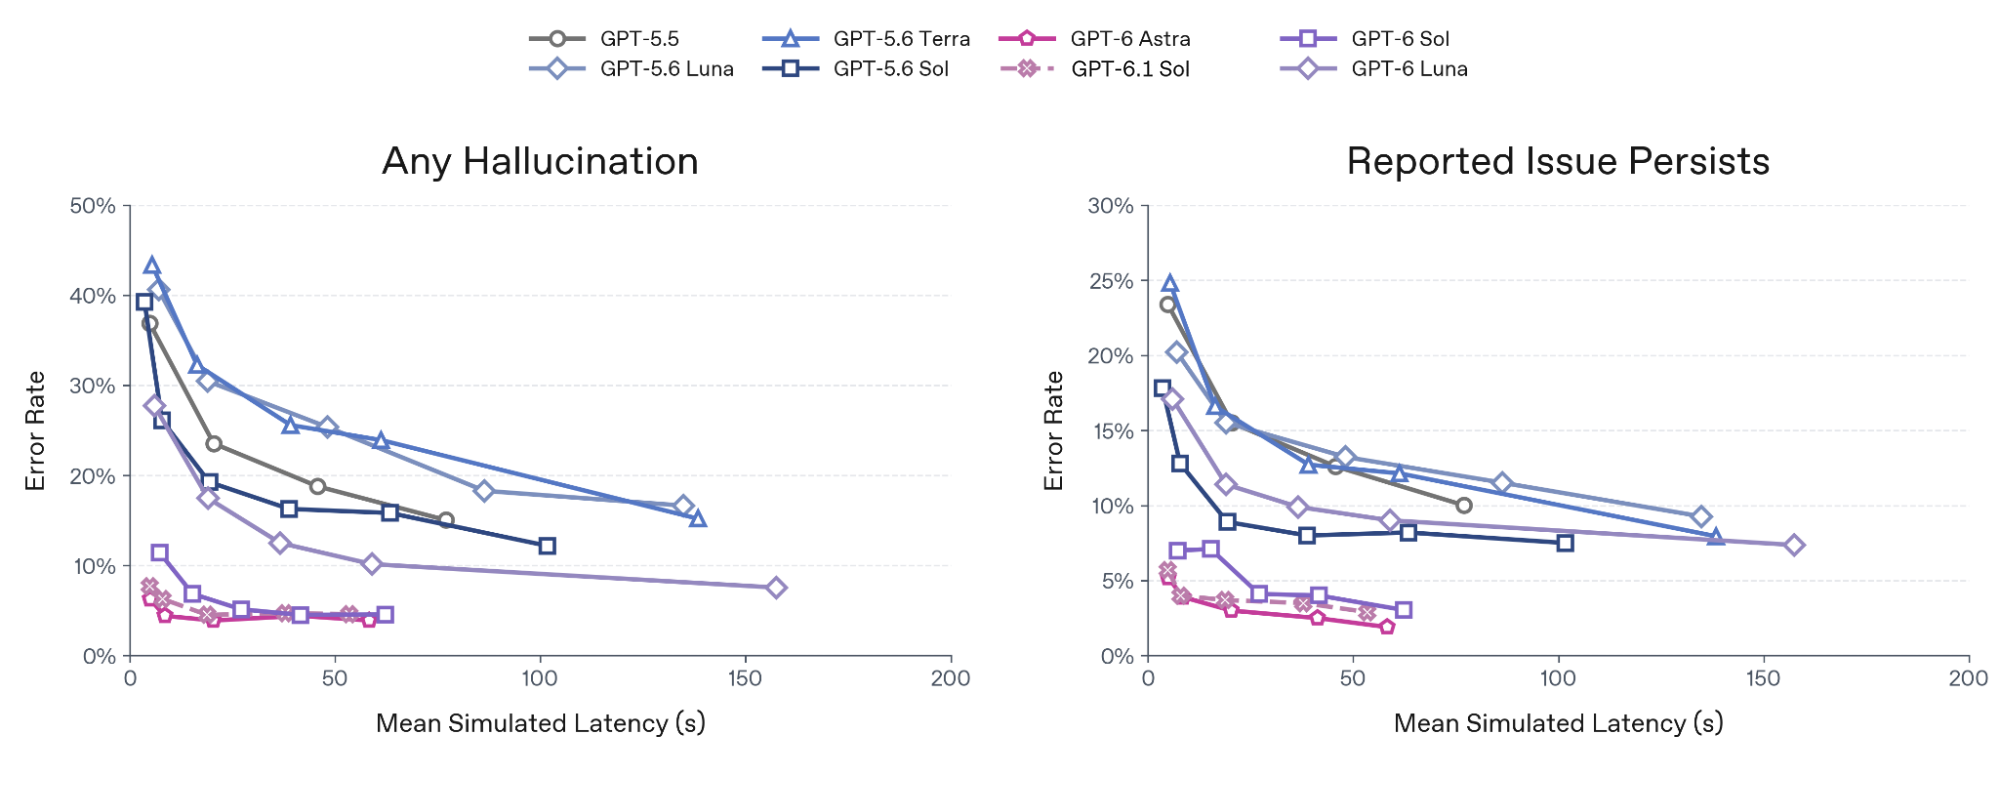
Das obige Originaldiagramm ist direkt aus dem OpenAI System‑Card‑PDF extrahiert, ohne Neuzeichnung. Es trägt ausgewählte schwierige Konversations‑Evaluationen gegen simulierte Latenz auf; die zwei Paneele messen beliebige Halluzinationen und Persistenz des gemeldeten Problems. Es sollte nicht als produktionsweite Fehlerabschätzung gelesen werden.
| Model | Broken-search Failure Rate — maximum effort |
|---|---|
| GPT-6.1 Sol | 2.1% |
| GPT-6 Sol | 4.9% |
| GPT-6 Astra | 1.5% |
| GPT-6 Luna | 28.7% |
Die GPT-6 Luna API in CometAPI ist eine weitere kostenorientierte Option, aber ihr Broken‑Search‑Ergebnis hier illustriert, warum ein Agent sowohl auf Fehlerbehandlung als auch auf erfolgreiche Tool‑Ausführung getestet werden muss.
Dies sind absichtlich adversarielle Evaluierungen und keine repräsentativen Produktions‑Fehlerraten. Sie sind nützlich als Evidenz, dass GPT-6.1 Sol besser erkennt, wenn Tools nicht verfügbar oder defekt sind, statt zuversichtlich mit unbelegten Behauptungen fortzufahren.
GPT-6.1 Sol vs. GPT-6 Sol: Should You Upgrade?
Für einen neuen komplexen Workflow ist GPT-6.1 Sol ein starker Evaluationskandidat. Für eine stabile GPT-6‑Sol‑Bereitstellung sollten Sie nur upgraden, wenn gemessene Gewinne die Migration rechtfertigen. Die gemeinsame Kontextgrenze und die Basis‑Token‑Preise ermöglichen einen fairen Vergleich, aber öffentliche Benchmarks können nicht entscheiden, ob Ihre eigene Anwendung schneller, zuverlässiger oder günstiger wird.
When Upgrading Is Worth Testing
Priorisieren Sie einen Test, wenn Repository‑Skalen‑Codierung, mehrstufige Geschäftsautomatisierung, Computerbenutzung oder schwierige Dokumentenanalyse einen wesentlichen Anteil Ihrer Workloads ausmachen. Die in den vorangegangenen Abschnitten gemeldeten Verbesserungen sind für diese Anwendungsfälle relevant. Behandeln Sie sie als Gründe zum Testen, nicht als Garantie, dass Ihre Produktions‑Erfolgsrate im gleichen Ausmaß steigt.
Anwendungen mit wiederholtem Kontext sind ein weiterer sinnvoller Testfall. Der niedrigere gecachte Lese‑Satz kann den Input‑Anteil der Rechnung reduzieren, wenn Anfragen tatsächlich ein stabiles Präfix wiederverwenden. Wenn die meisten Ausgaben aus generierten Tokens, Tools oder fehlgeschlagenen Versuchen stammen, kann ein Cache‑Rabatt allein wenig bewirken. Vergleichen Sie die Gesamtkosten pro akzeptiertem Ergebnis, einschließlich Wiederholungen und Prüfzeit.
When Keeping GPT-6 Sol Is Reasonable
Behalten Sie GPT-6 Sol bei, wenn es Ihre Qualitäts‑, Latenz‑ und Budgetziele bereits erfüllt und das neuere Modell in einer repräsentativen Evaluation keinen materiellen Vorteil bringt. Eine funktionierende Integration hat ebenfalls Wert: ersetzen Sie eine stabile Route nicht allein deshalb, weil der Modellname neuer ist.
Kompatibilität kann entscheidend sein. GPT-6 Sol unterstützt Reasoning none; GPT-6.1 Sol beginnt bei low. Eine Anwendung, die Sol Chat Completions‑Funktionsaufrufe bei none nutzt, muss ihre Tool‑Schleife auf Responses verlagern, um 6.1 Sol zu verwenden. Prüfen Sie außerdem Sampling‑Parameter und Response‑Parsing. Dies sind Migrationsänderungen, kein reiner Model‑ID‑Tausch. Siehe OpenAI Migrationshinweise.
How to Make the Upgrade Decision
Erstellen Sie einen festen Evaluationssatz mit Routinetasks, schwierigen Fällen und Tool‑Fehlern aus Ihrem vorgesehenen Workflow. Halten Sie Aufgabendefinitionen, Tool‑Berechtigungen und Abnahmekriterien konsistent. Vergleichen Sie eine validierte Sol‑Baseline mit einer gültigen 6.1‑Sol‑Konfiguration; zeichnen Sie Reasoning‑Einstellungen explizit auf, statt so zu tun, als seien none und low gleichwertig.
- Qualität: messen Sie akzeptierte Abschlüsse, faktische Korrekturen, ungültige Tool‑Aufrufe und manuellen Prüfaufwand.
- Geschwindigkeit: vergleichen Sie p50/p95 End‑to‑End‑Latenz, einschließlich Wiederholungen und Tool‑Wartezeiten.
- Kosten: erfassen Sie ungecachten Input, gecachte Lesezugriffe, Cache‑Writes, Output/Reasoning‑Tokens, Tool‑Gebühren und Engineering‑Aufwand.
- Rollout: beginnen Sie mit einem kleinen Traffic‑Anteil, behalten Sie eine Sol‑Fallback‑Route und erweitern Sie erst, wenn vordefinierte Schwellen erreicht sind.
Praktische Empfehlung: wählen Sie GPT-6.1 Sol, wenn der Test bessere Ökonomie pro akzeptierter Aufgabe oder einen benötigten Fähigkeitsgewinn ohne unakzeptable Rückschritte liefert. Behalten Sie GPT-6 Sol für Routen, bei denen Kompatibilität und bewährte Ergebnisse den gemessenen Nutzen überwiegen. Eine gemischte Bereitstellung ist sinnvoll, wenn nur einige Aufgabenklassen profitieren. Dies sind arbeitslastbasierte Empfehlungen, kein Anspruch, dass eines der Modelle universell gewinnt.
How Do You Migrate From GPT-6 Sol to GPT-6.1 Sol?
Auf einfachster Ebene ändert sich die Modellkennung von gpt-6-sol zu gpt-6.1-sol.
Eine Responses‑API‑Anfrage kann so aussehen:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Analysieren Sie dieses Repository und identifizieren Sie die Ursache der fehlschlagenden Tests."
)

print(response.output_text)
Die Änderung der Modellkennung ist nur der erste Schritt. GPT-6.1 Sol unterstützt low, medium, high, xhigh und max, während GPT-6 Sol zusätzlich none unterstützt. Entfernen Sie jede explizite none‑Einstellung und wählen Sie einen erlaubten Aufwand. Tool‑nutzende Anwendungen benötigen außerdem die Responses‑API: GPT-6.1 Sol Chat Completions unterstützt keine Tool‑Aufrufe, während GPT-6 Sol Chat Completions Funktionsaufrufe nur mit none unterstützt. Die offiziellen Modellspalten in der Spezifikationstabelle dokumentieren diese Endpoint‑Einschränkungen.
Teams sollten latenzsensitive Workflows, Tool‑Aufrufe, Prompt‑Caching, Long‑Context‑Verhalten und jede Logik, die explizit reasoning.effort="none" sendet, erneut testen.
Dieses Beispiel richtet sich direkt an OpenAI mit OPENAI_API_KEY; es ist kein verifiziertes CometAPI‑Endpoint‑Beispiel. Halten Sie Ihre GPT-6‑Sol‑Route während eines gestuften Rollouts verfügbar, erfassen Sie Aufgabenerfolg und p95‑Latenz und rollen Sie zurück, wenn die Abnahmekriterien Ihrer Anwendung nicht erfüllt werden.
Which GPT-6.1 Sol Workloads Benefit Most From the Upgrade?
| Workload | GPT-6.1 Sol Advantage |
|---|---|
| Coding agents | Höhere DeepSWE‑Performance |
| Repository-scale debugging | Besseres Software Engineering über lange Horizonte |
| Browser/computer agents | +7 Punkte auf OSWorld 2.0 |
| Enterprise automation | Höhere AutomationBench‑Performance |
| Repeated-context agents | 50% günstigerer gecachter Input |
| Complex PDF analysis | Nahe‑Astra‑Leistung bei professionellen Dokumenten |
| Scientific workflows | Mehr als 2x GPT-6‑Sol‑Punktzahl in OpenAIs Terminal‑Bench‑Science‑Evaluation |
| Fact-sensitive workflows | Niedrigere Faktfehler‑Rate bei schwierigen Prompts |
| Tool-heavy agents | Besseres Verhalten bei Tool‑Ausfällen |
GPT-6 Sol bleibt nützlich, wo bestehende Integrationen bereits stabil sind oder Entwickler speziell die none‑Reasoning‑Einstellung benötigen. Für neue Bereitstellungen, die auf Agenten, Codierung, Computerbenutzung oder wiederholte Kontext‑Workflows zentriert sind, verändert GPT-6.1 Sol die Kosten‑Performance‑Gleichung, ohne den normalen Input/Output‑Token‑Preis zu verändern.
How Can CometAPI Help You Upgrade From GPT-6 Sol to GPT-6.1 Sol?
Für Entwickler, die bereits die GPT-6 Sol API in CometAPI nutzen, kann das Upgrade auf GPT-6.1 Sol als relativ kleine Migration statt eines vollständigen Integrations‑Rewrites behandelt werden.
GPT-6.1 Sol ist jetzt über CometAPI mit der Modellkennung gpt-6.1-sol verfügbar. CometAPI zeigt derzeit einen Startpreis für Short‑Context‑Input von $1.60 pro Million Tokens, verglichen mit OpenAIs offiziellem $2.00‑Satz, während die Output‑Preise bei $8.00 pro Million Tokens beginnen. Dies hält das neuere Sol‑Modell in derselben rabattierten Preisstruktur wie GPT-6 Sol und gibt Entwicklern Zugang zu seiner stärkeren Leistung in Codierung, Agenten und Computerbenutzung.
Da CometAPI eine OpenAI‑kompatible Schnittstelle bereitstellt, können bestehende GPT-6‑Sol‑Anwendungen in der Regel dieselbe SDK‑Struktur und denselben Anfragefluss beibehalten, während sie die Modell‑ID auf gpt-6.1-sol umstellen. CometAPI stellt außerdem Tools bereit, um Modelle zu vergleichen, Prompts zu testen, Workload‑Kosten zu schätzen und Migrationsverhalten vor dem Produktions‑Rollout zu inspizieren.
Ein sichererer Upgrade‑Prozess besteht darin, dieselben repräsentativen Prompts zuerst gegen GPT-6 Sol und GPT-6.1 Sol laufen zu lassen und dann Output‑Qualität, Latenz, Tool‑Verhalten und Gesamtkosten zu vergleichen. Dies ist besonders wichtig für Anwendungen, die von Reasoning‑Einstellungen, strukturierten Outputs, Tool‑Aufrufen oder lang laufenden Agenten abhängen, da Modellkompatibilität nicht identisches Verhalten in jeder Workload garantiert.
Für Teams mit Workloads, die wiederholten Kontext oder agentenintensive Aufgaben umfassen, kann die neuere Route auch die Ökonomie verbessern. CometAPI bepreist derzeit Short‑Context‑Cache‑Reads für GPT-6.1 Sol mit $0.08 pro Million Tokens, gegenüber OpenAIs offiziellem $0.10‑Satz, während Short‑Context‑Input‑ und Output‑Sätze bei 20% unter der offiziellen Preisgestaltung liegen.
In der Praxis kann CometAPI den GPT‑6‑Sol → GPT‑6.1‑Sol‑Übergang in drei Schritten gestalten:
- Ersetzen Sie
gpt-6-soldurchgpt-6.1-sol. - Benchmarken Sie dieselben Produktions‑Prompts und Agent‑Workflows, bevor Sie den Traffic umschalten.
- Verschieben Sie Workloads schrittweise, sobald Output‑Qualität, Tool‑Verhalten, Latenz und Kosten Ihre Anforderungen erfüllen.
Dieser Ansatz ermöglicht es Entwicklern, GPT-6.1 Sol zu übernehmen, ohne ihre Anwendung um einen neuen API‑Stack herum neu aufzubauen, während die Verhaltensunterschiede des neuen Modells dennoch validiert werden.
Conclusion
GPT-6 Sol ist nicht technisch obsolet. Es behält dasselbe 1.05M‑Kontextfenster, 128K‑Ausgabeobergrenze, strukturierte Outputs, Image‑Input und $2/$10 Standard‑Preise. Die none‑Reasoning‑Option kann für bestehende Integrationen ebenfalls wichtig sein. Die Upgrade‑Entscheidung sollte auf gemessenen Aufgabenergebnissen und Kompatibilität beruhen, nicht allein auf der Versionsnummer.
Die Dokumentation zu GPT-6 Sol von OpenAI verweist Entwickler jedoch nun auf GPT-6.1 Sol als das neuere Sol‑Modell.
Für die meisten komplexen Workloads lautet die Schlüsselfrage daher nicht, ob GPT-6.1 Sol ein größeres Kontextfenster oder einen höheren Token‑Satz hat — hat es nicht. Die Frage ist, ob höherer Aufgabenerfolg, günstigere Cache‑Reads, verbesserte Faktentreue und stärkeres Agent‑Verhalten es rechtfertigen, die Modellkennung zu ändern und die Workload erneut zu testen.
FAQ
How do you migrate from GPT-6 Sol to GPT-6.1 Sol with tool calling?
Nein. Prüfen Sie zuerst Endpoint und Request‑Felder, verlagern Sie dann die Tool‑Schleife auf die Responses‑API und testen Sie Tool‑Call‑Parsing, Argumentvalidierung, Wiederholungen und Fehlerbehandlung. Führen Sie ein Canary‑Deployment mit repräsentativen Aufgaben durch, bevor Sie den Traffic erhöhen; eine erfolgreiche Text‑Only‑Anfrage verifiziert keinen funktionierenden Tool‑Loop.
Is GPT-6.1 Sol cheaper in real workloads?
Protokollieren Sie gecachte und ungecachte Input‑Tokens, Cache‑Writes, Reasoning‑ und Output‑Tokens, Verarbeitungsmodus und Tool‑Gebühren. Vergleichen Sie Kosten pro akzeptierter Aufgabe statt nur den Preis gecachter Tokens. Stabile Präfixe helfen nur, wenn Anfragen den Cache tatsächlich treffen, und längere Tool‑Schleifen oder fehlgeschlagene Versuche können Cache‑Einsparungen aufheben.
How should you test GPT-6.1 Sol before switching from GPT-6 Sol?
Nutzen Sie einen festen Satz produktionsnaher Aufgaben und erfassen Sie erfolgreiche Abschlüsse, faktische Korrekturen, ungültige Tool‑Aufrufe, p50/p95‑Latenz und Gesamtkosten. Definieren Sie akzeptable Schwellen vor dem Test. Halten Sie einen Model‑Routing‑Rollback bereit und erweitern Sie den Traffic erst, nachdem die neue Konfiguration diese Schwellen erfüllt.
How do you test GPT-6.1 Sol with PDFs?
Erstellen Sie einen kleinen Korpus mit dichten Tabellen, Fußnoten, Diagrammen und gescannten Seiten, der den vorgesehenen Workflow repräsentiert. Stellen Sie Fragen mit verifizierbaren Antworten und verlangen Sie Seiten‑ oder Tabellen‑Evidenz. Bewerten Sie Rechenrichtigkeiten, fehlende Hinweise und unbelegte Antworten separat; behalten Sie menschliche Prüfung für Outputs bei, deren Fehler wesentliche Folgen hätten.