

TL;DR: GPT-6.1 Terra ist der stärkere Ausgangspunkt, wenn Reasoning-Qualität und komplexe visuelle Workflows am wichtigsten sind; DeepSeek V4.1 Flash ist attraktiv, wenn Token-Kosten, Generierungsgeschwindigkeit oder Selbsthosting Priorität haben. Dieser Vergleich verwendet DeepSeeks Update vom 17. Oktober, Flash-1017.
DeepSeek Flash-1017 hat niedrigere Tokenpreise, aber die Kosten einer abgeschlossenen Aufgabe hängen auch von der Reasoning-Länge, Wiederholungen und Tool-Aufrufen ab.
Der Vergleich unten umfasst Architektur, Kontext, Reasoning, Coding, Vision, Geschwindigkeit, Preise und Deployment. Preise und Live-Bewertungsseiten wurden am 28. Oktober 2026 geprüft.
Wichtigste Erkenntnisse
- Terra führt den zitierten unabhängigen Intelligenzindex an und ist daher ein logischer erster Kandidat für anspruchsvolle Reasoning-Aufgaben.
- DeepSeek hat niedrigere gelistete Tokenpreise. Vergleichen Sie End-to-End-Latenz und Kosten pro erfolgreicher Aufgabe, einschließlich Spitzenzeiten, Cache-Nutzung, Reasoning-Tokens und Wiederholungen.
- Bewerten Sie Coding über akzeptierte Patches und visuelle Workflows über abgeschlossene Aufgaben. Veröffentlichte Benchmark-Ergebnisse liefern nützliche Hinweise, aber die Test-Setups unterscheiden sich.
- Terra ist ein gehostetes proprietäres Modell. DeepSeek bietet MIT-lizenzierte herunterladbare Gewichte für Selbsthosting, mit zu berücksichtigender Hardware und Betriebskosten.
- CometAPI stellt eine gemeinsame Textschnittstelle für Tests beider Modelle bereit. Prüfen Sie die aufgelöste Modellversion sowie die Unterstützung für Tools, Reasoning-Steuerung und strukturierte Ausgabe vor dem Einsatz.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Überblick und Spezifikationen
Die wichtigsten Spezifikationsunterschiede betreffen Ausgabelimits, Reasoning-Steuerung, Tool-Aufrufe und Deployment. Die Tabelle unten fasst die beiden Modelle zusammen.
Die Terra API-Spezifikationen und die DeepSeek API-Spezifikationen definieren die unten genannten gehosteten Limits; eine Drittanbieter-Route oder selbstgehostete Konfiguration kann andere Limits auferlegen.
Architektur und Modellversionen
Terra verwendet eine proprietäre Architektur, deren Parameteranzahl nicht öffentlich offengelegt ist. DeepSeek-V4.1-Flash nutzt eine Causal Encoder–Decoder MoE-Architektur mit unterschiedlichen aktiven Parameterbudgets für die Eingabeverarbeitung und die Ausgabeerzeugung.
Der V4.1 Flash-Release von DeepSeek beschreibt ein Causal Encoder–Decoder MoE-Backbone mit 552B Parametern, mit etwa 8B aktiven Parametern während der Input-Verarbeitung und 16B während der Output-Generierung. Das Update vom 17. Oktober verbessert die veröffentlichten Coding-, Agent- und Vision-Ergebnisse.
In diesem Artikel bedeutet Flash-1017 den Oktober-Checkpoint. Ein generischer API-Alias kann später auf eine andere Version zeigen, daher sollte ein Evaluierungsprotokoll die tatsächlich bereitgestellte Modellversion enthalten.
KV-Cache und Deployment-Anforderungen
DeepSeek berichtet von einem globalen KV-Cache-Fußabdruck von ca. 890 Bytes pro Token, etwa ein Viertel von DeepSeek-V4-Flash. Das verbessert die Cache-Effizienz, auch wenn Selbsthosting weiterhin beträchtliche Ressourcen für die Modellgewichte erfordert. Terra ist über gehostete Dienste verfügbar, während DeepSeeks herunterladbare Gewichte eine zusätzliche Selbsthosting-Option bieten.
Reasoning-Steuerung und Tool-Aufrufe
Beide Modelle unterstützen Agenten-Workflows, jedoch unterscheiden sich Reasoning-Steuerung und Anforderungen für Tool-Aufrufe. Terras dokumentierte Unterstützung für Tool-Aufrufe nutzt die Responses API. DeepSeeks Modellkarte beschreibt einen numerischen Reasoning-Aufwand von 1 bis 100; gehostete API-Steuerungen sollten separat geprüft werden. Beim Wechsel des Modells passen Sie Reasoning-Parameter und Tool-Definitionen an den gewählten Endpoint an.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Leistung
Der Vergleich unten umfasst Reasoning, Coding, Vision und Long-Context-Aufgaben. Unabhängige Bewertungen und vom Anbieter gemeldete Benchmarks werden getrennt ausgewiesen und im Kontext ihrer Modellkonfigurationen und Agenten-Frameworks interpretiert.
Reasoning und Wissen
Artificial Analysis berichtet über einen Intelligence Index v5.0-Score von 51 für GPT-6.1 Terra (Max) und 32 für DeepSeek Flash-1017 (Max) in den zitierten Konfigurationen, Stand 28. Oktober 2026. Der Index kombiniert neun Bewertungen.
Terras höherer aggregierter Score unterstützt den Ansatz, es zuerst für anspruchsvolle Reasoning-Aufgaben zu testen. Für engere Aufgabenbereiche kann DeepSeek dennoch die bessere Wahl sein, wenn es die erforderliche Genauigkeit zu geringeren Kosten pro erfolgreicher Aufgabe erreicht.
Offizielle Coding- und Agenten-Benchmarks
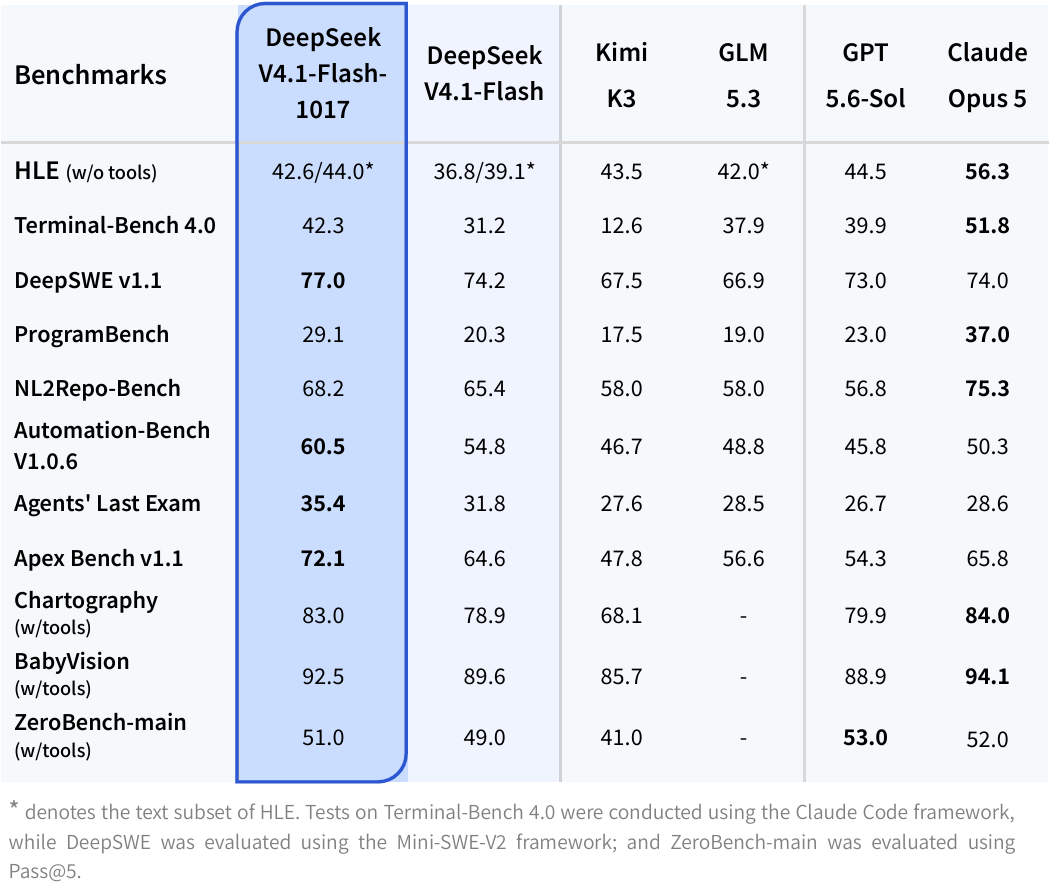
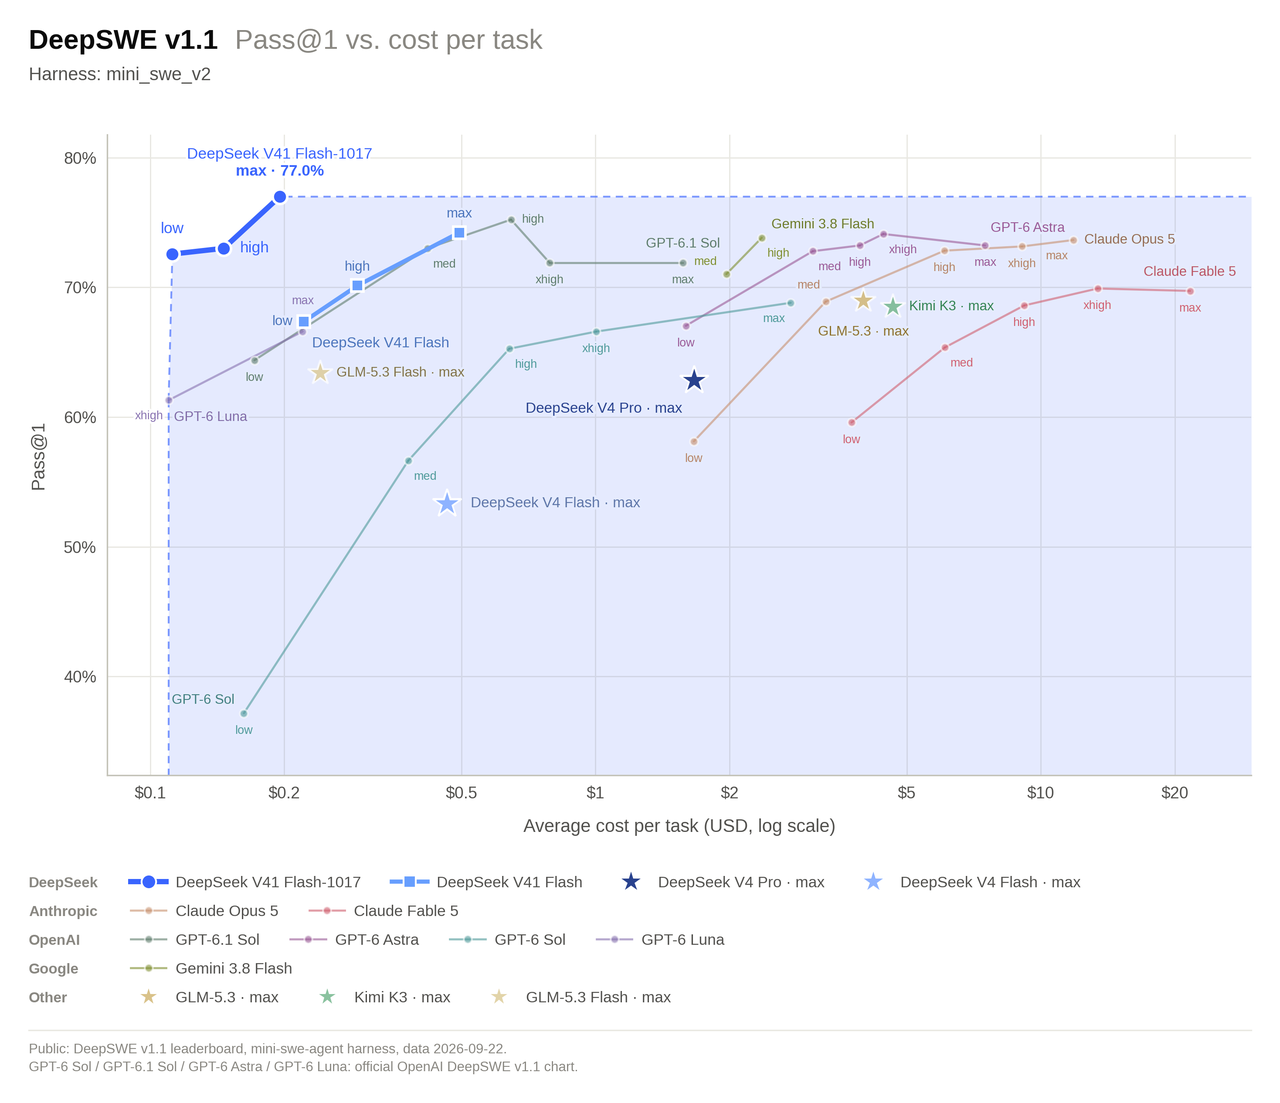
Terminal-Bench 4.0 und DeepSWE v1.1 liefern Hinweise zur Coding- und Agentenleistung. Beim Vergleich von Anbieterergebnissen sollten Sie die genaue Modellversion, Reasoning-Einstellung, das Agenten-Framework und die Bewertungsmetrik identifizieren; Unterschiede in diesen Einstellungen können die Scores wesentlich beeinflussen.
Für praktische Coding-Arbeit vergleichen Sie, ob jedes Modell Patches erzeugt, die bestehende Tests bestehen, öffentliche Schnittstellen bewahren, Edge Cases behandeln und keine irrelevanten Änderungen vornehmen. Die Zuverlässigkeit von Tool-Aufrufen und die Recovery nach Ausführungsfehlern beeinflussen ebenfalls, wie viel Arbeit ein Agent abschließen kann.
DeepSeeks niedrigere gelistete Tokenpreise machen es zu einem nützlichen Kandidaten für wiederholte Repository-Wartung mit klaren Abnahmekriterien. Für komplexe Änderungen vergleichen Sie beide Modelle hinsichtlich akzeptierter Patches, Gesamtkosten der Aufgabe und menschlicher Korrekturzeit.
Vision und Computerbedienung
Beide Modelle akzeptieren Bild-Inputs, aber Bildverständnis und Desktop-Interaktion erfordern unterschiedliche Fähigkeiten. OpenAIs Terra-Launch-Material diskutiert MMMU-Pro und OSWorld 2.1, während DeepSeeks Modellkarte visuelle Aufgaben einschließlich Chartography und BabyVision mit Tool-unterstützten Einstellungen berichtet.
Für die Dokumentextraktion vergleichen Sie Feldgenauigkeit, übersehenen Text und Tabellenstruktur. Für Desktop-Automatisierung vergleichen Sie abgeschlossene Workflows, falsche Aktionen und Recovery nach Änderungen der Benutzeroberfläche. Ein Modell, das einen Screenshot korrekt beschreibt, kann dennoch Schwierigkeiten haben, die dargestellte Anwendung zu bedienen.
Wählen Sie entsprechend dem Workflow: Extraktionsgenauigkeit ist für die Dokumentverarbeitung am wichtigsten, während zuverlässige Aktionen und Recovery für Computer-Use-Agenten stärker zählen. Vergleichen Sie die Kosten erst, nachdem beide Modelle die benötigte Qualitätsgrenze erreicht haben.
Reasoning und Retrieval bei langen Kontexten
Beide Modelle unterstützen Langdokument-Workflows, aber die Kontextkapazität allein bestimmt die Retrieval-Qualität nicht. Vergleichen Sie sie auf derselben Dokumentensammlung und platzieren Sie wichtige Evidenz am Anfang, in der Mitte und am Ende.
Bewerten Sie Antwortgenauigkeit, unterstützende Passagen, Konsistenz über Dokumente und Vollständigkeit der Antworten. Für Recherche und Dokumentanalyse bevorzugen Sie das Modell, das relevante Evidenz zuverlässig innerhalb Ihrer Latenz- und Kostenanforderungen abruft und verknüpft.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Geschwindigkeit
Ausgaberate und Aufgabenabschlusszeit
Latenz verdient eine getrennte Betrachtung von Reasoning-Qualität.
Auf den Artificial Analysis-Seiten vom 28. Oktober liegt die Flash-1017 (Max) Ausgabegeschwindigkeit bei 173,4 Token pro Sekunde, während die Terra (Max) Ausgabegeschwindigkeit 90,9 beträgt. Diese Messungen beschreiben die beim Evaluator bereitgestellten Konfigurationen, nicht garantierte Raten bei jedem Anbieter.
Ein Modell, das schneller Token generiert, kann dennoch länger bis zur Fertigstellung benötigen, wenn es mehr Reasoning produziert, auf Tools wartet oder Wiederholungen durchführt. Messen Sie Zeit bis zum ersten Token, Gesamtabschlusszeit und Latenz akzeptierter Aufgaben gesondert.
Interaktive Latenz auf Ihrer API-Route
Für ein interaktives Produkt testen Sie kurze und lange Prompts bei realistischer Gleichzeitigkeit und protokollieren Median- und 95.-Perzentil-Latenz. Halten Sie Region, API-Route, Prompt-Caching, Reasoning-Einstellungen und Retry-Policy in den Ergebnissen fest. Dieses Protokoll sagt mehr über die User Experience aus als eine einzelne Token-pro-Sekunde-Zahl.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Kosten
Die Preisgestaltung ist einer der deutlichsten Unterschiede zwischen diesen Modellen.
Die Terra-Preisliste und DeepSeeks Preisrichtlinie geben die folgenden First-Party-Raten an, geprüft am 28. Oktober 2026. Alle Preise sind US-Dollar pro Million Token.
Offizielle API-Raten
DeepSeeks Peak-Pricing gilt Montag–Freitag, 01:00–04:00 und 06:00–10:00 UTC, ausgenommen chinesische Feiertage. Das entspricht 09:00–12:00 und 14:00–18:00 in China Standard Time (UTC+8). Andere Zeiträume verwenden die Off-Peak-Raten.
Für Terra-Anfragen über 272.000 Input-Token gibt OpenAI für die gesamte Anfrage 2× Input- und Cached-Input-Raten sowie 1,5× Output-Raten an. Vergleichen Sie diese Bedingungen mit Ihren tatsächlichen Prompt-Größen, bevor Sie den Basispreis als effektiven Preis behandeln.
CometAPI-Raten
CometAPI listet DeepSeeks Peak-Fenster als Montag–Freitag, 01:00–04:00 und 06:00–10:00 UTC. Der gelistete Zeitplan stellt nicht dieselbe Feiertagsausnahme wie DeepSeeks First-Party-Richtlinie her. Prüfen Sie die Abrechnungsbedingungen der gewählten Route für Ihre beabsichtigte Ausführungszeit.
Beispiel mit fester Token-Anzahl
Betrachten Sie eine Anfrage, die 100.000 ungecachte Input-Token verbraucht und 10.000 Output-Token generiert.
Wenn dies die vollständigen abgerechneten Token-Gesamten sind, beträgt die Token-Gebühr $0.150 für Terra, $0.021 für DeepSeek Off-Peak oder $0.042 für DeepSeek zu Peak-Zeiten. Die Off-Peak-Reduktion beträgt 86 %. Das Beispiel schließt zusätzliche Tool-Gebühren, Infrastruktur und Wiederholungen aus; getrennt gezählte Reasoning-Tokens müssen ebenfalls in die Berechnung einfließen.
Zu den gelisteten CometAPI-Basisraten kosten dieselben 100.000 Input- und 10.000 Output-Token $0.120 für Terra oder $0.0168 für Flash. Anwendung des gelisteten 2× Peak-Multiplikators ergibt $0.0336 für Flash. Dies sind reine Token-Berechnungen anhand der angegebenen Zählungen, keine Messungen einer tatsächlichen Aufgabe.
Wenn zusätzliche Ausgabe den Tokenpreisvorteil zunichte macht
Halten Sie ungecachten Input bei 100.000 Token und Terras insgesamt abgerechnete Ausgabe bei 10.000 Token. Terras standardmäßige Token-Rechnung beträgt dann $0.150. Flash erreicht die gleiche Rechnung bei 225.000 abgerechneten Output-Token Off-Peak oder 100.000 zu Peak-Raten. Diese Arithmetik isoliert das Ausgabevolumen; Caching, wiederholter Input, Tool-Gebühren und Wiederholungen verändern den Vergleich.
Kosten pro erfolgreicher Aufgabe
Bewerten Sie einen festen Aufgabenstapel und teilen Sie alle abgerechneten API- und Tool-Ausgaben durch die Anzahl der Aufgaben, die Ihre Abnahmekriterien bestehen. Zählen Sie die Ausgaben für fehlgeschlagene Versuche mit. Berichten Sie die Erfolgsquote neben diesen Kosten, damit ein Modell nicht allein dafür belohnt wird, nur die einfachsten Jobs abzuschließen.
Kosten pro erfolgreich abgeschlossener Aufgabe = Gesamte API- und Tool-Kosten / Erfolgreich abgeschlossene Aufgaben
Welche sollten Sie wählen: GPT-6.1 Terra oder DeepSeek-V4.1-Flash?
Wählen Sie entsprechend den Qualitätsanforderungen, Kostenzielen und Deployment-Bedürfnissen der Aufgabe. Nutzen Sie die oben genannten Benchmark-Ergebnisse, um zu entscheiden, welches Modell Sie zuerst testen.
Wann Sie GPT-6.1 Terra wählen sollten
Priorisieren Sie Terra für die Evaluierung, wenn komplexes Reasoning zentral für die Aufgabe ist. Für anspruchsvolle visuelle oder Computer-Use-Workflows nehmen Sie es in den Testsatz auf und messen abgeschlossene Aufgaben, Fehler und Recovery.
Die entscheidende Frage ist, ob Terra fehlgeschlagene Versuche und manuelle Korrektur soweit reduziert, dass der höhere Tokenpreis gerechtfertigt ist.
Wann Sie DeepSeek-V4.1-Flash wählen sollten
Beginnen Sie mit DeepSeek-V4.1-Flash für repetitive, hochvolumige Aufgaben mit klaren Abnahmekriterien und straffen Kostenzielen. Wählen Sie es, wenn die Outputs Ihre Qualitätsanforderungen zu geringeren Kosten pro erfolgreicher Aufgabe erfüllen.
DeepSeeks MIT-lizenzierte Gewichte machen es auch zur relevanten Option, wenn Selbsthosting eine Anforderung ist. Berücksichtigen Sie Hardware- und Betriebskosten in dieser Entscheidung.
Wann Sie beide Modelle testen sollten
Testen Sie beide, wenn Coding-Qualität, Tool-Zuverlässigkeit, Latenz oder Genauigkeit bei Langdokumenten kritisch ist. Verwenden Sie repräsentative Aufgaben mit denselben Inputs, Tools, Ausführungslimits und Abnahmekriterien.
Vergleichen Sie Erfolgsquote, Gesamtkosten pro erfolgreicher Aufgabe, End-to-End-Latenz und menschliche Korrekturzeit. Protokollieren Sie Modellversion und Reasoning-Einstellungen, damit die Ergebnisse reproduzierbar sind.
Ein hybrides Setup kann Routineaufgaben mit DeepSeek starten und ausgewählte Fehlschläge an Terra eskalieren. Messen Sie Kosten und Abschlussrate des gesamten Workflows, um zu bestätigen, dass der zusätzliche Modellaufruf sinnvoll ist.
Wo können Sie GPT-6.1 Terra und DeepSeek V4.1 Flash nutzen?
Verwenden Sie OpenAIs gehostete API für Terra oder DeepSeeks gehostete API für Flash. Bestätigen Sie die aktuelle Modellkennung, Kontolimits und den unterstützten Endpoint vor der Integration. Flash-1017s herunterladbare Gewichte bieten eine separate Selbsthosting-Option.
Zugriff über CometAPI
CometAPI bietet eine OpenAI-kompatible Schnittstelle, die die Entwicklung von Multi-Modell-Anwendungen vereinfachen kann.
Verwenden Sie die GPT-6.1 Terra API und die DeepSeek V4.1 Flash API mit einem gemeinsamen Text-Client und fügen Sie dann modellspezifische Steuerungen erst nach Prüfung der Unterstützung der Route hinzu.
Textantworten über CometAPI vergleichen
Um beide Modelle über einen Text-Client auszuprobieren, verwenden Sie das OpenAI Python SDK mit Ihrem CometAPI-Schlüssel und dem Endpoint https://api.cometapi.com/v1. Halten Sie den Schlüssel in einer Umgebungsvariable und senden Sie dann denselben Prompt an die Routen gpt-6.1-terra und deepseek-v4.1-flash und vergleichen Sie die zurückgegebenen Antworten und die Token-Nutzung.
Bitten Sie beispielsweise jedes Modell, einen Zahlungsworkflow zu überprüfen, der zeitüberschrittene Anfragen ohne Idempotency-Key erneut versucht und vollständige Request-Bodies protokolliert. Vergleichen Sie, wie klar die Antworten Zuverlässigkeits- und Datenschutzrisiken identifizieren und praktische Korrekturen erklären. Ein gemeinsamer Prompt macht die Antworten leichter prüfbar, aber eine Standard-Textanfrage gleicht keine Reasoning-Budgets aus und begründet kein Leistungsranking. Bestätigen Sie den Checkpoint, den jede Route bereitstellt, bevor Sie ein Ergebnis als Evidenz über Flash-1017 behandeln.
Fazit
GPT-6.1 Terra bietet das derzeit stärkere aggregierte Reasoning-Ergebnis, während DeepSeek Flash-1017 niedrigere Tokenpreise, schneller gemessene Output-Generierung und Deployment mit offenen Gewichten kombiniert. Die sinnvolle Wahl ist das Modell, das Ihre Qualitäts- und Latenzanforderungen zum niedrigsten Gesamtkostenpunkt erfüllt.
Beginnen Sie mit einer repräsentativen Arbeitslast, halten Sie Tool-Umgebung und Abnahmekriterien konstant und vergleichen Sie die Kosten erfolgreicher Abschlüsse. Eine gemeinsame CometAPI-Textintegration kann diese Evaluierung erleichtern, während modellspezifische Funktionen weiterhin ihre eigene Konfiguration benötigen.
FAQ
Warum kann dieselbe Aufgabe unterschiedliche Token-Rechnungen mit Terra und Flash-1017 erzeugen?
Ein Textprompt wird nicht zwangsläufig zu derselben Anzahl Token in zwei Modellen. Generierte Antworten und Reasoning-Längen können ebenfalls variieren. Vergleichen Sie die von jeder Route gemeldete Nutzung für identische Aufgaben, einschließlich gecachter und abgerechneter Reasoning-Tokens, statt beide Preislisten auf eine geschätzte Tokenzahl anzuwenden.
Können GPT-6.1 Terra und DeepSeek V4.1 Flash sich einen Prompt-Cache teilen?
Sie können den Prompt-Text in Ihrer Anwendung wiederverwenden, aber gehen Sie nicht davon aus, dass ein für ein Modell oder einen Anbieter erzeugter Cache die Rechnung des anderen reduziert. Cache-Berechtigung und -Abrechnung sind route-spezifisch. Prüfen Sie die Nutzungsfelder jeder Antwort und testen Sie wiederholte Anfragen, bevor Sie Einsparungen in eine Prognose einplanen.
Wie sollte ich strukturierte Ausgaben von Terra und Flash-1017 validieren?
Definieren Sie vor der Modellauswahl die benötigten Felder und Typen in Ihrer Anwendung. Wenn eine Route JSON oder schema-beschränkte Ausgaben bietet, prüfen Sie den genauen Modus, den sie unterstützt, und parsen Sie die Antwort, um sie gegen Ihr Schema zu validieren. Behandeln Sie fehlende Felder, ungültige Werte, abgeschnittene Ausgaben und Verweigerungen als getrennte Ergebnisse. Gültiges JSON allein belegt nicht, dass die extrahierten Fakten korrekt sind.