Mit CometAPI entwickelnEine API für mehrere Modelle erforderlich?Teste den Workflow im Playground und erstelle anschließend einen API-Schlüssel, sobald Modell und Kosten zu deinem Anwendungsfall passen.
GPT-6.1 Terra gegen GPT-6.1 Sol: Benchmarks, Preise und welche Wahl Sie treffen sollten
Vergleichen Sie GPT-6.1 Terra und GPT-6.1 Sol in Bezug auf offizielle Benchmarks, Reasoning, API-Preise und praktische Workloads, mit einem CometAPI-Python-Beispiel.
Beginnen Sie mit GPT-6.1 Terra für Aufgaben mit hohem Volumen, verifizierbaren Ergebnissen und hoher Kostensensitivität. Evaluieren Sie GPT-6.1 Sol für komplexes Coding, mehrstufige Tool-Nutzung und Workflows, bei denen Fehler teuer sind. Eine praktische Voreinstellung ist, zunächst Terra zu verwenden und bei Fehlschlagen vordefinierter Tests oder Validierungen auf Sol zu eskalieren.
Key Takeaways
Standard-Tokenpreise: Auf OpenAI Standard kostet Terra $1 pro Million Eingabetokens und $5 pro Million Ausgabetokens; Sol kostet entsprechend $2 bzw. $10.
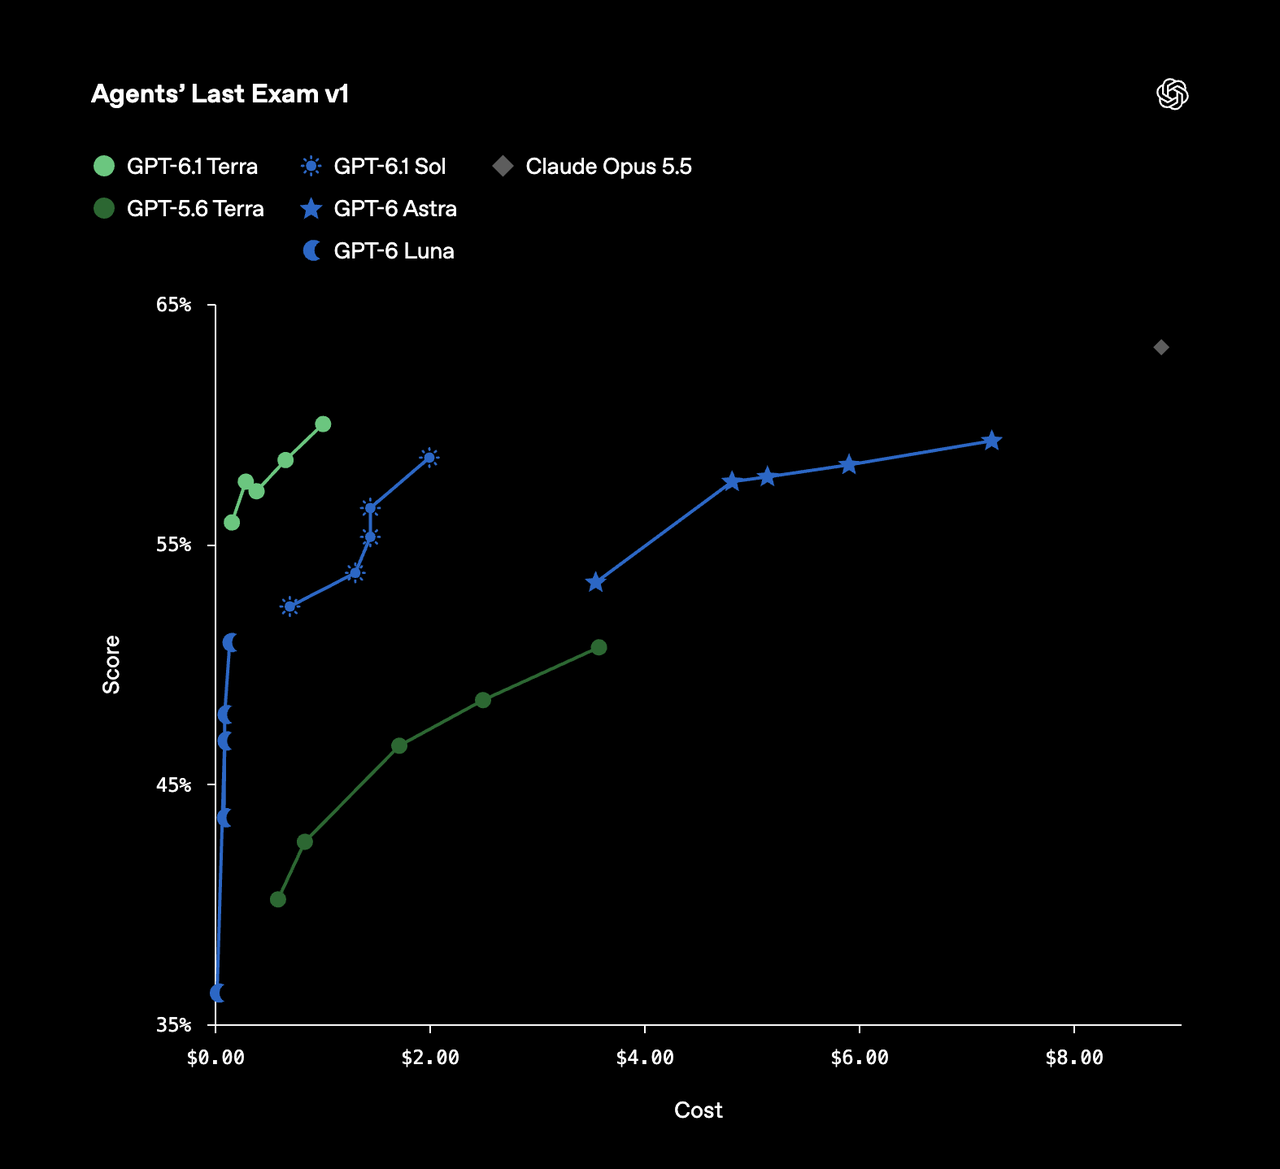
Aufgabenbezogene Performance: Bei maximalem Reasoning-Aufwand liegt Terra knapp bei Agents’ Last Exam v1 und Terminal-Bench-Science 0.1 vorn, während Sol bei Terminal-Bench 4.0 und OSWorld 2.1 führt.
Gemeinsame Kontextkapazität: Beide Modelle bieten ein Kontextfenster von 1,05 Millionen Tokens und akzeptieren Text- und Bild-Eingaben.
Unterschiedliche Reasoning-Kontrollen: Terra unterstützt das Deaktivieren von Reasoning mit ; Sol erfordert mindestens Reasoning-Aufwand.
Weiterlernen
Diesen Artikel mit der nächsten Entscheidung verknüpfen.
Auf Klarheit, Quellenangabe und aktuelle API-Terminologie geprüft.
none
low
Operative Kosten zählen: Vergleichen Sie die Ausgaben pro erfolgreich abgeschlossener Aufgabe, einschließlich Wiederholungen und Tool-Aufrufen, und erfassen Sie die Kosten für menschliche Überprüfung separat.
GPT-6.1 Terra vs GPT-6.1 Sol: Überblick und Spezifikationen
Die folgende Übersicht fasst die Abwägungen zusammen. Die detaillierten Abschnitte erläutern die Evidenz, Abrechnungsannahmen und Grenzen hinter jeder Entscheidung.
Entscheidungsfaktor
GPT-6.1 Terra
GPT-6.1 Sol
Ausgangs-Workload
Routine-Visual-Aufgaben und wiederholbare Agents
Komplexes Coding und nachhaltiges professionelles Reasoning
Kontext und Modalitäten
Gleiche Gesamtkontextkapazität; Text- und Bildinput
Gleiche Gesamtkontextkapazität; Text- und Bildinput
Reasoning-Kontrolle
Enthält eine Option zum Deaktivieren von Reasoning
Erfordert mindestens geringen Reasoning-Aufwand
Veröffentlichtes Leistungsbild
Niedrigkosten-Performance bei wiederholbaren Agent-Aufgaben
Stärker bei mehreren schwierigen Coding- und Desktop-Tests
API-Zugriff
OpenAI und CometAPI
OpenAI und CometAPI
GPT-6.1 Terra: Effiziente visuelle und Agent-Workflows
OpenAI stellte GPT-6.1 Terra am 26. Oktober 2026 vor. Es kombiniert visuelles Reasoning, Computer-Nutzung und generelle Textgenerierung für routinierte professionelle Workflows. Die niedrigeren Tokenpreise machen es zu einem nützlichen Ausgangspunkt, wenn Aufgaben häufig sind und Ergebnisse überprüft werden können.
GPT-6.1 Sol: Komplexes Coding und professionelles Reasoning
GPT-6.1 Sol wurde am 29. September 2026 eingeführt. Es zielt auf anspruchsvolles Coding und professionelle Arbeit ab. Evaluieren Sie es, wenn ein unbekanntes Repository, eine lange Kette abhängiger Schritte oder teure Korrekturen zusätzlichen Reasoning-Aufwand sinnvoll machen.
Kontext, Reasoning und API-Spezifikationen
Spezifikation
GPT-6.1 Terra
GPT-6.1 Sol
Offizielles Veröffentlichungsdatum
26. Oktober 2026
29. September 2026
API-Modell-ID
gpt-6.1-terra
gpt-6.1-sol
Kontextfenster
1.050.000 Tokens
1.050.000 Tokens
Wissensstand
1. Juni 2026
30. April 2026
Input/Output
Text und Bilder / Text
Text und Bilder / Text
Reasoning-Aufwand
none, low, medium, high, xhigh, max
low, medium, high, xhigh, max
Standard-Reasoning-Aufwand
medium
medium
API-Funktionen: Beide Modelle unterstützen Structured Outputs, Streaming und die Batch API. Tool-Aufrufe nutzen die Responses API, Fine-Tuning wird nicht unterstützt. Stellen Sie sicher, dass Ihr gewählter Provider und Endpunkt die Funktionen bietet, die Ihre Anwendung benötigt.
Beide Modelle erlauben bis zu 128.000 Ausgabetokens innerhalb eines Kontextfensters von 1.050.000 Tokens. Wenn die volle Ausgabekapazität reserviert wird, bleiben 922.000 Tokens für den Rest des Austauschs, einschließlich Ihres Inputs, Systemanweisungen und Tool-Historie. Dies ist eine Planungsrechnung, keine separate feste Input-Grenze.
Architektur-Offenlegung: Die verlinkten öffentlichen Modellspezifikationen liefern nicht genügend interne Architekturdaten für einen verlässlichen Vergleich. Kontextkapazität und Reasoning-Einstellungen sollten nicht als Beleg für Parameteranzahl oder Architektur interpretiert werden.
Reasoning-Kontrollen: Terras none-Einstellung ist nützlich für einfache Transformationen und Extraktionen. Verwenden Sie für den ersten Vergleich auf beiden Modellen dieselbe unterstützte Reasoning-Einstellung und optimieren Sie anschließend jedes Modell hinsichtlich der für Ihren Workload erforderlichen Qualität und Latenz.
Beide Modelle haben die gleiche veröffentlichte Kontextkapazität, was jedoch keine identische Retrieval-Genauigkeit oder Long-Context-Reasoning-Qualität impliziert. Die Modellauswahl sollte daher Reasoning-Qualität, Workflow-Effizienz, Kosten und aufgabenspezifische Retrieval-Performance berücksichtigen.
GPT-6.1 Terra vs GPT-6.1 Sol: Performance
Die berichteten Ergebnisse zeichnen ein gemischtes Bild: Terra liegt bei einigen Agenten- und wissenschaftlichen Coding-Evaluierungen knapp vorn, während Sol bei allgemeinem Terminal-Coding, Desktop-Automatisierung und Vision höher punktet. Die folgenden Vergleiche trennen OpenAIs Launch-Ergebnisse von unabhängigen Evaluierungen und erläutern, was diese über die Produktionsleistung aussagen – und was nicht.
Offizielle Benchmark-Ergebnisse und Testbedingungen
Die folgenden Ergebnisse stammen aus den Terra-Launch-Evaluierungen von OpenAI. Terra wird bei medium und maximalem Reasoning-Aufwand gezeigt; Sol wird bei maximalem Aufwand gezeigt. Die letzte Spalte vergleicht nur die Konfigurationen mit maximalem Aufwand.
OSWorld verwendet die Offline-Evaluierung 2.1. Der Faktizitätstest nutzt interne OpenAI-Prompts, die Fehler provozieren sollen. Dies sind anbieterseitig berichtete Ergebnisse aus spezifischen Evaluierungs-Setups und keine Messungen Ihres Produktions-Workloads.
Benchmark
GPT-6.1 Terra (medium)
GPT-6.1 Terra (max)
GPT-6.1 Sol (max)
Vergleich bei maximalem Aufwand
Agents’ Last Exam v1
57.60%
60.00%
58.60%
Terra +1.4 pp
MMMU-Pro (Vision)
84.60%
85.50%
86.30%
Sol +0.8 pp
OSWorld 2.1, offline
66.70%
74.20%
78.00%
Sol +3.8 pp
Terminal-Bench 4.0
35.80%
50.30%
55.90%
Sol +5.6 pp
Terminal-Bench-Science 0.1
34.30%
58.30%
57.00%
Terra +1.3 pp
Faktische Fehlerrate bei schwierigen Prompts
10.10%
4.30%
4.40%
Terra 0.1 pp niedriger
Alle Werte sind Prozentsätze; Unterschiede werden in Prozentpunkten (pp) angegeben. Nur bei der faktischen Fehlerrate ist niedriger besser. Der Unterschied von 0,1 Punkten bei der Fehlerrate allein begründet keinen bedeutenden Zuverlässigkeitsvorteil.
Für Software Engineering deuten Sols Vorsprung bei Terminal-Bench und Terras knapper Vorsprung bei Terminal-Bench-Science darauf hin, dass die Ergebnisse vom Typ der Coding-Aufgabe abhängen. Für Anwendungs-Workflows stützt Sols höherer OSWorld-Wert die Evaluierung für Desktop-Automatisierung, während Terras Ergebnis bei Agents’ Last Exam es als Kandidaten für professionelle Agentenaufgaben ausweist. Keines der Muster begründet einen universellen Sieger.
Agent-Scaffolding, Toolzugriff und Umgebungskonfiguration können diese Ergebnisse beeinflussen. Nutzen Sie die Werte zur Identifikation von Testkandidaten und validieren Sie sie anschließend an den Repository-Änderungen und Anwendungs-Workflows, die Sie tatsächlich erledigen müssen.
Die Agents’ Last Exam v1-Grafik von OpenAI stellt die Werte gegenüber den geschätzten Aufgabenkosten über Modellkonfigurationen hinweg dar. Sie ergänzt die obige Tabelle um eine Kosteneffizienz-Perspektive; die dargestellten Kosten sind spezifisch für das Evaluierungs-Setup.
Unabhängige Intelligenz- und Coding-Evaluierungen
Die Auswertung von Artificial Analysis vom 26. Oktober ordnet Terra beim maximalen Reasoning-Aufwand vier Punkte unter Sol auf dem Intelligence Index ein. Der Coding Agent Index v2.0 gibt Terra 48 und Sol 54. Dies sind separate Evaluierungen mit eigenen Methoden und Bewertungsskalen; sie sollten nicht numerisch mit den Benchmark-Ergebnissen von OpenAI kombiniert werden.
Die gleiche Analyse identifiziert Terras niedrige und mittlere Reasoning-Einstellungen als besonders kosteneffizient in der Intelligenz-Evaluierung. Das unterstützt Tests praktischer Konfigurationen neben Einstellungen mit maximalem Aufwand. Evaluierungskosten bleiben spezifisch für das Test-Setup und sollten nicht als Schätzung der Ausgaben Ihrer Anwendung betrachtet werden.
Geschwindigkeit und Latenz: Aufgabenerfüllung vs. Tokengenerierung
OpenAI berichtet, dass Terra die evaluierten Aufgaben von Agents’ Last Exam mehr als dreimal schneller abschließt als Sol. Dies ist eine End-to-End-Aufgabenmessung, die Reasoning und Software-Interaktionen einschließt. Sie impliziert weder eine dreifach höhere Ausgabetoken-Durchsatzrate noch denselben Geschwindigkeitsschub für jede API-Anfrage.
Für interaktive Anwendungen unterscheiden Sie zwischen Zeit bis zum ersten Token, die die Wartezeit bis zum Beginn der Ausgabe misst, und Ausgabetokens pro Sekunde, die misst, wie schnell die Antwort fortschreitet. Für Agents hat End-to-End-Abschlusszeit Priorität, einschließlich Tool-Aufrufen, Wiederholungen und Recovery.
Vergleichen Sie beide Modelle mit denselben Prompts, Tools, unterstützten Reasoning-Einstellungen und Abnahmekriterien. Erfassen Sie Latenz zusammen mit Aufgabenerfolg: Eine schnellere Antwort hat begrenzten Wert, wenn sie mehr Korrektur erfordert oder den Workflow nicht abschließt.
Vision- und Long-Context-Performance: Was die Ergebnisse belegen
Sols Vorsprung von 0,8 Prozentpunkten bei MMMU-Pro mit maximalem Aufwand ist ein berichtetes Vision-Ergebnis und keine Garantie für bessere Performance in jedem visuellen Workflow. Testen Sie kleine Beschriftungen, schlechte Scans, dichte Diagramme und unbekannte Layouts mit repräsentativen Eingaben.
Die oben genannten Evaluierungen belegen nicht, welches Modell bei Long-Context-Retrieval oder -Reasoning besser ist. Obwohl beide die gleiche veröffentlichte Kontextkapazität haben, belegt Kapazität allein weder Retrieval-Genauigkeit noch Gedächtnis über Sitzungen hinweg. Testen Sie, ob jedes Modell relevante Belege in Ihren Dokumenten finden und nutzen kann, und halten Sie den Anwendungszustand explizit zwischen Anfragen aufrecht.
GPT-6.1 Terra vs GPT-6.1 Sol: Kosten
Tokenpreise sind der Ausgangspunkt für den Kostenvergleich. Wiederholungen, Reasoning-Tokens, Tool-Aufrufe und menschliche Überprüfung beeinflussen ebenfalls, wie viel Sie für den erfolgreichen Abschluss einer Aufgabe ausgeben.
Die folgenden Sätze sind in USD pro Million Tokens und Preise.
Provider und Tokenkategorie
GPT-6.1 Terra
GPT-6.1 Sol
OpenAI Standard — Input
$1.00
$2.00
OpenAI Standard — gecachter Input
$0.05
$0.10
OpenAI Standard — Output
$5.00
$10.00
OpenAI Standard — 30-min Cache Write
$1.25
$2.50
OpenAI Standard — 12-h Cache Write
$2.50
$5.00
CometAPI gewöhnlicher Input
$0.80
$1.60
CometAPI gewöhnlicher Output
$4.00
$8.00
OpenAI API Pricing
Terras gelistete Standardtarife liegen in diesen Kategorien bei der Hälfte von Sols. Die tatsächlichen Gebühren hängen von der Anfragestruktur ab: Long-Context-Anfragen, Verarbeitungsebenen, regionale Verarbeitung und Tool-Nutzung können unterschiedliche Bedingungen haben. Prüfen Sie die maßgebliche OpenAI-Preisdokumentation, bevor Sie Produktionskosten schätzen.
CometAPI Pricing
CometAPI ist ein Drittanbieter-Zugangsweg mit eigener Preisgestaltung und Feature-Verfügbarkeit. Die gelisteten gewöhnlichen Input- und Output-Preise sind unten separat aufgeführt.
Zu diesen Sätzen liegen CometAPIs gewöhnliche Input- und Output-Preise 20% unter den oben genannten OpenAI-Standardpreisen. Bestätigen Sie aktuelle Preise, Long-Context-Gebühren, Caching-Unterstützung und Tool-Verfügbarkeit für Ihr Konto vor dem Deployment.
Beispielkosten für 1.000 Anfragen
Angenommen, eine Anwendung stellt 1.000 Anfragen, die jeweils 2.000 nicht gecachte Eingabetokens und 500 abrechenbare Ausgabetokens verwenden. Dies ergibt insgesamt 2 Millionen Eingabetokens und 500.000 Ausgabetokens.
Für 1.000 Anfragen, jeweils mit 2.000 nicht gecachten Eingabetokens und 500 abrechenbaren Ausgabetokens, ergeben sich die geschätzten Kosten:
Terra über OpenAI: $2.00 für Input und $2.50 für Output, insgesamt $4.50.
Sol über OpenAI: $4.00 für Input und $5.00 für Output, insgesamt $9.00.
Terra über CometAPI: $1.60 für Input und $2.00 für Output, insgesamt $3.60.
Sol über CometAPI: $3.20 für Input und $4.00 für Output, insgesamt $7.20.
Diese Berechnungen nutzen die oben genannten gewöhnlichen Sätze ohne Batch-API-Rabatt. Cache Writes, separate Tool-Gebühren und Wiederholungen sind ausgeschlossen. Alle als Output abgerechneten Reasoning-Tokens müssen in die Output-Gesamtsumme einfließen.
Effektive Kosten pro erfolgreicher Aufgabe
In diesem Artikel ist eine erfolgreiche Aufgabe eine solche, die die vordefinierte Qualität, ggf. das Schema und die Abschlussprüfungen ohne zusätzliche manuelle Korrektur besteht.
Niedrigere Tokenpreise führen nicht immer zu niedrigeren Betriebskosten. Terras Einsparungen können schrumpfen, wenn mehr Versuche, Reasoning-Tokens oder menschliche Eingriffe nötig sind. Sols höhere Sätze können sich lohnen, wenn mehr Aufgaben beim ersten Versuch erfolgreich abgeschlossen werden.
Effektive Modell-und-Tool-Kosten pro erfolgreicher Aufgabe = gesamte Ausgaben für Modell und Tools über alle Versuche ÷ Anzahl erfolgreicher Aufgaben.
Erfassen Sie die Kosten für menschliche Überprüfung und Korrektur separat. Wählen Sie das Modell, das Ihr Qualitätsziel zu den niedrigsten kombinierten Kosten erreicht, statt allein Tokenpreise zu vergleichen.
Welches Modell sollten Sie wählen: GPT-6.1 Terra oder GPT-6.1 Sol?
Wählen Sie basierend auf Aufgabenkomplexität, verifizierbarer Output-Qualität und Gesamterfüllungskosten. Terra ist ein nützlicher Ausgangspunkt für Routine-Workflows; Sol lohnt die Evaluierung, wenn schwieriges Reasoning oder teure Fehler zusätzlichen Aufwand rechtfertigen.
Wann GPT-6.1 Terra wählen
Beginnen Sie mit Terra für hochvolumige Extraktion, Dokumententwürfe, Katalogabgleich und vorhersehbare Anwendungs-Workflows. Diese Aufgaben sind gute Kandidaten, wenn Ergebnisse gegen Quelldokumente, Pflichtfelder oder automatisierte Validierungsregeln geprüft werden können.
Wählen Sie Terra, wenn es Ihre Genauigkeits- und Abschlussziele innerhalb des erlaubten Budgets für Wiederholungen und menschliche Überprüfung erfüllt. Niedrigere Tokenpreise sind wenig wert, wenn wiederholte Fehlschläge die Einsparungen aufzehren.
Wann GPT-6.1 Sol wählen
Evaluieren Sie Sol für schwieriges Debugging, Repository-Änderungen mit vielen Abhängigkeiten und Desktop-Workflows mit langen Ketten abhängiger Aktionen.
Wählen Sie Sol, wenn Tests zeigen, dass es mehr akzeptierte Patches erzeugt, mehr Tests besteht oder weniger manuelle Korrektur erfordert. Die höheren Tokenkosten sind gerechtfertigt, wenn diese Verbesserungen die Gesamtkosten der Aufgabenerfüllung senken.
Wann Terra zuerst nutzen und auf Sol eskalieren
Ein hybrider Workflow kann Terra für den ersten Versuch nutzen und auf Sol eskalieren, wenn vordefinierte Prüfungen scheitern. Basieren Sie die Eskalation auf beobachtbaren Ergebnissen statt ausschließlich auf der Modellkonfidenz.
Beispiel für einen Codegenerierungs-Workflow:
Terra die gewünschte Änderung erzeugen lassen.
Die relevanten Tests und Validierungen ausführen.
Auf Sol eskalieren, wenn die Änderung diese Prüfungen nicht besteht oder außerhalb von Terras verifizierter Fähigkeit liegt.
Nicht gelöste Fälle zur manuellen Prüfung geben, sobald das Wiederholungsbudget erschöpft ist.
Bewahren Sie bei Eskalation die ursprüngliche Anfrage, relevanten Kontext, das fehlgeschlagene Output und die Validierungsergebnisse auf. Protokollieren Sie die Nutzung beider Modelle, damit der Kostenvergleich den gesamten Workflow umfasst.
Produktions-Evaluierungs-Checkliste
Vor der Auswahl eines Standardmodells oder der Einführung eines Eskalations-Workflows:
Repräsentative Aufgaben nutzen: Schließen Sie Routineanfragen und Fälle ein, bei denen Fehler teuer sind.
Vergleiche kontrolliert halten: Vergleichbare Anweisungen, Belege, Tools und Abnahmekriterien verwenden. Modell-IDs, Endpunkte, Reasoning-Einstellungen und Testdaten erfassen.
Akzeptierte Ergebnisse messen: Genauigkeit, ggf. Schema-Gültigkeit, Testergebnisse und Abschluss ohne manuelle Korrektur prüfen.
Zeit und Ausgaben messen: Median- und Tail-Latenz, abgerechnete Tokens, Tool-Aufrufe, Wiederholungen und Aufwand für menschliche Überprüfung erfassen.
Vergleich wiederholen: Aufgaben mehrfach ausführen und die Modellreihenfolge alternieren, um Einmal-Effekte zu reduzieren.
Betriebsgrenzen definieren: Wiederholungsbudgets, Eskalationsauslöser und Anforderungen an menschliche Freigaben vor dem Deployment festlegen.
Den kompletten Workflow vergleichen: Fehlgeschlagene Versuche und Eskalationskosten in die Ausgaben pro erfolgreicher Aufgabe einbeziehen.
Wo erhalten Sie Zugriff auf GPT-6.1 Terra und GPT-6.1 Sol?
Offizieller Provider-Zugang
Beide Modelle sind über die OpenAI API verfügbar. Für Textanfragen wird Chat Completions unterstützt; Tool-Aufrufe erfordern die Responses API. Bestätigen Sie die unterstützten Parameter des Modells, Ihre Kontolimits und die verfügbaren Tools auf dem von Ihnen vorgesehenen Weg.
CometAPI-Zugang
Um eines der Modelle über CometAPI zu nutzen, folgen Sie der Quickstart-Anleitung, um das OpenAI-kompatible SDK einzurichten. Übergeben Sie Ihren CometAPI-Key sicher über die Umgebungsvariable COMETAPI_KEY und setzen Sie die Base-URL auf https://api.cometapi.com/v1. Wählen Sie gpt-6.1-terra oder gpt-6.1-sol als Modellbezeichner und bestätigen Sie, dass die Route für Ihr Konto aktiviert ist.
Für einen ersten Vergleich geben Sie beiden Modellen dieselben repräsentativen Aufgaben und verwenden medium Reasoning-Aufwand. Halten Sie Anweisungen und Abnahmekriterien konsistent, wiederholen Sie jede Aufgabe und alternieren Sie die Modellreihenfolge. Vergleichen Sie erfolgreiche Ergebnisse, verstrichene Zeit, abgerechnete Tokens und Wiederholungen, statt eines der Modelle anhand einer einzelnen Antwort zu bewerten.
Conclusion
Beginnen Sie mit GPT-6.1 Terra für häufige, verifizierbare Workflows, bei denen niedrigere Tokenpreise und schnellere Aufgabenerfüllung zählen. Evaluieren Sie GPT-6.1 Sol, wenn schwieriges Coding, mehrstufige Tool-Nutzung oder teure Fehler höhere Reasoning-Fähigkeit wertvoll machen. Die endgültige Wahl sollte auf den Kosten pro akzeptierter Aufgabe unter einem repräsentativen Evaluierungssatz basieren, nicht auf Preis oder einem einzelnen Benchmark.
Für viele Anwendungen ist der sinnvolle nächste Schritt ein kleiner, repräsentativer Versuch mit klaren Bestehensbedingungen und einem begrenzten Eskalationspfad. Lassen Sie das gemessene Ergebnis das Modell bestimmen, statt sich auf Preis oder einen einzelnen Benchmark zu verlassen.
GPT-6.1 Terra gegen GPT-6.1 Sol: Benchmarks, Preise und welche Wahl Sie treffen sollten - CometAPI