
Grok 4.7 Release-Update: Von Prognosen zur offiziellen Verfügbarkeit
Information geprüft: 16. Oktober 2026.
Grok 4.7 wurde offiziell am 21. September 2026 veröffentlicht. Frühere Hinweise auf einen Launch am 12. September waren Vorab-Schätzungen und sollten nicht als tatsächliches Veröffentlichungsdatum betrachtet werden.
Die offizielle Launch-Ankündigung beschreibt Verbesserungen bei Coding, Wissensarbeit, länger laufenden Aufgaben und der Verifikation eigener Modellergebnisse. Sie bestätigt die Verfügbarkeit über die Grok API, Cursor und Grok Build. Für die genaue API-Modell-ID, unterstützte Funktionen, Kontextgrenzen und aktuelle Preise siehe die offizielle Grok 4.7-Dokumentation.
Offizielle Ergebnisse zeigen messbare Fortschritte gegenüber Grok 4.6. Beispielsweise meldet der Launch-Vergleich einen Terminal-Bench 4.0-Wert von 37,6 % für Grok 4.7 bei xhigh effort, verglichen mit 20,3 % für Grok 4.6 bei high effort. Dies sind vom Anbieter gemeldete Ergebnisse unter den angegebenen Evaluations-Einstellungen; die Anwendungsleistung hängt von Prompts, Tools, Reasoning-Aufwand und Aufgabenschwierigkeit ab.
Für Entwickler lautet die sinnvolle Frage jetzt, ob Grok 4.7 ihre Workloads zuverlässiger und wirtschaftlicher erledigt. Testen Sie es bei Repository-Änderungen, Dokumentenerstellung und mehrstufigen Tool-Workflows und messen Sie erfolgreiche Abschlüsse, Latenz, Wiederholungen und Gesamtkosten pro Aufgabe.
Quelle: Offizielle Grok 4.7-Launch-Ankündigung.
Wichtigste Erkenntnisse
- Das erwartete Datum 12. September wird aus Musks Zehntage-Countdown abgeleitet, nicht aus einer separat veröffentlichten xAI-Kalenderankündigung.
- Die 2,1T-Skala und SpaceX-Daten-Aussagen sind Vorab-Claims; aktive Parameter, Routing, Architektur und Trainingsmethodik bleiben unveröffentlicht.
- Grok 4.6 zeigt bereits starke Ergebnisse in Wissensarbeit und Agentik, darunter 61,3 % auf FrontierCode v1.1 (Extended), liegt aber auf mehreren schwierigen Coding-Evaluierungen hinter dem stärksten Vergleichsmodell.
- Grok 4.7 sollte anhand der Quote akzeptierter Aufgaben, Langzeit-Zuverlässigkeit, Token-Effizienz, Latenz und Kosten pro erfolgreichem Ergebnis beurteilt werden – nicht allein nach der Parameterzahl.
- CometAPI wird Grok 4.7 integrieren, sobald xAI das Modell offiziell veröffentlicht und Produktionszugang verfügbar ist; Entwickler sollten die Live-Modell-ID, den Preis und das Antwortverhalten vor einer Migration validieren.
Was ist Grok 4.7?
Grok 4.7 ist der angekündigte Nachfolger von Grok 4.6 und soll xAIs Fokus auf Coding, Engineering, lang laufende Agenten und professionelle Wissensarbeit fortsetzen. Die öffentliche Evidenz besteht derzeit aus Gründer‑Aussagen und einem Release-Countdown statt eines vollständigen technischen Launch-Pakets.
Die wichtigste Unterscheidung besteht zwischen drei Objekten: dem angekündigten Grok 4.7-Modell, den Vorab-Signalen zu möglicher Größe und Training sowie dem Live-Grok 4.6-Produktionsbaseline. Entwickler sollten Grok 4.7 als bevorstehenden Evaluierungs-Kandidaten betrachten, bis xAI finale Dokumentation veröffentlicht und eine Produktionsanfrage gegen den veröffentlichten Endpoint erfolgreich ist.
Grok 4.7: Veröffentlichungsdatum und Zeitplan
Wann wird Grok 4.7 voraussichtlich veröffentlicht?
Musks Aussage vom 2. September, dass das Modell in zehn Tagen komme, weist auf ungefähr den 12. September 2026 hin.
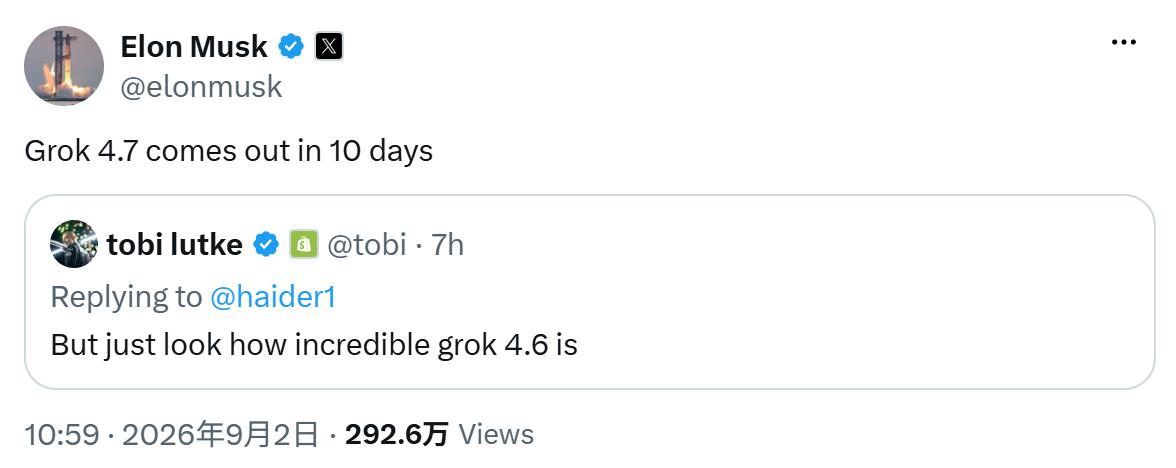
Quelle: Elon Musk auf X, 2. September 2026
Zeitplan zur Veröffentlichung von Grok 4.7
| Datum | Öffentliches Signal | Interpretation |
|---|---|---|
| Ende Juli 2026 | Musk beschrieb ein Modell mit ungefähr 2,1T, verbesserter Token-Effizienz und etwas langsamerem Serving. | Vom Gründer angegebene Modellgröße und Effizienz-Erwartungen. |
| 12. August 2026 | Das initiale Training wurde als abgeschlossen beschrieben; ergänzendes Training soll umfangreiche SpaceX-Daten beinhalten. | Update zum Trainingsfortschritt, keine Veröffentlichungbestätigung. |
| 2. September 2026 | „Grok 4.7 kommt in 10 Tagen.“ | Bisher der klarste öffentliche Release-Countdown. |
| 12. September 2026 | Kalenderdatum aus dem Countdown abgeleitet. | Erwartetes Ziel; finale Verfügbarkeit erfordert xAI-Release-Hinweis und funktionierenden Endpoint. |
Grok 4.7 Spezifikationen: Bestätigte vs. unbestätigte Informationen
Die nützlichste Lesart der aktuellen Informationen zu Grok 4.7 trennt direkte Gründeraussagen von Spezifikationen, die xAI nicht veröffentlicht hat. Der neue Post bestätigt nur den Modellnamen und einen Release-Countdown; er ergänzt keine technischen Parameter oder Benchmark-Ergebnisse.
| Spezifikation | Aktueller Grok 4.7-Status | Evidenzgrad |
|---|---|---|
| Release-Zeitpunkt | Um den 12. September, abgeleitet aus dem Zehntage-Countdown vom 2. September | Vom Gründer angekündigtes Ziel |
| Modellgröße | Ungefähr 2,1T Parameter | Vom Gründer angegeben |
| Initiales Training | Bis 12. August als abgeschlossen beschrieben | Vom Gründer angegeben |
| Ergänzendes Training | Enthält umfangreiche SpaceX-Unternehmensdaten | Vom Gründer angegeben |
| Relative Qualität | Als deutlich besser als Grok 4.6 behauptet | Unverifizierte Aussage |
| Token-Effizienz | Gegenüber Grok 4.6 als verbessert behauptet | Unverifizierte Aussage |
| Serving-Geschwindigkeit | Erwartet etwas langsamer | Vom Gründer angegeben |
| Kontextfenster | Von xAI nicht veröffentlicht | Unbekannt |
| Ein-/Ausgabe-Modalitäten | Von xAI nicht veröffentlicht | Unbekannt |
| Endgültige API-Modell-ID | In xAI-Dokumentation nicht bestätigt | Unbekannt |
| Offizielle Preise | Von xAI nicht veröffentlicht | Unbekannt |
| Offizielle Benchmarks | Für Grok 4.7 nicht veröffentlicht | Unbekannt |
Die Behauptung von ungefähr 2,1T Parametern gibt keine aktiven Parameter, Sparsity, Experten-Routing, Inferenzkosten oder effektiven Trainings-Compute preis. Die Parameteranzahl allein kann die Produktionsqualität nicht belegen.
Warum das SpaceX-Training-Signal wichtiger sein könnte als 2,1T
Die bedeutsamere Offenlegung könnte die Ergänzung durch SpaceX-Unternehmensdaten sein. Ein hochwertiger Engineering-Korpus könnte technisches Reasoning, Design, Debugging, Optimierung und langhorizontige Agentenarbeit verbessern, bei denen Aufgabenverteilung und Post-Training-Qualität oft wichtiger sind als bloße Skalierung.
Diese Richtung ist konsistent mit xAIs Modell-Release-Strategie. Der Grok 4.6-Trainingsbericht beschreibt einen längeren ergänzenden Trainingslauf mit hochwertigen Engineering-Daten, gefolgt von überwachtem Fine-Tuning und Reinforcement Learning über Coding, MINT, Webentwicklung, Kernel-Optimierung und Computer-Aided Design.
Das macht die Grok 4.7-Aussage technisch plausibel, aber nicht bewiesen. Ein echter Vorteil sollte nach der Veröffentlichung in reproduzierbaren Engineering-Tests, Aufgabenabschlussraten, Latenz und Kosten pro erfolgreichem Ergebnis sichtbar werden.
Grok 4.7 vs. Grok 4.6 Leistung: Was die Basis zeigt
Für Grok 4.7 existieren noch keine offiziellen Werte. Der verantwortbare Vergleichspunkt ist xAIs veröffentlichte Grok 4.6-Evaluation. Die vollständige Modellübersicht findet sich im CometAPI-Grok 4.6 Deep Dive; die Tabelle unten behält nur die für Entscheidungen relevantesten Benchmark-Zeilen.
| Offizielle Evaluation | Grok 4.6 High | Grok 4.5 High | GPT-5.6 Sol Max | Claude Fable 5 Max |
|---|---|---|---|---|
| AA Intelligence Index | 61 | 56 | 61 | 62 |
| GDPVal-AA v2 | 1753 | 1526 | 1728 | 1741 |
| CursorBench v3.2 | 69,9% | 66,7% | 67,2% | 70,5% |
| DeepSWE v1.1 | 65,9% | 54,0% | 73,0% | 70,0% |
| FrontierCode v1.1 (Extended) | 61,3% | 56,6% | 60,6% | 63,6% |
| Terminal-Bench v3.0 | 26,0% | 15,7% | 34,6% | 34,1% |
Baseline-Ergebnis: Grok 4.6 zeigt gegenüber Grok 4.5 auf jeder hier aufgeführten Zeile einen echten Vorteil. Es entspricht GPT-5.6 Sol im Gesamt-Intelligenzindex, führt diese Gruppe bei GDPVal-AA v2 an und liegt auf FrontierCode knapp vor GPT-5.6 Sol. Die wichtigsten veröffentlichten Lücken bleiben DeepSWE und Terminal-Bench.
Diese Ergebnisse setzen einen konkreten Standard für Grok 4.7. Wenn das größere Modell und das engineering-orientierte ergänzende Training in die Produktion übertragen werden, wäre der erwartete Durchbruch stärkere Coding-Resultate auf Repository-Ebene und Terminal-Aufgabenabschlüsse, ohne die Stärke von Grok 4.6 in Wissensarbeit zu verlieren. Ein glaubwürdiges Stretch-Ziel ist, mit dem veröffentlichten Claude Fable 5.1 bei Coding und lang laufenden Agenten-Workflows wettbewerbsfähig zu werden. Das ist eine zu testende Prognose, keine aktuelle Benchmark-Aussage.
Grok 4.7 vs. Grok 4.6: Erwartete Durchbrüche und Upgrade-Leitfaden
Die geleakten und vom Gründer genannten Signale deuten auf fünf Bereiche hin, in denen Grok 4.7 sich verbessern könnte. Da xAI keine finalen Evaluationsdaten veröffentlicht hat, sollte jede Erwartung in einen messbaren Akzeptanztest überführt werden.
Coding auf Repository-Ebene
Grok 4.6 ist bereits stark auf CursorBench und FrontierCode, aber seine DeepSWE- und Terminal-Bench-Ergebnisse lassen sichtbaren Verbesserungsbedarf. Grok 4.7 sollte höhere Patch-Akzeptanz, weniger Regressionen und bessere Kommandozeilen-Erholung auf denselben Repositories zeigen, bevor es 4.6 ersetzt.
Langzeit-Agenten-Zuverlässigkeit
Das SpaceX-Daten-Signal und xAIs bisherige Agenten-Trainingsrichtung deuten auf einen Fokus auf mehrstufige Engineering-Arbeit hin. Messen Sie abgeschlossene Workflows, fehlerhafte Tool-Aufrufe, Wiederholungen, menschliche Interventionen und Erholung nach Fehlern – nicht nur die Qualität des finalen Prosatexts.
Wissensarbeit und technisches Reasoning
Grok 4.6 führt die Vergleichsgruppe auf GDPVal-AA v2 an. Grok 4.7 sollte diesen Vorteil bewahren und zugleich die Übertragung auf Design-Reviews, Forschungssynthese, Debugging, Optimierung und andere komplexe technische Aufgaben verbessern.
Token-Effizienz
Ein größeres Modell kann pro erfolgreicher Aufgabe trotzdem günstiger sein, wenn es korrekte Ergebnisse in weniger Schritten erreicht. Vergleichen Sie Gesamt‑Input, gecachten Input, Output-Tokens, Wiederholungen und Kosten für dasselbe akzeptierte Ergebnis.
Bereitstellungs-Abwägungen
Wenn Grok 4.7 langsamer ist, müssen Qualitätsgewinne die Latenz überwiegen. Protokollieren Sie Zeit bis zum ersten Token, nachhaltigen Durchsatz, Wall‑Time zur Aufgabenkomplettierung, Fehlerrate und Kosten unter realistischer Parallelität.
Grok 4.7 Benchmarks: 5 Tests, um ein echtes Upgrade gegenüber Grok 4.6 zu verifizieren
- Software-Engineering-Erfolg: Messen Sie gelöste Issues, bestandene Tests, Regressionsrate und Patch-Akzeptanz auf repräsentativen Repositories.
- Langhorizontige Agenten-Zuverlässigkeit: Verfolgen Sie abgeschlossene Workflows, Tool-Call-Fehler, Wiederholungen, Erholung und menschliche Eingriffe über mehrstufige Läufe.
- Realwelt-Engineering-Transfer: Testen Sie Design, Debugging, Optimierung, wissenschaftliches Reasoning und CAD-bezogene Aufgaben mit offengelegten Bewertungskriterien.
- Token-Effizienz pro erfolgreicher Aufgabe: Vergleichen Sie Gesamtzahl der Tokens und Ausgaben, die erforderlich sind, um dasselbe akzeptierte Ergebnis zu erreichen.
- Latenz und Kosten unter Produktionslast: Evaluieren Sie Zeit bis zum ersten Token, Durchsatz, Wall‑Time, Fehlerrate und Kosten bei realistischer Parallelität.
Was Entwickler vor dem 12. September tun sollten – und wie CometAPI passt
Pre-Launch-Checkliste für Entwickler
- Erstellen Sie ein fixes Evaluierungsset aus realen Coding-, Forschungs-, Engineering- und Agenten-Workflows.
- Führen Sie es gegen Grok 4.6 aus und protokollieren Sie Erfolgsrate, Wiederholungen, Tool-Aufrufe, Latenz, Tokens und Gesamtkosten.
- Halten Sie die Modellauswahl konfigurierbar und vermeiden Sie das Hardcoding einer vorläufigen Grok 4.7‑Kennung.
- Beobachten Sie die xAI Release Notes und die CometAPI-Modellseite auf bestätigte Verfügbarkeit.
- Verifizieren Sie nach dem Launch Kontext, Modalitäten, Reasoning-Kontrollen, Preise, Rate-Limits und Umfang des Rollouts.
- Spielen Sie dasselbe Evaluierungsset erneut durch, bevor Sie Produktionstraffic umleiten.
CometAPI bietet eine einheitliche API-Schicht für den Zugriff auf mehrere KI-Modellanbieter über ein Konto und ein Integrationsmuster. Eine Grok 4.7 Tracking-Seite ist bereits verfügbar. CometAPI wird Grok 4.7 integrieren, sobald xAI das Modell offiziell veröffentlicht und Produktionszugang verfügbar ist.
Bis dahin sollten alle Vorab-Kennungen, Preise oder Fähigkeitsfelder als vorläufig betrachtet werden. Bevor Produktionstraffic gesendet wird, bestätigen Sie, dass die Route live ist, eine echte Anfrage erfolgreich ist, das zurückgegebene Modell die beabsichtigte Version ist und die aktuellen Preise in der Konsole sichtbar sind.
Grok 4.7 Preis-Ausblick vs. Grok 4.6
Der veröffentlichte Standardtarif für Grok 4.6 beträgt $2 pro 1 Million Input-Tokens und $6 pro 1 Million Output-Tokens unterhalb der Langkontext-Schwelle. xAIs Release Notes führen höhere Tarife für Anfragen über 200.000 Prompt-Tokens auf. Preise für Grok 4.7 wurden nicht offiziell angekündigt.
| Veröffentlichte Preisbasis | Input / 1M | Output / 1M | Status |
|---|---|---|---|
| Grok 4.6, Prompt unter 200K | $2 | $6 | Veröffentlicht |
| Grok 4.6, Prompt über 200K | $4 | $12 | Veröffentlichte Langkontext-Stufe |
| Grok 4.7 | Nicht angekündigt | Nicht angekündigt | Nach offiziellem Launch bestätigen |
Drei Preisrichtungen bleiben plausibel: Parität mit Grok 4.6 zur Beschleunigung der Adoption, eine Premium-Stufe, falls die Serving-Kosten materiell höher sind, oder getrennte Tarife nach Kontextlänge und Geschwindigkeit. Dies sind Planungsszenarien, keine xAI-Prognose.
Pre-Launch-Checkliste für Entwickler
- Erstellen Sie ein fixes Evaluierungsset aus realen Coding-, Forschungs-, Engineering- und Agenten-Workflows.
- Führen Sie es gegen Grok 4.6 aus und protokollieren Sie Erfolgsrate, Wiederholungen, Tool-Aufrufe, Latenz, Tokens und Gesamtkosten.
- Halten Sie die Modellauswahl konfigurierbar und vermeiden Sie das Hardcoding einer vorläufigen Grok 4.7‑Kennung.
- Beobachten Sie die xAI Release Notes und die CometAPI-Modellseite auf bestätigte Verfügbarkeit.
- Verifizieren Sie nach dem Launch Kontext, Modalitäten, Reasoning-Kontrollen, Preise, Rate-Limits und Umfang des Rollouts.
- Spielen Sie dasselbe Evaluierungsset erneut durch, bevor Sie Produktionstraffic umleiten.
Grok 4.7: Was als Nächstes zu beobachten ist
Vier Ereignisse würden den aktuellen Countdown in einen verifizierbaren Produktlaunch verwandeln: ein offizieller xAI-Release-Post; Modelldokumentation zu Kontext, Modalitäten und Reasoning-Kontrollen; finale API-Preise und Modellkennungen; sowie reproduzierbare Benchmark- oder Produktionsevaluierungen.
Die nützlichste Launch-Frage ist nicht, ob 2,1T groß klingt. Sondern ob Grok 4.7 schwierige Engineering- und Agentenaufgaben zuverlässiger – und zu besseren Kosten pro erfolgreichem Ergebnis – abschließt als die veröffentlichte Baseline.
FAQ
Wann wird Grok 4.7 voraussichtlich veröffentlicht?
Musks Zehntage-Countdown vom 2. September weist auf ungefähr den 12. September 2026 hin. Dies ist ein abgeleitetes Ziel, kein separat veröffentlichtes Kalenderdatum von xAI.
Wurde Grok 4.7 bereits veröffentlicht?
Grok 4.7 wurde öffentlich angeteasert/angekündigt, hat aber noch keine vollständige offizielle API-/Modelldokumentation erhalten.
Ist Grok 4.7 ein Modell mit 2,1 Billionen Parametern?
Musk hat es als ungefähr 2,1T Parameter beschrieben. xAI hat noch kein Architekturdokument veröffentlicht, das aktive Parameter oder Routing-Details bestätigt.
Wird Grok 4.7 besser sein als Grok 4.6?
Musk hat eine substanzielle Verbesserung behauptet, aber es existiert keine offizielle Grok 4.7-Benchmark-Tabelle. Behandeln Sie die Aussage als unverifiziert, bis reproduzierbare Ergebnisse vorliegen.
Wird Grok 4.7 über CometAPI verfügbar sein?
Eine CometAPI-Tracking-Seite existiert bereits, aber finale Verfügbarkeit, Kennung, Preise und unterstützte Formate sollten nach dem offiziellen Launch bestätigt werden.
Fazit
Die Geschichte von Grok 4.7 hat sich von einer breiten Früh‑September‑Schätzung zu einem konkreten Countdown entwickelt. Musks jüngste Aussage weist auf ungefähr den 12. September 2026 hin, während frühere Posts ein Modell mit rund 2,1T und ergänzendem Training mit umfangreichen SpaceX-Unternehmensdaten beschreiben.
Das sind ungewöhnlich spezifische Vorab-Signale, aber sie sind keine Modellkarte, Benchmark-Suite oder API-Vertrag. Entwickler sollten Grok 4.6 als messbare Baseline beibehalten, jetzt eine kontrollierte Evaluation vorbereiten und auf die Bestätigung von Produktionszugang durch xAI und CometAPI warten, bevor sie Migrations- oder Budgetentscheidungen treffen.