
TL;DR
Grok 4.7 und Xiaomi MiMo-V2.6 erschienen im Abstand von nur einem Tag, repräsentieren jedoch zwei unterschiedliche Ansätze an die Frontier-KI. Grok 4.7 betont einen proprietären, eng integrierten Agenten-Stack für Programmierung und professionelle Wissensarbeit, während MiMo-V2.6-Pro offene Gewichte, ein größeres Kontextfenster, native multimodale Verarbeitung und aggressive API-Preise kombiniert.
SpaceXAI positioniert Grok 4.7 als sein Frontier-Modell für Programmierung, agentische Aufgaben und Wissensarbeit mit einem Kontextfenster von 500K Tokens und konfigurierbarem Reasoning-Aufwand.
Xiaomi positioniert MiMo-V2.6-Pro als multimodales Flaggschiff mit 1M-Kontext mit offenen Gewichten und Unterstützung für Text-, Bild-, Audio- und Videoverarbeitung.
Kurz gesagt: Grok 4.7 ist das stärker vertikal integrierte Managed-Agent-Produkt; MiMo-V2.6-Pro bietet Entwicklern mehr Deployment-Kontrolle und deutlich niedrigere Roh-Token-Preise. Die beste Wahl hängt vom Workload ab statt von einem einzelnen Benchmarkwert.
Key Takeaways
- Grok 4.7 ist für langfristige Programmieraufgaben und professionelle Agenten ausgelegt. In der von SpaceXAI veröffentlichten Anbieterbewertung erzielt es 46,3% auf CursorBench 4.0, 71,0% auf DeepSWE v1.1 bei hohem Aufwand und 1.657 auf AA Briefcase v1.1.
- MiMo-V2.6-Pro ist für ein offenes Modell ungewöhnlich konkurrenzfähig. Xiaomi veröffentlicht die Modellgewichte und meldet Ergebnisse nahe an proprietären Frontier-Systemen auf mehreren Coding- und Agent-Benchmarks, jedoch sind herstellerübergreifende Scores nicht direkt austauschbar.
- MiMo hat Vorteile bei Kontext und Multimodalität. MiMo-V2.6-Pro unterstützt ein Kontextfenster von 1M Tokens sowie Text-, Bild-, Audio- und Videoverarbeitung, gegenüber Grok 4.7 mit 500K Kontext und Text- sowie Bildeingabe.
- MiMo ist bei reinen API-Tokens erheblich günstiger. Die offiziellen Standardpreise betragen für MiMo-V2.6-Pro 0,435/0,87 $ pro Million ungecachter Eingabe-/Ausgabe-Tokens gegenüber 2/6 $ für Grok 4.7.
- Die Deployment-Architektur ist der entscheidende Trade-off. Grok bietet den stärkeren First-Party-Hosted-Tool-Stack; MiMos offene Gewichte ermöglichen private Deployments, maßgeschneidertes Serving und tiefere Infrastrukturkontrolle.
Grok 4.7 vs MiMo-V2.6-Pro at a Glance
| Dimension | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Release | September 21, 2026 | September 22, 2026 |
| Access and control | Proprietary API and managed agent ecosystem | Open weights, self-hosting option, and API access |
| Performance evidence | Provider-reported strength in coding and long-running agent tasks; validate on the same task harness | Provider-reported strength across reasoning, coding, and multimodal tasks; validate on the same task harness |
| Distinctive strengths | First-party tools, managed workflows, and web/X-connected agents | Deployment control, 1M-token context, and text/image/audio/video understanding |
| Context window | 500K tokens | 1M tokens |
| Input modalities | Text and image | Text, image, audio, and video |
| Official standard uncached input / output per 1M tokens | $2 / $6 | $0.435 / $0.87 |
| Reasoning | Low to xHigh | Deep reasoning |
| Open weights | No | No |
| Best fit | Managed coding and agent workflows | Private deployment, multimodal input, and lower raw token cost |
What Is Grok 4.7?
SpaceXAI veröffentlichte offiziell Grok 4.7 am 21. September 2026 als sein leistungsfähigstes Modell für Programmierung und Wissensarbeit. Der Launch ist bedeutsam, weil vorab Berichte bestätigte Fakten mit geleakten Architekturbehauptungen vermischten. Die endgültige Launch-Dokumentation veröffentlicht keine Gesamt- oder aktiven Parameterzahlen, daher sollten Vorab-Schätzungen nicht als offizielle Spezifikationen behandelt werden.
Laut dem offiziellen Launch-Post verwendet Grok 4.7 ein neues, größeres Basismodell als Grok 4.6 und wurde mit einem längeren Reinforcement-Learning-Run trainiert, der stärker auf Probleme ausgerichtet ist, deren Lösung viele Stunden dauert.
Die Modelle optimieren unterschiedliche Schichten des Stacks. Grok 4.7 bietet eine reichere verwaltete Umgebung rund um das Modell; MiMo-V2.6-Pro legt mehr des Modells und der Deployment-Schicht für Entwickler offen.
Für Prompts über 200K Tokens wendet SpaceXAI höhere Kontextpreise an. Die veröffentlichte Stufe beträgt 4 $ pro Million Eingabetokens, 1 $ pro Million gecachter Eingabetokens und 12 $ pro Million Ausgabetokens.
Changes in Grok 4.7
Die bedeutsamste Änderung ist das Trainingsziel, nicht lediglich eine höhere Benchmarkzahl. SpaceXAI sagt, dass sein Reinforcement-Learning-Mix stärker auf längere, mehrstündige Aufgaben verschoben wurde, während das Modell darauf trainiert wurde, seine eigene Arbeit sorgfältiger zu verifizieren und den Grok-Bot-Harness nativ zu verstehen. Diese Kombination zielt auf echte Agentenausführung: Zustände beibehalten, Tools nutzen, Zwischenarbeit prüfen und über lange Aufgabenverläufe kohärent bleiben.
Grok 4.7 Performance
| SpaceXAI-published benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0%* | 65.2% | 72.7% | 70.0% |
| EEBench | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
- SpaceXAI kennzeichnet Grok 4.7 DeepSWE als hohen Aufwand. Dies sind vom Anbieter veröffentlichte Auswertungen und sollten im Rahmen des dokumentierten Harnesses und der Reasoning-Einstellungen interpretiert werden.
SpaceXAI präsentiert die Launch-Diagramme als webnative Inhalte auf der offiziellen Ankündigungsseite; die obige Tabelle bewahrt die offengelegten Benchmarkwerte, ohne ein neu gezeichnetes Diagramm zu substituieren.
What Is Xiaomi MiMo-V2.6?
Xiaomi veröffentlichte und open-sourcte MiMo-V2.6 am 22. September 2026. Die Familie umfasst MiMo-V2.6-Pro und MiMo-V2.6-Flash, mit einer Pro-UltraSpeed-Serving-Option für latenzsensitive Workloads. Für einen direkten Vergleich mit Grok 4.7 ist MiMo-V2.6-Pro das passende Flaggschiff-Pendant.
Xiaomis offizielle Materialien dokumentieren getrennt offene Gewichte, native multimodale Eingabe und API-Preise. Diese Kombination macht MiMo-V2.6 über Benchmark-Bestenlisten hinaus relevant.
MiMo-V2.6 vs MiMo-V2.5: What was improved?
Die architektonische Schlagzeile ist nicht einfach ein größerer Checkpoint. Xiaomis öffentliche Veröffentlichung legt den Fokus stark auf Post-Training und Live RL. Laut den offiziellen Release Notes absolvierten Pro und Flash jeweils 30 Reinforcement-Learning-Schritte und generierten zusammen ungefähr 750.000 Trajektorien; die offengelegten RL-Phasen-Kosten betrugen etwa 2,62 Mio. $ für Pro und 850.000 $ für Flash.
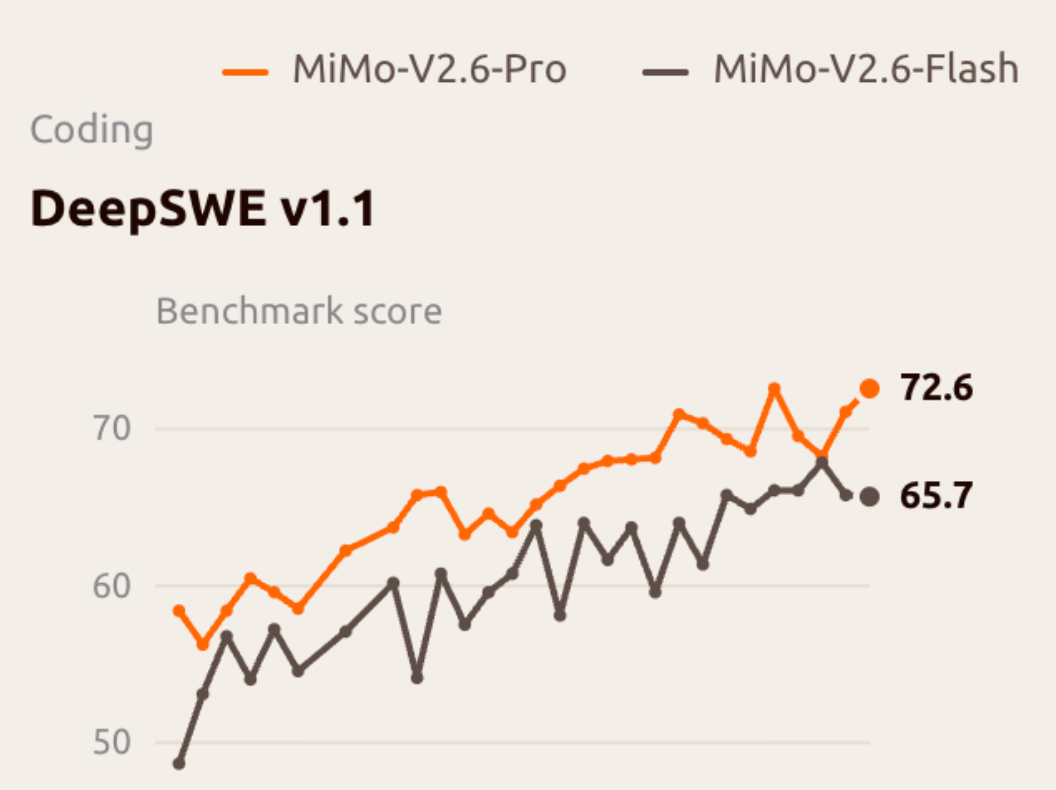
Ein Benchmarkdetail erfordert sorgfältige Behandlung: Xiaomis Live-RL-Kurve zeigt, dass MiMo-V2.6-Pro während des Trainingslaufs etwa 72,6 auf DeepSWE v1.1 erreicht, während die abschließende Vergleichstabelle 71,9 berichtet. Diese Zahlen beziehen sich auf unterschiedliche Auswertungskontexte und sollten nicht stillschweigend zusammengeführt werden.
Grok 4.7 vs MiMo-V2.6-Pro: Benchmark Comparison
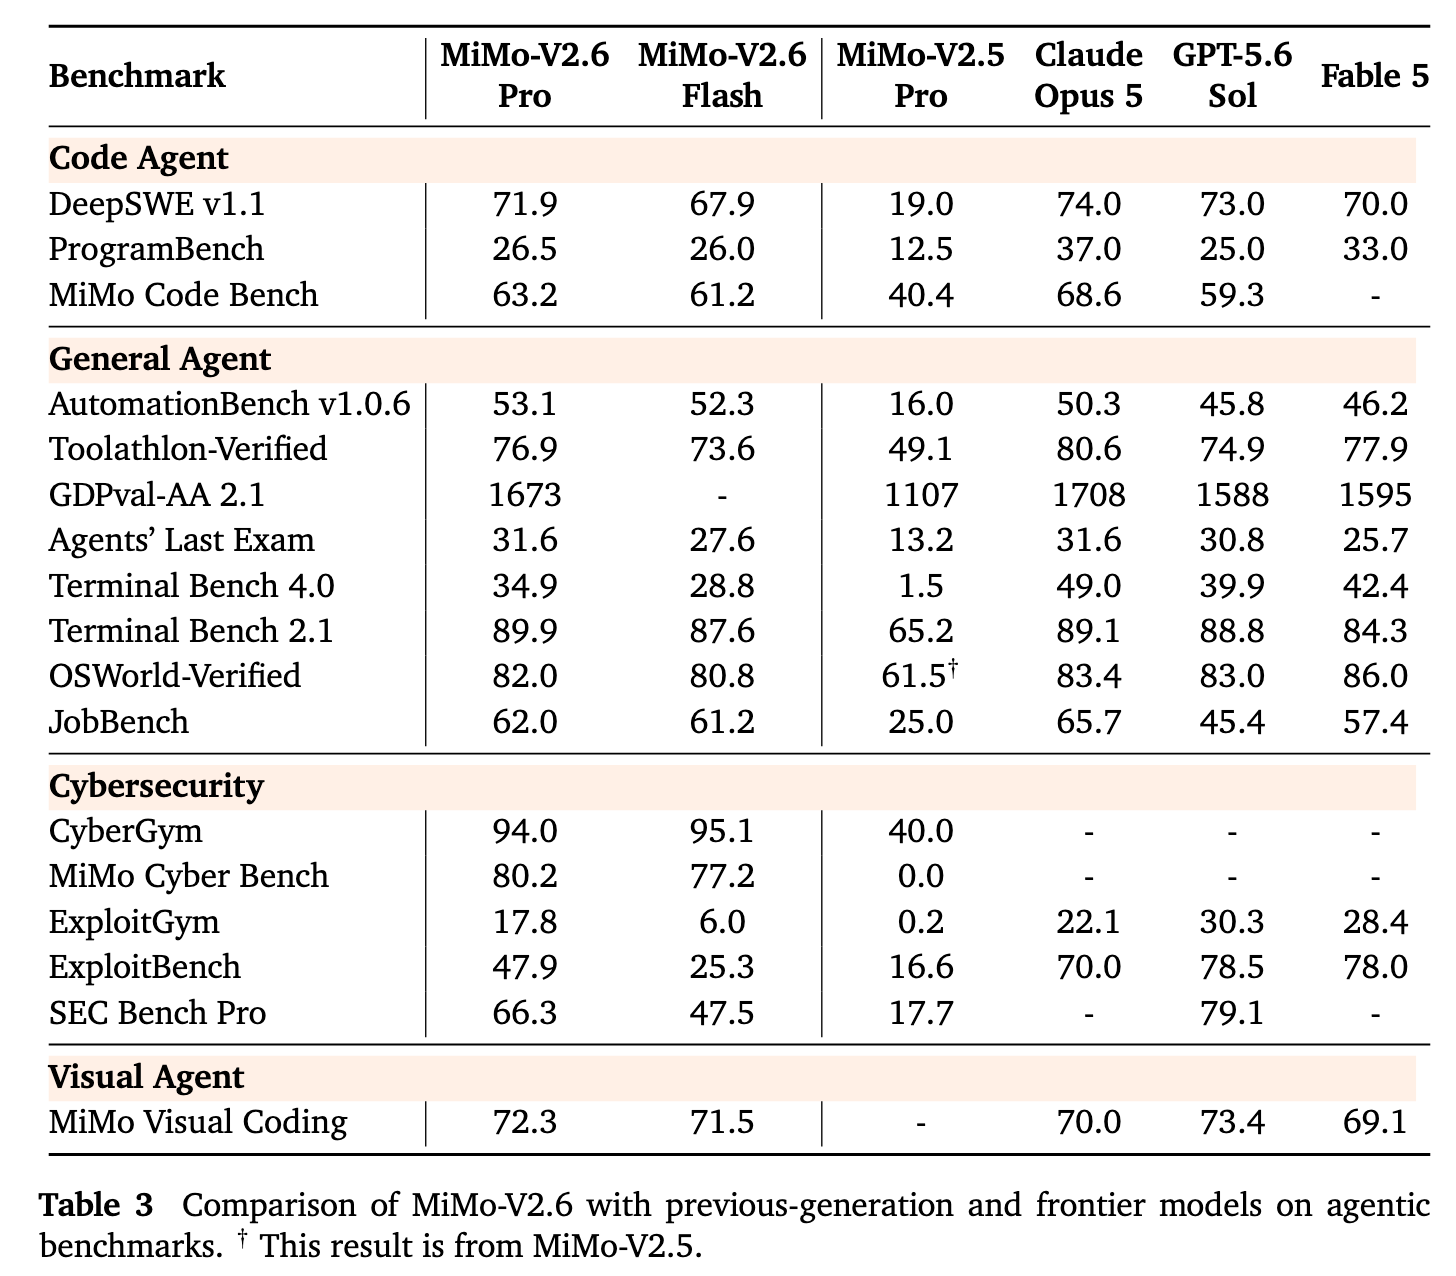
Direkte Benchmarkvergleiche erfordern Vorsicht. Anbieter verwenden nicht immer identische Harnesses, Reasoning-Budgets, Checkpoints oder Tool-Konfigurationen. Selbst wenn Benchmarknamen übereinstimmen, können kleine Score-Unterschiede weniger bedeutsam sein, als sie erscheinen. Am sichersten ist es, wirklich abgeglichene Messungen von Richtungsbelegen zu trennen.
Artificial Analysis Intelligence Index
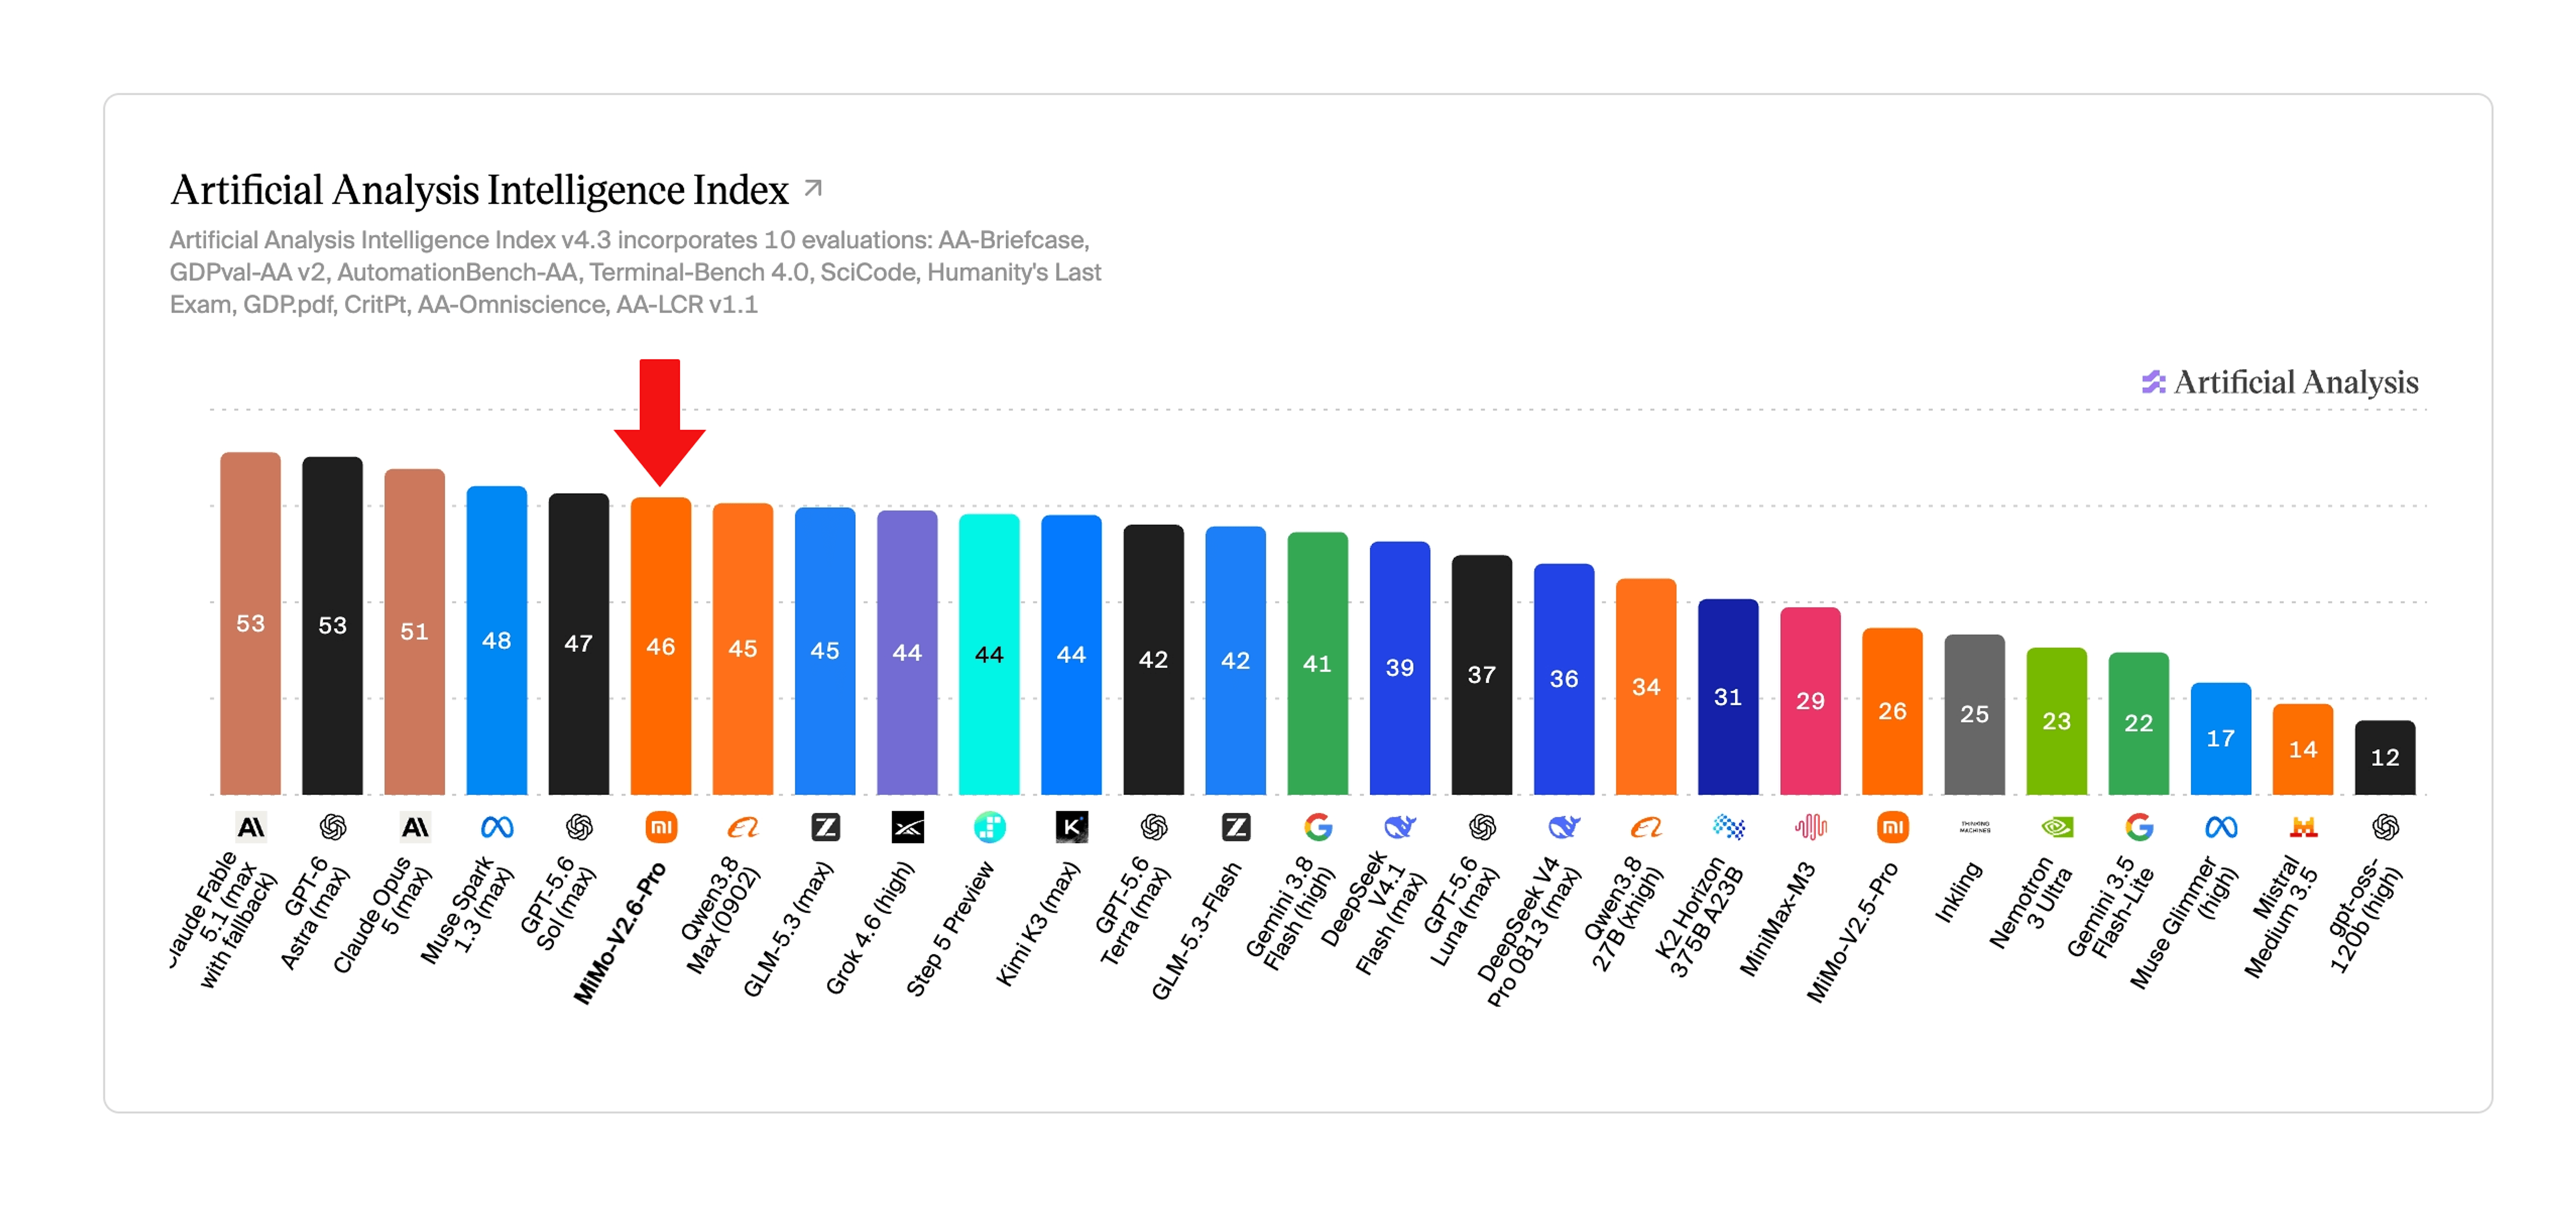
Xiaomi berichtet 46,32 für MiMo-V2.6-Pro auf dem Artificial-Analysis-Kompositindex. Jeder Grok-Vergleich sollte an die exakte Artificial-Analysis-Snapshot- und Modellkonfiguration geknüpft sein; eine gerundete Gleichheitsbehauptung sollte ohne diese Quelle nicht präsentiert werden.
Coding and Agent Performance
| Benchmark | Grok 4.7 — SpaceXAI | MiMo-V2.6-Pro — Xiaomi | Interpretation |
|---|---|---|---|
| DeepSWE v1.1 | 71.0* | 71.9** | Numerisch nah beieinander; veröffentlichte Läufe und Einstellungen unterscheiden sich |
| GDPval-AA | Siehe SpaceXAI-Chart | 1,673 | Nur als Richtwert, sofern die Harnesses nicht angeglichen sind |
| AA Briefcase | 1,657 | Siehe Xiaomi-Chart | Anbieterangaben nur mit Kontext nutzen |
| Terminal-Bench 4.0 | 38.0 | 34.9 | Ähnliche Richtung; Harness ist relevant |
| Context window | 500K | 1M | MiMo unterstützt mehr Arbeitskontext |
- SpaceXAI berichtet Grok 4.7 DeepSWE mit hohem Aufwand. ** Xiaomis finale Vergleichstabelle meldet 71,9; die Live-RL-Trainingskurve erreicht ungefähr 72,6. Diese Zahlen stammen aus unterschiedlichen Auswertungskontexten.
Coding Workflow Fit
Für Programmierung hängt die Unterscheidung davon ab, ob „Coding“ rohes Repository-Problemlösen oder ein vollständiges, verwaltetes Coding-Agent-Erlebnis bedeutet. Auf DeepSWE v1.1 sind die veröffentlichten Zahlen nah genug beieinander, dass eine Lücke von unter einem Punkt allein nicht die Produktionswahl entscheiden sollte.
Der Vorteil von Grok 4.7 liegt weiter oben im Stack. Es ist in Grok Build integriert, in Cursor verfügbar, darauf ausgelegt, den Grok-Bot-Harness zu verstehen, und mit First-Party-Codeausführung und -Suchtools gepaart.
Der Vorteil von MiMo-V2.6-Pro liegt weiter unten im Stack. Offene Gewichte machen es praktikabel, einen privaten Coding-Assistenten zu bauen, Serving anzupassen, Datenresidenz-Kontrollen durchzusetzen oder mit einem proprietären Agenten-Harness zu experimentieren.
Für Teams, die zwischen beiden wählen, ist ein Produktions-A/B-Test auf repräsentativen Repositories aussagekräftiger als ein einzelner öffentlicher Coding-Benchmark.
Grok 4.7 vs MiMo-V2.6-Pro: Multimodal Capability Differences
Dies ist einer der klarsten Unterschiede. Grok 4.7 akzeptiert Text- und Bildeingaben und erzeugt Text. Die breitere Grok-Plattform bietet separate Medienprodukte, doch diese sollten nicht mit der Modalitätsoberfläche des Modells grok-4.7 selbst verwechselt werden.
MiMo-V2.6-Pro unterstützt Text-, Bild-, Audio- und Videoverarbeitung. In Kombination mit einem Kontextfenster von 1M Tokens erweitert dies die Bandbreite der Workflows, die in einem Modellkontext bearbeitet werden können.
- Screenshot- und Code-Analyse in derselben Aufgabe
- Videoverständnis mit begleitenden Anweisungen
- Verarbeitung von Langform-Audio
- Computer-Use-Agenten mit visuellem Feedback
- Multimodale Forschungsassistenten
- Großskalige multimodale Extraktion und QA
Grok 4.7 vs MiMo-V2.6-Pro: API Pricing Comparison
| Official API pricing | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Input / 1M tokens | $2.00 | $0.435 |
| Cached input / 1M | $0.50 | $0.0036 |
| Output / 1M | $6.00 | $0.87 |
| Long-context surcharge | Yes, above 200K prompt tokens | No comparable standard tier published |
| Open-weight/self-host option | No | Yes |
Zum Listenpreis ist MiMo-V2.6-Pro sowohl bei normaler Eingabe als auch bei generierter Ausgabe mehrfach günstiger, mit einem besonders großen Unterschied für gecachten Kontext. Das kann die Ökonomie von Agenten materiell beeinflussen, die wiederholt Repositories, lange Dokumente oder persistente Kontexte verarbeiten.
Wichtiger Preishinweis: Das 500K-Kontextfenster von Grok 4.7 bedeutet nicht, dass der gesamte Kontext zum Standardtarif abgerechnet wird. Anfragen über 200K Prompt-Tokens werden in der Long-Context-Stufe berechnet.
Mit Stand 24. September 2026 listet CometAPI Grok 4.7 mit 1,60 $ Eingabe und 4,80 $ Ausgabe pro 1 Mio. Tokens gegenüber den offiziellen 2,00 $ und 6,00 $. Es listet MiMo-V2.6-Pro mit 0,348 $ Eingabe und 0,696 $ Ausgabe gegenüber den offiziellen 0,435 $ und 0,87 $. Diese aufgeführten Standardtarife liegen 20% unter den entsprechenden offiziellen Werten. Preise und Berechtigung können sich ändern; prüfen Sie die Live-Modelseiten vor der Budgetierung.
Der Tokenpreis entspricht nicht dem Kostenaufwand pro abgeschlossener Aufgabe. Reasoning-Modelle können unterschiedliche Tokenvolumina verbrauchen, verschiedene Anzahlen von Toolaufrufen nutzen und unterschiedliche Retries benötigen. Produktionsauswertungen sollten daher abgeschlossene-Aufgaben-Kosten, Latenz und Erfolgsrate gemeinsam tracken.
Grok 4.7 vs MiMo-V2.6-Pro: Access and Availability
Der Zugangsunterschied ist eindeutig: Grok 4.7 ist über die API und verwaltete Grok-Workflows verfügbar, während seine Modellgewichte nicht zum Selbsthosting angeboten werden. MiMo-V2.6-Pro ist über die API und als offene Gewichte verfügbar, was Teams eine zusätzliche selbstgehostete Route gibt.
Verfügbarkeit ist getrennt von Lizenzierung oder Deployment-Flexibilität. Mit Stand 24. September 2026 haben beide Modelle auch Live-CometAPI-Katalogseiten. Teams sollten Endpoint, Region, Ratenlimits und Kontoberechtigung vor dem Produktionsrollout bestätigen; ein gelistetes Modell garantiert nicht identische Verfügbarkeit oder Servicelevels für jedes Konto.
| Availability question | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Official API | Available through xAI | Available through Xiaomi MiMo |
| CometAPI catalog | Listed as available | Listed as available |
| Self-hosted weights | Not available | Open-weight option |
| Operational check | Confirm account access, region, rate limits, and tool availability | Confirm account access, endpoint readiness, and self-hosting requirements |
Open Weights and Proprietary Access
Die offenen Gewichte von MiMo-V2.6-Pro verändern den Vergleich stärker als eine Ein-Punkt-Benchmarklücke. Sie schaffen Optionen für private Deployments, Tuning der Inference-Engine, maßgeschneidertes Post-Training, Datenresidenz-Kontrollen und tiefere Infrastruktur-Integration.
Grok 4.7 wählt den entgegengesetzten Trade-off: weniger Kontrolle über die Modellinternals im Austausch für einen verwalteten, kontinuierlich betriebenen Service und ein eng integriertes First-Party-Ökosystem. Für viele Organisationen werden Governance- und Infrastruktur-Anforderungen die Shortlist bestimmen, bevor Benchmarks dies tun.
How to Use Grok 4.7 and MiMo V2.6 APIs in CometAPI
Entwickler können Grok 4.7 API in CometAPI über einen vereinheitlichten API-Workflow nutzen, wodurch der Bedarf sinkt, separate anbieterspezifische Integrationen zu pflegen.
Für Teams, die mehrere Frontier-Modelle benchmarken, ist eine vereinheitlichte API-Schicht besonders nützlich, da dieselben Produktionsprompts, Test-Harnesses, Token-Abrechnung und Anwendungscode über Modelle mit weniger Integrationsvariablen wiedergegeben werden können.
CometAPI listet jetzt MiMo-V2.6-Pro als verfügbar, mit am 22. September 2026 bestätigter API-Verfügbarkeit. Prüfen Sie den Live-Katalog und den Kontozugang vor der Produktion.
Da beide Modellseiten jetzt als verfügbar gelistet sind, kann ein Application-Level-A/B-Test Prompts, Tools, Reasoning-Einstellungen und Erfolgskriterien so konsistent wie möglich halten und dann Aufgabenabschluss, Latenz, Tokenverbrauch und Fehlermodi vergleichen.
Grok 4.7 vs MiMo-V2.6-Pro: Model Fit by Use Case
| Requirement | Model fit / evaluation guidance |
|---|---|
| First-party web and X search | Grok 4.7 |
| Managed long-running agents | Grok 4.7 |
| Grok Build / Cursor workflows | Grok 4.7 |
| 1M-token context | MiMo-V2.6-Pro |
| Native audio/video understanding | MiMo-V2.6-Pro |
| Open weights, self-hosting, and model control | MiMo-V2.6-Pro |
| Lowest raw API token cost | MiMo-V2.6-Pro |
| Repository coding | Benchmark both on representative repositories |
| Professional knowledge agents | Benchmark both on production tasks |
Die Entscheidung sollte daher um die Workload-Architektur herum gerahmt werden. Grok 4.7 ist darauf ausgelegt, einen verwalteten Agenten-Stack leistungsfähiger zu machen; MiMo-V2.6-Pro soll hochklassige Intelligenz günstiger, multimodaler und kontrollierbarer machen.
Which one should you choose?
Wählen Sie Grok 4.7, wenn Sie ein Managed-Agent-Erlebnis mit First-Party-Web- und X-Suche, nativer Codeausführung und weniger zu betreibender Infrastruktur wünschen. Es ist die praktischere Option für Teams, die einen integrierten Tool-Stack und lang laufende professionelle oder Coding-Workflows schätzen.
Wählen Sie MiMo-V2.6-Pro, wenn Sie offene Gewichte, private Deployments, ein Kontextfenster von 1M Tokens, native Audio- und Videoverarbeitung oder deutlich niedrigere Roh-API-Preise benötigen. Es ist die stärkere Option, wenn Deployment-Kontrolle, Multimodalität und Kosteneffizienz die primären Constraints sind.
Wenn die Entscheidung weiterhin unklar ist, führen Sie beide Modelle auf denselben repräsentativen Aufgaben mit identischen Prompts, Tools, Reasoning-Budgets, Timeouts und Retry-Policies aus. Wählen Sie das Modell, das die beste Kombination aus Abschlussrate, Latenz, Gesamtkosten pro erfolgreicher Aufgabe und menschlichem Prüfaufwand liefert.
Conclusion
Grok 4.7 vs MiMo V2.6 ist aufschlussreich, weil rohe Intelligenz nicht mehr der einzige bedeutsame Differenzierer ist. Beide Modelle besetzen in aktuellen öffentlichen Auswertungen ein ähnliches Hochfähigkeitsband, doch ihre Produktstrategien divergieren stark.
Grok 4.7 kombiniert ein 500K-Kontextfenster, konfigurierbares Reasoning, starkes Training für langhorizontige Agenten und einen gereiften First-Party-Such- und Ausführungs-Stack. MiMo-V2.6-Pro kombiniert ein 1M-Kontextfenster, native multimodale Eingaben, offene Gewichte und API-Preise deutlich unter vielen proprietären Frontier-Systemen.
Für Entwickler ist die praktische Frage daher weniger „welcher Benchmarkscore ist höher?“ und mehr „wo soll die Intelligenz leben?“ Ein verwaltetes Agentenökosystem und ein offener, anpassbarer Modell-Stack lösen unterschiedliche operative Probleme. Die richtige Wahl ist diejenige, die am besten zum Produktionsworkload, zu Infrastruktur-Constraints und zum Kostenmodell passt.
FAQs
Ist Grok 4.7 ein Modell mit 2.1 Billionen Parametern?
Eine Zahl von ungefähr 2,1T kursierte vor dem Release, aber die finale SpaceXAI-Grok-4.7-Dokumentation veröffentlicht keine Gesamt- oder aktiven Parameterzahlen. Bestätigt ist, dass Grok 4.7 ein größeres Basismodell als Grok 4.6 verwendet.
Ist MiMo-V2.6 Open Source?
Xiaomi veröffentlichte MiMo-V2.6 als offene Modellfamilie mit herunterladbaren Gewichten und zugehörigen Forschungsressourcen. In der Produktionsplanung sollten Teams dennoch die genaue Modelllizenz und die Weitergabebedingungen für ihren beabsichtigten Einsatz prüfen.
Wie viel kostet Grok 4.7 vs MiMo-V2.6-Pro pro abgeschlossener Agentenaufgabe?
Normalisieren Sie Aufgabensatz, Prompts, Toolberechtigungen, Retry-Policy und Erfolgskriterien. Tracken Sie gesamte Eingabe, gecachte Eingabe, Reasoning- und Ausgabetokens, Toolaufrufe, Latenz, Retries und menschliche Prüfzeit. Der reine Tokenpreis ist nur eine Komponente der Kosten pro abgeschlossener Aufgabe.
Wie zuverlässig sind Benchmarkvergleiche zwischen Grok 4.7 und MiMo-V2.6-Pro?
Verwenden Sie dasselbe Repository oder denselben Aufgabensatz, denselben Agenten-Harness, dieselben Tools, dasselbe Reasoning-Budget, Timeout, Retry-Policy und dieselbe Bewertungsrubrik. Berichten Sie Konfidenzintervalle oder Varianz über Wiederholungsläufe und halten Sie Anbieterzahlen getrennt von internen Ergebnissen.
Erhebt Grok 4.7 höhere Gebühren für lange Kontext-Prompts?
SpaceXAI dokumentiert höhere Tarife, sobald die Prompt-Tokens 200K überschreiten. Da die höhere Stufe auf die Anfrage angewendet wird, sollten Teams, die große Repositories oder persistente Agentenkontexte nutzen, den Schwellenwert explizit modellieren.