
TL;DR
Kimi K3.1 Pro ist Moonshot AIs Upgrade zu Kimi K3 vom 24. Oktober 2026. Zusätzliches Post-Training verbessert autonomes Programmieren, Finanzrecherche und erweiterte werkzeuggestützte Workflows, bei unveränderter Kontextkapazität von etwa einer Million Tokens.
Unabhängige Bewertungen zeigen insgesamt stärkere Leistung, und die offiziellen Standardpreise für Input-/Output-Tokens sinken um ein Drittel. Das Upgrade erfordert dennoch Workload-Tests: Tiefere Reasoning-Prozesse können die Aufgabenlatenz und die Gesamtausgaben erhöhen, während K3 bei AA-LCR einen kleinen Vorsprung behält und die derzeit verfügbaren Gewichte für Self-Hosting bietet.
Key Takeaways
- Die deutlichsten Zugewinne liegen in der agentischen Ausführung. Artificial Analysis berichtet Terminal-Bench-4.0-Werte von etwa 67% für K3.1 Pro gegenüber 13% für K3; Moonshots interne Financial-Research-Werte steigen von 58.8 auf 70.4.
- Niedrigere Tokenpreise garantieren keine niedrigeren Aufgabenkosten. Standardpreise für Input/Output fallen von $3/$15 auf $2/$10 pro Million Tokens, doch zusätzliches Reasoning, Tool-Aufrufe und Retries können die Einsparungen aufheben.
- Das Kontextfenster bleibt gleich. Beide Modelle unterstützen bis zu 1,048,576 Tokens. K3 liegt in der zitierten AA-LCR v1.1 leicht vorn; testen Sie die Langkontext-Genauigkeit mit Ihren eigenen Dokumenten.
- Die Verfügbarkeit der Gewichte kann die Wahl bestimmen. Am 24. Oktober 2026 sind K3-Gewichte verfügbar; K3.1-Pro-Gewichte sollen bis 4. November veröffentlicht werden. Teams mit unmittelbarem Self-Hosting-Bedarf sollten diesen Unterschied berücksichtigen.
Kimi K3.1 Pro vs Kimi K3: Overview and Specifications
Kimi K3.1 Pro baut durch zusätzliches Post-Training auf K3 auf, mit Verbesserungen bei Coding, Finanzrecherche und erweiterten Agenten-Workflows. Beide behalten einen Kontext von etwa einer Million Tokens. Die Hauptunterschiede betreffen Aufgabenleistung, Tokenpreise, Bereitstellungsoptionen und Verfügbarkeit der Gewichte.
| Spezifikation | Kimi K3.1 Pro | Kimi K3 |
|---|---|---|
| Entwickler | Moonshot AI | Moonshot AI |
| Veröffentlichungsdatum | 24. Oktober 2026 | 16. Juli 2026 |
| Architektur | Aus K3 abgeleitetes MoE, weiter post-trainiert | MoE mit KDA, AttnRes |
| Modellgröße | 3T-Klasse und 104B aktive Parameter | 2.8T gesamt und 104B aktive Parameter |
| Kontextfenster | Bis zu 1,048,576 Tokens | Bis zu 1,048,576 Tokens |
| Standard-API-Input-/Output-Preis | $2 / $10 pro Million Tokens | $3 / $15 pro Million Tokens |
| Highspeed-Version | Verfügbar | Keine separate K3-Highspeed-Variante aufgeführt |
| Verfügbarkeit der Gewichte | Veröffentlichung bis 4. November 2026 geplant | Verfügbar unter der Kimi K3 License |
Die Verfügbarkeit der Gewichte spiegelt den Stand vom 24. Oktober 2026 wider. API-Preise in USD für regulären Input und Output, ohne Cache-Write-Gebühren, Steuern und andere anfallende Gebühren.
Architecture and Post-Training
K3 führte eine 2,8-Billionen-Parameter-Architektur ein, die Kimi Delta Attention, Attention Residuals und Stable LatentMoE kombiniert. Pro Token werden etwa 104 Milliarden Parameter aktiviert.
Moonshot beschreibt K3.1 Pro als post-trainierte Version von K3, entwickelt mit deutlich größerem Post-Training-Compute. Das Upgrade konzentriert sich darauf, die Fähigkeiten des Modells über mehrstufige Aufgaben hinweg anzuwenden, einschließlich Tool-Nutzung, Debugging und Ergebnisvalidierung. Die Ankündigung führt keine separat benannte Basisarchitektur ein.
Shared Capabilities and API Requirements
Beide Modelle unterstützen multimodale Eingaben, Tool-Calling, strukturierte Ausgaben und Context Caching. Bild- und Videoeingabeformate hängen von der gewählten API-Route ab. Beide führen stets Reasoning durch und unterstützen low, high und max Reasoning-Aufwand, wobei max der Standard ist.
Für mehrturnige Gespräche und Tool-Aufrufe müssen Integrationen vollständige Assistant-Nachrichten bewahren, einschließlich Reasoning-Inhalten und Tool-Aufrufen, wie von der API gefordert. Tatsächliche Kontextgrenzen und Funktionsverfügbarkeit sollten ebenfalls für den gewählten Anbieter, das Produkt und die Abonnementstufe geprüft werden.
Kimi K3.1 Pro vs Kimi K3: Performance
Die Evidenz stammt aus Moonshots internen Tests und berichteten Vergleichen sowie unabhängigen Drittanbieter-Bewertungen.
Diese sollten getrennt interpretiert werden, da Benchmark-Harnesses, Testsets, Reasoning-Einstellungen und Bewertungskriterien variieren können.
Die Launch-Evaluation von Artificial Analysis berichtet einen Anstieg um 11 Punkte auf dem zusammengesetzten Intelligence Index, mit besonders großen Verbesserungen bei terminalbasiertem Coding und agentischen Workflows.
| Unabhängiger Benchmark (Artificial Analysis) | Kimi K3 | Kimi K3.1 Pro | Differenz |
|---|---|---|---|
| Intelligence Index | 44 | 55 | +11 |
| Terminal-Bench 4.0 | ~13% | ~67% | +54 Prozentpunkte |
| AutomationBench-AA | 58% | 73% | +15 Prozentpunkte |
| GDPval-AA Elo | 1,534 | 1,846 | +312 |
| AA-Omniscience Index | 20 | 30 | +10 |
| Humanity's Last Exam | ~47% | ~52% | +5 Prozentpunkte |
| AA-Omniscience Halluzinationsrate | 53% | 44% | −9 Prozentpunkte |
| AA-LCR v1.1 | 88.7% | 86.3% | −2.4 Prozentpunkte |
Dies sind unabhängige Bewertungsergebnisse. Gerundete Werte werden verwendet, wenn der Bewerter gerundete Werte meldet. Niedrigere Halluzinationsraten sind besser.
Die größte Verbesserung tritt beim terminalbasierten Coding auf. K3.1 Pro schneidet deutlich besser bei Aufgaben ab, die Kommandoausführung, Interaktion mit der Umgebung, Debugging und wiederholte Validierung erfordern.
Auch AutomationBench-AA zeigt einen signifikanten Zugewinn, was auf stärkere Ausführung in SaaS-Workflows hindeutet.
Moonshots Release-Benchmarks konzentrieren sich auf Coding, Wissenschaft, 3D-Rekonstruktion, Finanzen, Wissensarbeit und autonome Agenten.
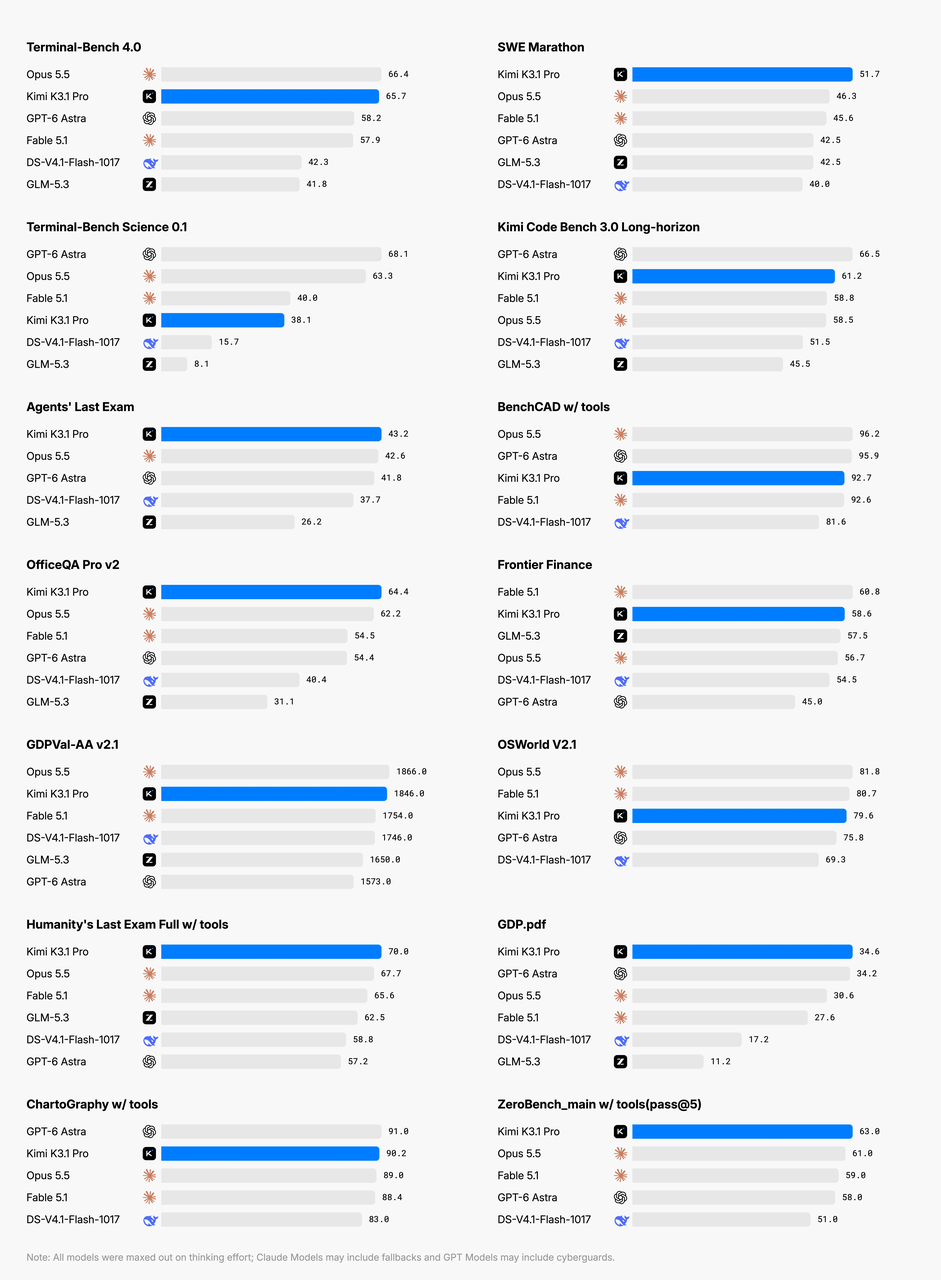
Die ausgewählten Vergleiche umfassen Claude Opus 5.5 und GPT-6 Astra. Vergleichen Sie jedes Ergebnis innerhalb seines benannten Benchmarks und der angegebenen Konfiguration.
| Benchmark (Moonshot AI) | Kimi K3.1 Pro | Anderes Modell | Vergleichsmodell-Wert |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | Claude Opus 5.5 | 66.4% |
| Terminal-Bench 4.0 | 65.7% | GPT-6 Astra | 58.2% |
| SWE-Marathon | 51.7% | Claude Opus 5.5 | 46.3% |
| Kimi Code Bench 3.0 | 61.2% | GPT-6 Astra | 66.5% |
| BenchCAD mit Tools | 92.7% | Claude Opus 5.5 | 96.2% |
| OfficeQA Pro v2 | 64.4 | Claude Opus 5.5 | 62.2 |
| Frontier Finance | 58.6 | Claude Opus 5.5 | 56.7 |
| OSWorld 2.1 | 79.6% | Claude Opus 5.5 | 81.8% |
K3.1 Pro nähert sich in ausgewählten Aufgaben mehreren führenden proprietären Modellen an oder übertrifft sie. Es dominiert jedoch nicht jede Kategorie.
Beispielsweise liegt es in den vom Anbieter gemeldeten BenchCAD- und OSWorld-Vergleichen hinter Claude Opus 5.5, und das offizielle Diagramm zeigt eine größere Schwäche bei Terminal-Bench Science.
Bewertungs-Setups unterscheiden sich: Artificial Analysis verwendet das mini-swe-agent-Harness für Terminal-Bench 4.0, während Moonshot Claude Code nutzt. Vergleichen Sie Werte innerhalb desselben Test-Setups; Harnesses, Reasoning-Aufwand und Laufzeitlimits können die Ergebnisse beeinflussen.
Coding and Software Engineering
Für komplexes autonomes Programmieren ist K3.1 Pro im Allgemeinen die stärkere Wahl.
Moonshots interne Kimi Code Bench 3.0 Long-horizon-Ergebnisse steigen von 55.95% für K3 auf 61.2% für K3.1 Pro, ein Zugewinn von etwa 5.25 Prozentpunkten.
Unabhängige Terminal-Bench-Ergebnisse zeigen ebenfalls einen erheblichen Zugewinn. Diese Tests bewerten mehrstufige Ausführung: Verständnis eines Repositories, Dateiänderungen, Befehlsausführung, Fehlerdiagnose und Ergebnisverifikation.
K3.1 Pro ist die stärkere Option für Entwicklung über mehrere Dateien, autonomes Terminal-Arbeiten und erweitertes Debugging. Für einfache Codegenerierung vergleichen Sie beide Modelle mit Ihren eigenen Aufgaben; K3 bleibt die unmittelbare Option, wenn Self-Hosting erforderlich ist.
Ein wichtiger Unterschied ist, dass Coding-Benchmark-Werte stark vom Agenten-Framework abhängen. Tools, Prompts, Laufzeitlimits und Testumgebungen beeinflussen das Ergebnis.
Für Softwareentwicklung in der Produktion bleibt die beste Bewertung ein passender Vergleich an Ihren eigenen Repositories.
Financial Research and Business Operations
Finanzmodellierung bietet einige der deutlichsten direkten Vergleiche zwischen den beiden Modellen.
Moonshot testete sowohl K3 als auch K3.1 Pro in internen Bewertungen, die Tabellenkalkulationsaufbau, Recherchequalität und simulierte Geschäftsabläufe abdecken.
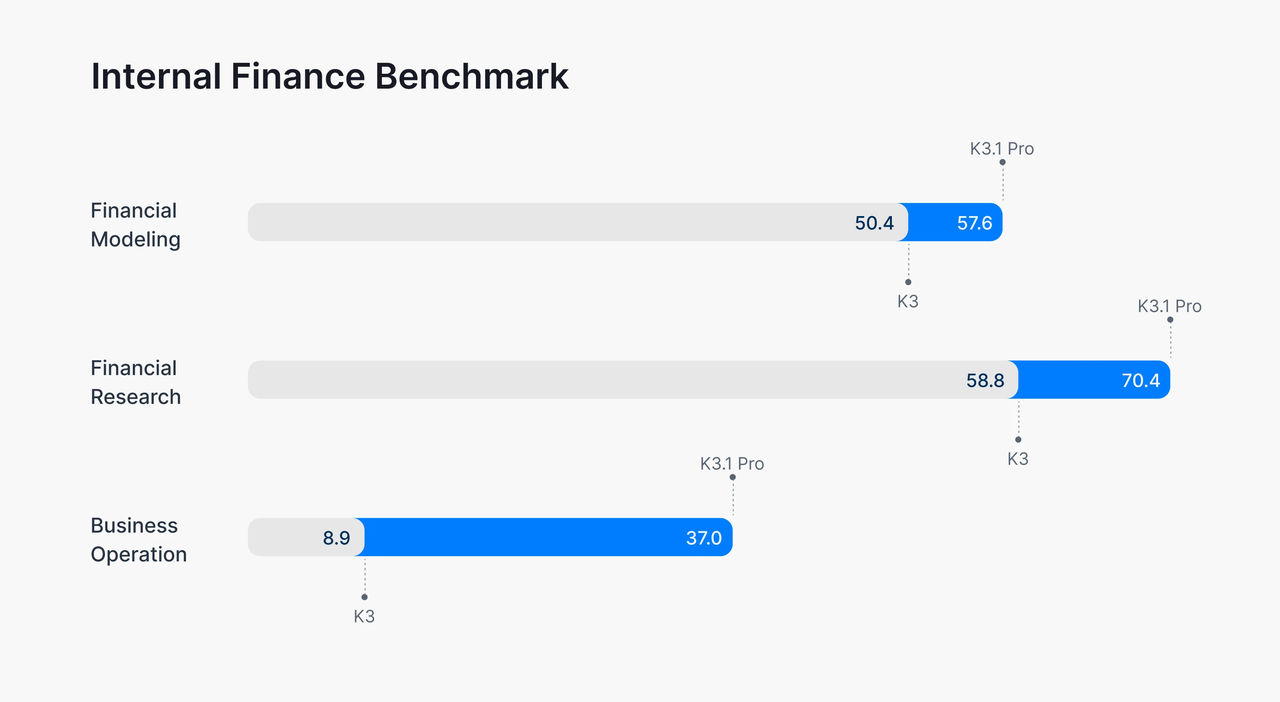
Moonshots interne Finanzergebnisse umfassen Finanzmodellierung, Recherche und simulierte Geschäftsabläufe. Diese vom Anbieter gemeldeten Aufgabenscores sind keine Messwerte der Anlagerenditen. Pro-Aufgabe-Einstellungen sollten nicht als identisch mit unabhängigen Benchmarks angenommen werden.
In Moonshots internen Tests steigt Financial Modeling von 50.4 auf 57.6, ein Zugewinn von 7.2 Punkten, und Financial Research von 58.8 auf 70.4, ein Zugewinn von 11.6 Punkten. Business Operation steigt von 8.9 auf 37.0, etwa das 4,2-Fache des K3-Werts.
Dieser Benchmark bewertet Langhorizont-Management und Entscheidungsfindung in einer simulierten Unternehmensumgebung. Er ist daher enger mit agentischer Planung als mit einfacher finanzieller Fragebeantwortung verwandt.
Financial Research misst die Fähigkeit, evidenzbasierte Recherche unter Einhaltung von Quellenanforderungen und Informations-Cutoffs zu liefern. Financial Modeling konzentriert sich auf mathematische Beziehungen, Tabellenlogik und Qualität der Arbeitsmappe.
Das Muster legt nahe, dass K3.1 Pro besonders wertvoll ist, wenn Finanzaufgaben anhaltendes Reasoning, Verifikation und strukturierte Deliverables erfordern.
Für Investoren, Analysten und Business-Anwender besteht der praktische Nutzen potenziell in der besseren Handhabung von Multi-Dokument-Workflows. Keines der Modelle sollte als unangefochtene Autorität für Finanzentscheidungen verwendet werden.
Long-Context Reasoning and Factual Reliability
Die AA-LCR-Langkontext-Ergebnisse zeigen jedoch K3 leicht voraus. Das ist eine nützliche Erinnerung, dass ein neueres Modell sich insgesamt erheblich verbessern kann, ohne jede spezialisierte Aufgabe zu gewinnen.
Die berichteten Bewertungen zeigen in ihren jeweiligen Testsets weniger sachliche Fehler.
Bei Kimi Hallu Bench Hard mit Tools berichtet Moonshot, dass die Fehlerquote auf Anspruchsebene von 23.4% bei K3 auf 8.3% bei K3.1 Pro gesunken ist.
Das entspricht einer relativen Reduktion von etwa 65% in Moonshots bewusst schwierigem Stresstest und ist keine Schätzung alltäglicher Fehlerraten. Unabhängig davon berichtet Artificial Analysis einen Rückgang der AA-Omniscience-Halluzinationsrate von 53% auf 44%. Die beiden Bewertungen verwenden unterschiedliche Methoden, daher sind ihre Prozentsätze nicht direkt vergleichbar.
Die praktische Lehre ist, dass K3.1 Pro bei den bewerteten Aufgaben zuverlässiger erscheint, faktische Verbesserungen jedoch die Notwendigkeit von Retrieval, Zitaten, Rechenprüfungen und menschlicher Überprüfung in folgenreichen Workflows nicht aufheben.
Data Analysis: Evidence from Plotly’s Evaluation
Plotly evaluierte das standardmäßige K3.1 Pro über OpenRouter mit einem privaten 43-Fragen-Test über ein synthetisches Windenergie-Datenlager. Highspeed wurde nicht getestet. Die Ergebnisse illustrieren den Trade-off zwischen Antwortqualität, Fertigstellungszeit und Kosten in diesem spezifischen SQL-basierten Analyse-Workflow.
| Plotly Data-Analytics-Messgröße | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| Korrekte Antworten | 35/43 | 42/43 |
| Genauigkeit | 81.4% | 97.7% |
| Entdeckte verborgene Muster | 0/5 | 5/5 |
| Identifizierte Datenqualitätsprobleme | 1/3 | 3/3 |
| Gesamtkosten der Evaluation | $5.01 | $13.47 |
| Medianzeit pro Frage | 43 Sekunden | 2.5 Minuten |
In dieser Evaluation beantwortete K3.1 Pro mehr Fragen korrekt und identifizierte mehr verborgene Muster und Datenqualitätsprobleme, verursachte jedoch höhere Kosten und eine längere mediane Fertigstellungszeit.
Die ausgewiesenen Gebühren sind beobachtete Evaluationskosten, nicht aus Moonshots Standard-API-Preisen berechnete Schätzungen. Das veröffentlichte Setup belegt nicht, dass alle Anbieter-Einstellungen zwischen den beiden Modellläufen identisch waren, daher können die Unterschiede nicht allein dem Modell zugeschrieben werden.
Diese Ergebnisse unterstützen die Evaluierung von K3.1 Pro für analytische Aufgaben, bei denen zusätzliche Erkenntnisse mehr Zeit und Ausgaben rechtfertigen könnten. Sie belegen nicht dieselbe Genauigkeit oder einen Kostenvortei
Is Kimi K3.1 Pro Faster Than Kimi K3?
Unterscheiden Sie Durchsatz an Ausgabetokens von der End-to-End-Aufgabenlatenz.
Artificial Analysis berichtet 73.5 Ausgabetokens pro Sekunde für K3.1 Pro im Vergleich zu 38.5 für K3 bei maximalem Reasoning-Aufwand über Kimi's API. Dies sind Token-Generierungs-Messungen, geprüft am 24. Oktober 2026; die gesamte Aufgabenlatenz hängt auch von der Reasoning-Länge und der Tool-Ausführung ab.
Schnellere Token-Generierung garantiert jedoch keine schnellere Aufgabenerledigung.
Moonshot bietet auch K3.1 Pro Highspeed an, das ungefähr zwei- bis dreimal schnellere Ausgabe als die Standardvariante liefern soll. Dies ist eine Serving-Geschwindigkeitsverbesserung, kein separat verifizierter Intelligenz-Upgrade.
K3.1 Pro hat einen höheren gemeldeten Ausgabetoken-Durchsatz, schließt Aufgaben jedoch nicht zwingend schneller ab. Unterscheiden Sie die Geschwindigkeit der Token-Generierung von der Zeit, die zum Reasoning, zu Tool-Aufrufen und zum Abschluss der Aufgabe erforderlich ist.
Output Speed vs. Task Completion Time
Artificial Analysis berichtet Ausgabegeschwindigkeiten von 73.5 Tokens pro Sekunde für K3.1 Pro und 38.5 für K3 bei maximalem Reasoning-Aufwand über Kimi’s API. Diese Messungen wurden am 24. Oktober 2026 geprüft und beschreiben den Token-Generierungsdurchsatz, nicht die End-to-End-Aufgabenlatenz.
Ein Modell kann Tokens schneller generieren und dennoch insgesamt länger benötigen, wenn es mehr Reasoning-Tokens produziert oder zusätzliche Tool-Aufrufe ausführt. In der oben diskutierten Plotly-Evaluation lag K3.1 Pros mediane Abschlusszeit bei 2.5 Minuten pro Frage, verglichen mit 43 Sekunden für K3, bei gleichzeitig höherer Genauigkeit.
Für interaktive Anwendungen messen Sie die Time-to-First-Token und die gesamte Aufgabenabschlusszeit auf der tatsächlichen Anbieterroute. Der Ausgabe-Durchsatz allein reicht nicht aus, um die Reaktionsfähigkeit vorherzusagen.
Consider K3.1 Pro Highspeed
Moonshot bewirbt K3.1 Pro Highspeed mit ungefähr zwei- bis dreifacher Ausgabegeschwindigkeit gegenüber dem Standard-K3.1 Pro. Diese Aussage betrifft die Serving-Geschwindigkeit; sie sollte nicht als zwei- bis dreifache Reduktion der gesamten Aufgabenabschlusszeit interpretiert werden.
Erwägen Sie Highspeed für interaktives Coding oder Assistenten, bei denen Nutzer auf Antworten warten. Vergleichen Sie End-to-End-Latenz, Aufgabenerfolg und insgesamt abgerechnete Kosten mit dem Standard-Endpunkt, bevor Sie ihn auswählen. Highspeed hat höhere reguläre Input- und Output-Tokenpreise, während der Cached-Input-Satz gleich ist.
Kimi K3.1 Pro vs Kimi K3: Cost
Official API and CometAPI Rates
Die offiziellen Standardtarife für Input, Output und Cache-Hit von K3.1 Pro sind um ein Drittel niedriger als die von K3. Die aufgeführten CometAPI-Input- und Output-Tarife liegen weitere 20% unter den entsprechenden offiziellen Tarifen.
| Modell | Offizieller Input / 1M | Offizieller Output / 1M | Offizieller Cached Input / 1M | CometAPI Input / 1M | CometAPI Output / 1M |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $1.60 | $8.00 |
| Kimi K3 | $3.00 | $15.00 | $0.30 | $2.40 | $12.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | Aktuelles Angebot prüfen | Aktuelles Angebot prüfen |
USD pro Million Tokens; Tarife geprüft am 24. Oktober 2026. Input-Spalten zeigen reguläre, nicht gecachte Input-Tarife. Steuern und separat abgerechnete Gebühren sind ausgeschlossen.
Offizielle Kimi-Preise listen auch Cache-Write-Gebühren: $2/$4 pro Million Tokens für Standard Pro mit 5-Minuten-/1-Stunden-Aufbewahrung und $4/$8 für Highspeed. Cache-Hits, Cache-Writes und regulärer Input sind separate, gegenseitig ausschließende Abrechnungskategorien.
Offizielles Kimi und CometAPI sind separate Anbieter-Routen. Bestätigen Sie die aktuellen Preise und Cache-Unterstützung für Ihre gewählte Route, einschließlich Highspeed-Verfügbarkeit. Vergleichen Sie die insgesamt abgerechneten Aufgabenkosten ebenso wie die Token-Tarife.
Fixed-Token Cost Example
Betrachten Sie eine Workload, die 100,000 nicht gecachte Input-Tokens und 20,000 Output-Tokens verbraucht.
Für diese feste Workload betragen die offiziellen API-Kosten $0.60 mit K3 und $0.40 mit K3.1 Pro. Zu den aufgeführten CometAPI-Tarifen kosten dieselben Tokenmengen $0.48 bzw. $0.32. Diese Summen umfassen nur die angegebenen Input- und Output-Tokens.
Dies ist jedoch ein Vergleich mit festen Tokenzahlen. Komplexe Agenten-Workflows können je nach Modell unterschiedliche Mengen an Reasoning-Tokens und Tool-Aufrufen verbrauchen.
Token Savings Disapears
Sei I die identische Anzahl nicht gecachter Input-Tokens, O die abgerechnete Output-Token-Anzahl von Kimi K3 und P die abgerechnete Output-Token-Anzahl von Kimi K3.1 Pro, alle gemessen in Millionen. Zu den Standard-Offizielltarifen in der Preistabelle lauten die Gebühren 3I + 15O bzw. 2I + 10P Dollar. Sie sind gleich, wenn P = 1.5O + 0.1I.
Bei ausgabestarken Anfragen kann K3.1 Pro somit ungefähr 50% mehr abgerechnete Output-Tokens verwenden, bevor sein Preisvorteil verloren geht. Diese Berechnung setzt unveränderte Tarife voraus und schließt Caching, Tool-Gebühren und andere separat abgerechnete Nutzung aus. Verwenden Sie die tatsächlich abgerechneten Tokenkategorien statt der sichtbaren Antwortlänge.
Cost per Successfully Completed Task
Berechnen Sie die Kosten pro erfolgreicher Aufgabe als die insgesamt abgerechneten Kosten aller Evaluationsversuche geteilt durch die Anzahl der einzigartigen Aufgaben, die ein vordefiniertes Akzeptanzkriterium erfüllen. Beziehen Sie Gebühren aus erfolglosen Versuchen, Retries und Timeouts ein, wenn der Anbieter sie in Rechnung stellt; nur die Kosten erfolgreicher Läufe durch deren Anzahl zu teilen, kann die Kosten pro Erfolg zu niedrig ansetzen.
Halten Sie Aufgabensatz, Akzeptanzkriterien, Retry-Limit und Timeout-Policy zwischen Kimi K3 und K3.1 Pro konstant. Berichten Sie die Erfolgsrate zusammen mit den Kosten pro Erfolg, sodass das Weglassen schwieriger Aufgaben ein Modell nicht künstlich wirtschaftlicher erscheinen lässt. Wenn keine Aufgabe erfolgreich ist, sind die Kosten pro Erfolg undefiniert, nicht null.
Kimi K3.1 Pro vs Kimi K3: Comparison and Selection
Für die meisten gehosteten agentischen Workloads ist K3.1 Pro der stärkere Ausgangspunkt. Dennoch sollte die Entscheidung die Aufgabenkomplexität und die Bereitstellungsanforderungen widerspiegeln.
| Anwendungsfall | Empfohlenes Modell | Begründung |
|---|---|---|
| Autonomes Coding | Kimi K3.1 Pro | Evaluieren Sie Mehrdatei-Änderungen, Terminalarbeit, Debugging und finale Testergebnisse. |
| Multidokument-Finanzrecherche | Kimi K3.1 Pro | Verbesserte Recherche- und Business-Operation-Benchmarks |
| Komplexe Datenanalyse | Kimi K3.1 Pro | Bessere Problemerkennung und Datenqualitätsprüfung |
| 3D-Erstellung und CAD-Workflows | Kimi K3.1 Pro | Starke spezialisierte, toolgestützte Fähigkeiten |
| Einfache Textaufgaben | Beide benchmarken | Vergleichen Sie Routine-Text- und einfache Coding-Aufgaben auf beiden Modellen; zusätzliches Reasoning kann Latenz erhöhen ohne besseren Output. |
| Genauigkeit bei Langkontext-Retrieval | Beide benchmarken | K3 liegt bei AA-LCR leicht vorn |
| Unmittelbares Self-Hosting | Kimi K3 | Herunterladbare Gewichte bereits verfügbar |
| Interaktive, hochfähige Agenten | K3.1 Pro Highspeed | Schnellere Bereitstellung, vorbehaltlich Kostenvalidierung |
| Kostenkritische Produktions-Workflows | Beide benchmarken | Niedrigere Tokenpreise bedeuten nicht zwingend niedrigere Aufgabenkosten |
Hosted Automation and Professional Workflows
Für gehostete Coding-Agenten und analytische Workflows evaluieren Sie K3.1 Pro an den schwierigen Teilen des tatsächlichen Jobs: Mehrdatei-Änderungen, Evidenzsammlung, Rechenprüfungen und Wiederherstellung nach fehlgeschlagenem Tool-Aufruf. Bevorzugen Sie gemessene Reduktionen fehlgeschlagener Aufgaben oder Korrekturarbeit gegenüber einem höheren Schlagzeilenwert allein.
Für etablierte K3-Anwendungen behalten Sie die bestehende Route als Vergleichsbasis bei. Routineaufgaben erfüllen möglicherweise bereits den Akzeptanzschwellenwert, während spezialisierte Langkontext-Aufgaben sich von aggregierten Benchmarks unterscheiden können. Priorisieren Sie die Workload-Segmente, bei denen ein Upgrade einen messbaren Nutzen hat.
Self-Hosting and Deployment Constraints
Am 24. Oktober 2026 sind K3s vollständige Gewichte verfügbar zur Bereitstellung gemäß Lizenz und Hardwareanforderungen des Modells. K3.1 Pros vollständige Gewichte wurden noch nicht veröffentlicht.
Moonshot plant, K3.1-Pro-Gewichte bis zum 4. November 2026 zu veröffentlichen. Dies ist ein angekündigter Veröffentlichungsplan, kein verfügbarer Checkpoint; bestätigen Sie die veröffentlichten Gewichte und geltenden Bedingungen, bevor Sie Self-Hosting terminieren.
Production Evaluation Criteria
Vergleichen Sie K3 und K3.1 Pro anhand repräsentativer Aufgaben mit denselben Prompts, Tools, Akzeptanzkriterien, Retry-Limits und Timeouts. Protokollieren Sie Anbieter- und Reasoning-Einstellungen und bewahren Sie vollständige Assistant-Nachrichten wie von der API gefordert.
Messen Sie Aufgabenerfolg, Latenz, Tokenverbrauch und Kosten pro erfolgreicher Aufgabe, einschließlich abgerechneter Fehlschläge und Retries. Überprüfen Sie Fälle, in denen K3 erfolgreich ist, K3.1 Pro jedoch scheitert. Bei menschlicher Bewertung blenden Sie die Modellbezeichnungen aus und randomisieren die Ausgabenreihenfolge.
Wenn K3.1 Pro Ihre Qualitäts-, Latenz- und Kostenschwellen erfüllt, rollen Sie es schrittweise mit einem getesteten K3-Fallback aus.
Controlled Migration and Fallbacks
Ein praktischer Ansatz ist, mit einem kleinen Prozentsatz des Produktions-Traffics auf K3.1 Pro zu beginnen.
Halten Sie K3 während der Validierung als Fallback verfügbar. Vergleichen Sie Aufgabenqualität, Latenz, Ausfallraten und Ausgaben, bevor Sie die Nutzung von K3.1 Pro erhöhen.
Achten Sie besonders auf Tool-Call-Schemas, Reasoning-bezogene Nachrichtenfelder, multimodale Eingaben und Output-Parsing. API-Kompatibilität garantiert nicht automatisch identisches Anwendungsverhalten.
Benchmark Gains and Regressions
Wenn beide Modelle dieselben 43 Fragen beantworteten und 35 bzw. 42 erzielten, könnte K3.1 Pro sieben K3-Fehler korrigiert haben, ohne Regressionen, oder acht Fehler, während eine zuvor korrekte Antwort verloren ging. Der Gesamtscore allein kann diese Ergebnisse nicht unterscheiden.
Untersuchen Sie gepaarte Antworten und klassifizieren Sie sie als beide korrekt, nur K3 korrekt, nur K3.1 Pro korrekt oder beide inkorrekt. Prüfen Sie die ausschließlich von K3 erzielten Erfolge gegen Ihre wirkungsstärksten Aufgaben, bevor Sie migrieren. Das Ergebnis 42/43 beschreibt dieses Testset; es garantiert keine Erfolgsquote von 97.7% für eine andere Workload.
Blind Evaluation of Model Outputs
Blenden Sie die Modellbezeichnungen aus und randomisieren Sie die Reihenfolge, in der Prüfer Ausgaben sehen. Definieren Sie die Akzeptanzrubrik vor der Begutachtung: Für Code nutzen Sie ausführbare Tests und Regressionstests; für Recherche prüfen Sie Quellenbelege, Berechnungen und ob das angeforderte Deliverable vollständig ist. Bewerten Sie Korrektheit, bevor Sie Präsentation oder Schreibstil berücksichtigen.
Legen Sie Modellidentität, Latenz und abgerechnete Kosten erst offen, nachdem die Qualitätsbewertung protokolliert ist. So trennen Sie Output-Qualität von Erwartungen an das neuere Modell. Lösen Sie Prüferdifferenzen anhand derselben Tests oder Quellenmaterialien und halten Sie die Entscheidungen fest, damit ein späteres Modell- oder Prompt-Update konsistent bewertet werden kann.
Where Can You Access Kimi K3.1 Pro and Kimi K3?
Official Provider Access
Nutzen Sie Moonshots dokumentierte Kimi K3 API oder Kimi K3.1 Pro API für eine direkte Anbieterintegration. Prüfen Sie die Modellkennung des gewählten Endpunkts, unterstützte Request-Felder und Kontolimits. Öffentlicher API-Zugang und herunterladbare Modellgewichte sind separate Bereitstellungsoptionen.
Access Through CometAPI
Entwickler können über CometAPIs einheitliche Schnittstelle auf die Kimi K3.1 Pro API und Kimi K3 API zugreifen und beide Routen mit derselben Anwendungs-Workload vergleichen.
Dies macht die Migration von K3 zu K3.1 Pro relativ unkompliziert, insbesondere für Anwendungen, die bereits eine OpenAI-kompatible Chat-Schnittstelle verwenden.
Um CometAPI zu nutzen, erstellen Sie ein Konto und einen API-Schlüssel und konfigurieren Sie dann Ihre Anwendung mit dem Endpunkt und der Modellkennung in der Integrationsdokumentation. Wählen Sie kimi-k3 für K3, kimi-k3.1-pro für Standard K3.1 Pro oder kimi-k3.1-pro-highspeed für die Highspeed-Route, wo unterstützt. Beginnen Sie mit einer kleinen Anfrage und vergleichen Sie dann dieselbe Workload über die Modelle hinweg, während Sie zurückgegebene Ergebnisse, Latenz und abgerechnete Nutzung prüfen.
Conclusion
Kimi K3.1 Pro ist in den hier geprüften Bewertungen der stärkere Kandidat für anspruchsvolles autonomes Coding, Finanzrecherche und erweiterte Agenten-Workflows. Kimi K3 bleibt relevant für unmittelbares Self-Hosting und Workloads, bei denen seine bestehende Genauigkeits- oder Latenzcharakteristik bereits ausreicht.
Wählen Sie anhand repräsentativer Aufgaben und der tatsächlichen Anbieterroute. Vergleichen Sie erfolgreiche Ergebnisse, Latenz und Gesamtausgaben und migrieren Sie dann schrittweise. Niedrigere Tokenpreise und höhere aggregierte Benchmark-Scores sind nützliche Ausgangspunkte, etablieren jedoch nicht die beste Konfiguration für jede Anwendung.