
TL;DR
MiniMax M3.1 Flash ist ein Hochgeschwindigkeits-KI-Modell für autonome Agenten, Software Engineering, Computerbedienung und komplexe Workflow-Automatisierung. Offiziell veröffentlicht am 19. Oktober 2026 kombiniert es ein Kontextfenster mit 1 Million Tokens mit konfigurierbarer Reasoning-Tiefe und niedrigeren Inferenzkosten.
MiniMax meldet bis zu 200+ Ausgabetokens pro Sekunde, eine 70%ige Reduktion der Agenten-Workload-Kosten gegenüber dem Vorgänger und wettbewerbsfähige Leistungen auf Automation-Bench, DeepSWE und OSWorld. Bei $0.15 pro Million Input-Tokens und $0.60 pro Million Output-Tokens macht das Modell mehrstufige KI-Agenten-Workflows wirtschaftlicher.
Key Takeaways
- MiniMax M3.1 Flash Leistung: Vom Anbieter gemeldete Benchmarks umfassen Automation-Bench 62.8, DeepSWE v1.1 73.7 und OSWorld 2.0 61.7 und unterstreichen die Fähigkeiten in Agentenautomatisierung, Coding und Computerbedienung.
- MiniMax M3.1 Flash API-Preise: Offizielle Tarife sind $0.15/M Input, $0.60/M Output und $0.015/M zwischengespeicherter Input. CometAPI-Tarife sind $0.80/M Input und $3.20/M Output mit Stand 21. Oktober 2026; auf der Modellseite ist keine Cache-Rate veröffentlicht.
- MiniMax M3.1 Flash Inferenzgeschwindigkeit: MiniMax meldet 200+ Tokens/s unter günstigen Bedingungen und eine P50-Durchsatzrate über 170 Tokens/s, was reaktionsfähige Agenten-Workflows unterstützt.
- MiniMax M3.1 Flash Agenten-Effizienz: Fünf Reasoning-Aufwandsstufen ermöglichen es Entwicklern, Task-Erfolg, Latenz und Gesamtkosten von KI-Agenten auszubalancieren.
- MiniMax M3.1 Flash API-Zugriff: Entwickler können über MiniMax auf das veröffentlichte Modell zugreifen oder die CometAPI-Integration mit anbieterspezifischen Modellkennungen und Preisen prüfen.
What Is MiniMax M3.1 Flash?
MiniMax M3.1 Flash ist ein Next-Generation-Sprachmodell, optimiert für agentisches Reasoning, Coding, Tool-Nutzung und autonome Workflow-Ausführung. MiniMax stellte M3.1 Flash offiziell vor am 19. Oktober 2026.
Anstatt sich ausschließlich auf Konversationsintelligenz oder isolierte Scores zu konzentrieren, zielt es auf die Gesamtkosten der Aufgabenerledigung durch wiederholtes Reasoning, Tool-Aufrufe und mehrstufige Ausführung. MiniMax verband seine frühe Entwicklung zudem mit Space Bunny, einem anonym bereitgestellten Modell, das laut Angaben vor der Ankündigung mehr als 200 Billionen Tokens verarbeitet hat; dies ist eine gemeldete Nutzungsgröße, keine veröffentlichte Trainings-Token-Zahl.
Für Entwickler, die autonome Coding-Assistenten, Enterprise-KI-Mitarbeiter und browserbasierte Agenten aufbauen, bietet M3.1 Flash drei relevante Vorteile: große Kontextkapazität, schnelle Generierung und günstigen Tokenverbrauch.
What Are MiniMax M3.1 Flash’s Specifications?
| API specifications | MiniMax M3.1 Flash |
|---|---|
| Developer | MiniMax |
| Official release | October 19, 2026 |
| Model family | MiniMax M3 |
| Context window | 1,000,000 tokens |
| Primary capabilities | Agent automation, coding, reasoning, computer use |
| Input modalities | Text, image, and video via MiniMax's OpenAI-compatible API; confirm support on other providers |
| Output modality | Text |
| Reasoning controls | Low, medium, high, xhigh, max |
| Reported output speed | Up to 200+ tokens/s |
| Reported P50 speed | 170+ tokens/s |
| Access channels | MiniMax API, M Plan, MiniMax Code |
| Open weights | Announced for future release |
| M3.1-specific parameter count | Not established in the announcement |
Ein großes Kontextfenster ist wertvoll für Repository‑Skalen‑Coding und dokumentintensive Workflows, garantiert aber keine perfekte Erinnerung. Produktionsagenten sollten weiterhin selektives Retrieval, strukturierte Tool-Antworten und Kontextkompression nutzen.
Fünf Reasoning-Aufwandsstufen erlauben es Entwicklern, intensive Rechenarbeit für komplexe Planung und Debugging zu reservieren, statt bei jeder Klassifikation, Extraktion oder einfachen Tool-Auswahl maximalen Aufwand zu betreiben. Da eine einzelne Agentenanforderung Dutzende Modellaufrufe auslösen kann, können kleine Einsparungen bei Routine-Schritten die Gesamtkosten spürbar senken.
How Does MiniMax M3.1 Flash Perform on Benchmarks?
MiniMax meldet Benchmark-Ergebnisse aus den Bereichen Geschäftsautomatisierung, Software Engineering, Computerbedienung, Cybersicherheit und multimodales Reasoning. Dies sind Anbieterangaben und kein Ersatz für unabhängige Tests in einer realen Bereitstellung.
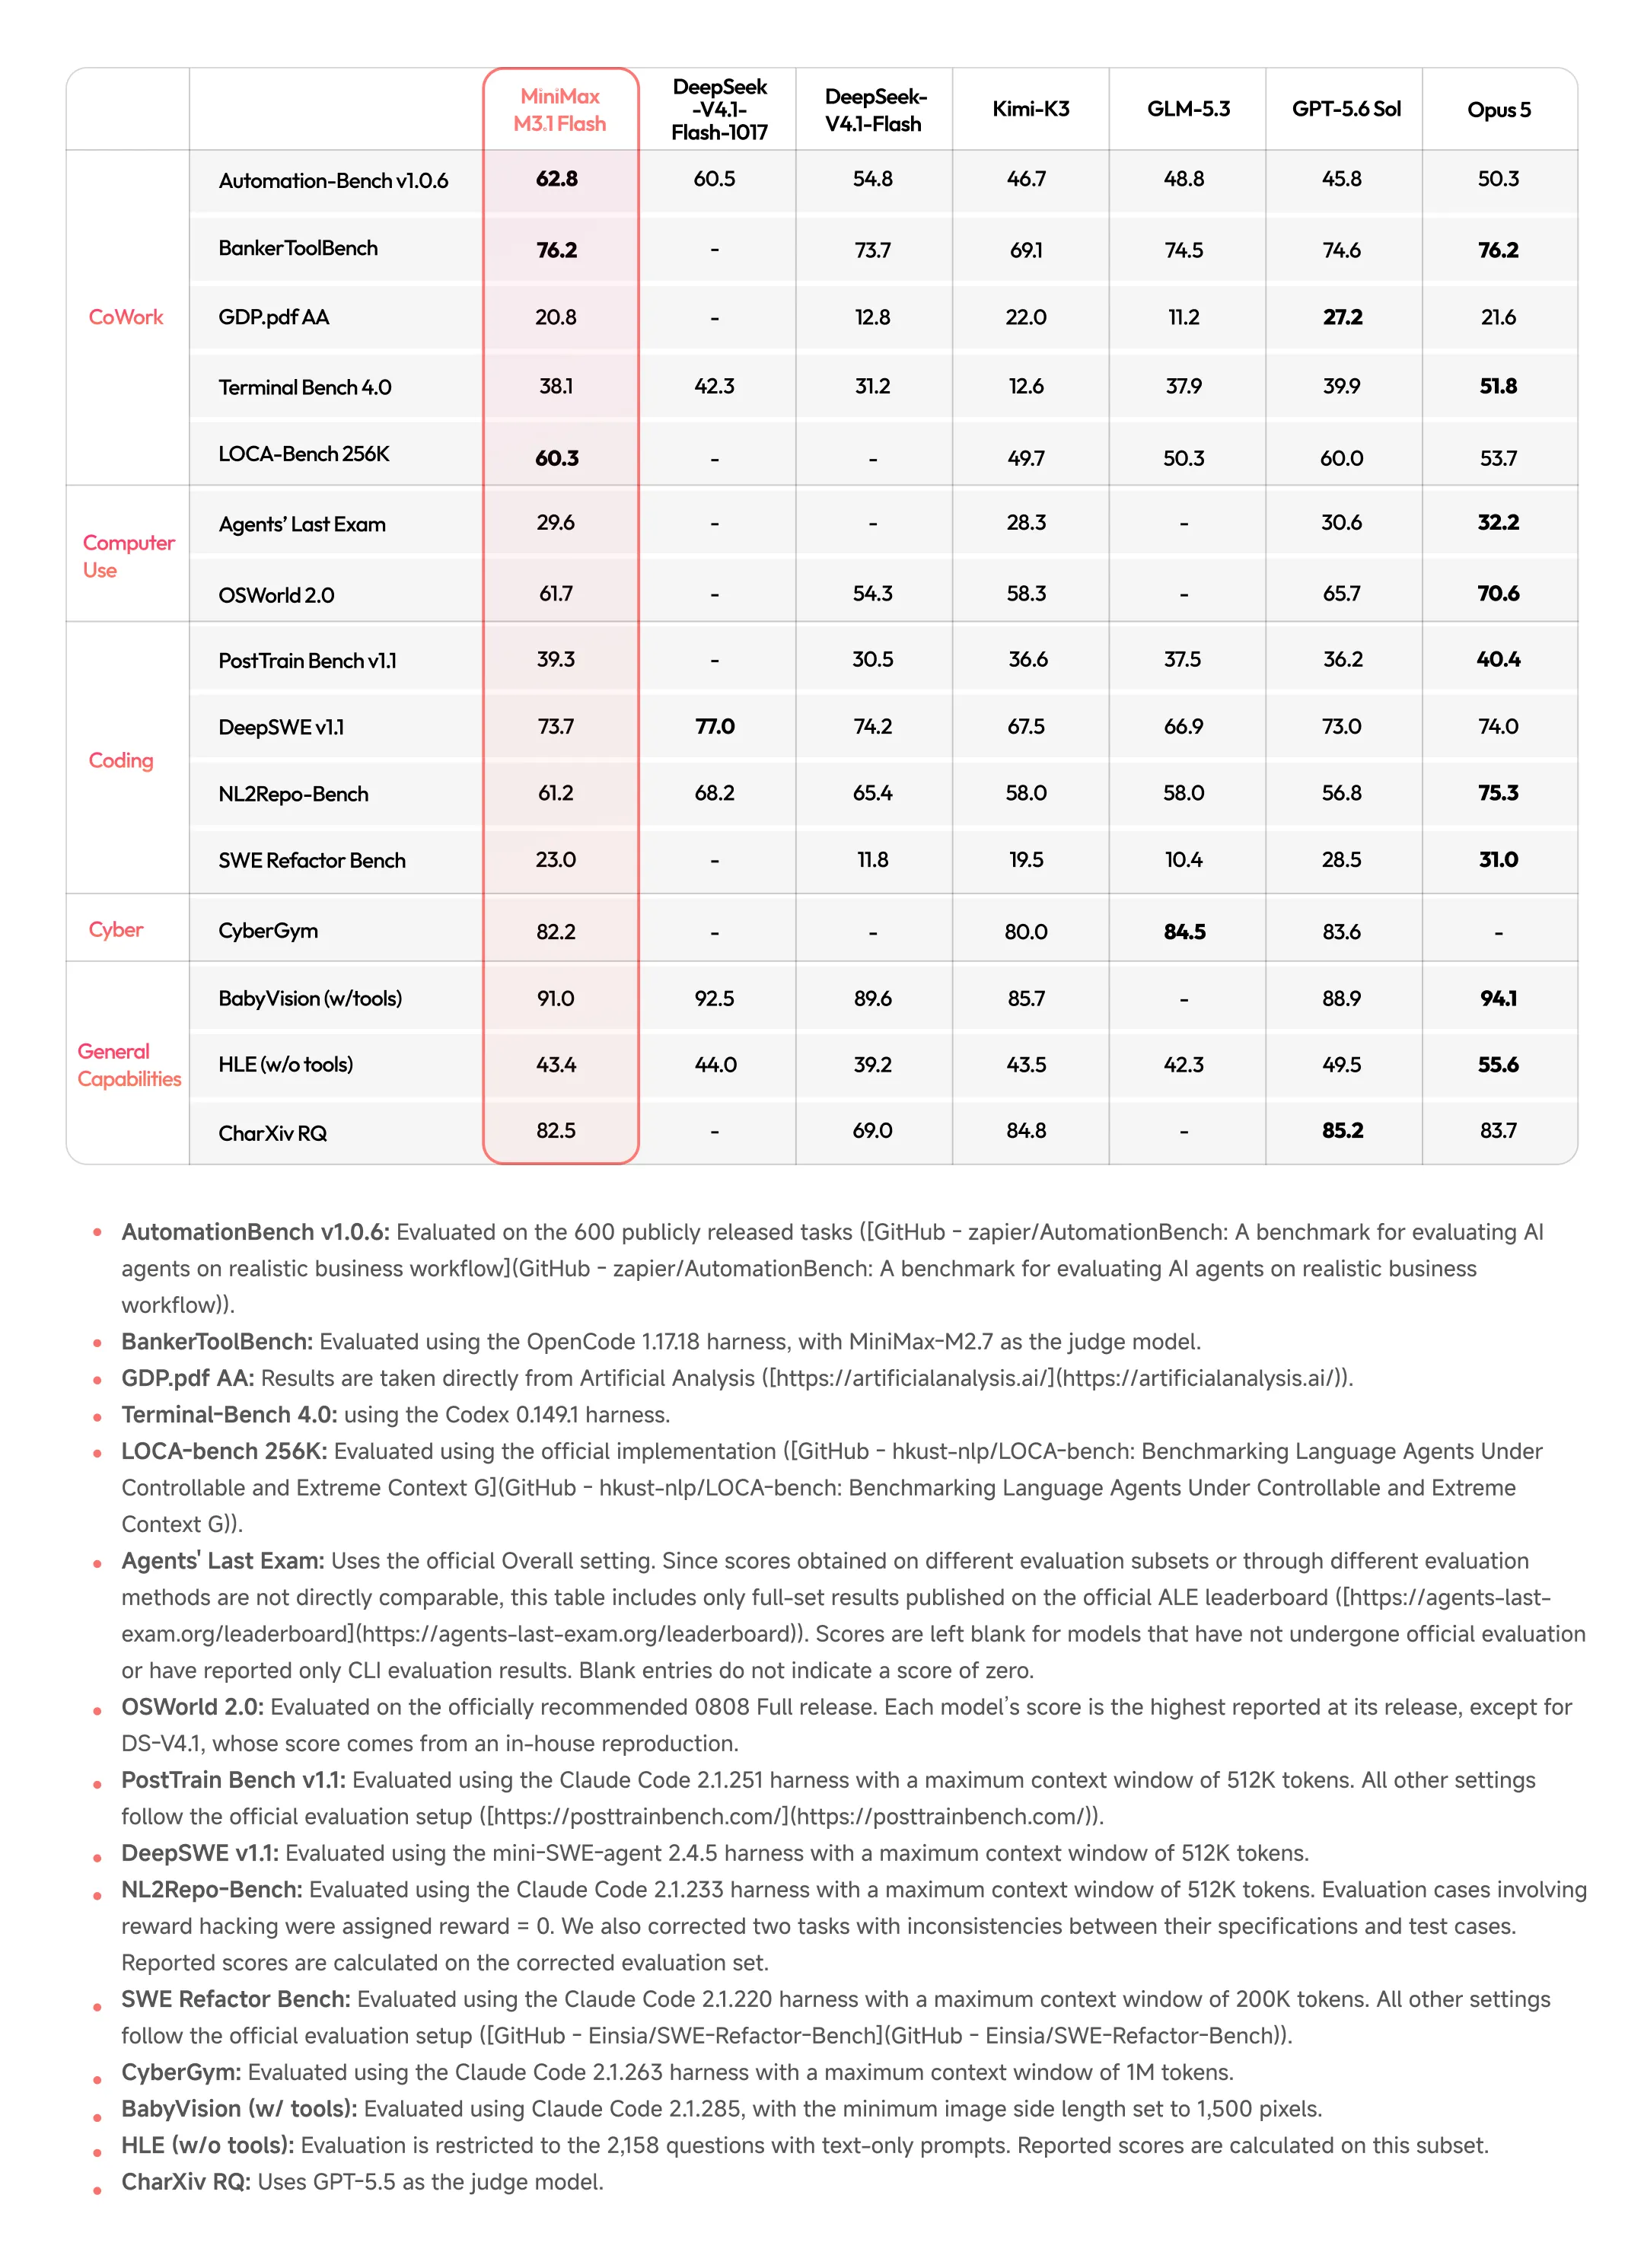
MiniMaxs offizieller Benchmark-Vergleich inklusive Evaluationshinweisen. Die Scores sind Anbieterangaben und stellen keinen einheitlichen unabhängigen Test dar.
| Official benchmark results | M3.1 Flash | What it measures |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | Mehrstufige Geschäftsautomatisierung |
| BankerToolBench | 76.2 | Finanz-Reasoning und Tools |
| LOCA-Bench 256K | 60.3 | Agentenausführung mit langem Kontext |
| DeepSWE v1.1 | 73.7 | Autonomes Software Engineering |
| Terminal Bench 4.0 | 38.1 | Terminalbasiertes Problemlösen |
| OSWorld 2.0 | 61.7 | Desktop-/Computer-Interaktion |
| Agents’ Last Exam | 29.6 | Komplexe wirtschaftliche Aufgaben |
| CyberGym | 82.2 | Cybersecurity-Problemlösen |
| BabyVision with tools | 91.0 | Visuelles Reasoning mit Tools |
| HLE without tools | 43.4 | Anspruchsvolles Wissen und Reasoning |
Automation-Bench v1.0.6 nutzt 600 öffentliche Aufgaben. BankerToolBench verwendet OpenCode 1.17.18 mit MiniMax-M2.7 als Judge; Terminal Bench 4.0 nutzt Codex 0.149.1. DeepSWE v1.1 verwendet mini-SWE-agent 2.4.5 mit einem Kontextlimit von 512K. OSWorld nutzt den 0808 Full Release: Die Tabelle kombiniert den jeweils höchsten Release-Score jedes Modells, außer DeepSeek V4.1, das MiniMax intern reproduzierte. Diese unterschiedlichen Setups begrenzen direkte modellübergreifende Schlussfolgerungen.
Für Geschäftsautomatisierung priorisieren Sie Automation-Bench und BankerToolBench; für Coding-Agenten betrachten Sie DeepSWE und terminalbasierte Ergebnisse. OSWorld bewertet Interaktionen mit einer Computerumgebung statt lediglich das Generieren von Anweisungen. Ein einzelner aggregierter Score kann eine aufgabenspezifische Analyse nicht ersetzen.
How Fast Is MiniMax M3.1 Flash?
Agentensysteme führen häufig viele sequentielle Modellaufrufe aus, daher beschreibt Durchsatz allein die Reaktionsfähigkeit nicht vollständig.
| Speed metric | Reported performance |
|---|---|
| Everyday peak output throughput | 200+ tokens/s |
| Median output throughput (P50) | 170+ tokens/s |
| Online inference improvement | Nearly 3× vs prior generation |
| Agent workload cost reduction | 70% vs predecessor |
Diese vom Anbieter gemeldeten Geschwindigkeits- und Workload-Kostenzahlen beschreiben die Startbewertung von MiniMax, sind jedoch keine garantierten Durchsätze oder Einsparungen für jede Anwendung. Serving-Hardware, Parallelität, Prompt-Längen und Variabilität zwischen Läufen sind in der Ankündigung nicht vollständig spezifiziert.
Die End-to-End-Latenz umfasst außerdem First-Token-Verzögerung, Reasoning-Overhead, Tool-Zeit, Retrys und Abhängigkeiten zwischen Schritten. Ein schneller Generator kann seinen Vorteil verlieren, wenn ein Agent mehr Aufrufe benötigt, um dieselbe Aufgabe abzuschließen.
How Much Does MiniMax M3.1 Flash API Cost?
MiniMax kündigte für M3.1 Flash flache Standardtarife ohne separate höhere Langkontext-Stufe in der initialen Preisbeschreibung an. Unterdessen bietet die MiniMax M3.1 Flash Preview API in CometAPI eine separate Preisstruktur mit 20% Rabatt gegenüber den dort angezeigten Referenzpreisen.
| Pricing category | Official M3.1 Flash | CometAPI Preview (≤512K) | CometAPI Preview (>512K) |
|---|---|---|---|
| Input tokens / 1M | $0.15 | $0.24 | $0.48 |
| Output tokens / 1M | $0.60 | $0.96 | $1.92 |
| Cached input / 1M | $0.02 | $0.05 | $0.10 |
| Pricing structure | Flat rate | Short-context tier | Long-context tier |
Die offiziellen MiniMax-API-Preise machen M3.1 Flash besonders attraktiv für Agenten-Workloads. Output-Tokens kosten das Vierfache des Standard-Input-Satzes, während zwischengespeicherter Input ein Zehntel kostet. Wiederholte Anweisungen und Tool-Historien können daher zu einem zentralen Optimierungsziel werden.
Die CometAPI-Preview-Preise beginnen bei $0.24 pro Million Input-Tokens und $0.96 pro Million Output-Tokens und stellen einen 20%igen Rabatt gegenüber den angezeigten Preview-Referenzpreisen dar. Diese Sätze bleiben jedoch höher als die neu angekündigten offiziellen Preise von M3.1 Flash, da beide Angebote unterschiedliche Preisbasen verwenden.
Für Entwickler ist der entscheidende Unterschied, dass CometAPI eine einheitliche Integrations-Erfahrung bietet, während die offizielle Veröffentlichung derzeit niedrigere veröffentlichte Token-Sätze aufweist. Überprüfen Sie vor der Bereitstellung die aktive Modellversion, die Kontextlängen-Stufe und die Abrechnungsregeln, um die Kosten autonomer Agenten-Workflows genau abzuschätzen.
MiniMax M3.1 Flash Cost per Agent Task
Geschätzte Inferenzkosten = (nicht zwischengespeicherte Input-Tokens × Input-Rate + zwischengespeicherte Input-Tokens × Cache-Rate + Output-Tokens × Output-Rate) / 1,000,000.
| Illustrative workload | Uncached input | Cached input | Output | Est. cost |
|---|---|---|---|---|
| Simple tool assistant | 10K | 0 | 2K | $0.0027 |
| Pull request review | 40K | 20K | 8K | $0.0111 |
| Multi-step coding agent | 100K | 200K | 30K | $0.0360 |
| Enterprise research | 300K | 700K | 80K | $0.1035 |
| Large autonomous workflow | 1M | 3M | 200K | $0.3150 |
Veranschaulichende Berechnungen, keine beobachtete Abrechnung. Nimmt an, dass Cache-Lesevorgänge für die angekündigte Cache-Rate qualifizieren; schließt Tool-, Such-, Browser-, Infrastruktur- und Human-Review-Kosten aus.
Reasoning Effort and Task Cost
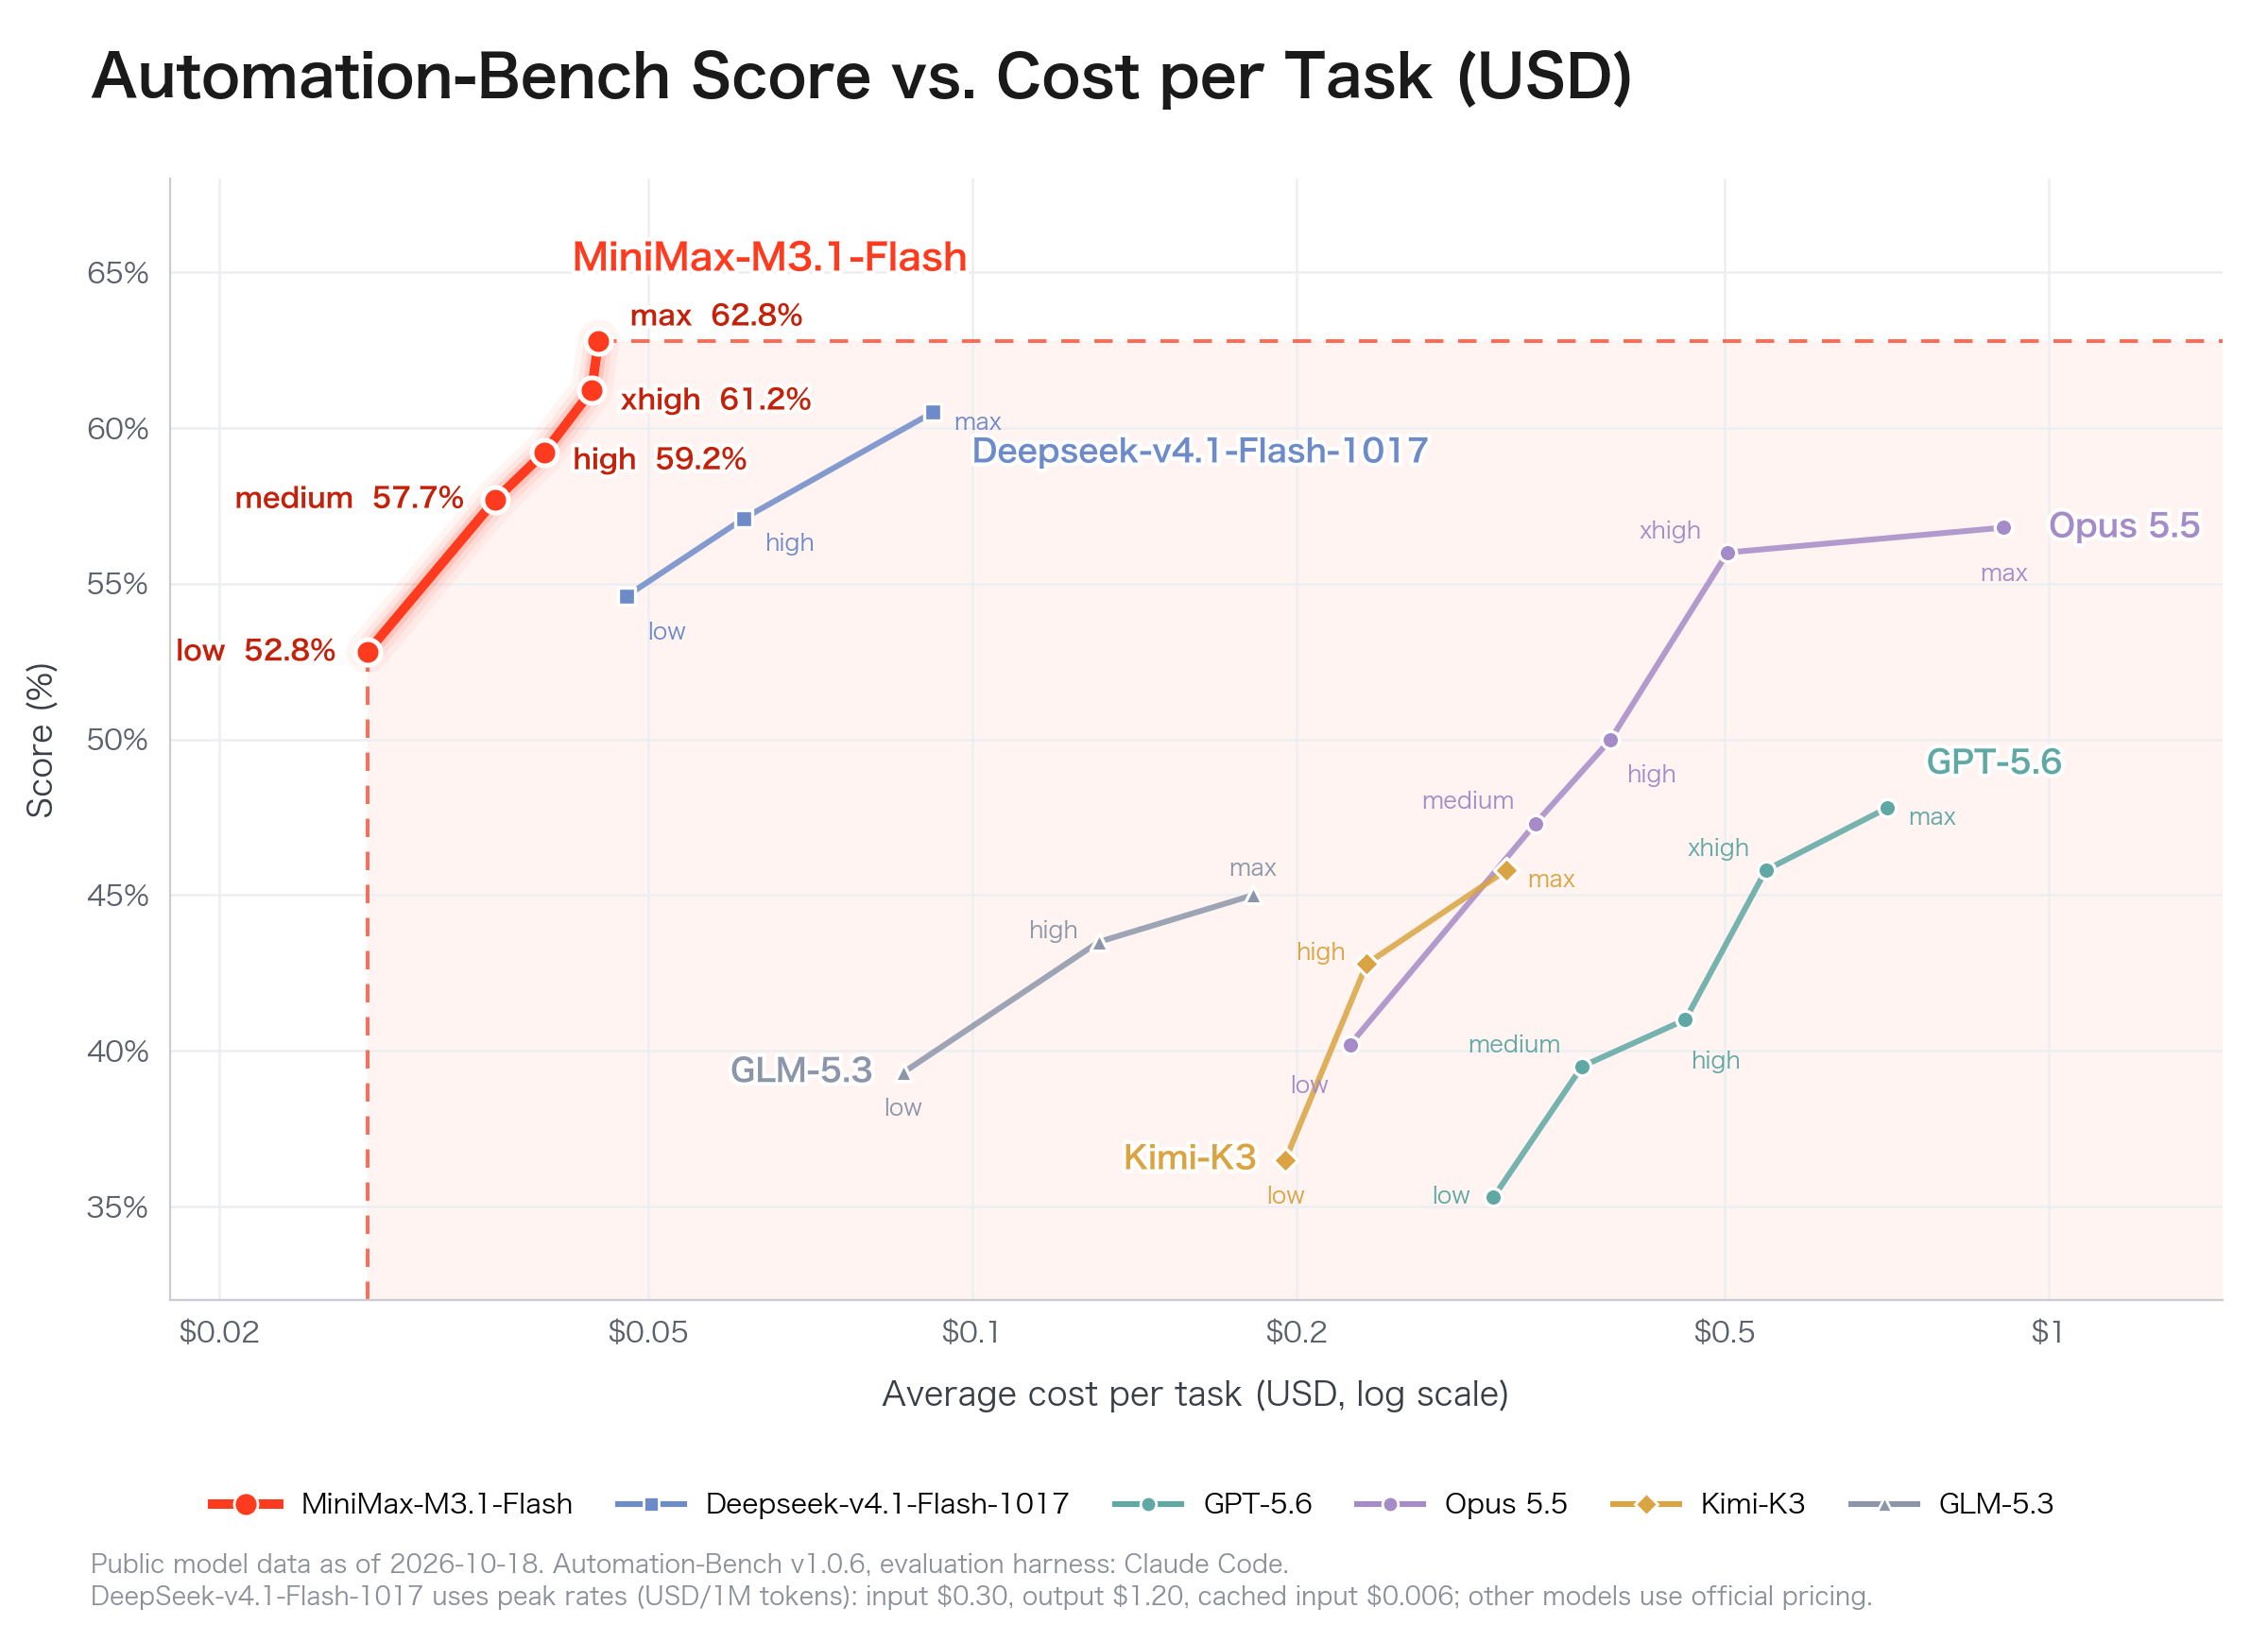
MiniMaxs Automation-Bench-Kostenanalyse verknüpft Reasoning-Aufwand mit Benchmark-Erfolg und Inferenzausgaben pro Aufgabe.
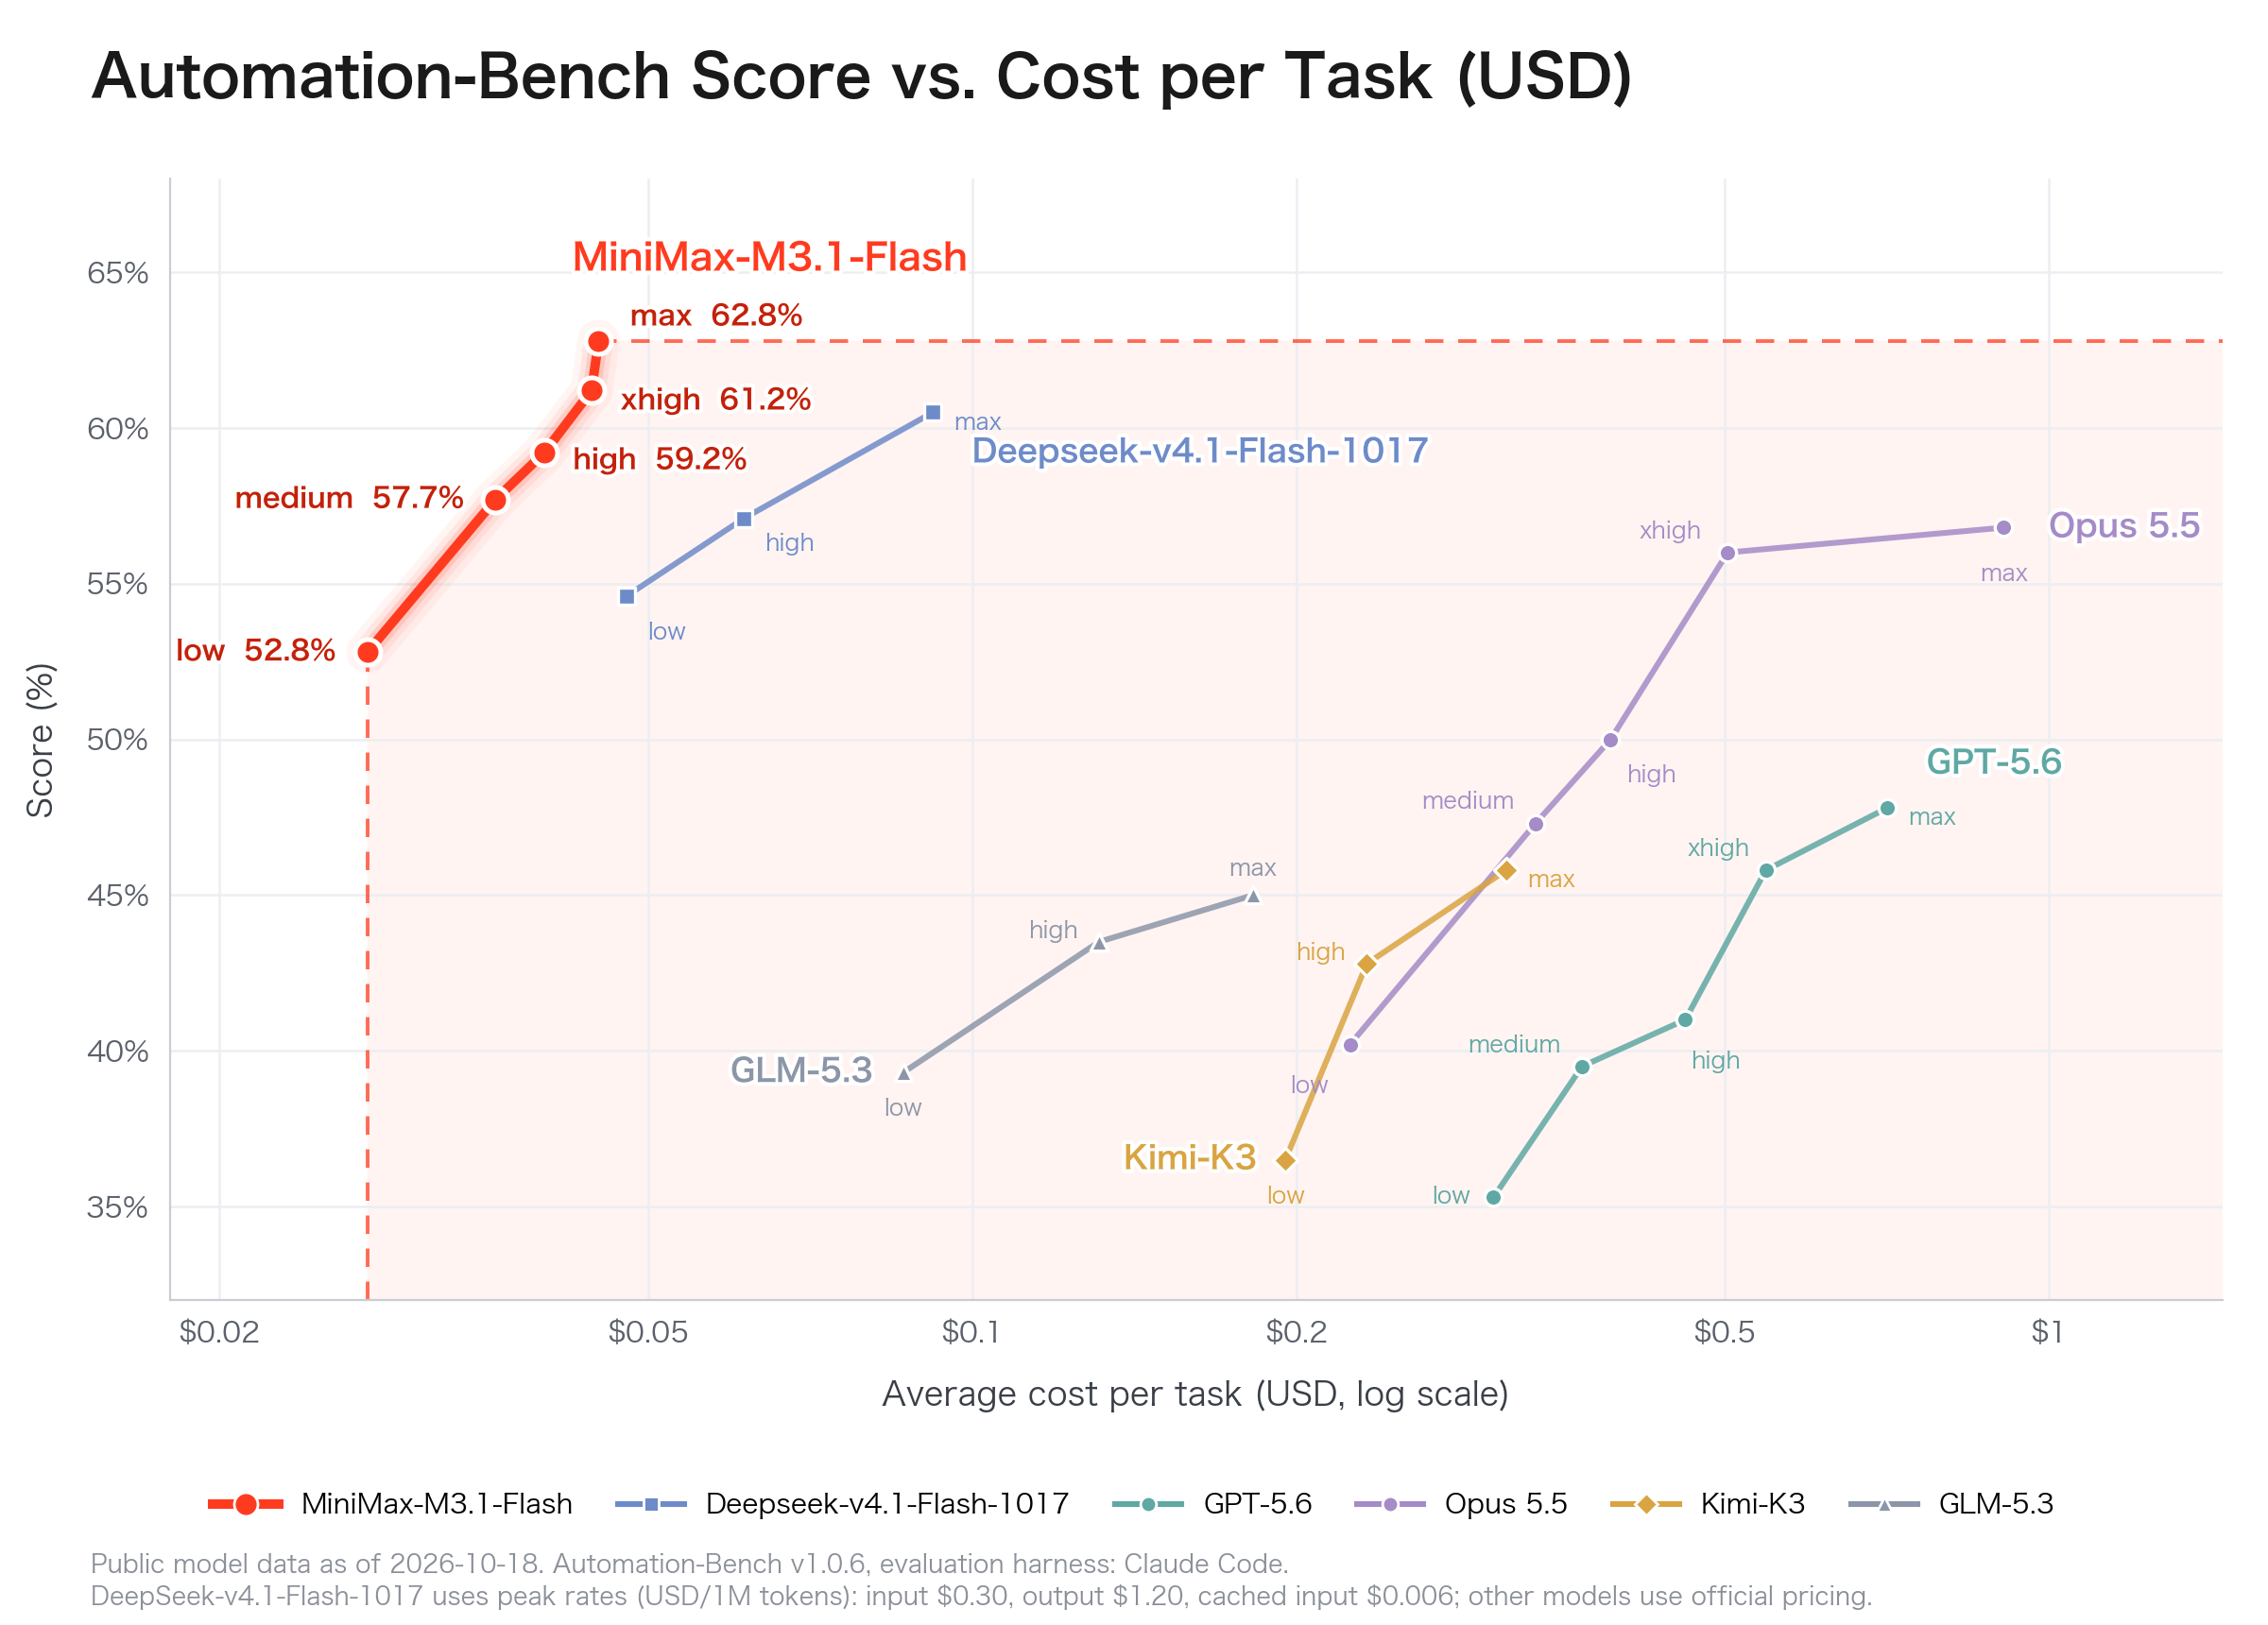
MiniMaxs offizielles Automation-Bench-Diagramm Score vs. Kosten. Die horizontale Achse ist logarithmisch; genaue Dollarwerte sind für die einzelnen MiniMax-Punkte nicht angegeben.
Die Evaluationshinweise des offiziellen Diagramms spezifizieren Automation-Bench v1.0.6 mit dem Claude Code Harness und öffentlichen Modelldaten mit Stand 18. Oktober 2026. DeepSeek verwendet Spitzen-Token-Sätze; die anderen Modelle verwenden offizielle Preise. Hardwaredetails und Konfidenzintervalle über wiederholte Läufe sind nicht angegeben.
| Reasoning effort | Labeled Automation-Bench score |
|---|---|
| Low | 52.8% |
| Medium | 57.7% |
| High | 59.2% |
| Xhigh | 61.2% |
| Max | 62.8% |
Die aktuelle offizielle Vergleichstabelle und der Max-Aufwandspunkt zeigen beide 62.8. Die Kostenkurve vergleicht Aufwandseinstellungen innerhalb des Anbietersetups; sie legt keine festen Dollar-Kosten für einen Produktionsagenten fest.
Der beschriftete Score steigt von niedrigem zu maximalem Aufwand um 10 Prozentpunkte. Vergleichen Sie für die Bereitstellung Medium und höhere Aufwände auf einem festen Aufgabensatz und zählen Sie Fehlversuche und Retrys in den Gesamtausgaben mit. Wählen Sie die Einstellung, die das Qualitätsziel zu den niedrigsten gemessenen Kosten pro akzeptierter Aufgabe erfüllt.
How Can Developers Access MiniMax M3.1 Flash Through CometAPI?
Entwickler können auf die MiniMax M3.1 Flash API in CometAPI zugreifen. Der öffentliche Katalog mit Stand 20. Oktober 2026 zeigt die Modell-ID minimax-m3.1-flash, obwohl die URL ein Preview-Suffix beibehält. Verwenden Sie die für Ihr Konto verfügbare Modell-ID, statt eine API-Kennung aus der Seiten-URL abzuleiten.
Senden Sie eine POST-Anfrage an https://api.cometapi.com/v1/chat/completions mit Authorization: Bearer YOUR_COMETAPI_KEY und Content-Type: application/json. Setzen Sie im JSON-Body model auf minimax-m3.1-flash (falls für Ihr Konto aktiviert) und geben Sie ein messages-Array an. Siehe die CometAPI-Dokumentation für Anfragedetails.
Warum CometAPI? Der einheitliche API-Key, das kompatible Request-Format und das Nutzungs-Dashboard können die Arbeit über mehrere Modellanbieter hinweg vereinfachen. Für MiniMax M3.1 Flash sollten Sie diesen Integrationsvorteil gegenüber den oben genannten anbieterspezifischen Preisen abwägen und die für Ihr Konto verfügbaren Funktionen überprüfen.
Which AI Agents Benefit Most From MiniMax M3.1 Flash?
| Use case | Why it may fit | Deployment consideration |
|---|---|---|
| Enterprise automation | Starke Automation-Bench-Ergebnisse | Tools und Retrys validieren |
| Coding assistants | Wettbewerbsfähige DeepSWE-Leistung | Tests ausführen und Patches prüfen |
| Customer support | Niedrige Input- und Cache-Preise | Genauigkeit überwachen |
| Research agents | 1M Kontextfenster | Belege und Quellen prüfen |
| Computer-use agents | OSWorld-Fähigkeit | UI-Änderungen und Recovery handhaben |
| Security code review | CyberGym-Ergebnis | Unabhängige Verifikation |
Die Vorteile sind am größten, wenn ein Agent genügend Aufgaben korrekt abschließt, um Kosten für Retrys, Orchestrierung und Reviews auszugleichen. In der Produktion sollten sowohl Modell- als auch Workflow-Ebene gemessen werden.
Is MiniMax M3.1 Flash the Best Value for AI Agents?
MiniMax M3.1 Flash ist eine starke Option für kostensensitive Agenten mit wiederholtem Kontext und strukturierten Tools, doch der niedrigste Tokenpreis führt nicht immer zu den niedrigsten Kosten pro erfolgreicher Aufgabe. Fehlgeschlagene Aufrufe, zusätzliche Retrys und menschliche Eingriffe können Einsparungen zunichtemachen. Bewerten Sie die Akzeptanzrate, End-to-End-Zeit, Gesamtkosten pro erfolgreicher Aufgabe und die Rate menschlicher Eingriffe.
FAQ
Why can MiniMax M3.1 Flash return an empty answer?
Auf MiniMaxs nativer OpenAI-kompatibler API verbrauchen Thinking-Tokens das Generierungsbudget. Ein zu kleines Limit kann eine Anfrage mit finish_reason auf length beenden, bevor sichtbarer Antworttext erzeugt wird. Prüfen Sie die Beendigungsursache und die Token-Nutzung, erhöhen Sie bei Bedarf das Completion-Budget und behandeln Sie reasoning_content getrennt von der finalen Antwort. Bestätigen Sie dieselben Antwortsemantiken auf einer Drittanbieter-Route.
How should MiniMax M3.1 Flash tool-call history be stored?
Bewahren Sie die vollständige Assistant-Nachricht auf, einschließlich Tool-Calls und Reasoning-Inhalt, bevor Sie die passenden Tool-Ergebnisse anhängen. Nur die sichtbare Antwort zu speichern, kann Informationen entfernen, die für den nächsten Schritt benötigt werden. Erhalten Sie Tool-Call-IDs und Nachrichtenreihenfolge und validieren Sie das Replay-Verhalten über den tatsächlichen Provider-Endpunkt. Die Konversationshistorie-Leitlinien von MiniMax beschreiben die Anforderungen der nativen API.
How can teams detect MiniMax M3.1 Flash routing changes?
Halten Sie eine kleine Regression-Suite mit festen Inputs, erwarteter Ausgabestruktur und Tool-Call-Assertions bereit. Protokollieren Sie die angeforderte Modell-ID, den zurückgegebenen Modell-Identifier (sofern vorhanden), Anbieter, Zeitstempel und abgerechnete Nutzung. Führen Sie sie nach Anbieterupdates erneut aus; ein stabiler Alias allein zeigt nicht, dass der zugrunde liegende Checkpoint oder das Verhalten unverändert ist.
How should a MiniMax M3.1 Flash migration be staged?
Beginnen Sie mit Read-only- oder Replay-Aufgaben, leiten Sie dann einen kleinen Anteil des Live-Traffics um, während Sie einen getesteten Fallback beibehalten. Definieren Sie Rollback-Schwellen für ungültige Tool-Calls, Timeouts und erfolglose Aufgaben, bevor Sie den Traffic erhöhen. Prüfen Sie Beispiele für Regressionen, statt sich nur auf Durchschnittswerte zu verlassen, da eine kleine Zahl kostspieliger Fehler niedrigere Tokenpreise überwiegen kann.
Conclusion
MiniMax M3.1 Flash verbessert die Wirtschaftlichkeit autonomer KI-Agenten durch günstige Tokens, konfigurierbares Reasoning, ein großes Kontextfenster und starke gemeldete Automatisierungs- und Coding-Ergebnisse. Der Schlüsselvorteil ist das Gleichgewicht zwischen Leistung, Latenz und Aufgabenkosten — nicht die absolute Überlegenheit in jedem Benchmark.
Entwickler sollten reale Workflow-Abschlussraten und Gesamtkosten von Agenten validieren und dann die MiniMax M3.1 Flash Route wählen, deren aktive Konfiguration, unterstützte Funktionen und Abrechnung ihren Anforderungen entsprechen.