
TLDR MiniMax M4 ist nicht veröffentlicht. MiniMax hat öffentlich eine neue Generation seiner M-Serie (und Hailuo-Video) für die zweite Jahreshälfte 2026 zugesagt. Das aktuelle Flaggschiff bleibt MiniMax M3 (Launch am 1. Juni 2026: ~428B gesamt / ~23B aktive Parameter, 1M-Token-Kontext via MiniMax Sparse Attention, native Multimodalität, offene Gewichte, 59.0% auf SWE-Bench Pro).
Ein Mid-Cycle-Effizienz-Refresh, Minimax M3.1 Flash, startete am 19. Oktober 2026 und liefert etwa 3× schnellere Inferenz sowie ~70% niedrigere agentische Kosten. Entwickler können bereits über einheitliche Gateways wie CometAPI auf die aktuelle MiniMax-Produktlinie (einschließlich M3 und M3.1 Flash) zugreifen, um Routing, Monitoring und Kostenkontrolle zu vereinfachen.
Zentrale Erkenntnisse
- MiniMax M4 ist mit Stand 20. Oktober 2026 nicht veröffentlicht. Das Unternehmen hat lediglich „eine neue Generation der M-Serie und Hailuo-Modelle in der zweiten Jahreshälfte 2026“ zugesagt.
- Aktuelle Produktionsmodelle: MiniMax M3 (1. Juni 2026) und der effizienzfokussierte M3.1 Flash (19. Oktober 2026).
- M3 führte MSA (MiniMax Sparse Attention) ein, das einen praktischen 1M-Token-Kontext ermöglicht, native Bild/Video-Verarbeitung, starke Coding-/Agent-Bewertungen und offene Gewichte bietet.
- M3.1 Flash priorisiert Geschwindigkeit und Kosten (angeblich ~3× Inferenz-Beschleunigung und 70% niedrigere agentische Kosten), behält das 1M-Kontextfenster und multimodale Eingaben bei; offene Gewichte werden kurz nach dem Launch erwartet.
- Ein Bericht vom Juli 2026 beschrieb einen internen Ansatz mit ~2,7 Billionen Parametern (intern M3 Pro genannt) mit einem möglichen Open-Weight-Release bereits in Q3 2026; dies hat sich öffentlich nicht materialisiert und ist von der breiteren Verpflichtung zur „neuen Generation“ zu unterscheiden.
- Erwartete M4-Verbesserungen (spekulativ, basierend auf der Entwicklung): weitere Fortschritte bei Coding/Agenten, verfeinerte Langkontext-Effizienz, stärkere multimodale oder Computer-Nutzungsfähigkeiten und weiterhin aggressive Preisgestaltung.
- Zugriffsempfehlung: Verwenden Sie ein Multi-Provider-Gateway wie CometAPI, um Traffic über MiniMax M3/M3.1 Flash (und zukünftiges M4) zusammen mit anderen Frontier-Modellen mit einheitlicher Abrechnung, Observability und Fallback-Logik zu routen.
Kommt MiniMax M4 wirklich bald?
Bestätigte Informationen
Die zentrale Frage ist nicht, ob MiniMax zukünftige KI-Systeme entwickelt, sondern ob es konkrete Hinweise gibt, dass ein Modell namens MiniMax M4 kurz vor der Veröffentlichung steht.
MiniMax veröffentlichte M3 im Juni 2026 und führte M3.1 Flash offiziell am 19. Oktober 2026 ein. Dies ist ein bestätigtes Zwischenrelease, kein Beweis für einen M4-Zeitplan. Offizielle Launch-Ankündigung.
Das offizielle Forschungsarchiv enthält nun M3.1 Flash. Am 20. Oktober 2026 wurde in den geprüften offiziellen Quellen keine M4-Launch-Ankündigung gefunden.
| Evidenzkategorie | Befund | Bewertung |
|---|---|---|
| Offizielle M4-Ankündigung | Nicht verifiziert | Unbestätigt |
| Öffentlicher M4-Modellbezeichner | Nicht verifiziert | Unbestätigt |
| Geleakter M4-Benchmark-Screenshot | Keine unabhängig verifizierten Belege gefunden | Unbestätigt |
| M4-API-Endpunkt | Nicht verifiziert | Unbestätigt |
| M4-Preise | Nicht veröffentlicht | Unbekannt |
| M4-Modellgewichte | Nicht verifiziert | Unbekannt |
| MiniMax M3-Launch | 1. Juni 2026 | Bestätigt |
| M3.1 Flash-Release | Veröffentlicht am 19. Oktober 2026; verfügbar über MiniMax API, M Plan und MiniMax Code | Bestätigt |
Community-Berichte / Leaks
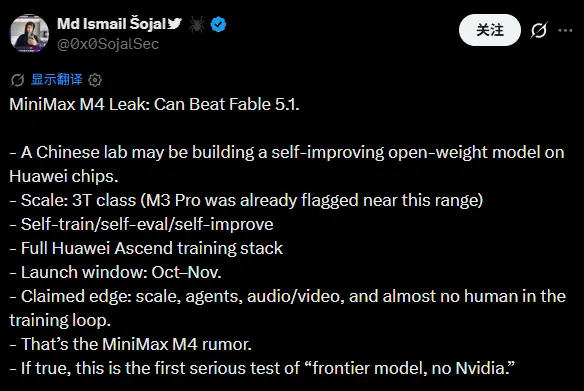
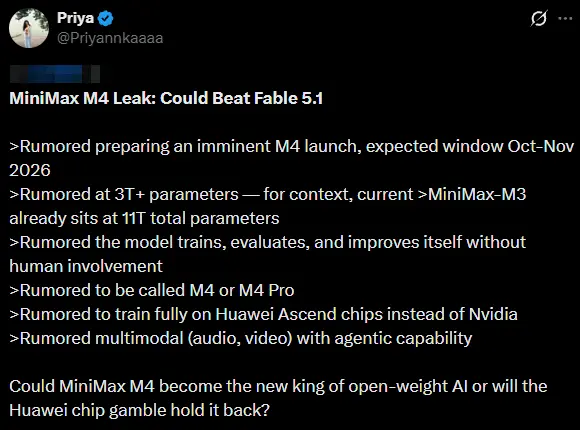
Zwei X-Posts vom 27. September 2026 diskutieren einen möglichen M4-Release. Sie belegen, dass diese Behauptungen in der Community kursierten, nicht dass MiniMax sie bestätigt hat. Beide werden hier als unbestätigte Community-Berichte behandelt; keiner der verifizierten Abzeichen der Autoren belegt die Richtigkeit der Aussagen.
In einem Beitrag von @0x0SojalSec suggeriert der Autor ein Modell mit rund drei Billionen Parametern, ein Open-Weight-Release und Training auf Huawei-Ascend-Hardware. Der lesbare Auszug beschreibt auch eine Schleife, in der das Modell an seinem eigenen Training und seiner Evaluation beteiligt ist. Dies sind Aussagen des Posters, keine verifizierten M4-Spezifikationen.
Ein Beitrag von Priya (@Priyannkaaaa) suggeriert einen möglichen Release im Oktober–November 2026 und eine Parameteranzahl von über drei Billionen. Er enthält zudem eine unbestätigte Behauptung zur Größe des vorausgehenden M3-Modells. Dieser Vergleich wird in diesem Artikel nicht als faktische Grundlage übernommen.
Wann könnte MiniMax M4 erscheinen?
Frühere Modelle bleiben nützliche Referenzpunkte, einschließlich MiniMax M2.5 API in CometAPI. Ihre Daten stellen Historie dar, keine Prognose für den nächsten Release.
MiniMax hat kein M4-Launch-Datum bestätigt. Das in Priyas Community-Post genannte Fenster Oktober–November 2026 ist ein Gerücht, kein offizieller Zeitplan; der zugrunde liegende Auszug und seine Einschränkungen werden in Community-Berichte / Leaks erörtert. Die Release-Historie der Modellfamilie zeigt sowohl große Generationen als auch Zwischenversionen, aber vergangene Startintervalle erlauben keine verlässliche Vorhersage des nächsten Releases.
| Meilenstein | Offizieller Veröffentlichungszeitplan | Bedeutung |
|---|---|---|
| MiniMax M2.5 | 12. Februar 2026 | Coding und Produktivität |
| MiniMax M2.7 | 18. März 2026 | Verbesserungen bei Agent-Workflows |
| MiniMax M3 | 1. Juni 2026 | 1M-Kontext und Multimodalität |
| M3.1 Flash | 19. Oktober 2026 — offizieller Release | Veröffentlichtes, effizienzfokussiertes Coding-/Agent-Modell |
| MiniMax M4 | Nicht angekündigt | Kein verifizierter Zeitplan |
Eine formale Produktankündigung von MiniMax wäre das stärkste Signal. API-Dokumentation oder ein authentifizierter Modellbezeichner würden zusätzliche Belege liefern. Benchmark-Ergebnisse und öffentliche Model Cards würden die Bewertung technischer Verbesserungen ermöglichen, während offizielle Preisangaben und Rate Limits die Produktionsfähigkeit bestimmen.
Preis von MiniMax M4 — Was Leaks und frühere Generationen nahelegen
Es existieren keine offiziellen Preise für M4. Alle nachstehenden Zahlen sind Extrapolationen aus den aktuellen M3- und M3.1-Flash-Preistabellen (USD, pro Million Tokens, ungefähr Mitte Oktober 2026):
| Modell | Input / 1M | Output / 1M | Zwischengespeicherter Input | Kontext | Hinweise |
|---|---|---|---|---|---|
| MiniMax M3 | $0.30 | $1.20 | ~$0.06 | 1M | „Permanent 50% off“-Listenpreise; höhere Stufe für >512k Kontext |
| MiniMax M3.1 Flash | $0.15 | $0.60 | $0.015 | 1M | ~50% günstiger als M3; optimiert für Agent-Throughput |
| Erwarteter M4-Bereich (spekulativ) | $0.20–$0.40 | $0.80–$1.50 | Ähnliche Rabattstruktur | 1M+ | Voraussichtlich weiterhin eines der günstigsten offenen Frontier-Angebote |
Quellen für aktuelle Preise: MiniMax-Plattformdokumentation, unabhängige Aggregatoren und Launch-Ankündigungen.
MiniMax positioniert seine Modelle wiederholt zu einem Bruchteil der Kosten führender, geschlossener westlicher Modelle und erreicht dabei auf ausgewählten Coding- und Agent-Benchmarks vergleichbare oder bessere Ergebnisse. Ein vollständiges M4 dürfte diese Strategie fortsetzen, mit möglichen Premium-Stufen für erweiterten Kontext, priorisierte Latenz oder höheren Reasoning-Aufwand.
CometAPI-Empfehlung: Anstatt mehrere MiniMax-API-Schlüssel und Preistabellen direkt zu verwalten, routen Sie über ein einheitliches Gateway wie CometAPI. So lassen sich M3, M3.1 Flash und (bei Verfügbarkeit) M4 nahtlos umschalten, automatische Fallbacks nutzen, die Verwendung analysieren und oft durch Volumenbündelung effektiv bessere Preise erzielen—besonders wertvoll für agentische Workloads mit hohem Token-Verbrauch.
Was MiniMax M3.1 Flash über die nächste Generation verrät
MiniMax M3.1 Flash bietet einen aktuelleren Referenzpunkt, um einzuschätzen, was ein zukünftiges MiniMax M4 liefern könnte. Offiziell am 19. Oktober 2026 vorgestellt, fokussiert M3.1 Flash agentische Workflows, Softwareentwicklung, Computer-Nutzung und Cybersicherheit, bei gleichzeitig schnellerer Inferenz und geringeren Nutzungskosten. Diese Verbesserungen liefern nützliche Hinweise auf die aktuellen Engineering-Prioritäten von MiniMax, bestätigen jedoch weder ein M4-Release-Datum noch dessen zukünftige Spezifikationen.
1. Agenten-Zuverlässigkeit wird so wichtig wie reine Intelligenz
Eines der klarsten Themen in der M3.1-Flash-Ankündigung ist die Betonung auf dem Abschluss komplexer, mehrstufiger Aufgaben. MiniMax berichtet von Verbesserungen in agentischen Workflows, Coding, Computer-Nutzung und Unternehmensautomatisierung.
Dies deutet darauf hin, dass die nächste Generation weniger an isolierter Frage-Antwort-Leistung gemessen wird, sondern stärker an der Fähigkeit, vollständige Workflows zuverlässig abzuschließen.
Beispielsweise muss ein Software-Engineering-Agent ein Repository inspizieren, einen Defekt identifizieren, mehrere Dateien ändern, Tests ausführen, Fehler diagnostizieren und den finalen Patch verifizieren. Erfolg hängt nicht nur von der Qualität des Reasonings ab, sondern auch von Toolauswahl, Zustandstracking, Fehlerbehebung und Konsistenz über mehrere Schritte.
Ein zukünftiges M4 könnte darauf aufbauen, indem es die Planung über lange Horizonte verbessert, unnötige Tool-Aufrufe reduziert und sich von fehlgeschlagenen Aktionen effektiver erholt. Dies sind vernünftige Evaluationsziele, keine bestätigten M4-Features.
2. Inferenz-Effizienz könnte ein großer Wettbewerbsvorteil werden
MiniMax berichtet, dass M3.1 Flash nahezu die dreifache Online-Inferenzgeschwindigkeit seines Vorgängers liefert und die Gesamtnutzungskosten für agentische Aufgaben um 70% reduziert. Das Unternehmen führt die Effizienzgewinne auch auf aggressivere Sparsity zurück.
Diese Aussagen unterstreichen den Unterschied zwischen Modellintelligenz und praktischer Betriebseffizienz. Ein Modell, das eine Aufgabe mit weniger Wiederholungen, geringerer Latenz und niedrigerem Tokenverbrauch abschließt, kann wertvoller sein als eines mit etwas höherem Benchmark-Score, das jedoch deutlich mehr Ressourcen benötigt.
Für ein mögliches M4 werden relevante Fragen sein, ob es hohen Durchsatz bei langlaufenden Aufgaben aufrechterhalten kann, die Output-Qualität unter engeren Inferenz-Budgets bewahrt und die Gesamtkosten erfolgreicher Aufgabenabschlüsse senkt.
Die berichteten M3.1-Flash-Verbesserungen sind Unternehmensangaben und sollten unter vergleichbaren Workloads unabhängig evaluiert werden, bevor sie als allgemeine Leistungszusagen gelten.
3. Programmierung und Computer-Nutzung bleiben Beobachtungsschwerpunkte
Die M3.1-Flash-Ankündigung berichtet von 73.7% auf DeepSWE v1.1, 61.7 auf OSWorld V2 und 82% auf CyberGym. Diese Ergebnisse decken unterschiedliche Aspekte von Softwareentwicklung, Computerinteraktion und Cybersicherheit ab.
Zusammen bieten sie einen nützlicheren Ausgangspunkt für die Bewertung zukünftiger Modelle als ein einzelner, allgemeiner Benchmark.
Falls MiniMax M4 vorstellt, sollten Entwickler auf Belege achten, dass es den praktischen Abschluss von Aufgaben verbessert, statt lediglich höhere Schlagzeilen-Scores zu produzieren. Nützliche Tests könnten Repository-basierte Bugfixes, Cross-Application-Workflows, Browserautomatisierung, Schwachstellenanalyse und die Erholung von fehlgeschlagenen Tool-Aufrufen umfassen.
Benchmark-Vergleiche sollten Datensatzversion, Ausführungsumgebung, Agenten-Scaffold, Ressourcenlimits und Bewertungsmethodik konstant halten. Ohne vergleichbare Bedingungen spiegeln Score-Unterschiede möglicherweise keine echten Fähigkeitsverbesserungen wider.
4. Langer Kontext und multimodales Reasoning benötigen weiterhin praktische Evaluation
MiniMax M3 unterstützt bereits ein Kontextfenster von bis zu einer Million Tokens und native multimodale Eingaben, einschließlich Bilder und Video. Der M3.1-Flash-Release behält ein Kontextfenster von einer Million Tokens bei und kombiniert multimodales Verständnis mit stärkeren, agentenorientierten Fähigkeiten.
Ein größeres Kontextfenster allein wäre daher nicht zwingend ein überzeugender Grund für ein Upgrade auf M4.
Sinnvollere Fortschritte könnten eine bessere Retrieval-Leistung aus großen Repositories, stärkere Konsistenz über lange Dokumente, genauere Interpretation visueller Evidenz und verlässlichere Koordination zwischen Wahrnehmung und Toolausführung umfassen.
So könnte ein Entwicklungsagent etwa eine Bildschirmaufnahme inspizieren, einen UI-Fehler identifizieren, den relevanten Anwendungscode nachverfolgen, eine Korrektur implementieren und das Ergebnis verifizieren. Die Qualität des gesamten Workflows zählt mehr als die Fähigkeit des Modells, einen großen Input isoliert zu verarbeiten.
Diese Szenarien stellen mögliche Evaluationsprioritäten für M4 dar, nicht von MiniMax angekündigte Fähigkeiten.
5. Zukünftige Modellveröffentlichungen könnten an den Kosten pro abgeschlossener Aufgabe gemessen werden
Die M3.1-Flash-Ankündigung unterstreicht die Bedeutung, die Modelleconomie auf Workflows zu evaluieren. Tokenpreise allein erfassen nicht die Gesamtkosten des Einsatzes eines Agenten.
Ein nützlicherer Vergleich berücksichtigt die Erfolgswahrscheinlichkeit, die Anzahl der erforderlichen Versuche, den Tokenverbrauch, Toolkosten, Latenz und menschliche Eingriffe.
Entwickler, die sich auf einen zukünftigen M4-Release vorbereiten, sollten mit den derzeit verfügbaren Modellen eine Basislinie etablieren und denselben Aufgabensatz für den Vergleich späterer Releases verwenden. So lässt sich feststellen, ob ein neues Modell sinnvolle Produktivitätsgewinne liefert, statt lediglich die Benchmark-Rangfolge zu verändern.
Wie stark sind die MiniMax-M3-Benchmarks, und was müsste M4 schlagen?
MiniMax veröffentlichte eine umfangreiche Reihe von Benchmark-Ergebnissen für M3, die messbare Ziele für ein zukünftiges Modell liefern. Die folgenden Werte sind gemeldete M3-Ergebnisse, keine M4-Prognosen.
| Benchmark | Gemeldeter Wert MiniMax M3 | Was evaluiert wird | M4-Verifizierungsziel |
|---|---|---|---|
| SWE-Bench Pro | 59.0% | Praxisnahe Softwareentwicklung | Höhere verifizierte Aufgabenauflösung |
| Terminal-Bench 2.1 | 66.0% | Terminalbasierte Agentenausführung | Mehr erfolgreiche End-to-End-Operationen |
| SWE-fficiency | 34.8% | Effizienz bei Coding-Aufgaben | Bessere Leistung unter vergleichbaren Budgets |
| KernelBench Hard | 28.8% | GPU-Kernel-Optimierung | Korrektheit und schnellere Kernel |
| MCP Atlas | 74.2% | Tool-orientierte und MCP-Aufgaben | Bessere Toolauswahl und -ausführung |
Dies sind vom Anbieter gemeldete Ergebnisse aus der Launch-Ankündigung vom 1. Juni 2026, keine unabhängigen Replikationen. Die Suites messen unterschiedliche Ergebnisse; ihre Prozentwerte dürfen nicht zu einem einzigen Accuracy-Score gemittelt werden.
Programmier- und Software-Engineering-Leistung
Bestätigt (M3)
- SWE-Bench Pro: 59.0%
- Terminal-Bench 2.1: 66.0%
- Starke Ergebnisse bei realen Bugfix-, Frontend/Backend- und Kernel-Optimierungsaufgaben (interne MiniMax-Evaluationen zeigten mehrstündige autonome Iteration).
Was M3.1 Flash hinzufügt: Behauptete weitere Zugewinne bei Coding-, agentischen und Cybersicherheits-Benchmarks sowie deutlich höhere Tokens pro Sekunde und niedrigere Kosten pro abgeschlossener Agenten-Trajektorie.
Unbestätigt/Erwartet für M4: Höhere absolute Scores auf SWE-Bench-ähnlichen und mehrstufigen, interaktiven Coding-Benchmarks, bessere Projektsteuerung über lange Horizonte und verbesserte Konsistenz über Multi-File- und Multi-Day-Sessions. Jedes 2,7T-Modell (falls veröffentlicht) dürfte die Fähigkeitsobergrenze weiter anheben; aktive Parameterzahl und Sparsity bestimmen jedoch die realen Kosten.
Langkontext-Effizienz und Architektur
Bestätigt: M3 führte MSA (MiniMax Sparse Attention) ein, das einen praktischen 1M-Token-Kontext liefert, mit angeblich 1/20 der Per-Token-Compute der vorherigen Dense-Attention-Generation, >9× Prefilling- und >15× Decoding-Speedups bei extremen Längen, bei gleichzeitiger Parität zur Full Attention bei den meisten Fähigkeiten.
Erwartete Verbesserungen: Verfeinerte Sparsity-Muster, bessere Unterstützung für noch längere Kontexte oder dichtere Retrievals innerhalb des Fensters, geringerer Speicherbedarf für Self-Hosting und verbessertes Handling verschachtelter multimodaler Langdokumente.
Multimodale und Computer-Nutzungsfähigkeiten
Bestätigt: Native Bild- und Videoverarbeitung ab den ersten Trainingsphasen sowie demonstrierte Computer-Nutzung (Desktop-Bedienung) in MiniMax Code und Agenten-Harnesses.
Erwartet für M4: Engere Integration des Videoverständnisses mit Agentenplanung, stärkere Dokument-/Screenshot-to-Code-Pipelines und verlässlichere, längerfristige Mehranwendungs-Steuerung des Computers.
Agentische Workflows, Tool-Nutzung und Selbstverbesserung
Bestätigt: M2.7 experimentierte bereits mit rekursiven Selbstverbesserungsschleifen. M3 und M3.1 Flash betonen Multi-Agenten-Zusammenarbeit, dynamische Toolsuche, langlaufende autonome Aufgaben und Producer-Verifier-Schleifen in MiniMax Code.
Erwartet: Robustere mehrtägige Agenten-Teams, bessere Erholung von Toolfehlern, native Unterstützung für größere Tool-Ökosysteme und möglicherweise fortgesetzte Selbstverbesserungs- oder Evolutionstechniken in größerem Maßstab.
Preis von MiniMax M4 — Was Leaks und frühere Generationen nahelegen
Es existieren keine offiziellen Preise für M4. Alle nachstehenden Zahlen sind Extrapolationen aus den aktuellen M3- und M3.1-Flash-Preistabellen (USD, pro Million Tokens, ungefähr Mitte Oktober 2026):
| Modell | Input / 1M | Output / 1M | Zwischengespeicherter Input | Kontext | Hinweise |
|---|---|---|---|---|---|
| MiniMax M3 | $0.30 | $1.20 | ~$0.06 | 1M | „Permanent 50% off“-Listenpreise; höhere Stufe für >512k Kontext |
| MiniMax M3.1 Flash | $0.15 | $0.60 | $0.015 | 1M | ~50% günstiger als M3; optimiert für Agent-Throughput |
| Erwarteter M4-Bereich (spekulativ) | $0.20–$0.40 | $0.80–$1.50 | Ähnliche Rabattstruktur | 1M+ | Voraussichtlich weiterhin eines der günstigsten offenen Frontier-Angebote |
MiniMax positioniert seine Modelle wiederholt zu einem Bruchteil der Kosten führender, geschlossener westlicher Modelle und erreicht dabei auf ausgewählten Coding- und Agent-Benchmarks vergleichbare oder bessere Ergebnisse. Ein vollständiges M4 dürfte diese Strategie fortsetzen, mit möglichen Premium-Stufen für erweiterten Kontext, priorisierte Latenz oder höheren Reasoning-Aufwand.
CometAPI-Empfehlung: Anstatt mehrere MiniMax-API-Schlüssel und Preistabellen direkt zu verwalten, routen Sie über ein einheitliches Gateway wie CometAPI. So lassen sich M3, M3.1 Flash und (bei Verfügbarkeit) M4 nahtlos umschalten, automatische Fallbacks nutzen, die Verwendung analysieren und oft durch Volumenbündelung effektiv bessere Preise erzielen—besonders wertvoll für agentische Workloads mit hohem Token-Verbrauch.
MiniMax M3 vs M3.1 Flash vs erwartete Richtung von M4
| Dimension | M3-API in CometAPI (Jun 2026) | MiniMax M3.1 Flash (Okt 2026) | Erwartete M4-Richtung (H2 2026+) |
|---|---|---|---|
| Status | Live, offene Gewichte | Live, Gewichte stehen bevor | Nicht veröffentlicht |
| Parameter (ca.) | 428B gesamt / ~23B aktiv | Ähnliche Größenordnung | Unbekannt (möglicherweise größeres MoE) |
| Kontext | 1M Tokens (MSA) | 1M Tokens | 1M+ mit weiterer Effizienz |
| Coding (SWE-Bench Pro) | 59.0% | Behauptete weitere Zugewinne | Höhere absolute Scores erwartet |
| Inferenzgeschwindigkeit | Starker Ausgangswert | ~3× schneller (behauptet) | Weitere Optimierung |
| Agentische Kosten | Wettbewerbsfähig | ~70% niedriger (behauptet) | Weiterhin aggressive Preisgestaltung |
| Multimodal | Native Bilder + Video | Gleich + verfeinert | Tiefere Integration |
| Offene Gewichte | Ja | Bald geplant | Sehr wahrscheinlich |
| API-Preis (in/out) | $0.30 / $1.20 | $0.15 / $0.60 | Erwartet $0.20–$0.40 / $0.80–$1.50 |
Modellauswahl nach Entwickler-Workflow
Setzen Sie den veröffentlichten M3.1 Flash als aktuelle Evaluationskandidaten ein und behalten Sie M3 sowie etablierte M2.7-Workflows zum Vergleich. Messen Sie abgeschlossene Aufgaben, Wiederholungen, menschliche Eingriffe und Gesamtkosten auf demselben Workload. Steuern Sie den Aufwand bewusst, anstatt anzunehmen, dass maximale „Denkanstrengung“ stets die beste Betriebsstrategie ist.
M4 ist noch keine handlungsrelevante Produktionsoption. Die nützlichste Vorbereitung ist der Aufbau einer reproduzierbaren Benchmark-Suite gegen bestehende Modelle, um einen zukünftigen Release schnell bewerten zu können.
Zugriff auf aktuelle MiniMax-Modelle (und Vorbereitung auf M4)
Während Sie auf M4 warten, ist der praktikable Weg die Nutzung der verfügbaren Modelle:
- Beschaffen Sie einen MiniMax-API-Schlüssel über die offizielle Plattform.
- Oder routen Sie für Produktionszuverlässigkeit über ein Multi-Model-Gateway wie CometAPI. CometAPI stellt einen einzigen Endpunkt und Schlüssel bereit, der MiniMax M3, M3.1 Flash und andere Anbieter ansteuern kann—mit integrierten Usage-Dashboards, Rate-Limit-Handling und der Möglichkeit, Modelle ohne Codeänderungen zu wechseln.
- Für Coding-Agenten koppeln Sie das Modell mit MiniMax Code (Desktop/CLI) oder offenen Frameworks, die bereits MiniMax-Endpunkte im Anthropic- oder OpenAI-Stil unterstützen.
- Beobachten Sie offizielle MiniMax-Kanäle und Aggregator-Kataloge; sobald eine neue M-Serien-Modell-ID erscheint, machen Gateways wie CometAPI sie in der Regel schnell sichtbar.
Dieser Ansatz minimiert Lock-in und ermöglicht es Teams, M3 vs. M3.1 Flash (und später M4) auf realen Workloads mit konsistenter Observability zu evaluieren.
Fazit
MiniMax M4 bleibt ein zukünftiges Modell, das durch eine klare, aber grobe Unternehmenszusage definiert ist, nicht durch konkrete Spezifikationen. Die M3-Generation etablierte MiniMax bereits als ernsthaften Open-Weight-Anbieter für Coding, Agenten und langkontextuelle Multimodalität; M3.1 Flash trieb anschließend die Effizienzgrenze voran. Welche Form die „neue Generation“ im 2. Halbjahr 2026 letztlich annimmt—ob als M3.5, M4 oder anders—sie wird auf einem starken Fundament aus Sparse Attention, offenen Gewichten und aggressiver Preisgestaltung aufbauen.
Für Entwickler und Teams, die heute Produktions-Agenten bauen, ist die handlungsleitende Empfehlung klar: Integrieren Sie die verfügbaren MiniMax-Modelle (M3 und M3.1 Flash) über eine flexible Multi-Provider-Schicht wie CometAPI. So erhalten Sie sofortige Fähigkeits- und Kostenvorteile und sind zugleich in der Lage, M4 unmittelbar nach seinem Erscheinen auf öffentlichen Endpunkten mit minimalen Codeänderungen und voller Transparenz über Performance und Ausgaben zu adoptieren.