Technische Spezifikationen von MiniMax M3.1-Flash
| Element | MiniMax M3.1-Flash |
|---|---|
| Modell-ID | MiniMax-M3.1-Flash |
| Modellfamilie | MiniMax M3.1-Serie, Coding-Modell |
| Release-Status | 27. September 2026 |
| Primärer Schwerpunkt | Alltägliche Softwareentwicklung, von Bugfixes bis zur vollständigen Feature-Umsetzung |
| Kontextfenster | 1,000,000 Token |
| Eingabemodalitäten | Text, Bild und Video |
| Ausgabemodalität | Text |
| Reasoning-Steuerung | reasoning_effort: low, medium, high, xhigh, max |
| Denkverhalten | Adaptives Denken ist erforderlich; die geprüfte öffentliche Dokumentation unterstützt das Deaktivieren des Denkens nicht |
| Maximale Ausgabe | In den geprüften öffentlichen Materialien nicht gesondert veröffentlicht |
| Parameteranzahl | Nicht öffentlich offengelegt |
| Offene Gewichte | Kein öffentliches Checkpoint-/Modell-Repository identifiziert |
MiniMax kündigte M3.1-Flash für MiniMax Code am 27. September 2026 an und positionierte es rund um alltägliche Entwicklungsaufgaben wie Fehlerbehebung und vollständige Feature-Lieferung. Die aktuelle öffentliche Berichterstattung nennt durchgängig ein Kontextfenster von 1M Token und einen einstellbaren Reasoning-Aufwand, weist jedoch darauf hin, dass weder eine eigenständige Benchmark-Tabelle noch ein Preis pro Token veröffentlicht wurden.
Was ist MiniMax M3.1-Flash?
MiniMax M3.1-Flash ist ein coding-orientiertes Textmodell, das für iterative Softwareentwicklungs-Workflows statt nur für Codegenerierung ausgelegt ist. MiniMax beschreibt den Workflow als Spannweite von Anforderungsverstehen, Problem-Lokalisierung, Implementierung, Regressionstests und Verifikation der Änderungen gegenüber bestehender Funktionalität.
Seine herausstechenden, dokumentierten Steuerungen sind der lange Kontext und eine fünfstufige Reasoning-Effort-Leiter. Die verfügbaren Stufen sind low, medium, high, xhigh und max, wodurch Entwickler die Tiefe des Reasonings und die Latenz entsprechend der Aufgabenkomplexität austarieren können.
Hauptfunktionen von MiniMax M3.1-Flash
- 1M-Token-Kontext: Die veröffentlichte Modellbeschreibung weist dem Modell ein Kontextfenster von einer Million Token zu, wodurch es sich für große Repositories, lange Spezifikationen und erweiterte Coding-Agent-Sitzungen eignet.
- Native multimodale Eingabe: Öffentliche Modellbeschreibungen führen Text, Bild und Video als Eingaben auf, während das Modell Text zurückgibt.
- Fünf Reasoning-Effort-Stufen:
low,medium,high,xhighundmaxbieten feinere Kontrolle über die Reasoning-Tiefe als ein einfaches Ein-/Aus-Schalten des Denkens. - End-to-End-Coding-Workflow: MiniMax positioniert das Modell ausdrücklich für Fehlerlokalisierung, Implementierung, Randfallbehandlung, Abschluss von Regressionstests und Validierung der Änderungen.
- Orientierte Bereitstellung: Die anfängliche öffentliche Einführung erfolgt über MiniMax Code und Token Plan statt über ein vollständig dokumentiertes, eigenständiges Pay-as-you-go-Modellangebot.
- Eignung für Coding-Agenten: Das Modell ist für wiederholte Entwicklungsinteraktionen ausgelegt, bei denen Repository-Kontext, Toolausgaben, Tests und iterative Korrekturen wichtiger sind als One-Shot-Codegenerierung.
MiniMax M3.1-Flash vs. andere MiniMax-Coding-Modelle
| Modell | Schwerpunkt | Kontext | Öffentliche Benchmark-Daten | Zugang/Status |
|---|---|---|---|---|
| M3.1-Flash | Alltägliches Coding, iterative Entwicklung | 1M | Noch nicht veröffentlicht | MiniMax Code / Token Plan |
| M3 | Frontier-Coding + agentische Arbeit, native Multimodalität | Bis zu 1M | Von MiniMax veröffentlicht | API, Token Plan, MiniMax Code |
| M2.7 | Software Engineering + breite Agenten-/Produktivitätsarbeit | Hier nicht verwendet, da eine kopierte M3.1-Spezifikation | Von MiniMax veröffentlicht | API, Token Plan, Agent |
M3 ist der ausführlicher dokumentierte Bezugspunkt: MiniMax veröffentlicht seine Architektur, die Bewertungsmethodik für Coding/Agenten und die API-Verfügbarkeit. M2.7 verfügt ebenfalls über öffentliche Benchmark-Ergebnisse und eine API-Integration. M3.1-Flash ist neuer und hat derzeit eine schmalere öffentliche Dokumentationsbasis, daher sollten Vergleiche den dokumentierten Positionierungen folgen, statt einen Benchmarksieger zu beanspruchen. 4
Repräsentative Anwendungsfälle
- Fehlerbehebung im Repository-Maßstab: Geben Sie dem Modell eine große Codebasis, eine Problembeschreibung, Protokolle und Tests und nutzen Sie seinen langen Kontext, um relevanten Projektkontext zu bewahren.
- Feature-Implementierung: Nutzen Sie das Modell, um von einer Anforderung in natürlicher Sprache über Codeänderungen bis hin zu Regressionstests vorzugehen.
- Code-Review und Behebung: Bitten Sie es, Randfälle zu identifizieren, Patches vorzuschlagen und zu verifizieren, dass Änderungen bestehendes Verhalten nicht beeinträchtigen.
- Multimodales Debugging: Stellen Sie Screenshots, Diagramme oder Video neben textlichen Anforderungen bereit, wenn visueller Kontext Teil des technischen Problems ist.
- Lang laufende Coding-Agent-Sitzungen: Verwenden Sie das große Kontextfenster für Spezifikationen, Repository-Dateien, Terminalausgaben und iterative Testergebnisse.
- Geschwindigkeitskritische Entwicklung: Wählen Sie für Routineänderungen eine niedrigere Reasoning-Effort-Stufe und erhöhen Sie den Aufwand für komplexere, mehrstufige Änderungen.
So greifen Sie auf die MiniMax M3.1-Flash-API zu
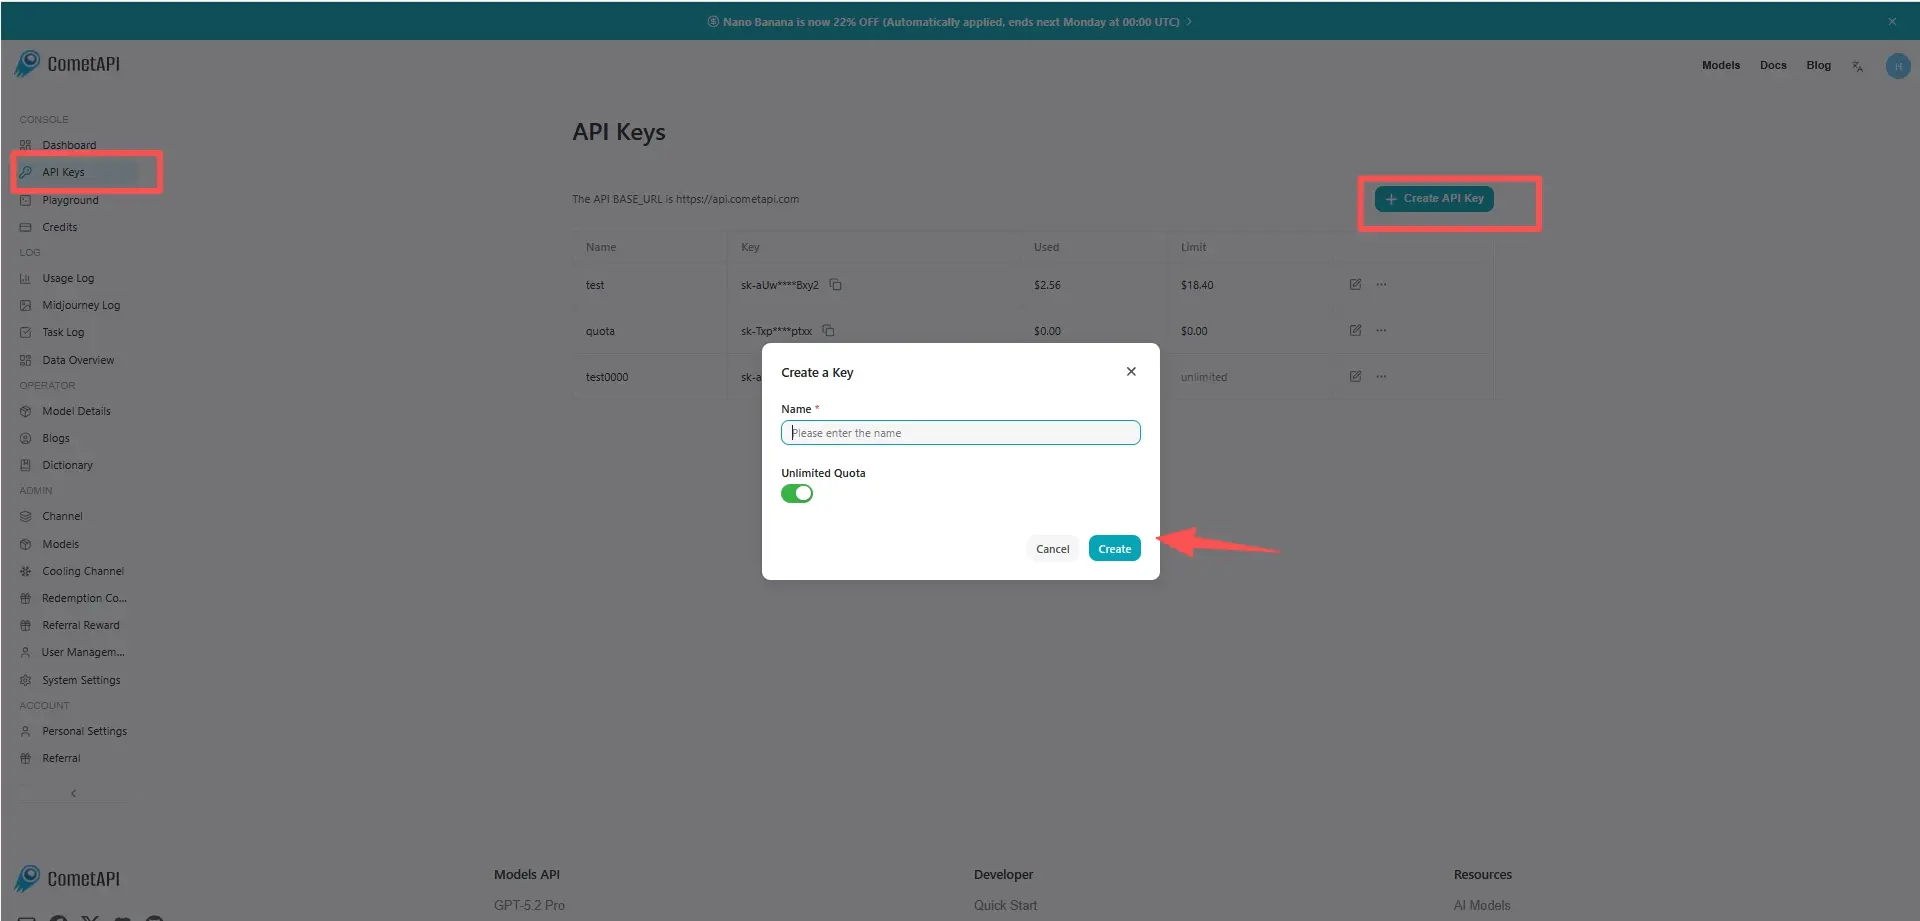
Schritt 1: Für API-Schlüssel registrieren
Melden Sie sich bei cometapi.com an. Wenn Sie noch kein Nutzer sind, registrieren Sie sich zuerst. Melden Sie sich in Ihrer CometAPI-Konsole an. Rufen Sie den API-Schlüssel der Schnittstelle als Zugriffsberechtigung ab. Klicken Sie im persönlichen Zentrum beim API-Token auf „Add Token“, erhalten Sie den Token-Schlüssel: sk-xxxxx, und senden Sie ihn ab.
Schritt 2: An MiniMax M3.1-Flash-API Anfragen senden
Wählen Sie den Endpunkt „minimax-m3.1-flash“, um die API-Anfrage zu senden, und setzen Sie den Request-Body. Die Request-Methode und der Request-Body werden unserer Website-API-Dokumentation entnommen. Unsere Website stellt außerdem Apifox-Tests zu Ihrer Bequemlichkeit bereit. Ersetzen Sie <YOUR_API_KEY> durch Ihren tatsächlichen CometAPI-Schlüssel aus Ihrem Konto. Basis-URL ist Chat Completions.
Fügen Sie Ihre Frage oder Anforderung in das content-Feld ein — darauf wird das Modell antworten. Verarbeiten Sie die API-Antwort, um die generierte Antwort zu erhalten.
Schritt 3: Ergebnisse abrufen und verifizieren
Verarbeiten Sie die API-Antwort, um die generierte Antwort zu erhalten. Nach der Verarbeitung antwortet die API mit dem Aufgabenstatus und den Ausgabedaten.