



TL;DR
Prompt-Caching ermöglicht Sprachmodellen, zuvor verarbeitete Prompt-Präfixe wiederzuverwenden, anstatt dieselbe Eingabe erneut zu berechnen. Es kann Eingabetoken-Kosten senken und die Latenz verbessern, insbesondere für Agent-Workflows, Kundensupport, RAG und die Analyse großer Dokumente. Im Jahr 2026 bietet OpenAI automatisches Caching und neuere explizite Cache-Kontrollen, Claude unterstützt automatisches Caching sowie Cache-Breakpoints auf Blockebene, und Gemini betont implizites Caching für seine neuesten Modelle. Anbieter berechnen unterschiedlich für Cache-Schreibvorgänge, -Lesevorgänge und, sofern zutreffend, -Speicherung. Ablauffristen können einen weiteren Schreibvorgang oder eine vollständige Eingabebelastung auslösen, daher hängen die tatsächlichen Einsparungen von der Wiederverwendungsfrequenz und gemessenen Cache-Treffern ab.
Dieser Leitfaden vergleicht Prompt-Caching in GPT-6.1 Sol, Claude Opus 5.5 und Gemini 4 Argon für Entwickler, die Anwendungen mit wiederholter Eingabe erstellen. Er konzentriert sich auf Cache-Kontrollen, Preise und die Verifikation der Wiederverwendung.
Key Takeaways
- Prompt-Caching wiederverwendet verarbeitete Eingaben – nicht die vorherige Antwort des Modells.
- OpenAI-Prompt-Caching hängt von einem stabilen Präfix, unterstützten Modellfunktionen sowie modellabhängigen Mindestanforderungen und Aufbewahrungseinstellungen ab.
- Claude-Prompt-Caching bietet 5-Minuten- und optionale 1-Stunden-TTLs mit automatischer und expliziter Cache-Steuerung.
- Gemini-Kontext-Caching ist bei modernen Modellen implizit; explizite Cache-Ressourcen bleiben modellabhängig.
- Einsparungen durch Prompt-Caching hängen von Cache-Schreibvorgängen, -Lesevorgängen, -Speicherung und tatsächlichen Treffern ab; prüfen Sie Endpunktunterstützung und Abrechnung für gecachte Tokens bei Verwendung der CometAPI.
What Is Prompt Caching in LLMs?
Prompt-Caching ist eine Inferenzoptimierung, die die Wiederverwendung von aus einem zuvor verarbeiteten Präfix abgeleitetem Rechenzustand ermöglicht. Ein Prompt enthält häufig stabile Anweisungen, Tool-Definitionen oder Dokumente, gefolgt von einer sich ändernden Nutzerfrage. Wenn eine spätere Anfrage dasselbe zulässige Präfix wiederholt, kann der Anbieter gecachte Key-Value-(KV)-Zustände wiederverwenden und nur den nicht gecachten Rest verarbeiten. Anders als beim Response-Caching wird dadurch keine frühere Antwort wiedergegeben: Das Modell generiert eine neue Antwort für die aktuelle Anfrage.
Prompt-Caching-Workflow:
- Erste Anfrage: Senden Sie ein großes, wiederverwendbares Präfix und eine spezifische Frage.
- Cache-Erstellung: Der Anbieter speichert zulässige Zwischenergebnisse.
- Nächste Anfrage: Wiederverwenden Sie das identische Präfix und ersetzen Sie die Frage.
- Cache-Lesevorgang: Zuvor verarbeitete Tokens werden wiederverwendet, während neue Tokens normal verarbeitet werden.
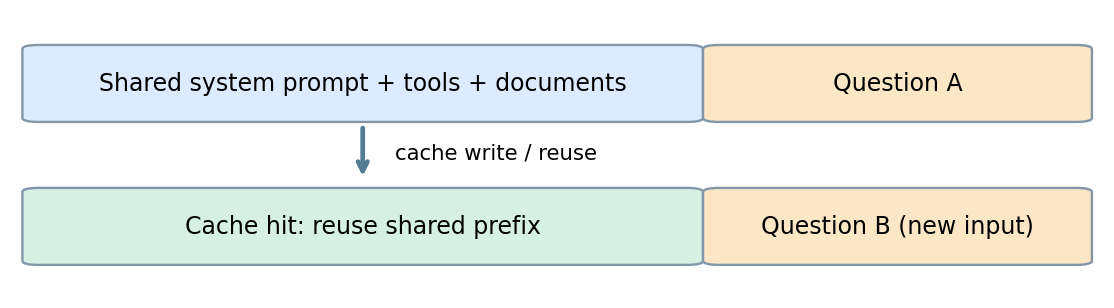
Konzeptionelle Darstellung aus dem Originalentwurf: Wiederholtes Prompt-Material geht einer sich ändernden Frage voraus. Dies ist kein offizielles Architekturdiagramm eines Anbieters.
Das gemeinsame Konstruktionsprinzip ist die Präfix-Stabilität. API-Verträge, zulässige Modellfamilien, Cache-Lebensdauer und Gebühren sind nicht austauschbar.
OpenAI, Claude, and Gemini Caching at a Glance
Dasselbe Prinzip stabiler Präfixe gilt für alle Anbieter, doch die folgenden Kontrollen sind spezifisch für die in diesem Leitfaden verwendeten Modelle. Prüfen Sie Modell und Endpunkt gemeinsam, bevor Sie eine Einstellung übernehmen.
Prompt Caching Controls and Python Examples
Jedes Beispiel sendet dasselbe Referenzmaterial mit zwei unterschiedlichen Fragen. Halten Sie die gemeinsamen Inhalte unverändert, führen Sie die Anfragen nacheinander aus und prüfen Sie die Nutzung, um festzustellen, ob die zweite Anfrage tatsächlich gecachte Eingaben wiederverwendet.
OpenAI: Cache Controls and Python Example
OpenAI ordnet cache-fähige Prompt-Präfixe automatisch zu und erlaubt bei unterstützten neueren Modellen explizite Konfigurationen für Breakpoints und Aufbewahrung. Cache-Wiederverwendung ist besonders nützlich, wenn lange Systemanweisungen, Tool-Schemata oder Repository-Kontext über Anfragen hinweg wiederkehren. Die erforderliche Präfixlänge und Token-Preis-Multiplikatoren hängen von der Modellgeneration und der gewählten Aufbewahrungsstufe ab.
Das Beispiel verwendet die Responses API mit prompt_cache_options im impliziten Modus und einer Lebensdauer von 30 Minuten. Frühere Modellgenerationen nutzen andere Aufbewahrungsparameter; folgen Sie den Einstellungen für Ihr genaues Modell.
Installieren Sie das openai-SDK und setzen Sie OPENAI_API_KEY. Verwenden Sie mindestens 1.024 sichtbare Tokens im stabilen Präfix. Führen Sie beide Anfragen nacheinander aus und prüfen Sie input_tokens_details.cached_tokens und cache_write_tokens in der Nutzung. Eine positive Anzahl gecachter Tokens bestätigt einen abgerechneten Cache-Lesevorgang; sie garantiert nicht bei jeder Anfrage eine niedrigere Latenz.
Zum Ausführen der Beispiele installieren Sie das jeweilige Python-SDK, setzen Sie den API-Schlüssel des Anbieters und erstellen Sie eine UTF-8-Datei reference.txt mit genügend stabilem Inhalt, um das Caching-Minimum des Modells zu erfüllen.
from pathlib import Path
from openai import OpenAI

client = OpenAI()  # Reads OPENAI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
questions = ["Summarize the architecture.", "Identify the main technical risks."]
for question in questions:
    response = client.responses.create(
        model="gpt-6.1-sol",
        instructions="Use the following reference material.\n" + shared,
        input=question,
        prompt_cache_key="docs-assistant-v1",
        prompt_cache_options={"mode": "implicit", "ttl": "30m"},
    )
    print(response.output_text)
    print(response.usage)
Claude: Cache Controls and Python Example
In der Claude Messages API ist Prompt-Caching ein Opt-in. Fügen Sie cache_control auf Anfrageebene für automatische Breakpoint-Platzierung hinzu oder hängen Sie es an einen Inhaltsblock, um einen expliziten Breakpoint zu markieren. Entwickler können stabile Anweisungen, Dokumente und ausgewählte Prompt-Blöcke markieren, während spätere Nutzereingaben variieren. Der Standardcache mit kurzer Dauer beträgt fünf Minuten, mit einer Ein-Stunden-Option für geeignete Workloads.
Die unterstützten Formen und Mindestanforderungen sind in der offiziellen Claude-Prompt-Caching-Anleitung dokumentiert.
Installieren Sie das anthropic-SDK und setzen Sie ANTHROPIC_API_KEY. Für Claude Opus 5.5 stellen Sie mindestens 512 Tokens vor der Cache-Grenze bereit. Halten Sie den Systemblock über Anfragen hinweg identisch. Ein Cache-Eintrag wird verfügbar, sobald die erste Antwort beginnt; dieses Beispiel wartet zur Vereinfachung auf die vollständige Antwort. Prüfen Sie Cache-Erstellung und -Lesungen; ein kurzes Präfix kann für beide Werte Null zurückgeben, ohne einen Fehler auszulösen.
from pathlib import Path
import anthropic

client = anthropic.Anthropic()  # Reads ANTHROPIC_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=1024,
        system=[{
            "type": "text",
            "text": shared,
            "cache_control": {"type": "ephemeral"},
        }],
        messages=[{"role": "user", "content": question}],
    )
    print(response.content)
    print(response.usage.cache_creation_input_tokens)
    print(response.usage.cache_read_input_tokens)
Gemini: Implicit Caching and Python Example
Google bezeichnet seine Implementierung als Kontext-Caching. Gemini 4 Argon verwendet implizites Caching und unterstützt keine expliziten Cache-Ressourcen. Einige frühere Modellfamilien unterstützen explizite Caches mit konfigurierbarer TTL. Wählen Sie die Caching-Schnittstelle anhand des jeweiligen Modellvertrags, anstatt anzunehmen, dass alle Gemini-Modelle dieselben Kontrollen bereitstellen.
Siehe die offizielle Gemini-Kontext-Caching-Anleitung
Installieren Sie google-genai und setzen Sie GEMINI_API_KEY. Verwenden Sie mindestens 4.096 Tokens gemeinsam führenden Inhalts für Gemini 4 Argon und senden Sie die zweite Anfrage kurz nach der ersten. Prüfen Sie cached_content_token_count in usage_metadata, sofern vorhanden. Implizites Caching kann auch dann ausbleiben, wenn das Präfix zulässig ist.
from pathlib import Path
from google import genai

client = genai.Client()  # Reads GEMINI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.models.generate_content(
        model="gemini-4-argon",
        contents=shared + "\nQuestion: " + question,
    )
    print(response.text)
    print(response.usage_metadata)
How Much Does Prompt Caching Cost Across OpenAI, Claude, and Gemini?
Caching-Kosten sollten als Kombination aus Schreibvorgängen, Lesevorgängen und – bei einigen expliziten Cache-Systemen – Aufbewahrung oder Speicherung bewertet werden. Die folgenden Multiplikatoren veranschaulichen gängige Designs und sind keine universellen Preiszusagen über Modellversionen hinweg.
Veranschaulichendes Beispiel: Ein Präfix mit 10.000 Tokens wird über N Anfragen wiederverwendet, sein anfänglicher Cache-Schreibvorgang kostet das 1,25-Fache der normalen Eingabe und nachfolgende Cache-Lesevorgänge kosten das 0,1-Fache der normalen Eingabe. Angenommen, der Basiseingabepreis beträgt 2 $ pro Million Tokens und die Cache-Treffer sind nach der ersten Anfrage perfekt.
| Anzahl der Anfragen | Ohne Caching | Mit Caching | Einsparungen beim wiederverwendeten Präfix |
|---|---|---|---|
| 10 | $0.200 | $0.043 |
Formel: Cached prefix cost = 1.25P + (N − 1) × 0.1P, wobei P die normalen Kosten für die einmalige Verarbeitung des gemeinsamen Präfixes ist. Dieses Beispiel schließt dynamische Eingaben, Ausgaben, Ablauflogik, Fehltreffer, Speicherung und andere Dienste aus.
Das obige Beispiel verwendet einen veranschaulichenden 10%-Lesesatz, nicht den aktuellen Satz von GPT-6.1 Sol. Sols Standardpreise für kurze Kontexte betragen 2 $ pro Million ungecachter Eingabetokens, 0,10 $ pro Million gecachter Eingabetokens und 2,50 $ pro Million Tokens für Schreibvorgänge mit der Standardlebensdauer. Berechnen Sie das Beispiel mit Ihrem tatsächlichen Modell, Ihrer Stufe und Ihrer Endpunktabrechnung neu.
Eine längere Lebensdauer lohnt sich nur, wenn sie genügend wiederholte Schreibvorgänge oder ungecachte Anfragen verhindert, um ihren Preis auszugleichen. Claudes 5-Minuten- und 1-Stunden-Schreibvorgänge werden mit dem 1,25- bzw. 2-fachen des Basiseingabepreises berechnet. Explizite Gemini-Caches auf unterstützten älteren Modellen können ebenfalls Speichergebühren verursachen. Messen Sie die Wiederverwendung über reale Leerlaufintervalle, nicht nur über eine Serie schnell aufeinanderfolgender Aufrufe.
Behandeln Sie Fehltreffer, Ablauffristen und die Ausgabegenerierung als Teil der Rechnung. Wenn ein Präfix abläuft, bevor es wiederverwendet wird, kann die nächste Anfrage einen weiteren Schreibvorgang oder eine vollständige Eingabeverarbeitung erfordern. Kurze Prompts qualifizieren sich möglicherweise überhaupt nicht, während lange Antworten die Ausgabetokens trotz starker Cache-Wiederverwendung zum größten Kostenfaktor machen können. Vergleichen Sie die Gesamtkosten pro abgeschlossener Aufgabe, bevor Sie zusätzliche Caching-Komplexität hinzufügen.
Which Prompt Caching API Is Best for Different Workloads?
Für Coding-Agenten und Kundensupport sollten stabile Tool-Definitionen, Repository-Kontext, Richtlinien und Wissen vor die sich ändernde Aufgabe gestellt werden. OpenAI und Claude bieten Breakpoint-Kontrollen, die bei der Definition wiederverwendbarer Grenzen helfen; bewerten Sie die tatsächlichen Cache-Lesevorgänge des Endpunkts, anstatt anzunehmen, dass wiederholter Text gecacht wurde.
Für Dokumentanalyse und multimodale Arbeit sollten Sie das Quelldokument oder unterstützte Medien vor die Frage stellen. Geminis impliziter Ansatz reduziert den Cache-Managementaufwand, während Claude den stabilen Block direkt markieren lässt. Prüfen Sie Unterstützung für den jeweiligen Medientyp und das Modell, bevor Sie sich auf Wiederverwendung verlassen.
Für lange Unterhaltungen sollten neue Turns angehängt werden, anstatt den Anfang wiederholt neu zu schreiben, und wählen Sie eine verfügbare Lebensdauer, die zu den Pausen zwischen Turns passt. Wenn Ihre Anwendung eine benannte Cache-Ressource benötigt, die sie explizit erstellen und referenzieren kann, evaluieren Sie ein Gemini-Modell, das diese Schnittstelle unterstützt; Argon tut dies nicht.
Es gibt keinen universellen Gewinner: Vergleichen Sie Cache-Trefferrate, Kosten pro abgeschlossener Aufgabe und Latenz unter Ihrem tatsächlichen Verkehrsmuster.
How Does Prompt Caching Affect Latency and Performance?
Ein Cache-Treffer reduziert die wiederholte Eingabeverarbeitung und kann die Zeit bis zum ersten Token verkürzen. Er verbessert nicht per se die Antwortqualität oder beschleunigt die Ausgabegenerierung, und gecachte Eingaben belegen weiterhin das Kontextfenster. Messen Sie sowohl die Latenz bis zum ersten Token als auch die Gesamtantwortzeit bei vergleichbaren Anfragen; ein Cache-Treffer allein ist kein Beleg dafür, dass der Nutzer die endgültige Antwort früher erhalten hat.
How to Optimize Prompt Caching and Troubleshoot Misses
Start with a Stable, Useful Prefix
Platzieren Sie wiederverwendbare Anweisungen, Tool-Definitionen, Richtlinien und Dokumente zuerst; setzen Sie Zeitstempel, Request-IDs, sich ändernden Kontext und die Nutzerfrage danach. Halten Sie Tool-Reihenfolge und Schemata stabil. Beenden Sie beim Einsatz von explizitem Caching den Breakpoint am letzten unveränderten Block. Fügen Sie nützliches Referenzmaterial hinzu, wenn es der Aufgabe hilft; blähen Sie nicht jede Anfrage auf, nur um eine Cache-Metrik zu verbessern.
If Cached Tokens Stay at Zero
Prüfen Sie die Zulässigkeit, bevor Sie den Prompt ändern: Bestätigen Sie das genaue Modell, den Endpunkt, die Mindesttokenlänge und erforderliche Cache-Control-Einstellungen. Senden Sie dann zwei aufeinanderfolgende Anfragen mit identischen gemeinsamen Inhalten. Prüfen Sie Cache-Erstellung und Cache-Lesen getrennt; die erste Anfrage kann den Eintrag erstellen, den eine spätere Anfrage wiederverwenden kann. Ein impliziter Cache ist berechtigt zu treffen, nicht garantiert.
Bei Claude kann eine Anfrage unterhalb des Minimums sowohl bei Cache-Erstellung als auch -Lesen Null zurückgeben, ohne einen Fehler. Sein Cache-Eintrag wird verfügbar, sobald die erste Antwort beginnt. Die Claude-Caching-Anleitung erläutert auch, wie Breakpoint-Platzierung und sich ändernde Anfrageeinstellungen die Wiederverwendung beeinflussen.
If Hits Disappear Between Requests
Vergleichen Sie die tatsächlichen Nutzlasten, nicht nur die Prompt-Vorlage. Achten Sie auf geänderte Dokumenttexte, neu angeordnete Tools, veränderte Schemata, umgeschriebene frühe Gesprächszüge oder dynamische Felder, die vor der wiederverwendbaren Grenze eingefügt werden. Prüfen Sie die verstrichene Zeit seit der vorherigen Anfrage und ob die gewählte Lebensdauer sie abdeckt. Ändern Sie jeweils nur eine Variable und protokollieren Sie die resultierende Nutzung.
If Hits Do Not Produce Savings
Trennen Sie gecachte Eingaben, Schreibvorgänge, ungecachte Eingaben, Ausgaben und etwaige Speichergebühren. Wiederholte Schreibvorgänge nach Leerlaufphasen, geringe Wiederverwendung oder lange generierte Antworten können Eingaberabatte übersteigen. Verwenden Sie die obige Kostenberechnung mit gemessener Nutzung und den tatsächlichen Abrechnungssätzen des Endpunkts. Behalten Sie eine Optimierung nur bei, wenn sie die Gesamtkosten pro Aufgabe oder die für Nutzer sichtbare Latenz verbessert.
Check Endpoint Support and Data Boundaries
Ein Kompatibilitäts-Endpunkt kann eine Anfrage akzeptieren, ohne dieselben Caching-Kontrollen oder Nutzungsfelder wie die native API bereitzustellen. Bestätigen Sie die Parameterunterstützung und vergleichen Sie die zurückgegebene Nutzung mit der Kontoabrechnung, bevor Sie Wiederverwendung als Einsparung behandeln. Halten Sie Mandantenisolation und Zugriffskontrollen aufrecht und befolgen Sie die Aufbewahrungs- und Datenverarbeitungsrichtlinien des Anbieters. Caching ersetzt diese Kontrollen nicht.
How Can You Use Prompt Caching with CometAPI?
CometAPI bietet einen einzigen Integrationspunkt zum Testen von Anfragen über Modellfamilien hinweg. Für Caching prüfen Sie, welche anbieterspezifischen Kontrollen der ausgewählte Endpunkt akzeptiert und wie gecachte Eingaben in Nutzung und Abrechnung erscheinen. Entwickler können Modellt tests zentralisieren und dennoch separate Validierung für Caching-Verhalten und Abrechnung beibehalten, da native Anbieteroptionen über Proxy- oder Kompatibilitätsendpunkte hinweg nicht garantiert identisch sind.
Für modellspezifische Einrichtung siehe die CometAPI-Seiten für GPT-6.1 Sol, Claude Opus 5.5 und Gemini 4 Argon. Bestätigen Sie, dass Ihr gewählter Endpunkt das benötigte Caching-Verhalten unterstützt.
Installieren Sie das openai-SDK und setzen Sie COMETAPI_KEY. Dieses Beispiel sendet Anfragen mit wiederholtem Präfix über CometAPIs OpenAI-kompatibles Chat Completions-Interface. Bestätigen Sie die Modellverfügbarkeit und prüfen Sie anschließend die zurückgegebene Nutzung und Kontoabrechnung auf Hinweise zu Cache-Wiederverwendung. Kopieren Sie keine Responses-API-Cache-Parameter in diesen Endpunkt, ohne die Unterstützung zu prüfen.
import os
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.chat.completions.create(
        model="gpt-6.1-sol",
        messages=[
            {"role": "system", "content": shared},
            {"role": "user", "content": question},
        ],
    )
    print(response.choices[0].message.content)
    print(response.usage)
Conclusion
Für Anwendungen mit vielen Wiederholungen kann Prompt-Caching einen spürbaren Unterschied bei den Inferenzkosten machen. OpenAI bietet Entwicklern zunehmend detaillierte Prompt- und Aufbewahrungskontrollen; Claude stellt bequeme automatische und Block-Level-Kontrollen bereit; Gemini macht implizite Wiederverwendung bei modernen Modellen unkompliziert. Die richtige Implementierung hängt von Umfang stabiler Prompts, Trefferrate, Ablauf und Gesamtkosten ab. Beginnen Sie mit einem klaren gemeinsamen Präfix, verifizieren Sie Nutzungs-Telemetrie und optimieren Sie anschließend Aufbewahrung und Anbieterauswahl anhand produktionsnaher Messungen.
FAQ
How can I compare caching providers fairly?
Spielen Sie dieselben nützlichen Quelldokumente und gleichwertige Fragen ab, verwenden Sie jedoch die eigenen Token-Zählungen und tatsächlichen Abrechnungssätze jedes Anbieters. Halten Sie die Ausgabebedürfnisse vergleichbar und berichten Sie sowohl erfolglose als auch erfolgreiche Anfragen. Eine feste Anzahl von Zeichen impliziert nicht dieselbe Anzahl von Tokens; vergleichen Sie daher die Kosten pro abgeschlossener Aufgabe neben Cache-Treffer-Messungen.
Should I cache every document in a changing knowledge base?
Gruppieren Sie Dokumente danach, wie oft sie sich ändern und wie häufig sie wiederverwendet werden. Ein häufig aktualisiertes Dokument kann ein großes gemeinsames Präfix wiederholt ungültig machen; das Platzieren stabiler Richtlinienmaterialien zuerst und veränderlicher Materialien später kann diese Exposition verringern. Versionieren Sie das Ausgangsmaterial bewusst und aktualisieren Sie es, sobald die Korrektheit es erfordert – auch wenn dies die Cache-Wiederverwendung reduziert.