
TL;DR
Claude Haiku 5.5 ist Anthropic's schnellstes Small-Model bei Standardgeschwindigkeit für Aufgaben mit hohem Volumen und strengen Latenzanforderungen. Es kombiniert ein Kontextfenster mit 1 Million Tokens, ein Standardausgabelimit von 128K, adaptives Reasoning und Basispreise ab $0.10 pro Million Eingabetokens und $0.50 pro Million Ausgabetokens. Die Tarife steigen, wenn ein Prompt 100.000 Tokens überschreitet. Für komplexes Coding und ausgedehnte agentische Arbeit bleiben Sonnet 5.5 und Opus 5.5 die stärkeren Optionen. CometAPI-Standardpreise liegen 20% unter den offiziellen Tarifen und beginnen bei $0.08 pro Million Eingabetokens und $0.40 pro Million Ausgabetokens. Die CometAPI-Modelseite ist live und meldet Produktions-API-Zugang.
Key Takeaways
- Offizielle Veröffentlichung: 7. Oktober 2026; Claude API Model-ID: claude-haiku-5-5.
- Start-API-Tarife: $0.10 Input und $0.50 Output pro Million Tokens für Prompts bis 100K Tokens. CometAPI: $0.08 Input und $0.40 Output pro Million Tokens bei 80% der offiziellen Standardpreise.
- Kontext und Output: 1M Tokens Kontext und 128K Tokens Standardausgabe.
- Fokus: Klassifikation, Dokumentenextraktion, Routing, Support und delegierte Agentenaufgaben.
- Der neuere Tokenizer kann für denselben Text etwa 30% mehr Tokens zählen; bewertet die Kosten pro akzeptierter Aufgabe statt nur den Preis pro Token.
What Is Claude Haiku 5.5?
Claude Haiku 5.5 ist das leichtgewichtige Mitglied der aktuellen Claude-Familie von Anthropic, entwickelt für große Anfragevolumina, bei denen Reaktionsfähigkeit und Betriebskosten zentral sind. Primäre Anwendungen umfassen Dokumentenverarbeitung, Konversationssupport, Informationsextraktion und kompakte Subagenten-Jobs. Anthropics Modellübersicht bestätigt Launch-Datum, Fähigkeiten und Plattformkennungen.
Claude Haiku 5.5 ist das erste Haiku-Modell mit konfigurierbaren Aufwandsebenen, wodurch Entwickler innerhalb desselben Modells Tiefgang des Reasonings, Latenz und Tokenverbrauch austarieren können.
What Are the Key Features of Claude Haiku 5.5?
Adaptive thinking and adjustable effort
Haiku 5.5 kann entscheiden, wann und wie viel es begründet, während der Aufwandsparameter Entwicklern ermöglicht, Antwortqualität, Latenz und Tokenverbrauch auszubalancieren. Der Standardaufwand ist mittel. Für einfache Klassifikation kann niedriger Aufwand vorzuziehen sein; für mehrdeutige Extraktion oder Tool-Planungsschritte kann eine höhere Einstellung gerechtfertigt sein.
Large-context processing
Ein Kontextfenster von 1M Tokens ermöglicht es, lange Dokumente und substanzielle Gesprächsverläufe in einer einzigen Anfrage unterzubringen. Entwickler sollten dennoch Retrieval, Trunkierung und Caching dort nutzen, wo es sinnvoll ist: lange Kontexte können unnötige Kosten und Genauigkeitskompromisse einführen, insbesondere jenseits der 100K-Preisschwelle.
Low-cost high-throughput processing
Die neuen Starttarife von $0.10/$0.50 machen wiederholte kurze Anfragen pro Token deutlich günstiger als bei der vorherigen Haiku-Generation. Anthropic dokumentiert jedoch einen geänderten Tokenizer: identischer Text produziert etwa 30% mehr Tokens als auf Haiku 4.5. Die tatsächlichen Einsparungen auf Aufgabenebene können daher kleiner ausfallen als die nominellen Tarifsenkungen.
Computer use and delegated agent tasks
Veröffentlichte Evaluationen zeigen bessere Leistung bei Computerinteraktion und toolgestützten Aufgaben als beim vorherigen Haiku-Modell. Das macht Haiku 5.5 nützlich für abgegrenzte Agentenschritte, doch erfolgreicher Automatismus hängt weiterhin von starken Tool-Berechtigungen, Fehlertoleranz und menschlicher Freigabe für riskante Aktionen ab.
How Does Claude Haiku 5.5 Perform on Benchmarks?
Anthropic berichtet von deutlichen Zugewinnen in den Bereichen Professional Knowledge, Computer-Nutzung, Coding und Reasoning. Die folgenden Ergebnisse nutzen die gemeldeten Evaluations-Settings; Scores verschiedener Benchmarks sollten nicht zu einem einzigen „Intelligenz-Score“ zusammengeführt werden.
| Benchmark | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 735 | 1,620 | 1,840 |
| AA-Briefcase v1.1 (Elo) | 614 | 1,578 | 1,824 |
| OSWorld 2.1, offline subset, partial credit | 15.7% | 72.4% | 83.9% |
| Humanity's Last Exam, no tools | 10.2% | 45.9% | 56.9% |
| Humanity's Last Exam, with tools | 18.7% | 57.4% | 64.5% |
| Terminal-Bench 4.0 | 0.0% | 39.2% | 70.6% |
| Chartography, no tools | 6.4% | 46.4% | 61.6% |
Die Standard-Evaluationskonfiguration der Systemkarte für Haiku 5.5 nutzt adaptives Denken bei maximalem Aufwand, Standard-Sampling und fünf Durchläufe, sofern nicht anders angegeben; das Produkt-Default ist mittel, daher sind die Schlagzeilenscores keine Garantien für die Default-Einstellungen. OSWorld nutzt 82 Offline-Aufgaben, keinen Internetzugang, 1080p und ein 500-Aktionen-Limit. Die 72.4% sind ein Partial-Credit-Score; die strikte Bestehensrate beträgt 37.1%. GDPval-AA und AA-Briefcase werden von Anthropic aus unabhängig durchgeführten Artificial Analysis Evaluations berichtet.
Terminal-Bench 4.0 nutzt Claude Code im --bare mode mit aktivierten Schutzmechanismen. Haiku 5.5 nutzt maximalen Aufwand, kein Fallback-Modell und keinen Internet-Egress, mit 10 Durchläufen pro Aufgabe; Sonnet 5.5 nutzt fünf Durchläufe und ein Fallback für einige gekennzeichnete Anfragen. Haiku 4.5 nutzt ein fixes Denkbudget von 63,999 Tokens. Diese Konfigurationsunterschiede sind relevant bei der Interpretation von 39.2% versus 70.6%.
Anthropics veröffentlichte Benchmark-Ergebnisse liefern die obigen Scores. OSWorld nutzt sein Offline-Subset; Humanity's Last Exam trennt tool-gestützte und tool-freie Läufe, und Chartography ist ohne Tools. Dies sind vom Anbieter gemeldete Ergebnisse, keine unabhängigen Messungen unter einer universellen Konfiguration. Anthropic liefert Evaluationsdetails in seiner Haiku 5.5 Systemkarte; reproduziert die relevanten Einstellungen für Aufwand, Tools, Scaffold und Budget, bevor ihr eigene Ergebnisse vergleicht. Die Launch-Zusammenfassung spezifiziert keine vollständig gemeinsame Testumgebung für jede Zeile.
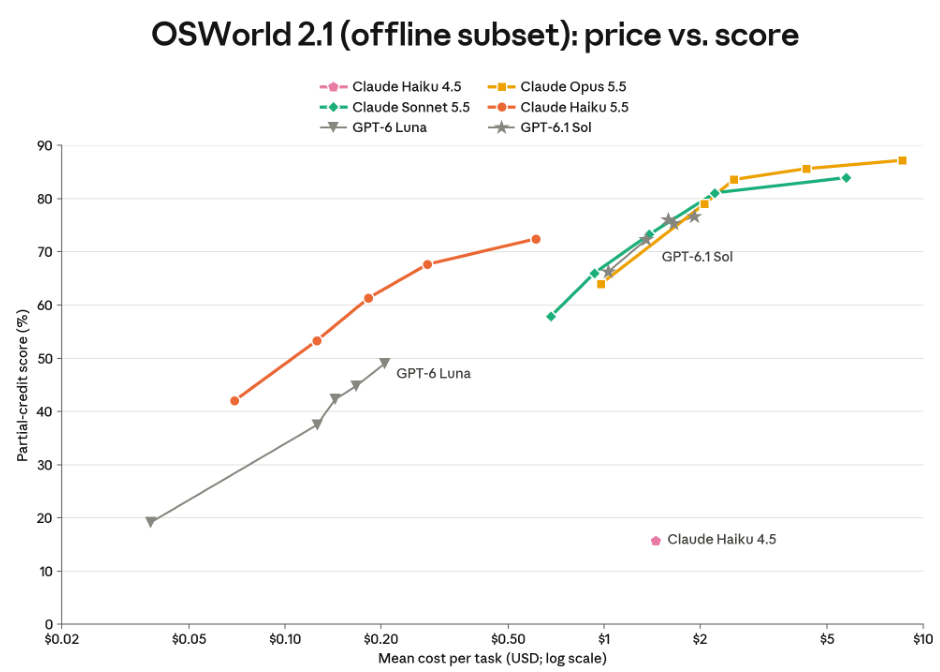
Die offizielle Evaluationsgrafik von Anthropic oben ist aus der Systemkarte reproduziert. Sie liefert zusätzliche Hinweise zu den evaluierten Konfigurationen; sie ist kein neuer Benchmark für diesen Artikel.
Benchmark Interpretation
Die OSWorld-Verbesserung legt nahe, dass Haiku 5.5 für strukturierte grafische Aufgaben deutlich nützlicher geworden ist. Dennoch deutet Sonnets 70.6% gegenüber Haikus 39.2% in Terminal-Bench auf einen anhaltenden Vorteil größerer Modelle beim agentischen Coding hin. Wählt Modelle entsprechend den Ausfallkosten und der Schwierigkeit des tatsächlichen Workflows.
Claude Haiku 5.5 vs Haiku 4.5 vs Sonnet 5.5
| Dimension | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| Kontext | 200K | 1M | 1M |
| Maximale Standardausgabe | 64K | 128K | 128K |
| Standardeingabe / MTok | $1 | $0.10 bis 100K; $0.50 über | $2 |
| Standardausgabe / MTok | $5 | $0.50 bis 100K; $2.50 über | $10 |
| Reasoning | Erweitertes Denken mit festem Token-Budget | Adaptiv; Standard mittel | Adaptiv; Standard hoch |
| Relative Latenz | Schnell | Am schnellsten bei Standardgeschwindigkeit | Schnell |
| Coding-Tiefe | Abgegrenzte Aufgaben | Stärkere Subagenten | Komplexeres Coding |
| Typische Nutzung | Legacy-Deployments kleiner Modelle | Workflows mit hohem Volumen | Komplexe Produktions-Workflows |
Gemeinsame Spezifikationen: alle drei Modelle akzeptieren Text- und Bildeingaben und erzeugen Textausgaben. Sie sind über die Claude API und unterstützte Partnerplattformen zugänglich; Model-Kennungen und Kontozugänge hängen vom Anbieter ab. Die zitierte Produktdokumentation legt weder Parameterzahlen noch detaillierte Architekturen fest.
Haiku 5.5 ist eine sinnvolle erste Wahl für verifizierbare und repetitive Aufgaben. Sonnet 5.5 wird attraktiver, wo stärkeres Urteilsvermögen wiederholte Fehlaufrufe, Tool-Retries oder menschliche Korrekturen reduziert. Opus 5.5 ist eine Option für besonders anspruchsvolle mehrstufige Aufgaben.
Die Vergleichs-Latenzlabels beziehen sich auf Standardgeschwindigkeitsmodi. Anthropics Geschwindigkeitsqualifikation schließt Opus Fast Mode vom Anspruch „schnellstes Modell“ aus. Architekturdaten wie Parameteranzahl sind durch diese Produktstufen nicht belegt. Text-und-Bild-Eingabe mit Textausgabe ist von der Bildgenerierung zu unterscheiden.
Der Fähigkeitsvergleich folgt Anthropics Modellspezifikationen. Der Plattformzugang hängt vom gewählten Anbieter und Konto ab; keine Modellstufe impliziert eine veröffentlichte Parameterzahl.
Workload Selection
| Workload | Praktische Voreinstellung | Warum |
|---|---|---|
| E-Mail-Klassifikation | Haiku 5.5 | Kurze, wiederholte, verifizierbare Entscheidungen |
| Dokumentfeld-Extraktion | Haiku 5.5 | Kosteneffiziente strukturierte Verarbeitung |
| Support-Triage | Haiku 5.5 | Schnelle Antworten und Eskalation |
| Coding-Subagenten | Haiku 5.5 | Günstige Dateisuche und abgegrenzte Edits |
| Komplexes Debugging | Sonnet 5.5 | Stärkere Coding-Benchmark-Performance |
| Hochriskantes mehrstufiges Reasoning | Opus 5.5 | Leistungsfähigeres Modell der Oberklasse |
| Gemischter Workload | Haiku + Sonnet | Routing nach Komplexität und Vertrauen |
How Much Does Claude Haiku 5.5 Cost?
Warum wird Haiku 5.5 als „rund 75% günstiger“ beworben, wenn der Tokenpreis 90% niedriger ist?
Die 90% beziehen sich auf die Reduktion der Standard-Input- und -Output-Tarife für Prompts bis 100.000 Tokens; längere Prompts erhalten eine 50%ige Reduktion. Anthropic berichtet, dass Haiku 5.5 im Durchschnitt etwa 75% weniger kostet, wobei die Anfragelängen-Mischung des früheren Modells und Änderungen im Tokenverbrauch pro Aufgabe berücksichtigt werden. Tokenization ist ein Faktor: derselbe Input-Text kann als etwa 30% mehr Tokens gezählt werden, daher sollten Kostenschätzungen mit den Zählungen des neuen Modells erfolgen.
Anthropics offizielle Preisgestaltung hat zwei Promptlängen-Bänder. Die Raten in der ersten Tabelle sind offizielle USD-Preise pro Million Tokens; der CometAPI-Vergleich unten wendet einen 20%-Rabatt auf die offiziellen Standard-Input- und -Output-Tarife an.
| Tarifkategorie | Prompt bis 100K | Prompt über 100K |
|---|---|---|
| Input | $0.10 | $0.50 |
| Output | $0.50 | $2.50 |
| 5-Minuten Cache-Schreiben | $0.125 | $0.625 |
| 1-Stunden Cache-Schreiben | $0.20 | $1.00 |
| Cache-Lesen | $0.01 | $0.05 |
| Batch-Input (50% Rabatt) | $0.05 | $0.25 |
| Batch-Output (50% Rabatt) | $0.25 | $1.25 |
Offizielle Standard-, Cache- und Batch-Tarife sind oben dargestellt, geprüft am 8. Oktober 2026. Die Promptlänge wählt das Preissegment; das höhere Segment gilt für die gesamte Anfrage, nicht nur für die Tokens über 100K. Die CometAPI-Standardtarife unten entsprechen den jeweiligen offiziellen Standardtarifen multipliziert mit 0.8. Dieser Vergleich setzt nicht voraus, dass der Gateway-Rabatt mit Batch- oder Cache-Rabatten kombiniert wird.
| Promptlänge | Tokenkategorie | Offizieller Standard / MTok | CometAPI / MTok |
|---|---|---|---|
| Bis 100K Tokens | Input | $0.10 | $0.08 |
| Bis 100K Tokens | Output | $0.50 | $0.40 |
| Über 100K Tokens | Input | $0.50 | $0.40 |
| Über 100K Tokens | Output | $2.50 | $2.00 |
Example: 100,000 short requests per month
Angenommen, jede Anfrage nutzt 2,000 Eingabetokens und 500 Ausgabetokens; jede Anfrage bleibt unter der 100K-Schwelle. Prompt-Caching, Tools und Retries werden ignoriert, und identische Tokenzahlen über Modelle hinweg werden zur Illustration angenommen.
| Modell / Anbieter | Input/Monat | Output/Monat | Total/Monat |
|---|---|---|---|
| Haiku 4.5 — offizieller Standard | $200 | $250 | $450 |
| Haiku 5.5 — offizieller Standard | $20 | $25 | $45 |
| Sonnet 5.5 — offizieller Standard | $400 | $500 | $900 |
| Haiku 5.5 — CometAPI | $16 | $20 | $36 |
In diesem Beispiel verwenden 100,000 Anfragen 200 Millionen Eingabetokens und 50 Millionen Ausgabetokens. CometAPI-Input kostet 200 × $0.08 = $16 und Output kostet 50 × $0.40 = $20, also $36 pro Monat gegenüber offiziellen $45: eine Ersparnis von $9 oder 20%. Das Szenario schließt Caching, Tools und Retries aus und nutzt feste Tokenzahlen; messt die Kosten pro akzeptierter Aufgabe an repräsentativen Inputs, da der neuere Tokenizer die Tokenzählung verändert.
Der Vergleich $450-zu-$45 ist eine Fix-Token-Illustration einer 90%igen Tarifsenkung, keine Zusage von 90% Einsparungen für äquivalente reale Workloads. In der Launch-Ankündigung berichtet Anthropic von rund 75% geringeren durchschnittlichen Betriebskosten, nachdem Anfragelängen und Änderungen im Tokenverbrauch berücksichtigt wurden. Zählt repräsentative Inputs neu und messt die Kosten abgeschlossener Aufgaben, bevor ihr eigene Einsparungen schätzt.
Where Can You Access Claude Haiku 5.5?
Official access and cloud platforms
Haiku 5.5 ist laut Anthropics Verfügbarkeitsankündigung über die Claude API und unterstützte Plattformen auf Amazon Web Services, Google Cloud und Microsoft Azure verfügbar. Die direkte Claude API Model-ID ist claude-haiku-5-5; Amazon Bedrock nutzt anthropic.claude-haiku-5-5. Nutzt die von eurem Anbieter ausgegebenen Zugangsdaten und prüft die aktuellen Zugangsanforderungen des Kontos.
Third-party access through CometAPI
Die CometAPI-Modelseite listet claude-haiku-5-5 als verfügbar, mit Standardtarifen ab $0.08 pro Million Eingabetokens und $0.40 pro Million Ausgabetokens für Prompts bis 100K, 20% unter den entsprechenden offiziellen Tarifen. Verwendet einen von CometAPI ausgegebenen Schlüssel mit dem Endpoint und dem Request-Format von CometAPI; dies ist ein separater Zugangsweg vom direkten Anthropic-API-Zugang. Prüft die Live-Seite auf Verfügbarkeit, Preisbänder und Integrationsdetails.
Beim Wechsel des Anbieters oder dem Upgrade von Haiku 4.5 verifiziert Model-IDs, zählt Tokens neu und testet Response-Limits sowie die Behandlung von Konversationen. Für Implementierungsdetails und Breaking Changes konsultiert Anthropics Migrationsleitfaden.
Migration Validation
- Aktualisiert die Model-ID und validiert anbieter-/endpoint-spezifische Request-Felder.
- Zählt Tokens mit dem aktualisierten Tokenizer neu, einschließlich stabiler Präfixe und Tool-Definitionen.
- Testet adaptive Denk-Einstellungen, Latenzverteilungen und Parsing von Response-Blöcken.
- Prüft Tool-Aufrufe, Fehlerbehandlung und etwaige Einschränkungen für gespeicherte Thinking-Blöcke auf Kontoebene.
- Vergleicht p50/p95-Latenz, akzeptierte-Aufgaben-Rate und insgesamt abgerechnete Tokens.
- Führt einen gestuften Rollout mit Rückrollpfad für geschäftskritische Workflows durch.
- Assistant prefill is banned
Der Haiku 5.5 Migrationsleitfaden erläutert Tokenizer-Verhalten, IDs und Request-Kompatibilität. Omit temperature, top_p and top_k. If explicitly supplied, temperature must be 1 and top_p must be 0.99; any top_k value, or supplying both temperature and top_p, returns a 400 error.
What Are the Limitations of Claude Haiku 5.5?
Haiku 5.5 ist kein universeller Ersatz für größere Modelle. Komplexes Coding und langfristiges Reasoning bleiben bedeutsame Differenzierungsmerkmale für Sonnet und Opus. Längere Prompts kosten ebenfalls mehr, daher sollte das 1M-Token-Fenster selektiv genutzt werden. Adaptives Reasoning führt zu Varianz bei generierten Tokens und Latenz; Benchmarks begründen keine Garantien für einen individuellen Business-Workflow.
Risikobewusste Automatisierung sollte strukturierte Outputs validieren, externe Tool-Berechtigungen begrenzen, Audit-Logs führen und vor folgenreichen Aktionen eine Prüfung verlangen. Leitet unsichere Aufgaben an stärkere Modelle weiter, statt sich allein auf Haikus niedrigeren Basis-Tokenpreis zu verlassen.
Conclusion
Für Hochvolumenverarbeitung mit messbaren Akzeptanzkriterien ist Claude Haiku 5.5 ein attraktives Upgrade: niedrigere Einstiegspreise, größeres Kontextfenster, adaptives Reasoning und stärkere veröffentlichte Evaluationen. Für komplexe Programmierung und mehrdeutige Entscheidungen können Sonnet 5.5 oder Opus 5.5 bessere Gesamtkosten liefern, indem sie Retries und Korrekturen reduzieren. Die gewinnende Strategie ist, den gesamten Workflow zu benchmarken und Anfragen nach Schwierigkeit zu routen.
FAQ
How does Haiku 5.5's 100K pricing boundary affect a cached workflow?
Die Promptlänge bestimmt, welches Tarifband gilt; schätzt die Gebühr nicht aus nur neuem Text ab und geht nicht davon aus, dass nur die überschießenden Tokens den höheren Tarif nutzen. Zählt die Anfrage für das ausgewählte Modell einschließlich Historie und Tool-Definitionen, und stimmt Input-, Cache-Write-, Cache-Read- und Output-Nutzung mit dem relevanten Band ab. Vergleicht Rechnungen auf repräsentativen gecachten Anfragen, bevor ihr ein Produktionsbudget festlegt.
Can Haiku 5.5 thinking blocks be replayed across accounts?
Sie funktionieren nur in dem Konto, das sie erzeugt hat, oder in einem damit verlinkten Konto. Wenn ein nicht verbundenes Konto einen gespeicherten Thinking-Block sendet, verwirft die API ihn, bevor das Modell ihn sieht; die Anfrage kann dennoch ohne dieses Reasoning erfolgreich sein. Siehe den offiziellen Migrationsleitfaden. Bewahrt die Konversationsblöcke auf und nutzt das ursprüngliche oder verlinkte Konto, wenn ihr einen Tool-Workflow fortsetzt. Ein Gateway- oder Konto-Wechsel sollte explizit getestet werden; eine übereinstimmende Modellbezeichnung garantiert nicht, dass gespeicherte Thinking-Blöcke weiter nutzbar sind.
Why can Haiku 5.5 truncate a response that Haiku 4.5 completed?
Der neuere Tokenizer kann für denselben Text mehr Tokens zählen, sodass ein unverändertes max_tokens-Limit weniger äquivalente Ausgabe erlauben kann. Adaptives Denken kann ebenfalls Output-Budget verbrauchen. Prüft stop_reason und usage, zählt Prompts mit dem neuen Modell neu und passt Output-Budgets anhand echter Aufgaben an, statt Legacy-Limits zu kopieren.
How should Haiku 5.5 routing thresholds be selected?
Nutzt ein gelabeltes Sample aus dem tatsächlichen Workload, um akzeptierte-Aufgaben-Rate, Korrekturkosten und Latenz zu messen. Leitet Anfragen, die explizite Validierung nicht bestehen oder den getesteten Aufgabenrahmen überschreiten, an ein stärkeres Modell weiter. Tunt den Schwellenwert gegen die Gesamtkosten des Workflows, einschließlich Retries und Eskalation, und überwacht ihn nach Änderungen an Prompts, Tools oder Aufwand.