
TL;DR: FLUX 3 ist das vereinheitlichte multimodale Foundation-Model von Black Forest Labs. Die öffentlich verfügbare Video-API generiert Clips von bis zu 20 Sekunden bei 24 fps mit optional synchronisiertem Audio aus Text, Bildern, Keyframes oder bestehendem Video. Sie unterstützt Auflösungen von HD bis UHD/4K, während FLUX 3 Image und das Open-Weight-Modell FLUX 3 Dev separate Rollout-Posten bleiben.
Was ist FLUX 3?
FLUX 3 ist ein fortschrittliches multimodales Modell von Black Forest Labs. Anstatt separat ein Modell für Bilder, ein weiteres für Video und ein weiteres für Audio zu trainieren, trainiert BFL eine gemeinsame Repräsentation über diese Modalitäten hinweg.
Die zentrale Idee ist, dass Bilder, Video und Ton unterschiedliche Beobachtungen derselben zugrunde liegenden Welt sind. Ein fahrendes Auto hat visuelle Erscheinung, Bewegung, Klang, räumliche Beziehungen, Materialeigenschaften und kausales Verhalten. Das gemeinsame Lernen dieser Signale gibt dem Modell mehr Constraints, als wenn nur einzelne Frames gelernt würden.
Deshalb beschreibt Black Forest Labs FLUX 3 als Schritt in Richtung Reality-Model bzw. World-Model statt lediglich eines Bild- oder Video-Generators. Das veröffentlichte Videosystem zeigt bereits diese Richtung: Synchronisiertes Audio, Bewegung, Szenenstruktur, Dialog, Kameraverhalten und Umgebungsgeräusche werden in einem Generations-Workflow gehandhabt.
Nicht jede angekündigte FLUX 3-Fähigkeit ist bereits öffentlich verfügbar. Stand September 2026 ist FLUX 3 Video verfügbar, während FLUX 3 Image und das Open-Weight-Modell FLUX 3 Dev separate Rollout-Posten bleiben.
FLUX 3 – Spezifikationen im Überblick
Die folgenden Spezifikationen spiegeln die aktuelle FLUX 3 Entwicklerdokumentation wider und nicht die vorläufige Konfiguration zum Juli-Launch.
| Spezifikation | Offizielle FLUX 3-Dokumentation |
|---|---|
| Entwickler | Black Forest Labs |
| Modellfamilie | FLUX 3 |
| Modelltyp | Vereinheitlichtes multimodales Foundation-/generatives Video-Modell |
| Öffentliche Videoveröffentlichung | 4. August 2026 |
| Kerntrainingsausrichtung | Gemeinsames Lernen von Bild-, Video- und Audiorepräsentationen |
| Forschungsgrundlage | Self-Flow |
| Aktueller primärer API-Output | Video mit synchronisiertem Audio |
| Text-zu-Video | Unterstützt |
| Bild-zu-Video | Unterstützt |
| Keyframe-zu-Video | Unterstützt |
| Videofortsetzung | Unterstützt |
| Maximale T2V/I2V-Dauer | 20 Sekunden |
| Dauer der Videofortsetzung | 5–15 Sekunden |
| Bildrate | 24 fps |
| Auflösung | HD, FHD, QHD/2K und UHD/4K |
| FHD 16:9-Auflösung | 1920 × 1088 |
| Bildreferenzen | Bis zu 10 für I2V/Keyframe-Workflows |
| Natives Audio | Ja |
| Mehrsprachiger Dialog | Ja |
| Lippensynchronisation | Ja |
| Multi-Shot-Generierung | Ja |
| Draft Mode | Ja |
| Öffentlicher FLUX 3 Still-Image-Endpunkt | Von BFL noch nicht allgemein freigegeben |
| FLUX 3 Dev Open Weights | Geplant |
Die aktuelle BFL-Dokumentation spezifiziert 5–20 Sekunden für Text-zu-Video und Bild-zu-Video, während Videofortsetzung ein Generationsfenster von 5–15 Sekunden akzeptiert. Unterstützte Seitenverhältnisse umfassen 21:9, 2:1, 16:9, 4:3, 1:1, 3:4 und 9:16.
Wie funktioniert FLUX 3?
Self-Flow
Die zentrale Forschungsgrundlage ist Self-Flow, BFLs selbstüberwachter Flow-Matching-Ansatz. Traditionelle generative Trainingspipelines verlassen sich oft auf separate vortrainierte Repräsentationsmodelle oder zusätzliche Supervision. Self-Flow ist darauf ausgelegt, nützliche Repräsentationen direkt aus dem generativen Ziel zu lernen.
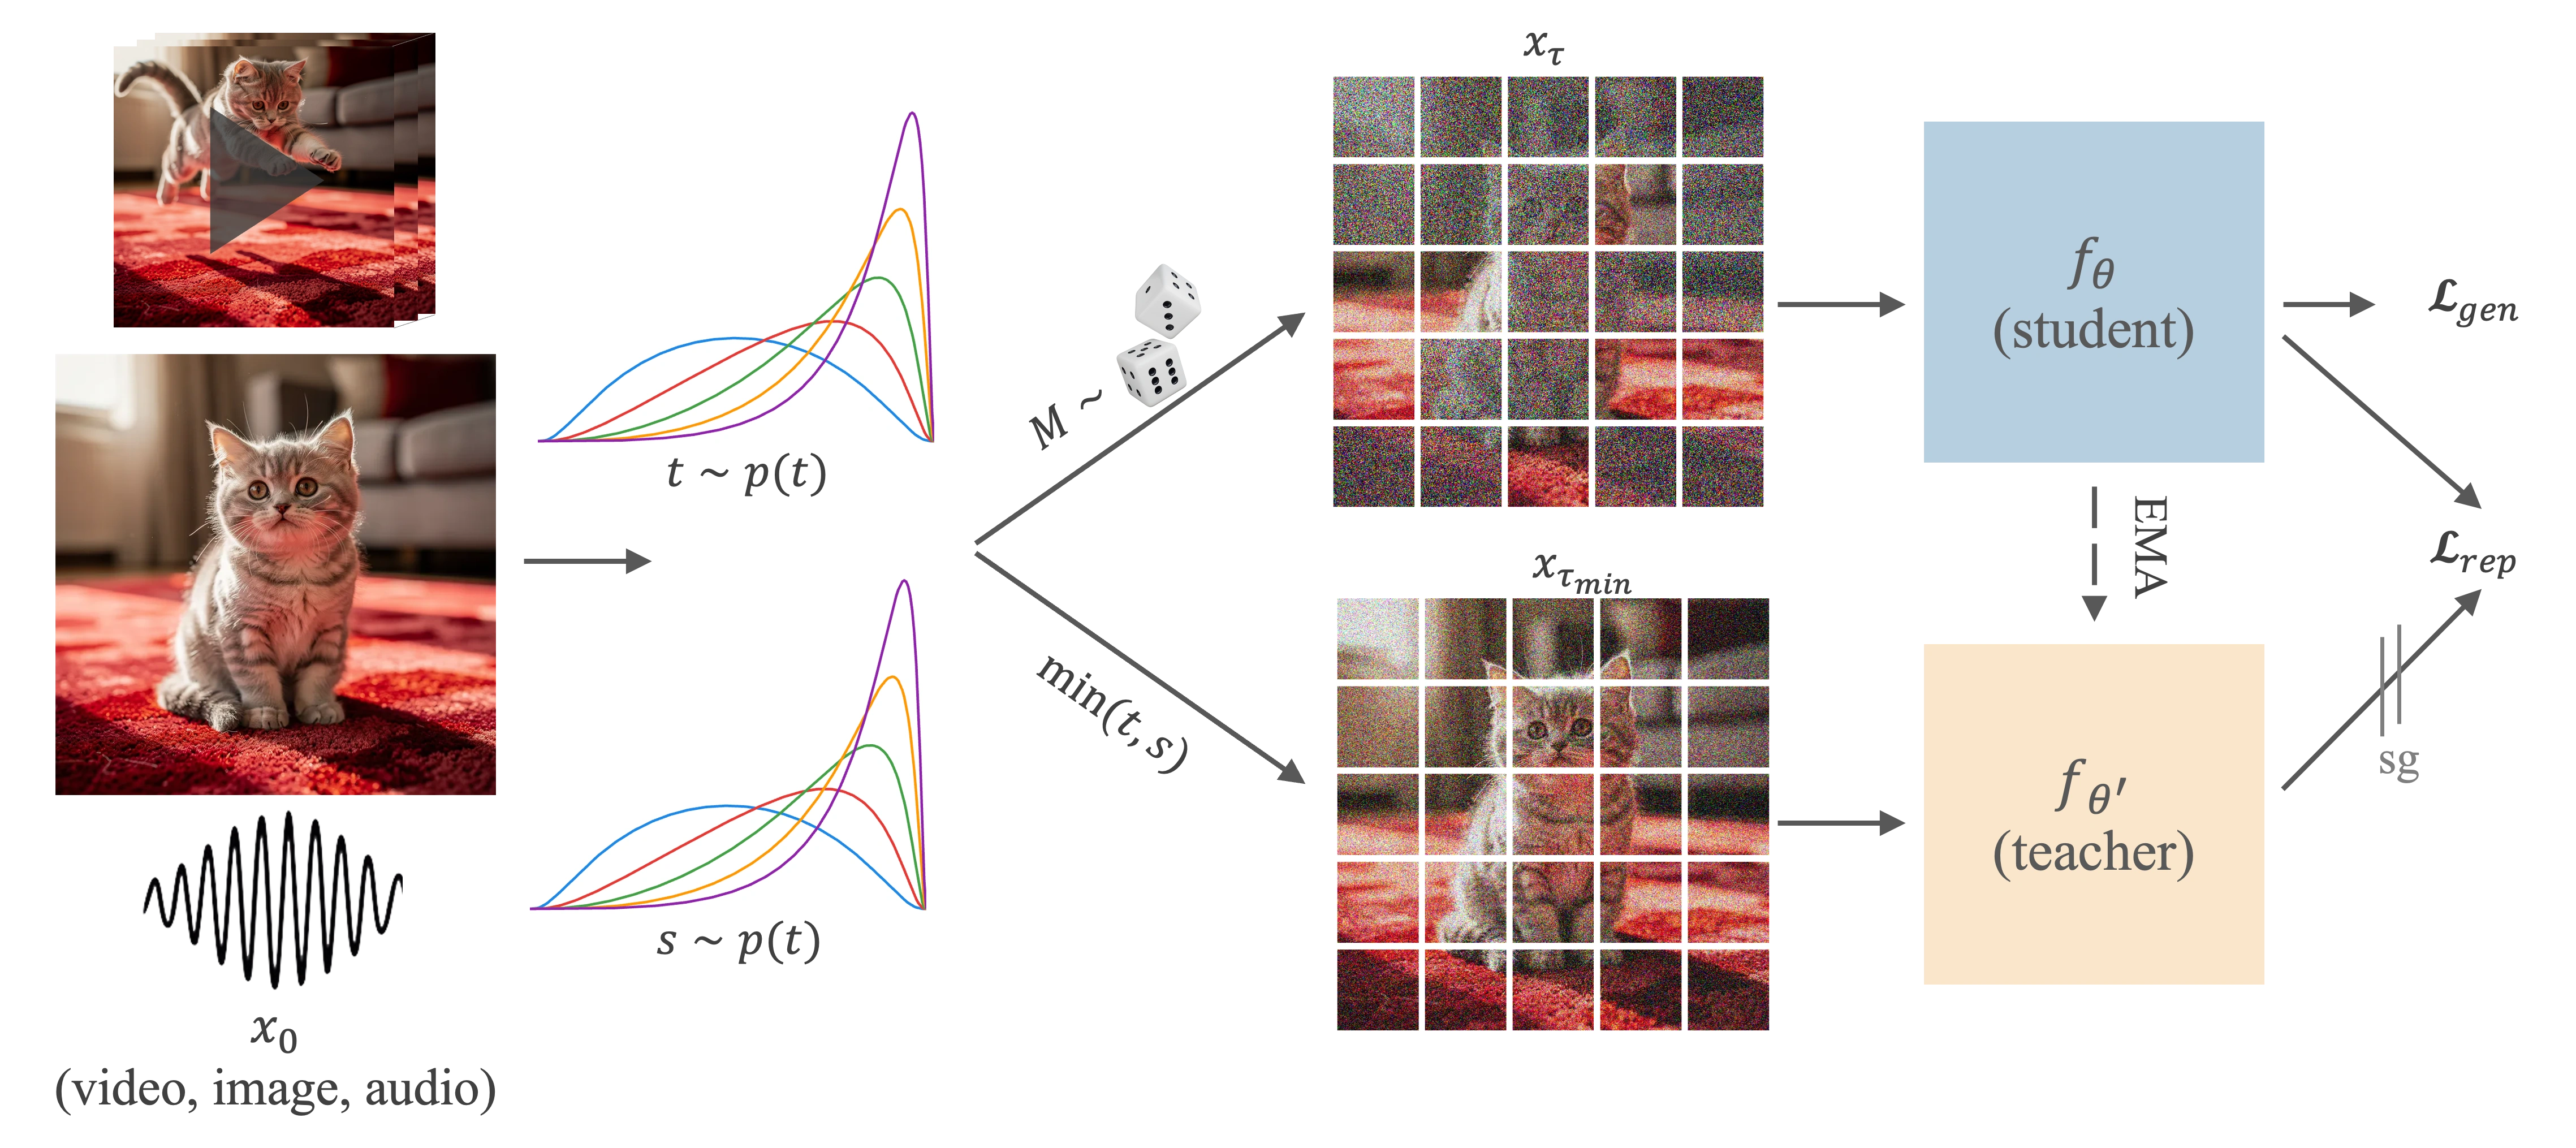
Ein wichtiger Mechanismus ist Dual-Timestep Scheduling. Verschiedene Gruppen von Tokens können während des Trainings unterschiedlichen Rauschpegeln zugewiesen werden. Dies erzeugt Informationsasymmetrie: Einige Teile des Inputs enthalten mehr nutzbare Informationen als andere, wodurch das Netzwerk gezwungen wird, Repräsentationen zu entwickeln, die helfen, fehlende Informationen zu erschließen.
Praktisch bedeutet dies, dass FLUX 3 ermutigt wird, Beziehungen zwischen Objekten, Frames, Bewegung, Ton und zeitlichen Ereignissen zu lernen, statt lediglich zu memorieren, wie einzelne Frames aussehen sollen.
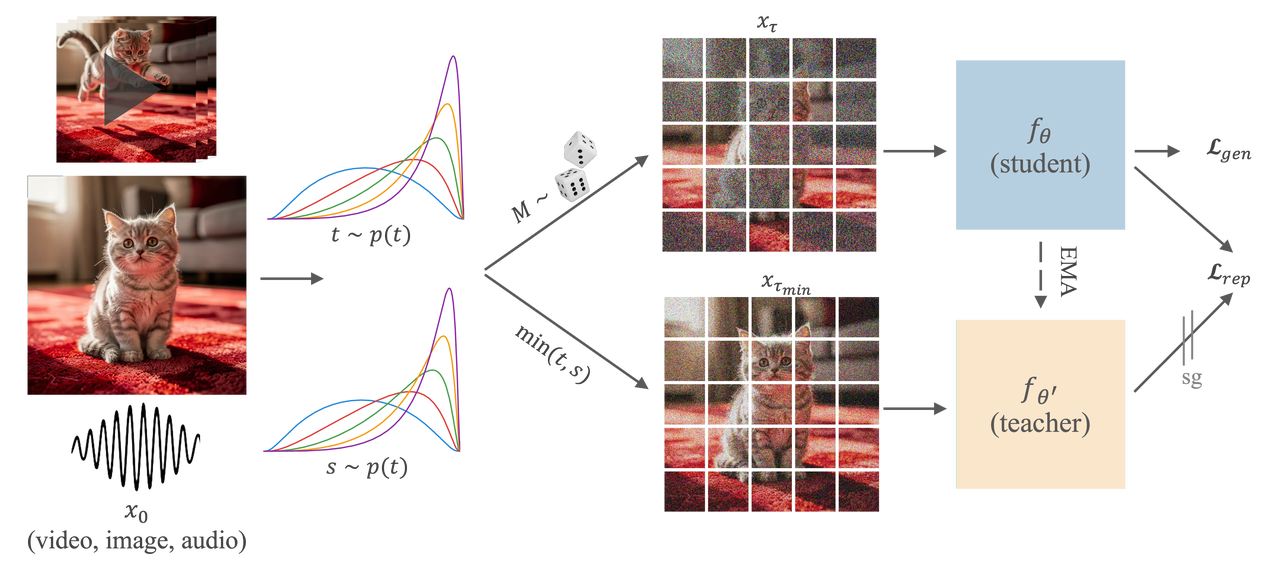
Self-Flow-Methodenarchitektur – offizielle Bildquelle: Black Forest Labs Self-Flow-Projekt
BFL testete außerdem gemeinsames multimodales Training unter Verwendung eines von FLUX.2 abgeleiteten Backbones mit Millionen von Videos und Hunderten Millionen Bildern. Die Experimente stützen die breitere FLUX 3-Hypothese, dass Repräsentationslernen und Generierung keine getrennten Systeme sein müssen.
Warum Video für FLUX 3 zentral ist
Video ist besonders wertvoll für Weltmodellierung, da es Informationen enthält, die ein Standbild nicht liefern kann. Ein einzelner Frame kann einen Ball über dem Boden zeigen; ein Video kann zeigen, dass der Ball fällt, aufprallt, sich beim Aufprall verformt, ein Geräusch erzeugt und danach die Richtung ändert.
BFL gab an, dass Videovorhersage mehr als 95 % der Trainings-Compute von FLUX 3 ausmacht. Audio ist vergleichsweise günstig, da es ein wesentlich niedrigerdimensionales Signal ist, das eng an sichtbare Ereignisse gekoppelt ist. Diese Allokation erklärt, warum Video die erste FLUX 3-Fähigkeit ist, die allgemeine Verfügbarkeit erreicht.
Was kann FLUX 3?
Text-zu-Video
Nutzer können ein vollständiges Video aus natürlichsprachigen Anweisungen generieren. BFL sagt, das veröffentlichte Modell handhabt einfache und komplexe Prompts, während es Bewegung, Szenenlogik, visuelle Komposition und Ton koordiniert. Dies ist besonders nützlich für Prompts, die mehrere aufeinanderfolgende Ereignisse enthalten, statt nur ein einzelnes animiertes Subjekt.
Bild-zu-Video und Keyframes
FLUX 3 kann ein Anfangsbild animieren, auf einen Endframe hinarbeiten oder mehrere Bilder als zeitlich gesteuerte Keyframes verwenden. Die aktuelle API unterstützt bis zu zehn Bildreferenzen in Bild-zu-Video-Workflows, sodass Creator steuern können, wie sich eine Szene im Zeitverlauf verändert, statt das Modell die gesamte Sequenz improvisieren zu lassen.
Videofortsetzung
Ein bestehendes Video und dessen Audio können als Kontext bereitgestellt werden, und FLUX 3 generiert, was als Nächstes passiert. BFL beschreibt Fortsetzungen, die Bewegung, Kameraverhalten, Dialog und Ton über den Übergang hinweg bewahren, was sich wesentlich davon unterscheidet, einfach einen zweiten unabhängigen Clip zu generieren und anschließend beide Dateien zusammenzufügen.
Natives Audio und Dialog
FLUX 3 erzeugt Audio zur Generationszeit, statt einen separaten Sprach- oder Sound-Generationslauf zu erfordern. Die veröffentlichten Audiokapazitäten umfassen Dialog, Soundeffekte und Umgebungsgeräusche. Mehrsprachiger Dialog mit Lippensynchronisation wird ebenfalls unterstützt.
Mehrere Shots in einer Generierung
Ein einzelner Prompt kann mehrere Szenen oder Kameraeinstellungen enthalten. Das ist wichtig, weil viele frühere Videomodelle am stärksten sind, wenn sie um einen kurzen, visuell kontinuierlichen Shot gebeten werden; FLUX 3 ist ausdrücklich darauf ausgelegt, Multi-Shot-Sequenzen innerhalb einer Generierung zu unterstützen.
Draft Mode
Draft Mode ist eine der praktischeren Ergänzungen für die hochvolumige Videogeneration. Statt für jeden Prompt-Test den vollen Preis zu zahlen, können Entwickler eine schnellere, kostengünstigere Vorschau erstellen und den ausgewählten Entwurf anschließend verbessern – bei Bewahrung der gewählten Komposition und Bewegung. Laut aktueller BFL-Preisliste kostet ein Standard-T2V/I2V-Entwurf 0,06 $ pro Sekunde, gegenüber 0,17 $ pro Sekunde für reguläre HD-Generierung.
Was wurde noch nicht ausgeliefert?
Die FLUX 3-Launch-Ankündigung beschrieb Bild-, Video-, Audio- und Action-Fähigkeiten unter einer architektonischen Ausrichtung, doch die Verfügbarkeit erfolgt gestaffelt.
| Fähigkeit | Aktuelle BFL-Roadmap und Verfügbarkeit |
|---|---|
| FLUX 3 Video-Generierung | Allgemein verfügbar |
| Natives Video-Audio | Allgemein verfügbar |
| Text-zu-Video | Allgemein verfügbar |
| Bild-zu-Video / Keyframes | Allgemein verfügbar |
| Videofortsetzung | Allgemein verfügbar |
| Umfangreichere Kombinationen von Bild/Video/Audio-Referenzen | Geplante Erweiterung |
| FLUX 3 Image-Generierung und -Bearbeitung | Bevorstehend |
| FLUX 3 Dev Open Weights | Geplant |
| Action-Prediction-Bereitstellung | Forschung / Track für kommerzielle Partner |
Diese Unterscheidung ist besonders wichtig für Nutzer, die mit FLUX.2 Max vertraut sind. FLUX.2 bleibt eine aktuelle dedizierte Option für die Standbildgenerierung, während das öffentliche FLUX 3-Produkt auf Video und Audio zentriert ist.
FLUX 3 Benchmark-Performance
Es gibt nun zwei nützliche Arten von FLUX 3-Benchmark-Belegen: BFLs interne Bewertung nach der Veröffentlichung und unabhängige Drittanbieterbewertung. Erstere zeigt relative menschliche Präferenz unter BFLs Protokoll; die zweite prüft, ob diese Stärken unter einem separat entworfenen Benchmark sichtbar bleiben.
BFL ELO-Bewertung nach Veröffentlichung
Die erste Juli-Ankündigung enthielt vorläufige Gewinnraten. Relevanter für aktuelle Nutzer ist BFLs Bewertung des veröffentlichten Modells vom 4. August. Black Forest Labs berichtet einen Text-zu-Video-ELO-Score von 1135 in seiner internen All-vs-All-Bewertung.
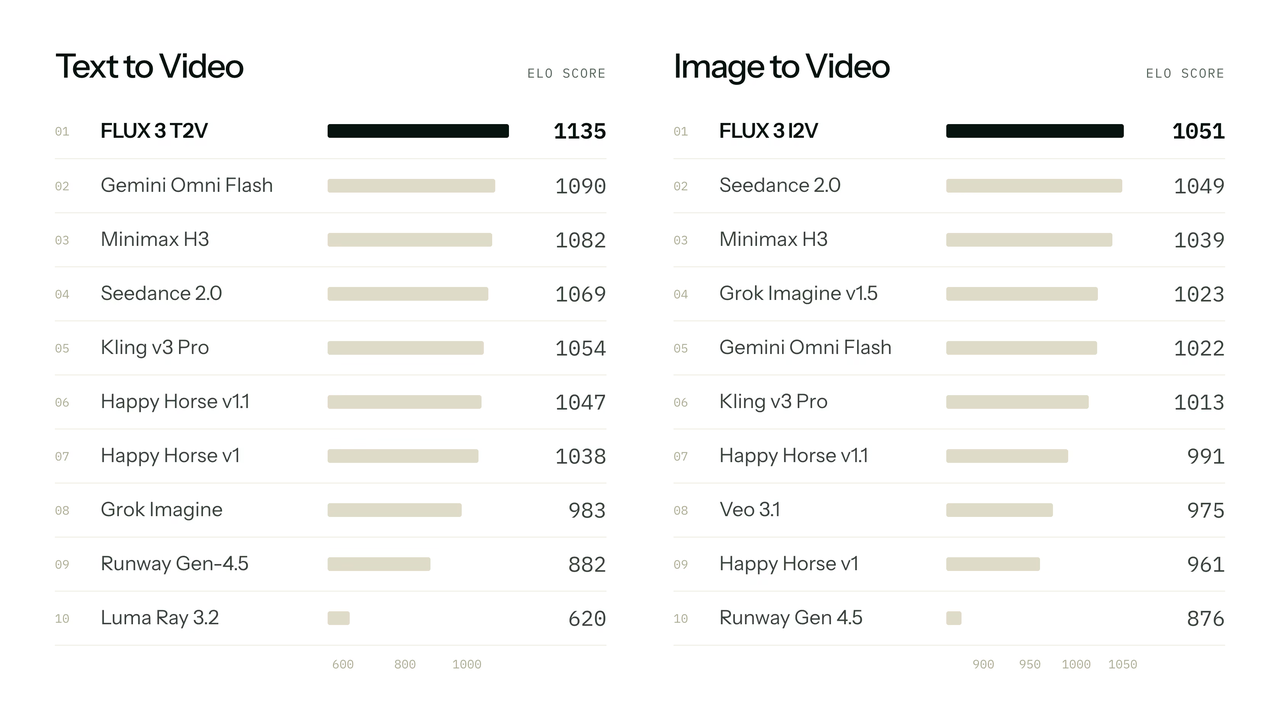
ELO-Bewertung des veröffentlichten FLUX 3-Modells – offizielle Bildquelle: Black Forest Labs
| Metrik | BFL-Bewertung des veröffentlichten Modells |
|---|---|
| Text-zu-Video ELO | 1135 |
| T2V-Position | Höchster Score in BFLs getesteter Gruppe |
| Bild-zu-Video-Ergebnis | Gleichstand mit dem stärksten getesteten Mitbewerber und besser als die übrigen evaluierten Modelle |
| Bewertungstyp | Interne Bewertung der menschlichen Präferenz |
| Modellstand | Allgemein verfügbare FLUX 3 Video-Release |
Dies ist stärkerer Beleg als der vorläufige Launch-Benchmark, da er das veröffentlichte August-Modell bewertet. Es ist jedoch weiterhin ein Anbieter-Benchmark und sollte nicht als Beweis interpretiert werden, dass FLUX 3 in jeder Prompt-Kategorie jeden Wettbewerber übertrifft.
Unabhängiger FLUX 3-Benchmark
Megatons v-benchmark v2 liefert eine unabhängige Prüfung. FLUX 3 wurde im August 2026 evaluiert und verzeichnet derzeit einen Megaton Index von 76.51/100, rangiert zum Zeitpunkt der Bewertung auf Platz 3 der veröffentlichten Liste.
| Benchmark-Dimension | Megaton FLUX 3-Bewertung |
|---|---|
| Megaton Index | 76.51 |
| Prompt Adherence | 87.07 |
| Scene Consistency | 94.76 |
| Physics | 70.63 |
| Human Fidelity | 73.70 |
| Object & Product Fidelity | 83.82 |
| Causal & Semantic Coherence | 80.91 |
| Text Fidelity | 82.41 |
| Cinematography | 71.43 |
| Taste & Art Direction | 65.00 |
Das Profil ist aussagekräftiger als der Gesamtscore. Scene Consistency mit 94.76 ist die stärkste Hauptkategorie, während Prompt Adherence, Objekt-Treue, kausale Kohärenz und Texttreue ebenfalls über 80 liegen. Physics, Human Fidelity und Taste & Art Direction sind schwächer, was zeigt, dass stärkere zeitliche Repräsentationen synthetische Bewegung oder Variation der künstlerischen Qualität nicht eliminieren.
Dies erklärt auch, warum Benchmark-Schlussfolgerungen differieren können: BFLs interner Präferenztest setzt FLUX 3 an die Spitze seines Vergleichssatzes, während Megatons unabhängiges Ranking es auf Platz drei setzt. Unterschiedliche Prompts, Bewertungsdimensionen, Evaluatorengruppen und Aggregationsmethoden können zu unterschiedlichen Platzierungen führen.
FLUX 3 vs Seedance 2.5 vs MiniMax H3 vs Wan 3.0
Der Markt für KI-Video bewegte sich 2026 schnell. FLUX 3 konkurriert nun mit multimodalen Systemen, die zunehmend Langform-Generierung, synchronisiertes Audio, Referenzen und Bearbeitung kombinieren.
| Dimension | FLUX 3 | Seedance 2.5 | MiniMax H3 | Wan 3.0 |
|---|---|---|---|---|
| Entwickler | Black Forest Labs | ByteDance Seed | MiniMax | Alibaba |
| Maximal beworbener Clip | 20 s | 30 s | 15 s | 30 s |
| Videoauflösung | HD / FHD / QHD (2K) / UHD (4K) | API-Tier-abhängig | Bis zu 2K | Bis zu 1080p |
| Natives Audio | Ja | Ja | Ja, Stereo | Ja |
| Text-zu-Video | Ja | Ja | Ja | Ja |
| Bild-/Referenzinput | Ja | Ja | Ja | Ja |
| Keyframe-/Referenzkontrolle | Starke zeitgesteuerte Keyframes | Starke multimodale Referenzkontrolle | Multimodales Conditioning | Multimodale Referenzkontrolle |
| Videofortsetzung/-bearbeitung | Fortsetzung verfügbar | Bearbeitungsorientierter Workflow | Omni-Generierungsfokus | Bearbeitungs- und Referenz-Workflows |
| Multi-Shot-Generierung | Ja | Ja | Ja | Ja |
| Unterscheidungsmerkmal | Reality-Model-Architektur, Szenenkonsistenz, Self-Flow | Langform-Storytelling und Referenzkontrolle | 2K-Audiovisualgenerierung und omni-modaler Kontext | Lange Clips und geringere Einstiegskosten |
| CometAPI Start-/Einheitspreis* | 0,136 $/s | 0,0824 $/s gelistet | 0,064 $/s | 0,040 $/s |
* Die Preisangaben sind nur grobe Vergleiche. Video-APIs verwenden unterschiedliche Auflösungen, Dauern, Qualitätsstufen und Abrechnungsregeln, daher ist der günstigste Pro-Sekunden-Wert nicht zwingend der günstigste Output vergleichbarer Qualität.
FLUX 3 vs Seedance 2.5
Seedance 2.5 hat einen offensichtlichen Dauer-Vorteil mit bis zu 30 Sekunden Generierung gegenüber 20 Sekunden bei FLUX 3. Es ist zudem stark auf referenzgetriebene Generierung, Bearbeitung und Langform-Storytelling ausgerichtet. FLUX 3 differenziert sich durch seine geteilte Weltmodell-Architektur, Szenenkonsistenz, native audiovisuelle Generierung, zeitgesteuerte Keyframes und eine breitere Image-/Action-Roadmap.
Unabhängige Tests untermauern, dass es sich um einen echten High-End-Wettbewerb handelt: Megaton platziert Seedance 2.5 derzeit vor FLUX 3.
FLUX 3 vs MiniMax H3
MiniMax H3 bietet bis zu 2K-Output und natives Stereo-Audio und liefert damit eine starke technische Spezifikation für audiovisuellen Content. FLUX 3 unterstützt ein längeres maximales Generationsfenster — 20 Sekunden gegenüber 15 Sekunden bei H3 — und sein Draft Mode ermöglicht einen kostenkontrollierten Iterations-Workflow.
FLUX 3 vs Wan 3.0
Wan 3.0 betont breite multimodale Inputs, audiovisuelle Generierung, Bearbeitung und Clips bis zu 30 Sekunden. Es ist zudem günstiger zum gelisteten Einstiegspreis von CometAPI. FLUX 3 ist teurer, differenziert sich jedoch durch seine Reality-Model-Positionierung, Szenenkonsistenz, die Self-Flow-Forschungsgrundlage, den Draft Mode und die Integration mit Action-Prediction.
FLUX 3 Preisgestaltung
Black Forest Labs berechnet FLUX 3 nach generierter Videodauer.
| Modus | Offizielle BFL-FLUX 3-Preise |
|---|---|
| T2V / I2V Draft HD | 0,06 $/s |
| T2V / I2V HD | 0,17 $/s |
| T2V / I2V FHD | 0,29 $/s |
| T2V / I2V QHD (2K) | 0,40 $/s |
| T2V / I2V UHD (4K) | 0,80 $/s |
| Videofortsetzung Draft | 0,12 $/s |
| Videofortsetzung HD | 0,41 $/s |
| Videofortsetzung FHD | 0,53 $/s |
| Videofortsetzung QHD (2K) | 0,65 $/s |
| Videofortsetzung UHD (4K) | 0,95 $/s |
Eine Standard-10-Sekunden-HD-Generierung kostet demnach etwa 1,70 $ gemäß BFLs Listenpreis, während eine 10-Sekunden-FHD-Generierung etwa 2,90 $ kostet. Videofortsetzung ist deutlich teurer als gewöhnliche Generierung, daher sollten Anwendungen, die Clips häufig verlängern, diese Kosten separat modellieren.
FLUX 3-Preis auf CometAPI
CometAPI listet FLUX 3 derzeit als verfügbar mit der Modell-ID flux-3.
| Auflösung | CometAPI-FLUX 3-Preise |
|---|---|
| 720p | 0,136 $/s |
| 1080p | 0,232 $/s |
Für eine 10-Sekunden-Generierung entspricht das etwa 1,36 $ bei 720p oder 2,32 $ bei 1080p. Verglichen mit BFLs gelisteten 0,17 $/s und 0,29 $/s liegen die Standardpreise von CometAPI für diese beiden Tiers etwa 20 % niedriger.
Hinweis zur Verfügbarkeit: Einige ältere beschreibende Inhalte auf CometAPI spiegeln noch die Early-Access-Phase im Juli wider. Die aktuelle Live Model Card, der Preisabschnitt und das API-Beispiel listen flux-3 als Available, mit einem CometAPI-Veröffentlichungsdatum vom 13. August 2026. Für Integrationsentscheidungen sind die Live-API und die Preisfelder relevanter als die älteren Verfügbarkeitsangaben.
Warum FLUX 3 über KI-Video hinaus wichtig ist
Das Ungewöhnlichste an FLUX 3 ist nicht die 20-sekündige Videogenerierung. Mehrere Wettbewerber können bereits gleich lange oder längere Clips generieren. Die größere technische Wette ist, dass eine starke Videorepräsentation zur Grundlage für andere Formen von Intelligenz werden kann.
Von Videovorhersage zu Action-Prediction
Robotikkontrollsignale sind zeitliche Vorhersagen, konditioniert auf visuelle Beobachtungen, daher nutzt BFL die FLUX 3-Videorepräsentation als Grundlage für Action-Prediction. Die Zusammenarbeit mit mimic robotics führte zu FLUX-mimic, bei dem ein Action-Decoder Repräsentationen aus dem Videomodell liest, statt einen vollständig unabhängigen Perzeption-Stack zu trainieren.
BFL berichtet, dass das FLUX-mimic-Backbone auf einer einzelnen RTX 5090 in unter 80 ms laufen kann, während das vollständige Robotersystem eine Reaktionsschleife von etwa 101 ms erreicht. Das Unternehmen hat außerdem industrielle Evaluierungen mit Audi diskutiert.
Dies macht die öffentliche FLUX 3 Video-API nicht zu einer Robotics-API. Es zeigt jedoch, warum BFL stark in multimodale Videorepräsentation investiert hat, statt Videogenerierung als isolierte Mediensaufgabe zu behandeln.
Was sind die Hauptstärken von FLUX 3?
- Zeitliche und Szenenkonsistenz. Megatons Scene Consistency-Score von 94.76 ist die stärkste große Benchmark-Kategorie des Modells.
- Native audiovisuelle Generierung. Dialog, Effekte, Atmosphäre und Visuals können gemeinsam generiert werden, statt aus separaten Modellen zusammengefügt zu werden.
- Starke Prompt-Treue. Das unabhängige Ergebnis von 87.07 in Prompt Adherence deutet darauf hin, dass die Stärken des Modells über reine visuelle Politur hinausgehen.
- Keyframe-Kontrolle. Bis zu zehn Bilder können in aktuellen Bild-zu-Video-Workflows teilnehmen, was Schöpfern explizite zeitliche Kontrolle gibt.
- Draft-to-Final-Workflow. Draft Mode adressiert ein echtes Kostenproblem in KI-Video: Viele Generationen werden während der Prompt-Iteration verworfen.
- Breites visuelles Spektrum. BFL positioniert FLUX 3 als fähig zu rohen, natürlichen, cineastischen, nostalgischen, verspielten, stilisierten und ungewöhnlichen Outputs statt eines festen Hausstils.
- Weltmodell-Forschungsrichtung. Self-Flow und Action-Prediction machen FLUX 3 über die Mediengenerierung hinaus relevant.
Was sind die Einschränkungen von FLUX 3?
- Die vollständige multimodale Roadmap ist noch nicht ausgeliefert. Öffentliche FLUX 3 Image und FLUX 3 Dev Open Weights sollten nicht aus der Familienankündigung hergeleitet werden.
- 20 Sekunden sind keine branchenführende Dauer mehr. Einige Wettbewerber aus 2026 unterstützen bereits 30-sekündige Generierungen.
- Physik ist nicht gelöst. Megaton gibt FLUX 3 einen Physics-Score von 70.63, deutlich unterhalb seiner Szenenkonsistenz.
- Menschliche Wiedergabetreue hat noch Luft nach oben. Ein unabhängiger Score von 73.70 bedeutet, dass schwierige Anatomie und realistische menschliche Bewegung weiterhin fehlschlagen können.
- Videofortsetzung ist teuer. Der Fortsetzungspreis von BFL ist pro Sekunde erheblich höher als bei normalem T2V/I2V.
- BFLs zentrale Wettbewerbsbenchmark ist intern. Produktionsentscheidungen sollten auch unabhängige Tests mit den eigenen Prompts, Shot-Typen, Sprachen und Referenzassets der Anwendung einbeziehen.
Wie man FLUX 3 mit CometAPI nutzt
CometAPIs frühere FLUX 3-Berichterstattung erklärt die Early-Access-Phase im Juli, vorläufige Benchmarks und geplanten Rollout. Dieser Abschnitt konzentriert sich auf die aktuelle Produktionsintegration, Preisgestaltung und den funktionierenden API-Flow, sodass die historische Anleitung nicht wiederholt wird. Das FLUX 3-Produktionsmodell verwendet die Modell-ID flux-3.
Eine grundlegende 720p-Anfrage verwendet den /v1/videos-Endpunkt:
Bash
curl --request POST "https://api.cometapi.com/v1/videos" \--header "Authorization: Bearer $COMETAPI_KEY" \ --form-string "model=flux-3" \ --form-string "prompt=Ein Papierboot gleitet in weichem Morgenlicht über einen stillen Teich" \ --form-string "seconds=5" \ --form-string "size=1280x720" |
|---|
Der Video-Workflow ist asynchron. Nachdem die anfängliche Anfrage eine Task-ID zurückgibt, prüft die Anwendung die Aufgabe, bis die Generierung abgeschlossen ist, und ruft dann das resultierende Video ab. Für Produktionsanwendungen sollte die Generierung normalerweise von einem Hintergrundjob oder einer Task-Queue gehandhabt werden, statt eine HTTP-Anfrage für die gesamte Renderzeit offen zu halten.
Wer sollte FLUX 3 nutzen?
FLUX 3 ist besonders überzeugend für Anwendungen, die mehr als visuell attraktive Fünf-Sekunden-Clips benötigen: Werbesysteme mit synchronisierten Visuals und Audio, automatisierte Kurzformproduktion, Produktdemonstrationen, bei denen Objektpersistenz wichtig ist, mehrsprachige Dialoggenerierung, Storyboard-zu-Video-Workflows, keyframe-gesteuerte Animation, Bildungsinhalte und Experimente mit längeren multimodalen Pipelines.
Weniger attraktiv ist es, wenn ausschließlich der niedrigstmögliche Preis pro Sekunde zählt, wenn mehr als 20 Sekunden in einem Durchlauf generiert werden müssen oder wenn Standbildgenerierung die primäre Aufgabe ist. Für Standbilder kann ein bestehendes FLUX-Bildmodell wie FLUX.2 Max derzeit besser geeignet sein.
Ist FLUX 3 besser als andere KI-Videomodelle?
Es gibt keine einzelne belastbare Antwort über jeden Anwendungsfall hinweg. BFLs interne Bewertung setzt das veröffentlichte FLUX 3 an die Spitze seines Text-zu-Video-Vergleichs, während die unabhängige Megaton-Bewertung FLUX 3 insgesamt auf Platz drei hinter neueren Wettbewerbern einordnet. Beide Ergebnisse können valide sein, da die Tests unterschiedliche Prompt-Verteilungen und Qualitätsdimensionen messen.
FLUX 3 scheint besonders stark zu sein, wenn Szenenkonsistenz, Prompt-Befolgung, Objekt-Treue, kausale Kohärenz, Textrendering, synchronisierter Ton und kontrollierbare Keyframes wichtig sind. Andere Modelle können bei maximaler Dauer, Auflösung, künstlerischen Präferenzen, Workflows zur Bearbeitung von Videos, menschlicher Wiedergabetreue oder Kosten gewinnen. Für Entwickler ist der richtige Vergleich arbeitslastspezifisch und nicht leaderboard-spezifisch.
Häufig gestellte Fragen
Ist FLUX 3 bereits verfügbar?
Ja. FLUX 3 Video wurde am 4. August 2026 durch BFL allgemein verfügbar. CometAPI listet FLUX 3 ebenfalls als Available unter der Modell-ID flux-3. Die Still-Image-Veröffentlichung von FLUX 3 und FLUX 3 Dev Open Weights bleiben separate Roadmap-Posten.
Kann FLUX 3 Audio generieren?
Ja. FLUX 3 Video generiert synchronisiertes natives Audio, einschließlich Dialog, Umgebungsgeräuschen und Effekten. Mehrsprachiger Dialog und Lippensynchronisation werden ebenfalls unterstützt.
Wie lang können FLUX 3-Videos sein?
Aktuelle Text-zu-Video- und Bild-zu-Video-Generierung unterstützt 5–20 Sekunden. Videofortsetzung unterstützt 5–15 Sekunden neu generierter Inhalte.
Welche Auflösung unterstützt FLUX 3?
BFL unterstützt HD (bis zu 1 Megapixel pro Frame), FHD (bis zu 2 MP), QHD/2K (bis zu 4 MP) und UHD/4K (bis zu 8 MP). Ein 16:9-FHD-Output beträgt 1920 × 1088. Auflösungsbänder basieren auf der Gesamtpixelzahl pro Frame und nicht auf dem Seitenverhältnis; Draft Mode ist nur HD.
Unterstützt FLUX 3 Bild-zu-Video?
Ja. Bild-zu-Video und Keyframe-Generierung sind Teil des allgemein verfügbaren FLUX 3 Video-Featuresets.
Ist FLUX 3 ein Bildgenerierungsmodell?
Architektonisch ist FLUX 3 über Bilder, Video und Audio hinweg trainiert, und BFL hat Forschung zu Bildgenerierung und -bearbeitung demonstriert. Das FLUX 3 Image-Produkt bleibt jedoch eine kommende Veröffentlichung; verwechseln Sie die Familien-Roadmap nicht mit der derzeit öffentlichen FLUX 3 Video-API.
Ist FLUX 3 Open Source?
Derzeit nicht. BFL hat FLUX 3 Dev angekündigt, eine Open-Weight-multimodale Variante, aber noch keinen öffentlichen Veröffentlichungstermin genannt.
Wie viel kostet FLUX 3?
BFL bepreist Text-/Bild-zu-Video mit 0,06 $/s für Draft HD, 0,17 $/s für HD, 0,29 $/s für FHD, 0,40 $/s für QHD und 0,80 $/s für UHD. Video-zu-Video kostet 0,12 $/s für Draft HD, dann 0,41 $/s für HD, 0,53 $/s für FHD, 0,65 $/s für QHD und 0,95 $/s für UHD. CometAPI listet derzeit 0,136 $/s für 720p und 0,232 $/s für 1080p.
Was ist Self-Flow?
Self-Flow ist BFLs selbstüberwachter Flow-Matching-Forschungsansatz. Er ist darauf ausgelegt, einem generativen Modell zu ermöglichen, nützliche interne Repräsentationen zu entwickeln, ohne von einem externen Repräsentationsmodell abzuhängen. Der Einsatz unterschiedlicher Rauschpegel über Tokens hinweg ermutigt das Netzwerk, fehlende Informationen zu erschließen und Beziehungen zwischen multimodalen Beobachtungen zu lernen.
Ist FLUX 3 ein Weltmodell?
Black Forest Labs positioniert FLUX 3 als Realitätsmodell-Grundlage, weil seine geteilten Repräsentationen sich von audiovisueller Vorhersage in Richtung physikalische Action-Prediction erstrecken. Es als vollständiges, allgemeines Weltmodell zu bezeichnen, wäre stärker, als die aktuellen Belege stützen; eine präzisere Beschreibung ist ein multimodales generatives Foundation-Model, das ausdrücklich um Weltmodellierungsziele herum entworfen wurde.
Fazit
FLUX 3 stellt für Black Forest Labs eine größere Veränderung dar als ein konventionelles Upgrade von einem FLUX-Bildmodell auf ein anderes. Die Schlüsselidee ist, eine gemeinsame multimodale Repräsentation der Welt zu trainieren und diese Repräsentation dann für Video, Ton, Bilder und schließlich Aktionen zu nutzen. Self-Flow liefert die Forschungsgrundlage, während das veröffentlichte FLUX 3 Video-Modell die erste produktive Demonstration dieser Strategie ist.
Stand September 2026 unterstützt FLUX 3 Video Clips bis zu 20 Sekunden, 24 fps, Output von HD bis UHD/4K, synchronisiertes Audio, mehrsprachigen Dialog, Bild-zu-Video, Keyframes, Videofortsetzung, Multi-Shot-Generierung und Draft Mode.
Das Benchmark-Bild ist ebenfalls glaubwürdiger als beim Launch. BFLs aktuelle Bewertung des veröffentlichten Modells setzt FLUX 3 in seinem internen T2V-ELO-Test an die Spitze, während unabhängige Megaton-Tests es insgesamt auf Platz drei setzen und eine besonders starke Szenenkonsistenz hervorheben.
FLUX 3 ist daher nicht automatisch das beste Videomodell für jede Arbeitslast. Seedance 2.5, MiniMax H3 und Wan 3.0 können längere Generierung, höhere nominale Auflösung, niedrigere Preise oder andere Referenz- und Bearbeitungsfähigkeiten bieten.
Ungewöhnlich interessant an FLUX 3 ist die Richtung unterhalb des Video-Generators: BFL setzt darauf, dass dieselben Repräsentationen, die erforderlich sind, um überzeugendes Video vorherzusagen, schließlich Bildgenerierung, Audio, physikalisches Schlussfolgern und Roboteraktionen unterstützen können. Entwickler können den ersten Produktionsschritt bereits über FLUX 3 auf CometAPI mit der Modell-ID flux-3 testen.