Mit CometAPI entwickelnEine API für mehrere Modelle erforderlich?Teste den Workflow im Playground und erstelle anschließend einen API-Schlüssel, sobald Modell und Kosten zu deinem Anwendungsfall passen.
Gemini 4 Carbon ist das Frontier-Modell von Google DeepMind für anspruchsvolle Ingenieurarbeit und defensive Cybersicherheit. Angekündigt am 28. Oktober 2026, verbessert es gegenüber Argon veröffentlichte Coding-, Security- und Long-Context-Evaluierungen. Einführungspreise liegen bei 2 $ pro Million Eingabe-Token und 10 $ pro Million Ausgabe-Token, der Zugriff ist zunächst jedoch auf ausgewählte Cyberverteidiger und vertrauenswürdige Partner beschränkt. Für Entwickler ist die Chance stärkere autonome Arbeit; die unmittelbare Einschränkung ist der Zugang.
Key Takeaways
Gemini 4 Carbon ist Googles nächstes Frontier-Modell nach Argon, optimiert für mehrtägige agentische Ingenieurarbeit und Cybersicherheitsverteidigung.
Gemini 4 Carbon belegt Platz #1 im Artificial Analysis Intelligence Index v5.0 (Score 59), vor Claude Opus 5.5 (58) und GPT-6 Astra (57). Deutliche Zuwächse bei Coding, Full-Stack-Webentwicklung (+89 Elo auf der WebDev Arena auf Platz #4), wissenschaftlichem Schlussfolgern, multimodalem Verständnis und Alignment (0.0% Erfolg im Gray Swan Indirect Prompt Injection Benchmark).
Weiterlernen
Diesen Artikel mit der nächsten Entscheidung verknüpfen.
Auf Klarheit, Quellenangabe und aktuelle API-Terminologie geprüft.
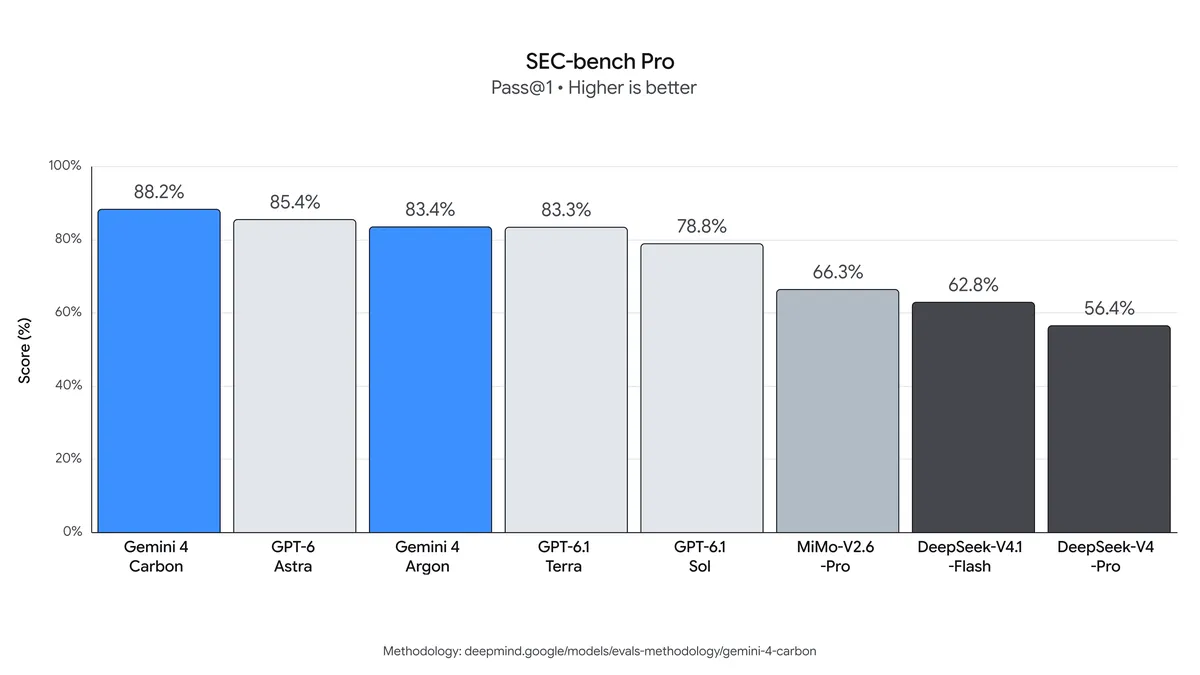
Hervorragende Cybersicherheitswerte (ohne Guardrails): 88.2% auf SEC-bench Pro (Schwachstellen finden), 54.8% auf ExploitGym (Exploitation) und 71.0% auf CWE-bench (Patchen).
Eingeschränkter anfänglicher Zugang über das Fairwind Program für Cyberverteidiger; öffentliche API und breiterer Rollout folgen später.
Gleiche Einführungspreise wie bei Argon; nach der Einführungsphase gelten Standardtarife.
Plattformen wie CometAPI unterstützen die breitere Gemini-Familie (einschließlich Argon) bereits über eine einheitliche OpenAI-kompatible API, wodurch der Modellwechsel und die Vorbereitung auf Carbons breitere Veröffentlichung erleichtert werden. Details zur öffentlichen API und ein Datum für die breite Veröffentlichung sind mit Stand 29. Oktober 2026 noch nicht angekündigt.
What Is Gemini 4 Carbon?
Gemini 4 Carbon ist Googles neuestes Flaggschiff-Frontier-AI-Modell, entwickelt für komplexe Softwareentwicklung, Cybersicherheitsforschung und autonome Workflows.
Laut der offiziellen Ankündigung baut Carbon auf der Grundlage von Gemini 4 Argon auf, mit substanziellen Verbesserungen bei Coding, agentischem Schlussfolgern und sicherheitsfokussierten Aufgaben.
Carbon ist für Arbeit konzipiert, die Untersuchung, Ausführung und Verifikation über mehrere Schritte erfordert. Ein defensiver Engineering-Agent könnte ein Repository inspizieren, eine vermutete Schwachstelle in einer isolierten Umgebung validieren, einen Patch entwickeln und testen, ob die Änderung den ursprünglichen Fehler behebt.
Google berichtet, dass interne Teams beobachtet haben, wie Carbon über mehrere Tage hinweg komplexe Engineering-Aufgaben bearbeitet. Dies sind interne Beobachtungen, keine veröffentlichte Garantie für eine bestimmte autonome Laufzeit. Google hat keinen vollständigen technischen Bericht, keine Parameteranzahl oder detaillierte Architekturdetails veröffentlicht. Kontextfenster und Ausgabelimits werden ähnlich wie oder besser als bei Argon erwartet (berichtet im Bereich von mehreren Millionen Token mit hoher Ausgabekapazität) und es unterstützt multimodale Eingaben einschließlich Text, Bilder, Video, Audio und PDFs.
What Are the Key Features of Gemini 4 Carbon?
Long-Horizon Software Engineering
Carbon ist für Engineering-Probleme ausgelegt, die nicht zuverlässig in einem einzigen Denkschritt abgeschlossen werden können.
Dazu gehören Root-Cause-Analysen in großen Repositories, abhängigkeitsbedingte Fehler, Debugging auf niedriger Systemebene und komplexes Refactoring.
Die Verbesserungen zielen auf die Fähigkeit ab, nach einem erfolglosen Versuch weiterzuarbeiten.
Ein effektiver Coding-Agent muss erkennen, wenn seine erste Lösung scheitert, neue Evidenz prüfen und seinen Ansatz überarbeiten, ohne vom ursprünglichen Auftrag abzudriften.
Defensive Cybersecurity Workflows
Carbons Sicherheitsresultate umfassen das Finden von Schwachstellen, die Validierung der Ausnutzbarkeit und das Patchen von Defekten. Die nützliche Frage für ein Sicherheitsteam ist, ob ein Agent von einem vermuteten Problem zu einem reproduzierbaren Befund und einem getesteten Fix gelangen kann, während er die ihm zugewiesenen Berechtigungen und die Umgebung respektiert.
Long-Context and Multimodal Understanding
Carbon erzielt einen GraphWalks BFS F1 von 96.2% in der 256K–1M-Token-Teilmenge, gegenüber 84.2% bei Argon. Dies ist Evidenz für Langkontext-Graphenverständnis, jedoch keine Garantie für korrekte Retrievals aus beliebigen Millionen-Token-Dokumenten.
Die veröffentlichten Chartography- und Blueprint-Bench 2-Ergebnisse decken ebenfalls visuelles Verständnis ab. Diese Tests können vielversprechende Dokument- und Chart-Workflows identifizieren, legen jedoch nicht das vollständige Modalitätsschema einer zukünftigen öffentlichen API fest.
How Does Gemini 4 Carbon Perform on Benchmarks?
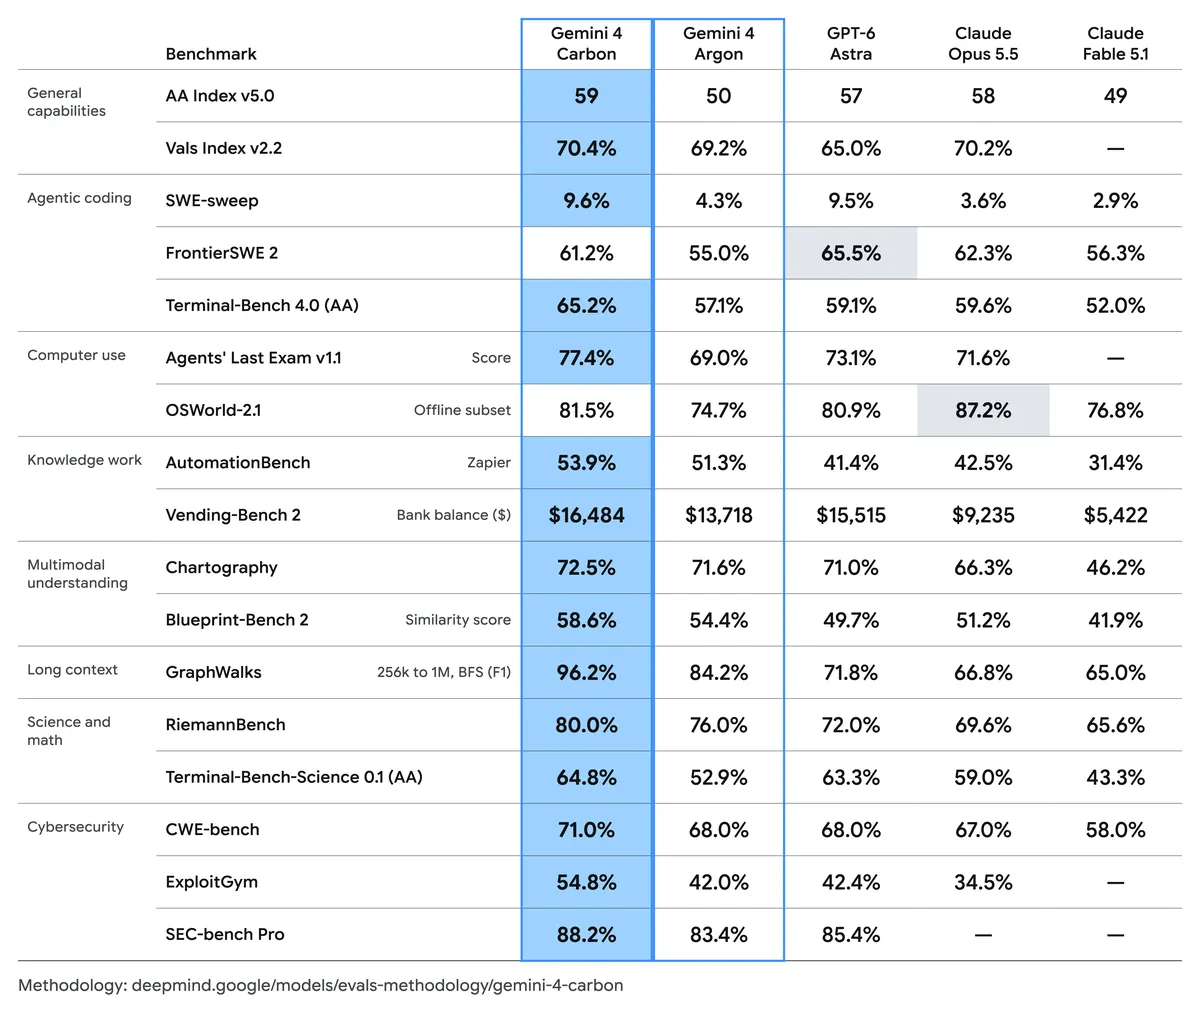
Die veröffentlichten Ergebnisse heben drei Gründe hervor, Carbon zu evaluieren: stärkere Coding-Leistung, besseres Langkontext-Schlussfolgern und Verbesserungen über den Cybersicherheits-Workflow hinweg. Die offizielle Ankündigung enthält das ursprüngliche Vergleichsdiagramm unten; die wichtigsten Ergebnisse sind im folgenden Abschnitt zusammengefasst.
Wählen Sie Benchmarks, die Ihrer eigenen Arbeitslast ähneln. Ein Modell, das einen allgemeinen Intelligenzindex anführt, kann bei einer bestimmten Engineering-Aufgabe dennoch hinter einem anderen Modell zurückliegen.
Benchmark Results and Test Conditions
Overall reasoning: Carbon erzielt 59 im AA Intelligence Index v5.0, verglichen mit 50 für Argon, 57 für GPT-6 Astra und 58 für Claude Opus 5.5.
Coding: Terminal-Bench 4.0 steigt von 57.1% auf 65.2%, ein Plus von 8.1 Prozentpunkten gegenüber Argon. SWE-sweep erhöht sich von 4.3% auf 9.6%.
Long-context reasoning: Carbon erreicht 96.2% auf dem GraphWalks 256K–1M-Token BFS F1-Subset, gegenüber 84.2% bei Argon.
Where alternatives lead: GPT-6 Astra erzielt 65.5% auf FrontierSWE 2 gegenüber 61.2% bei Carbon; Claude Opus 5.5 erreicht 87.2% auf dem OSWorld-Offline-Subset gegenüber 81.5% bei Carbon. Diese Vergleiche beziehen sich auf die Modelle und Evaluations-Settings im veröffentlichten Chart.
Über die 17 ausgewählten Ergebnisse im ursprünglichen Vergleich führt Carbon in 15. Diese Breite macht es zu einem vielversprechenden Kandidaten für komplexe Workflows, doch die zwei Ausnahmen zeigen, warum Ihre eigene Aufgabenmischung zählt. Vergleichen Sie Modelle anhand akzeptierter Ergebnisse, Abschlusszeit und Kosten, statt nicht zusammenhängende Benchmark-Scores zu mitteln.
Die Evaluationsmethodik verwendet im Allgemeinen die höchste Denk-Einstellung und pass@1, sofern nicht anders angegeben. Sie kombiniert von Google durchgeführte Ergebnisse mit externen Evaluatoren und von Anbietern gemeldeten Scores, sodass Agenten-Scaffolding und Denkbudgets nicht in jedem Eintrag identisch sind.
GraphWalks: Das zitierte Subset nutzt 200 Aufgaben und berichtet BFS F1.
Agents’ Last Exam: Die Evaluation verwendet ein 122-Task-v1.1-Set, das ALE-Claw-Harness, ein Fünf-Stunden-Fenster und aktivierte Sicherheitsfilter.
OSWorld: Das berichtete Ergebnis deckt ein 82-Task-Offline-Subset ab und nimmt das Maximum über drei Einzelversuche.
Coding Performance in Practice
Carbon verbessert Terminal-Bench 4.0 von 57.1% auf 65.2%, ein Plus von 8.1 Prozentpunkten. SWE-sweep steigt von 4.3% auf 9.6% und mehr als verdoppelt den Score, bleibt jedoch absolut unter 10%. Diese Ergebnisse stützen die Evaluation schwieriger Repository-Arbeit und zeigen zugleich, warum unabhängige Tests und Reviews weiterhin notwendig sind.
How Strong Is Gemini 4 Carbon at Cybersecurity?
Benchmark und Sicherheitsaufgabe
Gemini 4 Carbon
Gemini 4 Argon
Differenz
SEC-bench Pro — Schwachstellenfund
88.2%
83.4%
+4.8 Prozentpunkte
ExploitGym — Exploit-Validierung
54.8%
42.0%
+12.8 Prozentpunkte
CWE-bench — Schwachstellenbehebung
71.0%
68.0%
+3.0 Prozentpunkte
Der größte Zuwachs liegt bei der Exploit-Validierung. Für ein autorisiertes Verteidigerteam kann reproduzierbare Evidenz, dass eine Schwachstelle ausnutzbar ist, die Priorisierung verbessern; ein plausibler Befund allein reicht nicht aus. Patches benötigen weiterhin Tests, die bestätigen, dass der ursprüngliche Fehler behoben ist und bestehende Funktionalität erhalten bleibt.
Google berichtet die externen Sicherheitsbewertungen ohne Deploymentschutzmaßnahmen. SEC-bench Pro nutzt einen spezifischen 183-Task-JavaScript-Engine-Split; ExploitGym verwendet ein Single-Attempt-Offline-Setup mit deaktivierten Mitigations. Diese Bedingungen legen kein unbeschränktes Produktionsverhalten oder eine Erkennungsrate für beliebige reale Software fest.
Is Gemini 4 Carbon Safer and More Reliable Than Argon?
Nicht gestützte Behauptungen nahmen in internen Tests gegenüber Argon um etwa 50% ab.
Agent-Overreach verringerte sich um 26%.
Unterbedienung verringerte sich um 29%.
Hochgradige Fehlanpassungsalarme gingen in internen Coding-Umgebungen um fast 80% zurück.
Erfolgreiches Cheating auf Terminal-Bench 4.0 fiel in Googles Evaluation auf 0.0%.
Im evaluierten Gray Swan indirect prompt-injection benchmark liegt Carbons Angriffserfolgsrate bei 0.0% gegenüber 0.7% bei Argon. Das bedeutet, dass die evaluierten Angriffe unter diesem Setup nicht erfolgreich waren; es belegt keine Immunität gegen neue Angriffe oder andere Tool-Umgebungen.
Diese Zahlen stammen aus verschiedenen Evaluierungen und sollten nicht zu einem einzigen Zuverlässigkeits-Score zusammengeführt werden.
Für einen Produktionsagenten sollten Sie weiterhin unabhängige Berechtigungsprüfungen, Ausführungslogs und die Validierung beanspruchter Ergebnisse beibehalten. Das verbesserte Verhalten eines Modells hilft, aber die Anwendung muss weiterhin steuern, auf welche Dateien, Dienste und Aktionen es zugreifen kann.
How Much Does the Gemini 4 Carbon API Cost?
Google hat Carbons Einführungs- und anschließende Token-Tarife angekündigt. Die unten aufgeführten Cached-Input-Werte sind aus dem angekündigten 95%-Rabatt berechnet; die Implementierung der öffentlichen API und die Anspruchsdetails stehen noch aus.
Abrechnungskategorie, USD pro 1 Mio. Token
Einführungspreis
Folgetarif
Eingabe-Token
$2.00
$4.00
Ausgabe-Token
$10.00
$20.00
Qualifizierte zwischengespeicherte Eingabe-Token
$0.10
$0.20
Carbons Einführungsphase hat kein angekündigtes Enddatum. Argons veröffentlichte Einführungspreise enden am 30. November 2026; diese Frist sollte nicht auf Carbon angewendet werden. Batch-Preise, zusätzliche Tool-Gebühren und eine kostenlose Stufe wurden für Carbon nicht angekündigt.
Example Request Cost
Angenommen, eine Anfrage verwendet 200.000 nicht zwischengespeicherte Eingabe-Token und 10.000 insgesamt abrechenbare Ausgabe-Token. Zu den angekündigten Einführungspreisen kosten die Eingaben $0.40 und die Ausgaben $0.10, insgesamt also $0.50. Die gleichen Token-Werte würden zu den Folgetarifen $1.00 kosten.
Wenn alle 200.000 Eingabe-Token für den angekündigten Cached-Input-Rabatt qualifizieren, beträgt die Einführungsschätzung einschließlich Ausgaben $0.12. Dies ist eine bedingte Illustration, keine Zusage, dass jede wiederholte Eingabe qualifiziert.
Die Ausgabedeckung muss alle Thinking-Token einschließen, die nach den final geltenden Regeln als Ausgabe abgerechnet werden. Wenn sich 10.000 nur auf die sichtbare Antwort beziehen, würden zusätzliche abrechenbare Thinking-Token die Schätzung erhöhen. Tools, Wiederholungen und andere Dienste sind ausgeschlossen.
How Can Developers Prepare for the Gemini 4 Carbon API?
Current Gemini 4 Carbon API Availability
Stand: 29. Oktober 2026 beginnt der Zugang mit ausgewählten Cybersicherheitsverteidigern und erweitert sich schrittweise auf vertrauenswürdige Partner. Googles Fairwind Program beschreibt einen kontrollierten Zugangsweg. Ein breites Entwickler-Release-Datum und eine öffentliche Carbon-Modellkennung wurden nicht angekündigt.
Die angekündigten Preise bedeuten daher nicht, dass eine Anwendung heute eine allgemein verfügbare Carbon-API aufrufen kann. Das finale öffentliche Kontextlimit, maximale Ausgabe, Modalitätsschema, Tool-Kompatibilität und Betriebsgrenzen benötigen noch dokumentierte Produktionsspezifikationen.
Stand: 29. Oktober 2026 hat Google noch keine allgemein verfügbare Carbon-API gestartet, daher ist Carbon über CometAPI noch nicht verfügbar. Während Sie warten, können Sie Gemini 4 Argon für eine erste Evaluation nutzen. Prüfen Sie die CometAPI Carbon page auf Verfügbarkeit und Anbieterpreise, sobald der Zugang geöffnet wird.
Alternatives While You Wait for the Carbon API
Sie können mit der Evaluation Ihres Coding-Workflows beginnen, bevor Carbon breit verfügbar ist. Bauen Sie eine Baseline mit einem Modell auf, das Sie heute nutzen können, und vergleichen Sie Carbon bei den gleichen Aufgaben, wenn seine API geöffnet wird. Drei Optionen zur Erwägung sind Gemini 4 Argon, GPT-6.1 Astra und Claude Opus 5.5; bestätigen Sie den genauen Modellnamen, Zugriff und Preis bei Ihrem Anbieter, bevor Sie sich entscheiden.
Gemini 4 Argon: Starten Sie hier, wenn Sie bereits Gemini nutzen oder eine direkte Baseline für Carbon möchten. Probieren Sie repräsentative Repository-Änderungen, Code-Reviews und Bugfixes aus und protokollieren Sie, welche Ausgaben Ihre Abnahmetests bestehen.
**GPT-6.1 Astra:** Nehmen Sie es als Cross-Provider-Vergleich für die gleichen Engineering-Aufgaben auf. Messen Sie akzeptierte Fixes, Abschlusszeit und Gesamtkosten. Die zuvor diskutierten GPT-6 Astra-Ergebnisse beziehen sich auf diese benchmarkte Version und sollten nicht als Scores von GPT-6.1 Astra behandelt werden.
**Claude Opus 5.5:** Fügen Sie es als weiteren Kandidaten für Repository-Analyse, Refactoring und Review hinzu. Verwenden Sie die gleichen Aufgabenbeschreibungen und Validierungskriterien, damit Sie den praktischen Wert jedes Ergebnisses vergleichen können.
Halten Sie Ihre Modellauswahl konfigurierbar und speichern Sie die Prompts, Testfälle und Ergebnisse jedes Laufs. Das gibt Ihnen einen nützlichen Ausgangspunkt für die Evaluation von Carbon, ohne Ihren Workflow an ein nicht angekündigtes API-Format zu binden.
Benchmark
Gemini 4 Carbon
Gemini 4 Argon
GPT-6 Astra
Claude Opus 5.5
AA Intelligence Index v5.0
59
50
57
58
Vals Index v2.2
70.4%
69.2%
65.0%
70.2%
SWE-sweep
9.6%
4.3%
9.5%
3.6%
FrontierSWE 2
61.2%
55.0%
65.5%
62.3%
Terminal-Bench 4.0 (AA)
65.2%
57.1%
59.1%
59.6%
Agents' Last Exam v1.1
77.4%
69.0%
73.1%
71.6%
OSWorld-2.1, offline subset
81.5%
74.7%
80.9%
87.2%
AutomationBench, Zapier
53.9%
51.3%
41.4%
42.5%
Prepare a Model Evaluation Workflow
Ein praktisches Evaluations-Framework sollte mehr messen als die allgemeine Antwortqualität.
Für Coding- und Sicherheits-Workflows sind folgende Metriken hilfreich:
Task-Completion-Rate: Wie oft erfüllt der Agent vordefinierte Abnahmetests?
Patch-Korrektheit: Behebt die vorgeschlagene Änderung den ursprünglichen Defekt, ohne bestehendes Verhalten zu beeinträchtigen?
False-Positive-Rate: Wie oft schlägt eine gemeldete Problematik bei der Validierung fehl?
End-to-End-Latenz: Wie lange dauert der vollständige Workflow, einschließlich Tool-Ausführung?
Gesamtkosten pro Aufgabe: Wie viel kostet jedes akzeptierte Ergebnis nach Wiederholungen und Tool-Nutzung?
Befolgung von Anweisungen: Bleibt der Agent innerhalb der autorisierten Dateien, Tools und Aktionen?
Verwenden Sie einen festen Satz realer Aufgaben und halten Sie Modell, Einstellungen, Token-Nutzung und Testergebnisse fest. Schließen Sie Wiederholungen und manuelle Korrekturen in die Kosten ein. Sobald Carbon verfügbar ist, führen Sie die gleiche Evaluation durch, um zu sehen, ob es für Ihre Zeit und Ihr Budget mehr akzeptierte Arbeit liefert.
Conclusion
Gemini 4 Carbon ist ein vielversprechendes Upgrade für anspruchsvolles Coding, Langkontext-Schlussfolgern und defensive Sicherheitsarbeit. Die veröffentlichten Ergebnisse zeigen klare Zuwächse gegenüber Argon, während der Zugang mit Stand 29. Oktober 2026 weiterhin begrenzt ist. Etablieren Sie vorerst eine Baseline mit einem verfügbaren Modell und halten Sie Ihre Integration flexibel. Wenn Carbons öffentliche API öffnet, vergleichen Sie Qualität der abgeschlossenen Arbeit, eingesparte Zeit und Gesamtkosten, bevor Sie über einen Wechsel entscheiden.
FAQ
Can Gemini 4 Carbon run without human supervision?
Berichte über mehrtägige interne Ingenieurarbeit belegen keine unbeaufsichtigte Zuverlässigkeit für beliebige Aufgaben. Ein Team, das autonome Ausführung erwägt, sollte erlaubte Aktionen, Stop-Bedingungen und Abnahmetests definieren und messen, wie oft der Agent Arbeit ohne Korrektur abschließt. Laufzeit allein zeigt nicht, dass die Ausgabe eines Agenten korrekt ist.
Can an existing Argon integration switch directly to Carbon?
Nicht anhand der hier verfügbaren Evidenz. Halten Sie die Anbieterauswahl konfigurierbar, verifizieren Sie jedoch Carbons tatsächliche Modellkennung, unterstütztes Schema, Tools, Limits und Konto-Zugriff, bevor Sie eine Deployment-Änderung vornehmen. Das Wiederverwenden eines Prompts hilft bei einem kontrollierten Vergleich; es beweist keine API-Kompatibilität.
Which Gemini 4 Carbon tests matter for a private codebase?
Beziehen Sie repräsentative Bugs, Repository-Änderungen und Sicherheitsbefunde mit bekannten Abnahmekriterien ein. Prüfen Sie, ob Patches relevante Tests bestehen, ob Befunde reproduzierbar sind und ob es unbeabsichtigte Verhaltensänderungen gibt. Berücksichtigen Sie fehlgeschlagene Versuche und manuelle Korrekturen in der Kostenanalyse, damit ein starker öffentlicher Benchmark-Score operative Arbeit nicht überdeckt.