
TL;DR
Kimi K3.1 Pro bringt stärkere Leistungen in Coding, CAD und Finanzforschung auf die K3‑Basis von Moonshot AI, mit einem Kontextfenster von einer Million Token. Der veröffentlichte Terminal-Bench 4.0‑Score von 65,7 % positioniert das Modell in Moonshots Vergleich nahe bei Claude Opus 5.5. Das Standardmodell eignet sich für kostenkritische Workloads; Highspeed bietet etwa 2–3× schnellere Ausgaben bei identischen beworbenen Fähigkeiten.
Beide sind über die CometAPI‑API für Kimi K3.1 Pro verfügbar. Die Standardpreise von CometAPI liegen bei $1.60 pro eine Million Eingabe‑Token und $8.00 pro eine Million Ausgabe‑Token. Dieser Leitfaden erklärt die Benchmarks, vergleicht Kosten und zeigt, wie man beide Versionen aufruft. Zahlen und Preise wurden am 24. Oktober 2026 geprüft.
Key Takeaways
- Kimi K3.1 Pro ist ein Post‑Training‑Upgrade: Es baut auf K3s MoE‑Fundament auf und unterstützt ein Kontextfenster mit 1,048,576 Token.
- Kimi K3.1 Pro stärkt Agent‑Workflows: Moonshot berichtet 65,7 % auf Terminal-Bench 4.0 und 92,7 % Voxel‑IoU auf BenchCAD mit Tools.
- Kimi K3.1 Pro Highspeed priorisiert Antwortgeschwindigkeit: Die beworbene Ausgaberate ist etwa 2–3× so hoch wie bei der Standardversion, bei identischen Modellfähigkeiten.
- Zugriff auf die Kimi K3.1 Pro‑API über CometAPI: Standard‑Eingabe‑ und ‑Ausgaberaten liegen 20 % unter den offiziellen USD‑Tarifen; Highspeed‑Preise erfordern eine separate Kontoabfrage.
- Gehosteter Zugriff auf Kimi K3.1 Pro geht der vollständigen Gewichtsfreigabe voraus: Moonshot plant die Veröffentlichung der kompletten Gewichte bis zum 4. November 2026.
What Exactly Is Kimi K3.1 Pro?
Kimi K3.1 Pro ist das Flaggschiff‑LLM des in Peking ansässigen Moonshot AI (月之暗面), veröffentlicht am 23. Oktober 2026. Es ist kein vollständig neues Basismodell. Stattdessen ist es eine stark nachtrainierte Version des früheren Kimi K3 (erschienen im Juli 2026), mit deutlich größerem Post‑Training‑Compute, fokussiert auf gemeinsames Reinforcement Learning über Hunderte Downstream‑Domänen.
Moonshot beschreibt es als „unser bislang leistungsfähigstes Open‑Weight‑Modell der 3T‑Klasse“. Das Modell behält die gleiche Kernarchitektur wie K3 bei:
- 2.8 Billionen Gesamtparameter
- 104 Milliarden aktive Parameter pro Token (sparses Mixture‑of‑Experts‑Design)
- Natives Kontextfenster mit 1 Million Token
- Multimodaler Support (Text-, Bild- und Videoeingabe)
- Stets aktives Reasoning (kein Modus ohne „Denken“)
Eine begleitende Variante, Kimi K3.1 Pro Highspeed, liefert die 2–3× Inferenzgeschwindigkeit der Standard‑Pro‑Version bei doppeltem Preis und eignet sich damit für interaktive oder latenzsensitive Anwendungen.
Die vollständigen Modellgewichte sollen bis zum 4. November 2026 öffentlich verfügbar werden, womit K3.1 Pro eines der stärksten Open‑Weight‑Modelle wäre.
Kimi 3.1 Pro Technical Specifications
| Specification | Details |
|---|---|
| Model Family | Kimi K3.1‑Serie (erstes Modell) |
| Base | Nachtrainiertes Kimi K3 |
| Total Parameters | 2.8 Billionen |
| Active Parameters | 104 Milliarden (MoE) |
| Context Window | 1,048,576 Token |
| Max Output | Bis zu ~944K–1M Token (konfigurierbar) |
| Input Modalities | Text, Bild, Video |
| Output | Text |
| Reasoning | Stets aktiv (low / high / max Effort) |
| Tool Calling | Unterstützt |
| Structured Output (JSON) | Unterstützt |
| API Model IDs | kimi-k3.1-pro, kimi-k3.1-pro-highspeed |
| Open Weights | Bis 4. November 2026 |
Kimi K3.1 Pro Benchmarks: Coding, CAD, and Finance
Die folgende Tabelle verwendet die Veröffentlichungsevaluierungen von Moonshot. Dies sind vom Anbieter gemeldete Benchmark‑Ergebnisse, kein unabhängig reproduzierter Cross‑Provider‑Test.
Die Halluzinationsraten sanken stark: Moonshot berichtet, dass falsche Behauptungen von 23,4 % bei K3 auf etwa 8,3 % (oder niedriger in internen Tests) fielen. Finanzbezogenes Modellieren und Research verbesserten sich ebenfalls deutlich.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | Hinweis |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% | Coding‑Agenten für realistische Terminal‑Tasks |
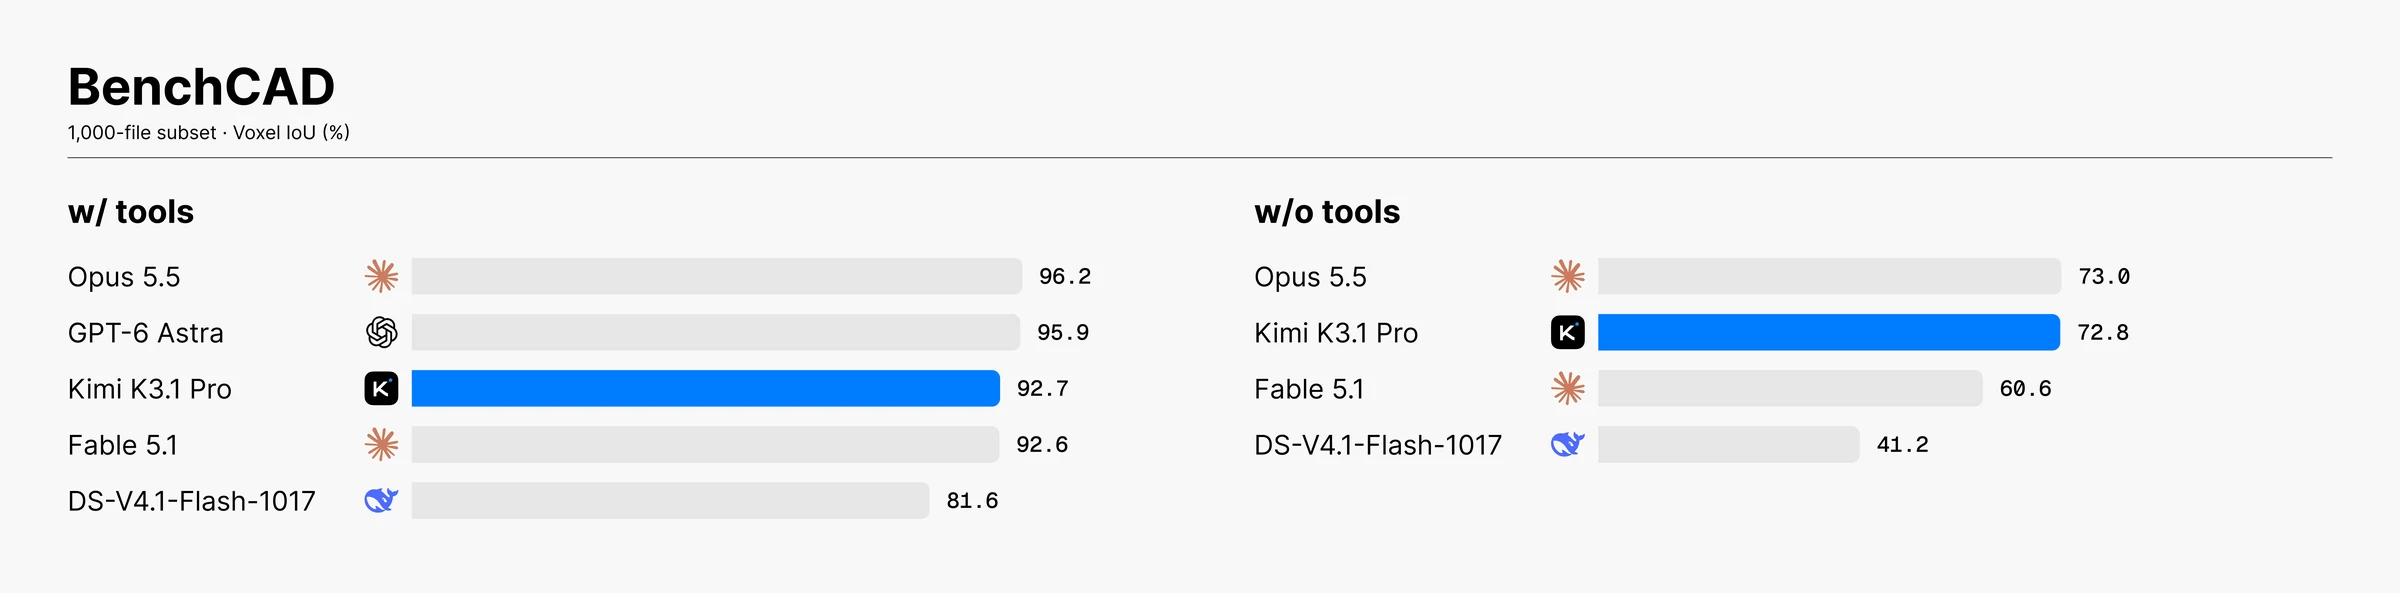
| BenchCAD, mit Tools (Voxel IoU) | 92.7% | 96.2% | 95.9% | 3D‑Rekonstruktion / CAD |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.4 | Dokumenten‑ & Office‑Aufgaben |
| Frontier Finance | 58.6 | 56.7 | 45.0 | Finanzen |
| SWE-Marathon | 51.7% | 46.3% | 42.5% | Langfristige Softwareentwicklung |
| Humanity’s Last Exam (mit Tools) | 70.0% | 67.7% | 57.2% | Breites Wissen & Reasoning |
| Kimi Hallu Bench Hard, mit Tools (je niedriger, desto besser) | 8.3% | 15.0% | 5.5% |
Coding‑Benchmarks zeigen Agent‑Performance auf Frontier‑Niveau
Bei Terminal-Bench 4.0 beträgt der Abstand zu Claude Opus 5.5 0,7 Prozentpunkte; der Vorsprung gegenüber GPT-6 Astra liegt bei 7,5 Punkten. Das macht K3.1 Pro zu einem relevanten Kandidaten für terminalbasierte Engineering‑Agenten, jedoch ist das Evaluierungssetup ebenso wichtig wie der Schlagzeilen‑Score.
Beachten Sie, dass einige unabhängige Coding‑Agent‑Tests je nach Harness und Sitzungsdauer gemischtere Ergebnisse zeigen, wobei K3.1 Pro mitunter längere, ausführlichere Reasoning‑Traces erzeugt.
Kimi K3.1 Pro verbessert 3D‑Erstellung und Vision
BenchCAD misst die Rekonstruktionsqualität aus Multi‑View‑Renderings über generierten CAD‑Code. Sein Voxel‑IoU‑Score misst die geometrische Überlappung, daher sollte 92,7 % nicht als 92,7%ige Aufgabenbestehensrate gelesen werden. Moonshots Vergleich „mit Tools“ nutzt einen 1.000‑Fälle‑Ausschnitt und platziert K3.1 Pro bei dieser Metrik unter Opus 5.5 und GPT-6 Astra.
Es zeigt außerdem große Zugewinne gegenüber Kimi K3 bei Vision‑Language‑Aufgaben (z. B. +0.11 mAP50 auf dem Ultralytics Auto‑Annotation Leaderboard) und Datenanalyse‑Prüfungen (42/43 Fragen bestanden).
What’s New in Kimi K3.1 Pro Compared With Kimi K3?
Der klarste Grund für ein Upgrade ist die verbesserte Fertigstellung von mehrstufiger Arbeit. Die folgende Tabelle vergleicht K3 und K3.1 Pro innerhalb der von Moonshot gemeldeten Evaluierungen.
| Evaluation | Kimi K3 | Kimi K3.1 Pro | Improvement |
|---|---|---|---|
| Kimi Code Bench 3.0 Long-horizon | 55.95% | 61.2% | +5.25 Punkte |
| Internal Financial Modeling | 50.4 | 57.6 | +7.2 Punkte |
| Internal Financial Research | 58.8 | 70.4 | +11.6 Punkte |
| Internal Business Operation | 8.9 | 37.0 | ~4.2× Leistung |
| Kimi Hallu Bench Hard mit Tools, Claim‑Level‑Fehler | 23.4% | 8.3% | ~64.5% Reduktion |
Dies sind jedoch individuelle Benchmark‑Vergleiche. Sie sollten nicht als universelle 4,2×‑Verbesserung der Agentenleistung interpretiert werden.
Kimi K3.1 Pro reduziert Faktenfehler
Das Diagramm trennt Ergebnisse ohne Tools von der schwierigeren Evaluierung mit Tools; die 8,3%‑Zahl gehört zu letzterer.
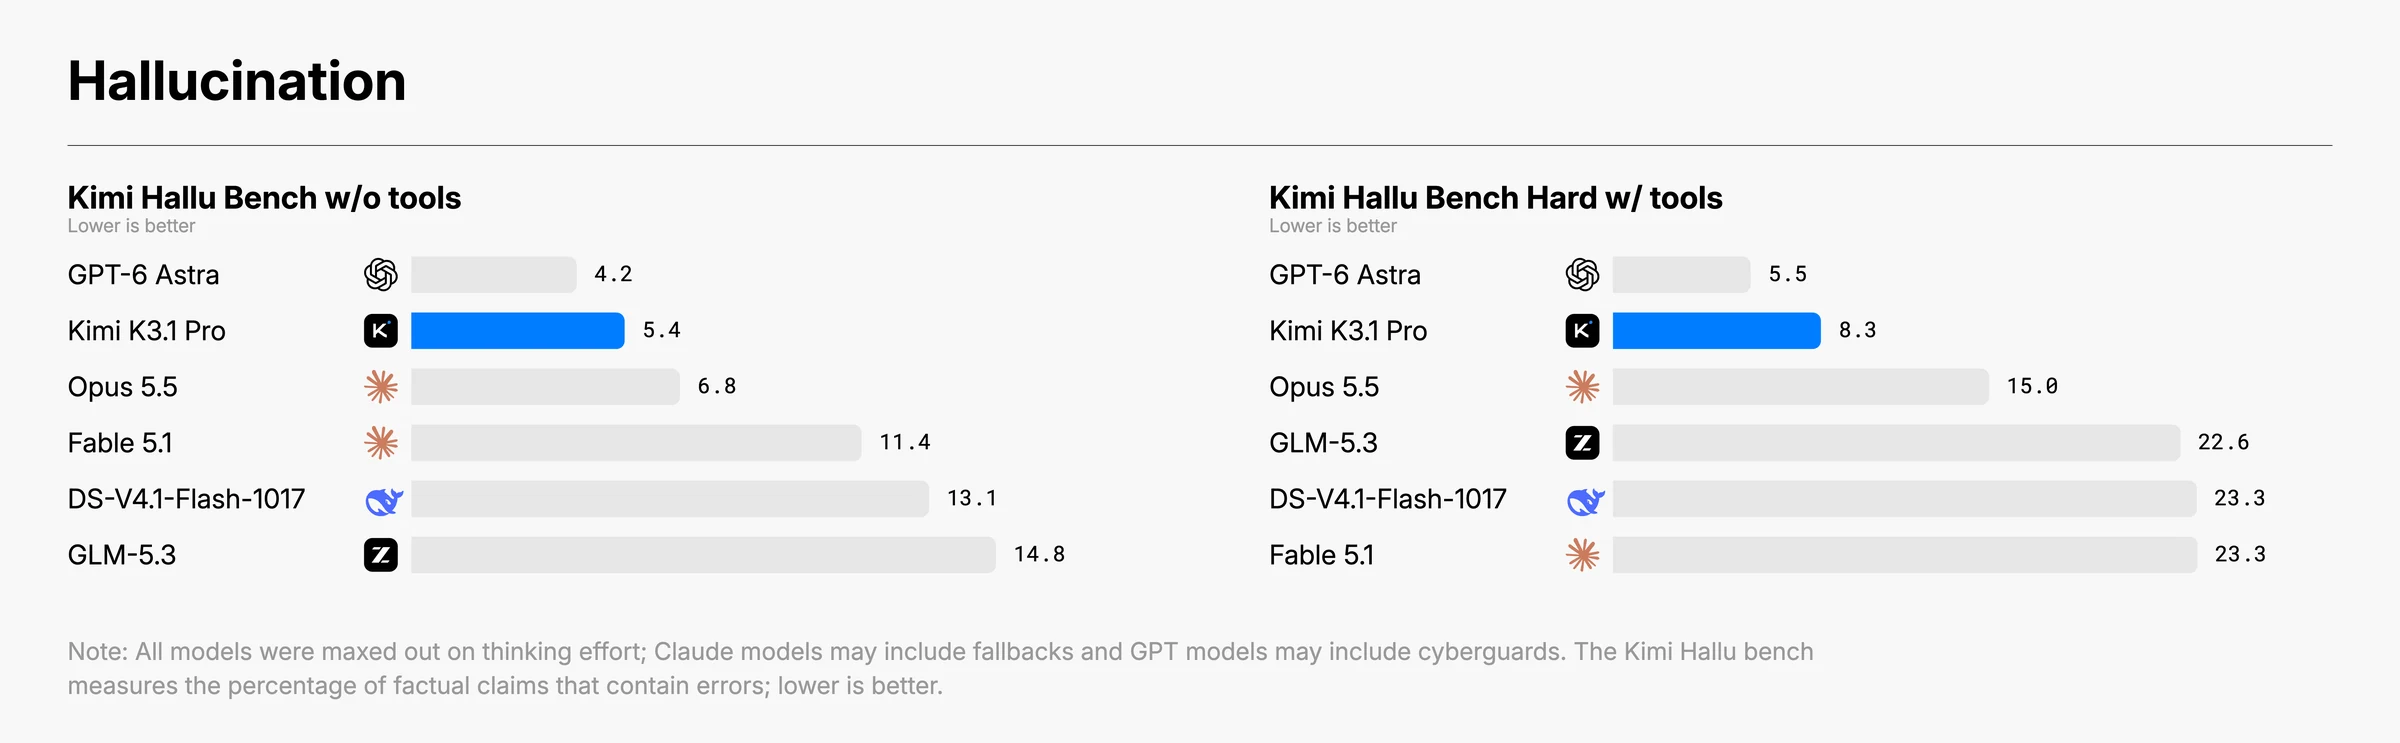
Die Unterscheidung zwischen Benchmark‑Genauigkeit und realer Zuverlässigkeit ist wichtig. Diese Evaluierung verwendet bewusst schwierige Prompts, die wahrscheinlich Faktenfehler aufdecken. Ihre Ergebnisse repräsentieren nicht die durchschnittliche Halluzinationsrate des Modells in Alltagsgesprächen.
Kimi K3.1 Pro führt einen bewussten Cybersicherheits‑Trade‑off ein
Moonshot AI entfernte ausgewählte cyberbezogene Trainingsdaten und Reinforcement‑Learning‑Tasks, um offensive Cybersicherheitsfähigkeiten zu reduzieren und gleichzeitig die allgemeine Coding‑Performance zu erhalten.
In Moonshots interner xdev-bench-hard‑Evaluierung bei pass@3 erzielte der unbeschränkte Checkpoint 90,5 %, und das Release‑Modell 81,0 %. Dieser Unterschied spiegelt eine bewusste Trainingsentscheidung wider und ist keine Garantie dafür, dass das veröffentlichte Modell nicht missbraucht werden kann. Siehe die offizielle Cybersicherheits‑Evaluierung für Bedingungen und Einschränkungen.
Kimi K3.1 Pro vs Highspeed: Which Version Should You Choose?
| Decision factor | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| Model capabilities | Standard‑Flaggschiff‑Fähigkeiten | Gleiche beworbene Fähigkeiten |
| Output speed | Basislinie | Ungefähr 2–3× schneller |
| Best starting workload | Batch‑Analysen, lange Berichte, Hintergrundtasks | Interaktive Coding‑ und Research‑Assistenten |
| CometAPI model ID | kimi-k3.1-pro | kimi-k3.1-pro-highspeed |
Verwenden Sie die Standardversion, wenn die Kosten wichtiger sind als die sofortige Ausgabe. Wählen Sie Highspeed, wenn Nutzer auf die Generierung warten, und messen Sie dann die Wirkung auf vollständige Tasks, statt anzunehmen, dass Ausgabegeschwindigkeit direkt in die gleiche Zeitersparnis end‑to‑end übersetzt.
Beispiel: Wenn ein Coding‑Agent die meiste Zeit damit verbringt, Tests auszuführen, Abhängigkeiten zu installieren oder auf externe Tools zu warten, kann die Beschleunigung der Modellausgabe nur eine relativ kleine End‑to‑End‑Verbesserung bringen.
Access Both Kimi K3.1 Pro Versions Through CometAPI
CometAPI bietet Zugriff auf Kimi K3.1 Pro und Kimi K3.1 Pro Highspeed über den OpenAI‑kompatiblen Chat‑Completions‑Endpoint. Die Integration bleibt beim Wechsel der Version unverändert; ändern Sie die Model‑ID, um die Variante zu wählen.
- Erstellen Sie einen API‑Schlüssel in Ihrem CometAPI‑Konto und stellen Sie ihn Ihrer Anwendung als Umgebungsvariable COMETAPI_API_KEY zur Verfügung.
- Installieren Sie das OpenAI‑Python‑SDK und setzen Sie dann die Base‑URL des Clients auf
https://api.cometapi.com/v1. - Verwenden Sie kimi-k3.1-pro für das Standardmodell oder kimi-k3.1-pro-highspeed für Highspeed.
python -m pip install --upgrade openaiimport osfrom openai import OpenAIclient = OpenAI( api_key=os.environ["COMETAPI_API_KEY"], base_url="https://api.cometapi.com/v1",)response = client.chat.completions.create( model="kimi-k3.1-pro", # Oder "kimi-k3.1-pro-highspeed" messages=[ { "role": "user", "content": "Schlagen Sie drei Tests für eine CSV-Importfunktion vor.", } ],)print(response.choices[0].message.content)
Das folgende Shell‑Beispiel ruft Highspeed direkt auf. Es verwendet dieselbe Umgebungsvariable COMETAPI_API_KEY.
Kimi K3.1 Pro API Pricing: Official Rates vs CometAPI
Die Tabelle vergleicht veröffentlichte USD‑Tarife pro eine Million Token für nicht gecachte Eingaben und generierte Ausgaben, geprüft am 24. Oktober 2026. CometAPIs Standardtarife für K3.1 Pro liegen 20 % unter den offiziellen Tarifen. Prüfen Sie die aktuellen Highspeed‑Tarife Ihres Kontos, bevor Sie diese Version wählen.
| Model | Official input | Official output | CometAPI input | CometAPI output |
|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $1.60 | $8.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | Check account pricing | Check account pricing |
Der Rabatt der Standardversion sollte nicht auf Highspeed übertragen angenommen werden. Cache‑Reads und ‑Writes, Tool‑Gebühren, Steuern und Retries liegen außerhalb dieses Vergleichs.
Zu offiziellen API‑Tarifen ist K3.1 Pro für nicht gecachte Eingabe‑ und Ausgabe‑Token etwa 33,3 % günstiger als K3.
Für Anfragen ohne Caching oder zusätzliche kostenpflichtige Dienste gilt die Formel:
Kosten = (Eingabe‑Token × Eingaberate + Ausgabe‑Token × Ausgaberate) / 1,000,000
Beispielsweise kostet die Verarbeitung von 100,000 nicht gecachten Eingabe‑Token und die Generierung von 10,000 Ausgabe‑Token über die Standard‑API von K3.1 Pro bei CometAPI ungefähr $0.24, verglichen mit $0.30 beim offiziellen Anbieter.
Schätzen Sie Produktionsausgaben anhand erfolgreicher Tasks, einschließlich etwaiger Retries oder Reasoning‑Token‑Nutzung in Ihren Abrechnungen. Ein niedrigerer Tokenpreis garantiert keine niedrigeren Gesamtkosten, wenn ein Workflow mehr Token erzeugt oder zusätzliche Versuche benötigt.
Put Kimi K3.1 Pro to Work: Four Practical Starting Points
Wählen Sie einen kleinen Workflow mit einem Ergebnis, das Sie prüfen können.
| Workflow | A practical first project | Acceptance checks |
|---|---|---|
| Software engineering | Beheben Sie einen reproduzierbaren Bug in einem Repository und fügen Sie einen Regressionstest hinzu. | Relevante Tests bestehen; der Patch behebt das Problem ohne nicht verwandte Änderungen. |
| CAD and 3D creation | Generieren Sie ein parametrisches Bauteil anhand eines bemaßten Briefings. | Prüfen Sie Maße, gültige Geometrie, Editierbarkeit und Export‑Kompatibilität. |
| Financial research | Gleichen Sie ausgewählte Kennzahlen aus Jahresberichten und einer Arbeitsmappe ab. | Verifizieren Sie jede Zahl gegen ihre Quelle und prüfen Sie Formeln unabhängig. |
| Long-context research | Vergleichen Sie Anforderungen über eine Sammlung technischer Dokumente. | Prüfen Sie Fundstellen, Dokumentversionen und die Abdeckung widersprüchlicher Aussagen. |
Für die Evaluation ist der Erfolg abgeschlossener Tasks aussagekräftiger als die Anzahl generierter Codezeilen.
What Are the Limitations of Kimi K3.1 Pro?
- Reasoning bleibt aktiviert. K3.1 Pro unterstützt niedrigen, hohen und maximalen Reasoning‑Aufwand, mit „max“ als dokumentiertem Standard. Gehen Sie nicht von einem Modus ohne Reasoning aus.
- Lange Eingaben verursachen Betriebskosten. Ein großes Kontextfenster kann die Eingabeverarbeitungszeit und den Token‑Verbrauch erhöhen. Wählen Sie relevantes Material aus und evaluieren Sie Caching, statt standardmäßig ein gesamtes Archiv zu senden.
- Eine API‑Antwort schließt keinen externen Workflow ab. Ihre Anwendung liefert Tool‑Ausführung, gespeicherten Zustand und Output‑Validierung; ein Tool‑fähiger Benchmark‑Wert bedeutet nicht, dass diese Fähigkeiten mit einem nackten API‑Call mitgeliefert werden.
- Gehosteter Zugriff und herunterladbare Gewichte sind unterschiedliche Meilensteine. Stand 24. Oktober ist die vollständige Gewichtsfreigabe von K3.1 Pro weiterhin für den 4. November 2026 geplant; prüfen Sie Release und Lizenz, bevor Sie Self‑Hosting planen.
Das API‑Verhalten ist im Kimi API Guide beschrieben; die Verfügbarkeit der Gewichte wird in der Release‑Ankündigung behandelt.
Conclusion
Kimi K3.1 Pro lohnt sich zur Evaluation, wenn Ihre Anwendung von mehrstufigem Coding, Dokumentenrecherche oder Tool‑unterstützter Arbeit abhängt. Die gemeldeten Zuwächse gegenüber K3 und niedrigere Standard‑API‑Tarife liefern einen praktischen Grund, das Upgrade zu testen. Beginnen Sie mit dem Standardmodell, messen Sie die Qualität und Kosten akzeptierter Tasks und wählen Sie Highspeed dort, wo schnellere Generierung die User Experience materiell verbessert. Verwenden Sie das CometAPI‑Modell, um Zugriff und aktuelle Preise zu prüfen, bevor Sie die obigen Beispiele integrieren.