Mit CometAPI entwickelnEine API für mehrere Modelle erforderlich?Teste den Workflow im Playground und erstelle anschließend einen API-Schlüssel, sobald Modell und Kosten zu deinem Anwendungsfall passen.
Step 5 Preview ist das Flaggschiff-KI-Modell von StepFun für Software Engineering, Finanzforschung und komplexe Agent-Workflows. Es verbindet wettbewerbsfähige Aufgabenleistung mit kosteneffizienter Inferenz, auch wenn die Ergebnisse je nach Benchmark variieren. Entwickler können es über eine gehostete API nutzen oder die offenen Gewichte je nach Budget, Infrastruktur und Leistungsanforderungen selbst deployen.
Zentrale Erkenntnisse
Architektur: Step 5 Preview verwendet eine sparse MoE-Architektur mit insgesamt 600B Parametern und 27B aktiven Parametern pro Token, was Modellkapazität und Inferenz-Effizienz ausbalanciert.
Kontext und Multimodalität: Das Modell unterstützt ein 1M-Token-Kontextfenster, Text-, Bild- und Videoeingaben sowie bis zu 64K Ausgabetokens über die gehostete API.
Benchmark-Leistung: Step 5 Preview erreicht 67,7% auf DeepSWE v1.1 und 66,4% auf FrontierFinance, liegt jedoch auf Terminal-Bench v4 hinter mehreren Wettbewerbern.
API-Preise: StepFun berechnet $1,00 für ungecachte Eingaben, $0,10 für gecachte Eingaben und $2,70 für Ausgaben pro einer Million Tokens.
Weiterlernen
Diesen Artikel mit der nächsten Entscheidung verknüpfen.
Auf Klarheit, Quellenangabe und aktuelle API-Terminologie geprüft.
Bereitstellungsflexibilität: Entwickler können Step 5 Preview über die gehostete API nutzen oder die veröffentlichten Gewichte mit kompatiblen Frameworks wie vLLM, SGLang und Transformers selbst hosten.
Was ist Step 5 Preview?
Step 5 Preview ist ein großes multimodales Reasoning-Modell von StepFun (阶跃星辰). Es zielt auf Workloads mit erweitertem Reasoning, wiederholter Toolausführung und Analysen über große Informationssammlungen. StepFun bietet gehosteten API-Zugang und veröffentlicht herunterladbare Modellgewichte.
Im Unterschied zu generischen Assistenten, die primär auf Konversationsantworten optimiert sind, betont Step 5 Preview agentische Ausführung: die Fähigkeit zu planen, Tools zu nutzen, Zwischenresultate zu prüfen, Fehler zu korrigieren und auf ein komplexes Ziel hinzuarbeiten.
Zentrale Spezifikationen
Die offizielle Modellkarte dokumentiert die sparse Architektur, Parameterzahlen und Bereitstellungskonfigurationen. Die Spezifikationen der gehosteten API definieren separat unterstützte Eingaben, Generationslimits und Serving-Features. Dies sind unterschiedliche Ebenen des Bereitstellungsvertrags.
Spezifikation (Modellkarte und API-Dokumentation oben verlinkt)
Step 5 Preview
Entwickler
StepFun
Modellkennung
step-5-preview
Modellkategorie
Multimodales Reasoning und agentisches LLM
Architektur
Sparse Mixture-of-Experts
Gesamtparameter
Ca. 600B
Aktive Parameter pro Token
Ca. 27B
Anteil aktiver Parameter
Ca. 4,5%
Kontextfenster
Bis zu 1M Tokens
Unterstützte Eingaben
Text, Bilder und Video über die gehostete API
Maximale Ausgabe (gehostete API)
64k Tokens
Primäre Ausgabe
Text
Reasoning-Modi
low, medium, high; reasoning_effort bei Chat Completions
Toolaufrufe
Unterstützt
Strukturierte Ausgabe
JSON-Modus und JSON-Schema auf der gehosteten API
Prompt-Caching
Unterstützt
Status der gehosteten API
Verfügbar seit 19. Oktober 2026
Verfügbarkeit der Gewichte
Die gehostete API dokumentiert eine maximale Ausgabe von 64k Tokens, während die Modellkarte eine Sequenzgenerierungskapazität von bis zu 1M Tokens aufführt. Letzteres ist kein Versprechen, dass der gehostete Endpunkt eine 1M-Token-Completion akzeptiert. In selbst gehosteten vLLM-Beispielen umfasst das konfigurierte 1M-Token-Sequenzbudget Eingabe und Ausgabe zusammen; verfügbare KV-Cache-Speicher und Parallelität können die nutzbare Kapazität reduzieren.
So funktioniert die 600B/27B-MoE-Architektur
Ein konventioneller dichter Transformer aktiviert während der Inferenz den Großteil seiner Parameter. Step 5 Preview nutzt stattdessen sparse Routing, um relevante Experts zu wählen. Mit ca. 27B aktiven Parametern von 600B nehmen rund 4,5% der Gesamtparameter an der Berechnung eines typischen Tokens teil.
Dies erklärt die Kosteneffizienzstrategie des Modells. 27B aktiv bedeutet jedoch nicht einen Bereitstellungs-Footprint von 27B. Die vollständigen Expert-Gewichte müssen weiterhin gespeichert und abgerufen werden; daher sind GPU-Speicherkapazität, Expert-Parallelisierung und Interconnect-Bandbreite entscheidende Faktoren.
Unterstützte Eingaben und Ausgabelimits
Die gehostete API akzeptiert Text, Bilder und Video mit einem Kontextfenster von bis zu 1M Tokens und einer maximalen Ausgabe von 64k Tokens. Diese Eingaben unterstützen Aufgaben wie Repository-Analysen, Finanzdokumentenrecherche und visuelle Interpretation. Beim Self-Hosting hängt die nutzbare Sequenzlänge von Laufzeitkonfiguration, verfügbarem Speicher und Parallelität ab.
Multimodale Unterstützung und API-Funktionen können sich zwischen gehosteten und selbst deployten Konfigurationen unterscheiden.
Wie schneidet Step 5 Preview in Benchmarks ab?
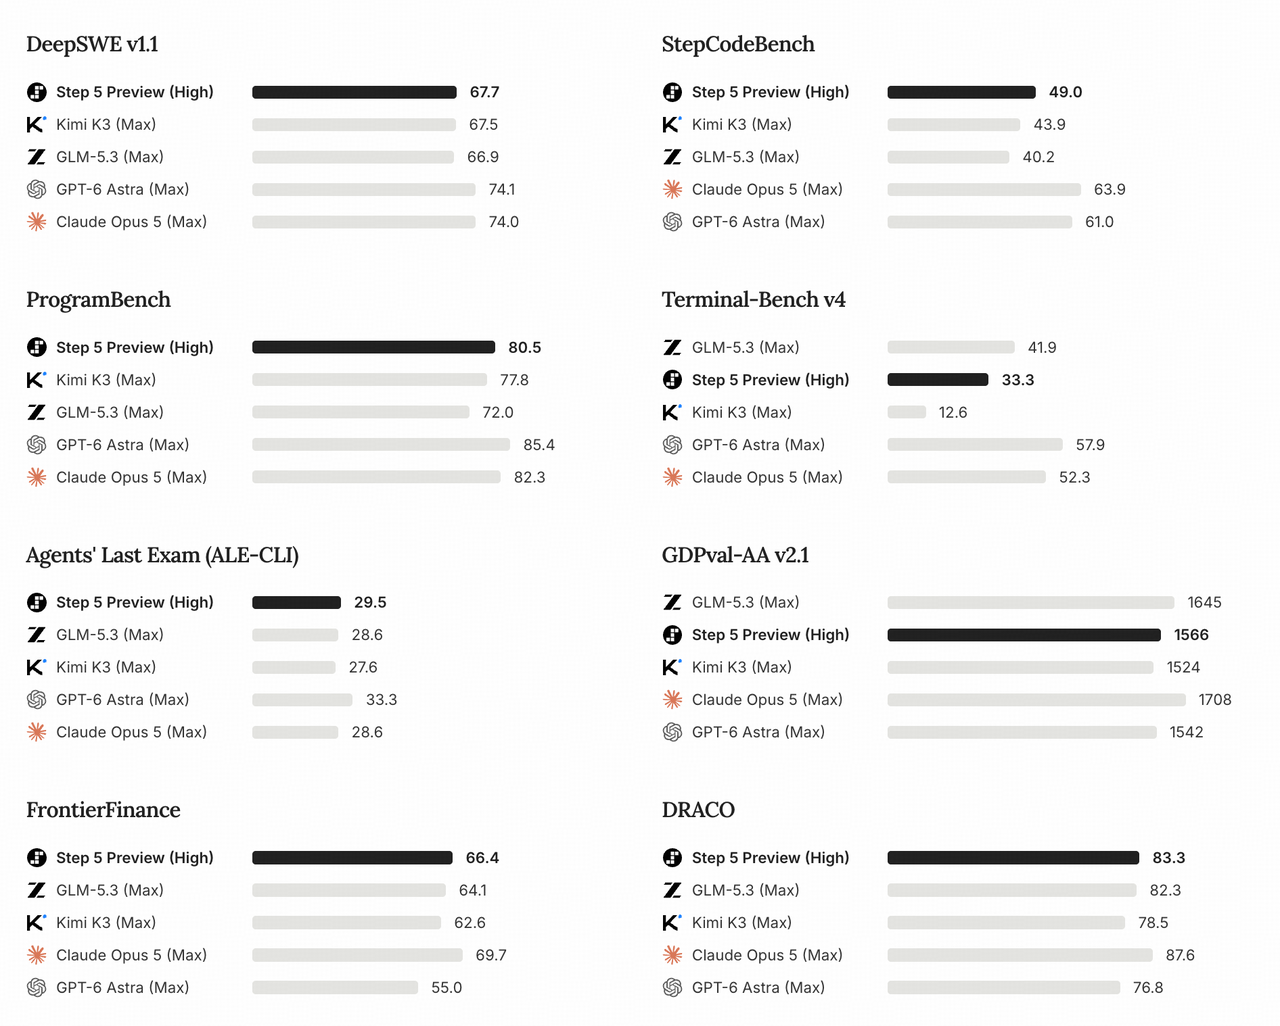
Die folgenden Ergebnisse stammen von StepFun. Step 5 Preview nutzt die Einstellung High; die Vergleichsmodelle nutzen Max. Übereinstimmende Label-Namen bedeuten keine gleiche Rechenzeit, und diese veröffentlichten Scores messen weder Anwendungslatenz noch Kosten pro erfolgreicher Aufgabe.
Das ursprüngliche offizielle Diagramm fasst die Bewertungsergebnisse des Herausgebers zusammen. Die Tabellen unten extrahieren die für diese Analyse relevanten Coding-, Reasoning- und Finance-Scores.
Coding- und agentische Leistung
Benchmark
Step 5 Preview (High)
Kimi K3 (Max)
GLM-5.3 (Max)
GPT-6 Astra (Max)
Claude Opus 5 (Max)
DeepSWE v1.1
67.7
67.5
66.9
74.1
74.0
StepCodeBench
49.0
43.9
40.2
61.0
63.9
ProgramBench
80.5
77.8
72.0
85.4
82.3
Terminal-Bench v4
33.3
12.6
41.9
57.9
52.3
Agents’ Last Exam (ALE-CLI)
29.5
27.6
28.6
33.3
28.6
Scores sind Prozentsätze; höhere Werte bedeuten bessere Leistung im jeweiligen Benchmark. DeepSWE v1.1 nutzt das SWE-agent-Harness mit temperature=1.0 und top_p=0,95; StepCodeBench meldet avg@4, ProgramBench meldet die Erfolgsrate. Jeder Benchmark misst eine andere Aufgabe mit eigener Evaluierungsumgebung, daher sind die Prozentsätze keine austauschbaren Genauigkeitsmaße. Der veröffentlichte Vergleich stellt keine identische Hardware oder identische Ausführungsbudgets zwischen den Modellen sicher.
Auf DeepSWE v1.1 erzielt Step 5 Preview 67,7% und liegt damit knapp vor Kimi K3 und GLM-5.3. Dies deutet auf eine wettbewerbsfähige Leistung für Coding-Agenten hin, die mit Repositories und automatisierter Softwareentwicklung arbeiten.
Auch ProgramBench liefert ein positives Signal. Step 5 Preview erreicht 80,5% gegenüber 77,8% für Kimi K3 und 72,0% für GLM-5.3.
Terminal-Bench v4 offenbart jedoch eine bedeutende Einschränkung: Das Ergebnis von 33,3% für Step 5 Preview liegt hinter GLM-5.3 mit 41,9%, während GPT-6 Astra 57,9% erreicht. Dies legt nahe, dass Step 5 Preview bei repository-orientiertem Software Engineering wettbewerbsfähig ist, sein relativer Vorteil sich jedoch nicht einheitlich auf terminalgetriebene Ausführung und komplexes Debugging erstreckt.
Reasoning- und Wissensleistung
Benchmark
Step 5 Preview (High)
GLM-5.3 (Max)
Kimi K3 (Max)
GPT-6 Astra (Max)
GPQA Diamond
93.5%
91.7%
93.5%
96.1%
Humanity’s Last Exam
46.5%
42.3%
46.9%
54.7%
AA-LCR v1.1
88.3%
79.7%
88.7%
80.7%
CritPt
20.9%
19.1%
23.4%
31.7%
Step 5 Preview erreicht 93,5% auf GPQA Diamond, entspricht Kimi K3 und liegt hinter GPT-6 Astra mit 96,1%. Auf AA-LCR v1.1 liegt das Ergebnis von 88,3% leicht unter Kimi K3 (88,7%) und über GPT-6 Astra (80,7%). Auf Humanity’s Last Exam und CritPt liegt es hinter Kimi K3 und GPT-6 Astra. Die Ergebnisse deuten auf konkurrenzfähiges Wissen und Long-Context-Reasoning hin, mit relativen Stärken, die je nach Aufgabe variieren.
Finanzforschung und Bewertungsleistung
Finanzforschung ist einer der markantesten Anwendungsbereiche von Step 5 Preview. Das Modell ist darauf ausgelegt, quantitative Schlussfolgerungen, Evidenz-Retrieval und strukturierte Analysen zu kombinieren. Diese Fähigkeiten sind besonders relevant für Bewertung, Interpretation von Finanzdokumenten und Investment Research.
StepFun führte FinStepBench ein, um Finanzforschung in mehreren Stufen zu evaluieren – von der Informationsbeschaffung bis zur Erstellung belastbarer Schlussfolgerungen.
Benchmark
Step 5 Preview (High)
Kimi K3 (Max)
GLM-5.3 (Max)
GPT-6 Astra (Max)
Claude Opus 5 (Max)
FrontierFinance
66.4
62.6
64.1
55.0
69.7
FinStepBench LiveSearch
74.5
70.9
73.3
74.5
76.2
FinStepBench CorporateValuation
60.6
60.6
56.1
77.3
69.7
FinStepBench DeepResearch
55.8
48.9
53.3
45.0
59.1
Höhere Scores bedeuten eine stärkere Benchmark-Leistung. FinStepBench wird von StepFun entwickelt; unabhängige Validierung ist daher besonders wichtig.
Step 5 Preview erreicht 66,4% auf FrontierFinance und übertrifft damit Kimi K3, GLM-5.3 und GPT-6 Astra unter den berichteten Konfigurationen. Claude Opus 5 bleibt mit 69,7% voraus.
Das Ergebnis bei FinStepBench DeepResearch ist besonders bemerkenswert. Step 5 Preview erreicht 55,8% gegenüber 48,9% für Kimi K3 und 53,3% für GLM-5.3. Dies deutet darauf hin, dass das Modell gut geeignet sein kann für Finanzforschungs-Workflows, die Retrieval, Synthese und erweiterte Analysen erfordern.
Der CorporateValuation-Score zeigt ein nuancierteres Bild. Mit 60,6% liegt Step 5 Preview deutlich hinter GPT-6 Astra (77,3%). Step 5 Preview sollte daher nicht als universell überlegen für Finanzanalysen gelten. Die relative Platzierung ist bei DeepResearch stärker als bei CorporateValuation; das unterstützt aufgabenspezifische Evaluierung statt einer pauschalen Behauptung finanzieller Überlegenheit.
Für produktive Anwendungen erfordern finanzielle Ausgaben weiterhin unabhängig validierte Berechnungen, dokumentierte Annahmen und nachvollziehbare Belege.
Step 5 Preview im Vergleich zu anderen KI-Modellen
Step 5 Preview konkurriert sowohl mit gehosteten Alternativen als auch mit proprietären Frontier-Diensten. Benchmark-Ergebnisse helfen bei der Identifikation von Kandidaten; API-Zugang, Eingabeunterstützung, Bereitstellungskontrolle und tatsächliche Workload-Kosten bestimmen, welcher Kandidat zu einer Produktivanwendung passt.
CometAPI bietet Zugriff auf Kimi K3, GLM-5.3, GPT-6 Astra und Claude Opus 5. Diese Alternativen liefern nützliche Vergleichspunkte für Qualitätsniveau, Latenz und Kosten im jeweiligen Workload.
Step 5 Preview bietet einen dokumentierten 600B/27B-sparse-MoE-Checkpoint und eine Self-Hosting-Option. Bei den Alternativen hängen Gewichtsverfügbarkeit, Parameterzahlen, Kontextlimits und akzeptierte Eingaben vom Modell und Endpunkt ab. Veröffentliche Benchmarks helfen bei der Shortlist; repräsentative Coding- und Research-Aufgaben zeigen, wie sich jeder Dienst in der Praxis verhält.
Step 5 Preview vs Kimi K3
Step 5 Preview schneidet auf DeepSWE v1.1, ProgramBench und FrontierFinance leicht besser ab. Kimi K3 bleibt in Reasoning und einigen anderen technischen Evaluierungen wettbewerbsfähig. Der praktische Unterschied liegt weniger in einem klaren Intelligenzvorteil, sondern mehr in Kosten, Serving-Bedingungen und aufgabenspezifischer Zuverlässigkeit für Entwickler.
Step 5 Preview vs GLM-5.3
Step 5 Preview führt GLM-5.3 in mehreren Finanz- und Softwareentwicklungsbewertungen. Allerdings deutet der stärkere Terminal-Bench v4-Score von GLM-5.3 auf einen Vorteil bei den berichteten terminalorientierten Aufgaben hin. Für Coding-Agenten sollten erfolgreiche Repository-Änderungen, Tool-Call-Fehler, Ausführungszeit und Patch-Korrektheit verglichen werden, statt sich auf einen aggregierten Score zu verlassen.
Step 5 Preview vs GPT-6 Astra und Claude Opus 5
Die proprietären Frontier-Modelle schneiden auf den schwierigsten Software-Engineering-Benchmarks im Allgemeinen besser ab. Der Hauptanreiz von Step 5 Preview ist, dass es sich auf ausgewählten Workloads einer wettbewerbsfähigen Leistungsfähigkeit annähert und gleichzeitig eine Open-Weight-Bereitstellungsoption und relativ zugängliche API-Preise bietet.
Wählen Sie ein Premium-Modell, wenn die Kosten eines Fehlschlags hoch sind und ein zusätzlicher Genauigkeitsgewinn die Mehrkosten rechtfertigt. Ziehen Sie Step 5 Preview in Betracht, wenn Preis, Bereitstellungskontrolle und wiederholte Agenten-Ausführung mehr Gewicht haben.
Wie viel kostet die Step 5 Preview API?
Der Wert von Step 5 Preview hängt sowohl von der Aufgabenfähigkeit als auch von den Betriebskosten ab. Agent-Workflows können Dutzende Aufrufe, wiederholtes Dokumentenretrieval und Retries umfassen; ein niedriger Tokenpreis hilft nur, wenn das Modell die Aufgabe zuverlässig abschließt. Kosten pro erfolgreich abgeschlossener Aufgabe sind eine sinnvolle Ergänzung zu den untenstehenden Tarifen.
API-Verfügbarkeit und Token-Preise
Diese Momentaufnahme vom 19. Oktober 2026 vergleicht StepFuns native API-Tarife mit den CometAPI-Tarifen, die im Modellvergleich oben verlinkt sind. Alle Preise in US-Dollar pro eine Million Tokens. Die Dienste haben unterschiedliche Abrechnungs-, Cache- und Endpunktbedingungen; „Not listed“ bedeutet, dass in der Quell-Momentaufnahme dieses Artikels kein gecachter Eingabetarif angegeben ist.
Modell
Servicekanal
Model ID
Uncached input / 1M tokens
Cached input / 1M tokens
Output / 1M tokens
Step 5 Preview
StepFun native API
step-5-preview
$1.00
$0.10
$2.70
Kimi K3
CometAPI
kimi-k3
$2.40
Not listed
$12.00
GLM-5.3
CometAPI
glm-5.3
$1.12
Not listed
$3.53
GPT-6 Astra
CometAPI
gpt-6-astra
$8.00 (short-context tier)
Not listed
$40.00 (short-context tier)
Claude Opus 5
CometAPI
claude-opus-5
$4.00
Not listed
$20.00
Der short-context tier von GPT-6 Astra gilt bis 272.000 Tokens; die angegebenen long-context-Tarife betragen $16 für Eingabe und $60 für Ausgabe pro einer Million Tokens. Die angegebenen Tarife schließen Tools, Retries und Infrastruktur aus. Die Verfügbarkeit von Step 5 Preview über CometAPI wird durch diesen Vergleich nicht belegt; das folgende Beispiel nutzt StepFuns nativen Endpunkt.
Der Eingabetarif bei Cache-Treffer liegt 90% unter dem ungecachten Tarif. Der ungecachte Preis umfasst das Schreiben neuer Inhalte in den Cache, während die Ausgabeabrechnung sowohl Reasoning- als auch Finalantwort-Tokens umfasst. Wiederholter Prompt-Text erhält nur dann den niedrigeren Tarif, wenn der Dienst einen qualifizierenden Cache-Treffer meldet; die sichtbare Antwortlänge allein unterschätzt die abrechenbare Ausgabe.
Beispielhafte Kostenkalkulationen
API-Workload
Uncached input
Cached input
Output
Geschätzte Kosten
Kurze analytische Anfrage
10K
0
5K
$0.0235
Mittlerer Coding-Workflow
100K
0
20K
$0.154
Wiederholte Agenten-Anfrage
10K
90K
20K
$0.073
Große Dokumentenanalyse
500K
0
30K
$0.581
Langkontext-Caching-Workflow
100K
400K
50K
$0.275
Kostenformel: C = (Tu × Pu + Tc × Pc + To × Po) / 1.000.000, wobei Tu/Tc/To ungecachte Eingabe, gecachte Eingabe und abrechenbare Ausgabe-Tokens darstellen und Pu/Pc/Po deren Preise pro einer Million Tokens sind.
Betrachten Sie zwei StepFun-Anfragen mit jeweils 100.000 Eingabetokens und 20.000 abrechenbaren Ausgabetokens:
Cache-Miss: Alle 100.000 Eingabetokens sind ungecacht. Kosten = (100.000 × $1,00 + 20.000 × $2,70) / 1.000.000 = $0,154.
Cache-Hit: 90.000 Eingabetokens qualifizieren für den gecachten Tarif und 10.000 bleiben ungecacht. Kosten = (10.000 × $1,00 + 90.000 × $0,10 + 20.000 × $2,70) / 1.000.000 = $0,073.
Das Cache-Hit-Beispiel spart $0,081 bzw. ca. 52,6% bei gleichem Ein- und Ausgabevolumen. Die Ersparnis hängt von einem qualifizierenden Cache-Treffer des Dienstes ab. Beide Beispiele schließen externe Tools, Retries und Infrastrukturkosten aus.
Tokenpreise allein bestimmen nicht das Modell mit dem besten Wert. Ein Agent, der mehrere Retries benötigt, kann teurer sein als ein höher bepreistes Modell, das beim ersten Versuch erfolgreich ist. Für einen verlässlichen Kostenvergleich sollten Kosten pro erfolgreich abgeschlossener Aufgabe neben den Tokenpreisen verwendet werden.
Ist Step 5 Preview Open Source, und kann es lokal laufen?
StepFun veröffentlicht herunterladbare Gewichte über die offiziellen Hugging Face-Repositories, mit FP8-, BF16- und NVFP4-Varianten (Stand: 19. Oktober 2026). Der Zugang zu Gewichten ermöglicht Self-Deployment, macht das Modell aber nicht hinsichtlich Speicheranforderungen einem kleinen dichten Modell gleichwertig.
Verfügbare Dateien umfassen den Step 5 Preview-Checkpoint, die BF16-Version und die NVFP4-Version.
Die Terminologie ist wichtig: Step 5 Preview bietet open weights unter der StepFun Model License 1.0. Die Lizenz umfasst modellbezogene Attribution und kommerzielle Lizenzbedingungen. Prüfen Sie diese Bedingungen für Ihre geplante Nutzung und Distribution vor der Bereitstellung.
Anforderungen für lokale Bereitstellung
Die offizielle Modellkarte führt diese Referenzkonfigurationen auf:
FP8 mit vLLM: 4 × NVIDIA B300 oder 8 × NVIDIA H200, Bereitstellung einer OpenAI-kompatiblen API.
BF16 mit vLLM: 8 × NVIDIA B300 oder 16 × NVIDIA H200, Bereitstellung einer OpenAI-kompatiblen API.
FP8 mit SGLang: 4 × NVIDIA B300, Bereitstellung einer OpenAI-kompatiblen API; FP8 mit Transformers: 8 × NVIDIA H200 für Offline-Generierung.
Dies sind Referenzkonfigurationen, keine Mindestgarantien für jeden Checkpoint, jede Laufzeit, Kontextlänge oder Parallelitätseinstellung. Sparse Aktivierung reduziert Rechenaufwand, aber Expert-Gewichtsspeicher und KV-Cache bleiben wesentliche Faktoren.
Ein 600B-Modell bringt zudem Herausforderungen jenseits der Speicherkapazität mit sich, darunter Multi-GPU-Kommunikation, Framework-Kompatibilität, Checkpoint-Laden und Durchsatz bei langen Kontexten. Für Teams ohne große GPU-Cluster ist eine gehostete API meist der praktischere Einstieg.
Wie können Entwickler die Step 5 Preview API nutzen?
StepFun unterstützt eine OpenAI-kompatible Chat Completions-Schnittstelle. Setzen Sie STEPFUN_API_KEY in der Umgebung, bevor Sie das folgende Python-Beispiel ausführen; max_tokens begrenzt die generierte Ausgabe dieser Anfrage. Nutzen Sie den API-Schlüssel und die Abrechnungsbedingungen der gewählten regionalen Plattform: Dieses Beispiel behält den Endpunkt api.stepfun.ai bei, während die Dollarpreise oben von StepFuns internationaler Plattform stammen.
Python-Beispiel: Senden Sie eine begrenzte Textanfrage an die StepFun-API und drucken Sie die zurückgegebene Antwort aus.
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["STEPFUN_API_KEY"],
    base_url="https://api.stepfun.ai/v1",
)
response = client.chat.completions.create(
    model="step-5-preview",
    messages=[{
        "role": "user",
        "content": (
            "Analysieren Sie die architektonischen Risiken der Migration "
            "einer monolithischen Anwendung auf Microservices."
        ),
    }],
    max_tokens=4000,
)
print(response.choices[0].message.content)
Vor dem Produktiveinsatz sollten die akzeptierten Parameter und Generationslimits des gewählten StepFun-Endpunkts bestätigt werden. Reasoning-Aufwand, Prompt-Caching, Tool-Schemata und Ausgabebudgets können Zuverlässigkeit, Latenz und die endgültige Rechnung beeinflussen.
Step 5 Preview in Agent-Workflows
Repository-Dokumentation und relevante Dateien lesen.
Die angeforderte Änderung identifizieren und einen Plan vorschlagen.
Ausgewählten Code ändern und Tests über externe Tools ausführen.
Fehler analysieren und die Implementierung überarbeiten.
Eine abschließende Erklärung der validierten Änderungen erstellen.
Das Modell generiert Reasoning und Tool-Anfragen; die Anwendung stellt tatsächlichen Dateizugriff, Ausführungsumgebungen, Berechtigungen und Sicherheitsprüfungen bereit. Modellfähigkeit allein garantiert keine autonome Ausführung.
Alternative Modell-APIs in CometAPI
CometAPI bietet über einen gemeinsamen Integrationsdienst Zugriff auf die oben verlinkten Alternativmodelle. Wählen Sie den dokumentierten Endpunkt und das Anfrageformat jedes Modells und vergleichen Sie Erfolgsraten, Tokenverbrauch, Retries und End-to-End-Latenz im gleichen Workload.
Das obige Beispiel nutzt StepFuns nativen Endpunkt. Der Wechsel zu einem Gateway erfordert bestätigte Verfügbarkeit von Step 5 Preview und die dokumentierte Modellkennung, den Endpunkt und die Abrechnungsbedingungen des Gateways.
Wann sollten Sie Step 5 Preview wählen?
Wählen Sie es für Repository-Coding und dokumentenintensive Recherche, wenn repräsentative Tests zuverlässige Ergebnisse bestätigen. Der lange Kontext und die veröffentlichten Coding- und Finance-Scores machen es zu einem Kandidaten, während Terminal-Aufgaben und Bewertungsresultate zeigen, warum aufgabenspezifische Tests wichtig sind.
Wählen Sie die gehostete API, wenn Sie ohne Betrieb eines großen GPU-Clusters starten möchten. Vergleichen Sie Kosten pro akzeptierter Aufgabe, Cache-Trefferquoten, Retries und Latenz; ein großes Kontextfenster garantiert weder schnelle Antworten noch niedrigere Gesamtkosten.
Wählen Sie Self-Hosting, wenn Bereitstellungskontrolle die Hardware- und Betriebsaufwände rechtfertigt. Planen Sie Speicher für vollständige Expert-Gewichte, KV-Cache, Multi-GPU-Kommunikation und Lizenzanforderungen ein. Für folgenreiche Finanz- oder Ingenieurarbeit gehören Quellenprüfungen, Fehlererkennung und menschliche Reviews dazu.
FAQ
Wie sollten Sie den Reasoning-Aufwand von Step 5 Preview wählen?
Beginnen Sie mit einem kleinen Satz repräsentativer Aufgaben und vergleichen Sie low, medium und high anhand identischer Akzeptanzkriterien. Protokollieren Sie Korrektheit, abrechenbare Ausgabe, Latenz und Toolfehler. Nutzen Sie die niedrigste Einstellung, die konsistent die Qualitätsgrenze erfüllt; die veröffentlichten High-Benchmark-Scores sagen nicht das Verhalten von low oder medium voraus. Folgen Sie der Reasoning-Konfigurationsanleitung und setzen Sie reasoning_effort bei Chat Completions explizit, wenn Sie Konfigurationen vergleichen.
Warum kann eine Step 5 Preview-Anfrage vor 64k Ausgabetokens stoppen?
Der dokumentierte Maximalwert ist eine Obergrenze, kein Ziel. Eine Anfrage kann früher stoppen, weil sie ihr max_tokens-Budget erreicht, einen natürlichen Stopp zurückgibt oder einen Toolaufruf erzeugt, den die Anwendung handhaben muss. Prüfen Sie die zurückgegebene Abschlussursache (finish reason) und etwaige Tool-Anfragen, bevor Sie automatisch erneut versuchen. Eine kürzere abgeschlossene Antwort weist nicht auf ein Kontextfensterproblem hin.
Wie sollten Sie Videoeingaben für Step 5 Preview testen?
Beginnen Sie mit einem kurzen, repräsentativen Clip und einer Frage, deren Antwort Sie verifizieren können. Die Spezifikation der gehosteten API akzeptiert Video per URL, Base64 oder über eine stepfile-Referenz; dokumentierte Formate umfassen MP4, QuickTime und Matroska. Für URL-Eingaben spezifiziert die Dokumentation einzelne MP4-Dateien unter 128 MB und empfiehlt weniger als fünf Minuten. Bestätigen Sie Format- und Größenlimits vor dem Batching und testen Sie zeitliche Fragen ebenso wie Einzelbild-Erkennung.
Welche Metriken zeigen die realen Agentenkosten von Step 5 Preview?
Messen Sie akzeptierte Aufgabenabschlüsse, gesamte Ein- und Ausgabetokens über alle Turns, Cache-Treffer, Retries, externe Toolkosten und verstrichene Zeit. Teilen Sie die Gesamtlaufkosten durch die erfolgreichen Abschlüsse, wobei das Erfolgskriterium über Modelle hinweg konstant bleibt. So erfassen Sie den wirtschaftlichen Effekt eines günstigeren Aufrufs mit mehr Versuchen oder eines höheren Aufwands, der spätere Fehlschläge reduziert.
Fazit
Step 5 Preview ist eine Evaluierung wert, wenn eine Anwendung Long-Context-Verarbeitung, wiederholte Toolnutzung oder Kontrolle über die Modellbereitstellung benötigt. StepFuns veröffentlichte Ergebnisse machen es zu einem Kandidaten für Repository-Coding und Finanzforschung, während Terminal-Bench v4 und CorporateValuation Bereiche aufzeigen, in denen gelistete Alternativen höher punkten. Vergleichen Sie Modelle anhand fixer Akzeptanzkriterien, Gesamtkosten pro akzeptierter Aufgabe und End-to-End-Latenz. Beim Self-Hosting sollten Infrastrukturkosten und Lizenzanforderungen in die Entscheidung einfließen.
Offizielle FP8-, BF16- und NVFP4-Repositories verfügbar