Especificaciones técnicas de MiniMax M3.1-Flash
| Elemento | MiniMax M3.1-Flash |
|---|---|
| ID del modelo | MiniMax-M3.1-Flash |
| Familia de modelos | Serie MiniMax M3.1, modelo de codificación |
| Fecha de lanzamiento | 27 de septiembre de 2026 |
| Enfoque principal | Desarrollo de software cotidiano, desde correcciones de errores hasta entrega completa de funciones |
| Ventana de contexto | 1,000,000 tokens |
| Modalidades de entrada | Texto, imagen y video |
| Modalidad de salida | Texto |
| Control de razonamiento | reasoning_effort: low, medium, high, xhigh, max |
| Comportamiento del razonamiento | Se requiere pensamiento adaptativo; la documentación pública revisada no admite desactivar el pensamiento |
| Salida máxima | No se publica por separado en los materiales públicos revisados |
| Número de parámetros | No divulgado públicamente |
| Pesos abiertos | No se identificó un checkpoint/repositorio de modelo público |
MiniMax anunció M3.1-Flash para MiniMax Code el 27 de septiembre de 2026, posicionándolo en torno a tareas de desarrollo cotidianas como la corrección de errores y la entrega completa de funcionalidades. La cobertura pública actual identifica de forma consistente una ventana de contexto de 1M tokens y un esfuerzo de razonamiento ajustable, señalando que no se han publicado una tabla de benchmarks independiente ni el precio por token.
¿Qué es MiniMax M3.1-Flash?
MiniMax M3.1-Flash es un modelo de texto orientado a la codificación, diseñado para flujos de trabajo de desarrollo de software iterativos en lugar de solo generación de código. MiniMax describe el flujo como abarcando la comprensión de requisitos, la localización de problemas, la implementación, las pruebas de regresión y la verificación de cambios frente a la funcionalidad existente.
Sus controles documentados distintivos son su largo contexto y una escalera de esfuerzo de razonamiento de cinco niveles. Los niveles disponibles son low, medium, high, xhigh y max, lo que permite a los desarrolladores equilibrar la profundidad de razonamiento y la latencia según la complejidad de la tarea.
Características principales de MiniMax M3.1-Flash
- Contexto de 1M tokens: La descripción publicada del modelo le otorga una ventana de contexto de un millón de tokens, lo que lo hace adecuado para grandes repositorios, especificaciones extensas y sesiones prolongadas de agentes de codificación.
- Entrada multimodal nativa: Las descripciones públicas del modelo enumeran texto, imagen y video como entradas, mientras que el modelo devuelve texto.
- Cinco niveles de esfuerzo de razonamiento:
low,medium,high,xhighymaxproporcionan un control más fino sobre la profundidad del razonamiento que un simple interruptor de pensamiento activado/desactivado. - Flujo de trabajo de codificación de extremo a extremo: MiniMax posiciona específicamente el modelo para la localización de errores, implementación, manejo de casos límite, finalización de pruebas de regresión y validación de cambios.
- Despliegue orientado: El lanzamiento público inicial es a través de MiniMax Code y Token Plan, en lugar de una oferta de modelo independiente de pago por uso con documentación completa.
- Adecuación para agentes de codificación: El modelo está pensado para interacciones de desarrollo repetidas donde el contexto del repositorio, la salida de herramientas, las pruebas y las correcciones iterativas importan más que la generación de código de una sola vez.
MiniMax M3.1-Flash frente a otros modelos de codificación de MiniMax
| Modelo | Enfoque | Contexto | Datos de benchmark públicos | Acceso/estado |
|---|---|---|---|---|
| M3.1-Flash | Programación cotidiana, desarrollo iterativo | 1M | Aún no publicado | MiniMax Code / Token Plan |
| M3 | Programación de frontera + trabajo basado en agentes, multimodalidad nativa | Hasta 1M | Publicado por MiniMax | API, Token Plan, MiniMax Code |
| M2.7 | Ingeniería de software + trabajo amplio de agentes/productividad | No se usa aquí como una especificación copiada de M3.1 | Publicado por MiniMax | API, Token Plan, Agent |
M3 es el punto de referencia mejor documentado: MiniMax publica su arquitectura, metodología de evaluación de codificación/agentes y disponibilidad de API. M2.7 también cuenta con un registro público de benchmarks e integración de API. M3.1-Flash es más nuevo y actualmente tiene una huella de documentación pública más estrecha, por lo que las comparaciones deben centrarse en el posicionamiento documentado en lugar de afirmar un ganador en benchmarks. 4
Casos de uso representativos
- Corrección de errores a escala de repositorio: Proporcione al modelo una base de código grande, la descripción del problema, registros y pruebas, y use su amplio contexto para preservar el contexto relevante del proyecto.
- Implementación de funcionalidades: Use el modelo para pasar de un requisito en lenguaje natural a cambios de código y pruebas de regresión.
- Revisión y remediación de código: Pídale que identifique casos límite, proponga parches y verifique que los cambios no rompan el comportamiento existente.
- Depuración multimodal: Proporcione capturas de pantalla, diagramas o video junto con requisitos textuales cuando el contexto visual sea parte del problema de ingeniería.
- Sesiones de agentes de codificación de larga duración: Use la gran ventana de contexto para especificaciones, archivos del repositorio, salida de terminal y resultados de pruebas iterativas.
- Desarrollo sensible a la velocidad: Seleccione un nivel de esfuerzo de razonamiento más bajo para ediciones rutinarias y aumente el esfuerzo para cambios más complejos de múltiples pasos.
Cómo acceder a la API de MiniMax M3.1-Flash
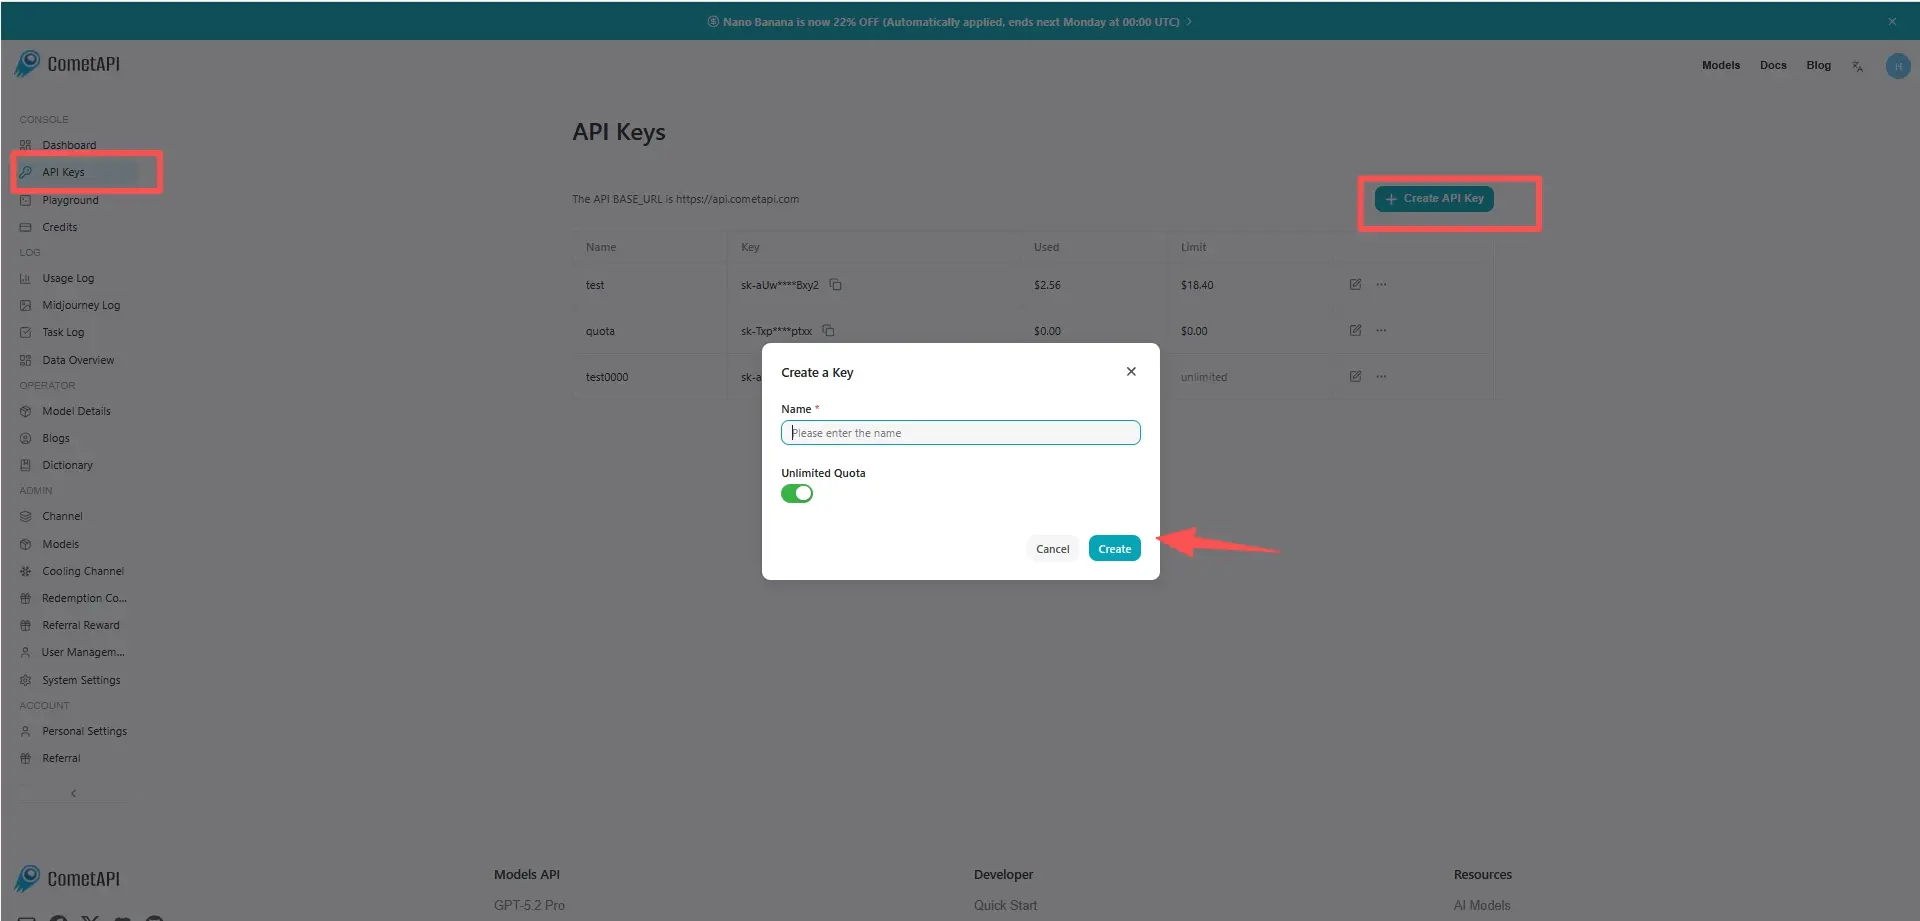
Paso 1: Registrarse para obtener la clave de API
Inicie sesión en cometapi.com. Si aún no es nuestro usuario, regístrese primero. Inicie sesión en su consola de CometAPI. Obtenga la clave de API de credenciales de acceso de la interfaz. Haga clic en “Add Token” en el token de API en el centro personal, obtenga la clave del token: sk-xxxxx y envíe.
Paso 2: Enviar solicitudes a la API de MiniMax M3.1-Flash
Seleccione el endpoint “minimax-m3.1-flash” para enviar la solicitud de API y establezca el cuerpo de la solicitud. El método y el cuerpo de la solicitud se obtienen de la documentación de API de nuestro sitio web. Nuestro sitio también proporciona pruebas en Apifox para su comodidad. Reemplace <YOUR_API_KEY> con su clave real de CometAPI de su cuenta. la URL base es Chat Completions.
Inserte su pregunta o solicitud en el campo content—esto es a lo que responderá el modelo. Procese la respuesta de la API para obtener la respuesta generada.
Paso 3: Recuperar y verificar resultados
Procese la respuesta de la API para obtener la respuesta generada. Después del procesamiento, la API responde con el estado de la tarea y los datos de salida.