
TL;DR : Quelle alternative à l’API GPT-6 Astra choisir ?
Choisissez le modèle en fonction de la charge de travail : Claude Opus 5 pour le substitut premium le plus proche, Claude Fable 5.1 pour le raisonnement soutenu le plus difficile, GPT-5.6 Sol pour une migration OpenAI à faible friction, Claude Sonnet 5 pour la production à haut volume, Gemini 3.8 Flash pour des travaux multimodaux à faible coût, et DeepSeek V4.1 Flash lorsque le coût en jetons est la contrainte principale.
Conservez GPT-6 Astra pour les charges où sa meilleure utilisation de l’ordinateur, l’exécution autonome, le raisonnement scientifique ou les performances en cybersécurité réduisent sensiblement les réessais et l’intervention humaine.
Points clés : Que faut-il considérer en remplaçant GPT-6 Astra ?
- GPT-6 Astra est difficile à remplacer sur ses tâches agentiques les plus fortes. Le tableau de référence officiel de GPT-6 Astra enregistre 57,9 % sur Terminal-Bench 4.0, 97,6 % sur FrontierMath Tier 4 et 96,0 % sur GPQA Diamond.
- Claude Opus 5 est l’alternative directe la plus équilibrée à tester en premier. Anthropic facture Opus 5 à 5 $/25 $ par million de jetons entrée/sortie, soit la moitié des tarifs de base d’Astra.
- Claude Fable 5.1 n’est pas une alternative économique. Sa tarification 10 $/50 $ à l’entrée/sortie correspond au tarif d’Astra, tandis que certaines évaluations de connaissances et de raisonnement long favorisent Fable 5.1.
- GPT-5.6 Sol est la rétrogradation la plus simple plutôt qu’un véritable changement de plateforme. La fenêtre de contexte 1,05 M, la sortie maximale 128 K et la tarification 4 $/20 $ réduisent la friction de migration pour les applications OpenAI.
- Gemini 3.8 Flash offre un bon rapport prix/performance hébergé. Son tarif d’introduction 2026 est de 0,75 $/3,75 $ par million de jetons entrée/sortie.
- DeepSeek V4 Flash appartient à une autre classe de coûts. Ses tarifs officiels en heures pleines et creuses sont bien inférieurs à ceux des modèles premium, mais un coût en jetons plus bas n’établit pas des taux de réussite agentiques équivalents.
- La meilleure métrique de production est généralement le coût par tâche acceptée et terminée. Incluez les réessais, échecs d’outils, latence, usage de jetons de sortie et retravail humain.
Qu’est-ce que l’API GPT-6 Astra ?
OpenAI positionne GPT-6 Astra comme son modèle phare pour les travaux complexes de bout en bout. La spécification de l’API inclut une fenêtre de contexte de 1 050 000 jetons et une sortie maximale de 128 000 jetons, des entrées texte et image, la prise en charge de jetons de raisonnement, et cinq niveaux d’effort de raisonnement : low, medium, high, xhigh et max.
Astra diffère d’un chatbot conventionnel car il est conçu pour une exécution longue durée. La vue d’ensemble officielle des capacités met en avant l’utilisation de l’ordinateur et le travail professionnel, ainsi que l’ingénierie logicielle, la navigation, la science, la cybersécurité et le raisonnement complexe.
| Spécification GPT-6 Astra | Valeur |
|---|---|
| ID du modèle API | gpt-6-astra |
| Fournisseur | OpenAI |
| Fenêtre de contexte | 1 050 000 jetons |
| Sortie maximale | 128 000 jetons |
| Entrée | Texte, images |
| Sortie | Texte |
| Coupure de connaissances | 30 avril 2026 |
| Effort de raisonnement | Low, medium, high, xhigh, max |
| Prix standard à l’entrée | 10 $ / 1 M jetons |
| Entrée mise en cache | 1 $ / 1 M jetons |
| Prix standard à la sortie | 50 $ / 1 M jetons |
| Seuil long-contexte | Plus de 272K jetons d’entrée |
Note sur la tarification long-contexte :
les requêtes dépassant 272K jetons d’entrée
sont reproportionnées pour toute la requête à 20 $/M à l’entrée et 75 $/M à la sortie. Budgétez ces requêtes séparément.
Pourquoi les équipes regardent au-delà de GPT-6 Astra
Astra est plus convaincant lorsque ses capacités supplémentaires éliminent les tentatives échouées, les erreurs d’outils, l’intervention manuelle ou des appels répétés à des modèles plus faibles. Son tarif premium est plus difficile à justifier pour la synthèse, l’extraction, la classification, la RAG de routine, la conversation ordinaire et la génération de code standard.
Les équipes évaluent donc des alternatives pour réduire les coûts, rester dans un écosystème fournisseur existant, améliorer l’économie du cache, ajouter le multimodal, ou utiliser un modèle plus rapide pour le trafic de routine tout en réservant Astra pour l’escalade.
Comparaison des benchmarks et limites
Note de preuve : le tableau utilise le cadre de comparaison publié par OpenAI pour placer plusieurs alternatives dans une configuration commune. Ces scores fournis par les vendeurs peuvent évoluer avec les snapshots de modèles, les prompts, les outils et la méthodologie d’évaluation ; utilisez-les pour présélectionner des candidats, puis validez les finalistes sur des tâches de production représentatives.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 57,9 % | 37,3 % | 55,8 % | 52,6 % | 19,1 % |
| DeepSWE v1.1 | 74,1 % | 72,7 % | 67,4 % | 73,7 % | 73,8 % |
| FrontierCode 1.1 Extended | 64,5 % | 60,6 % | 63,6 % | 63,6 % | 56,3 % |
| GPQA Diamond | 96,0 % | 94,6 % | 93,7 % | 93,7 % | 95,3 % |
| FrontierMath Tier 4 | 97,6 % | 83,0 % | 87,8 % | 73,2 % | — |
| Humanity’s Last Exam, with tools | 57,2 % | — | 65,0 % | 63,6 % | — |
Les résultats montrent pourquoi appeler un modèle « remplacement universel d’Astra » est trompeur. Astra possède une avance nette sur plusieurs évaluations agentiques et scientifiques, tandis que Fable 5.1 fait mieux sur Humanity’s Last Exam et que plusieurs alternatives restent très proches sur DeepSWE.
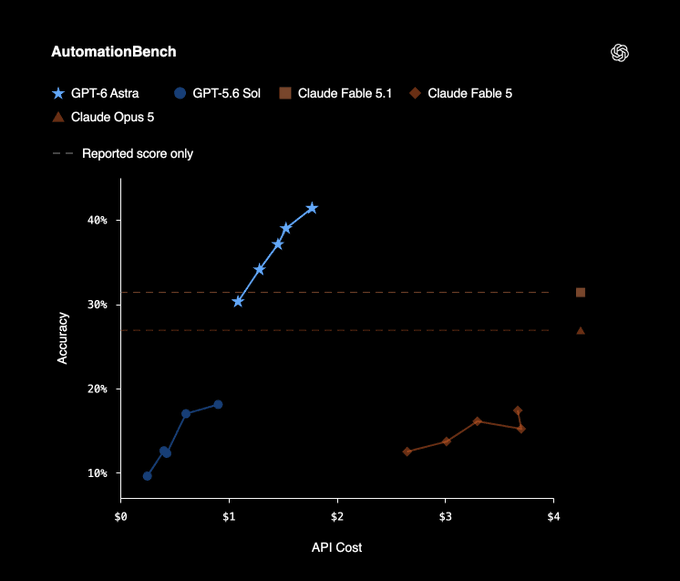
Graphique officiel du benchmark OpenAI AutomationBench.
Les index de benchmarks publics peuvent également évoluer à mesure que la méthodologie et les snapshots de modèles sont révisés. Utilisez-les pour établir une présélection, pas comme substitut à une évaluation spécifique à la charge de travail.
Alternatives à GPT-6 Astra
Aucun modèle ne remplace Astra sur toutes les charges. Le choix le plus pragmatique dépend des capacités dont vous avez besoin, de l’écosystème fournisseur que vous utilisez déjà et du coût des exécutions échouées ou répétées.
| Alternative | Prix officiel entrée/sortie par 1M jetons | Contexte | Meilleure raison de le choisir |
|---|---|---|---|
| Claude Opus 5 | 5 $ / 25 $ | 1M | Substitut premium global le plus proche |
| Claude Fable 5.1 | 10 $ / 50 $ | 1M | Raisonnement le plus difficile et agents longs |
| GPT-5.6 Sol | 4 $ / 20 $ | 1,05M | Migration OpenAI à plus faible friction |
| Claude Sonnet 5 | 2 $ / 10 $ | 1M | Travaux de production à haut volume |
| Gemini 3.8 Flash | 0,75 $ / 3,75 $ promotionnel | 1M | Multimodal à bas coût et charges par lots |
| DeepSeek V4.1 Flash | 0,22–0,44 $ / 0,66–1,32 $ | 1M | Coût en jetons le plus bas et traitement massif |
Claude Opus 5
Pourquoi le considérer
Claude Opus 5 est la première alternative à tester lorsqu’un produit a besoin de performances premium en raisonnement, codage ou travail professionnel à un prix catalogue inférieur à celui d’Astra.
Prix, contexte et cache
Anthropic annonce Claude Opus 5 à 5 $/M à l’entrée et 25 $/M à la sortie avec une fenêtre de contexte de 1 M de jetons. Confirmez les conditions de cache actuelles avant la budgétisation en production.
Où il performe bien
Il est compétitif en codage, analyse, rédaction professionnelle et workflows d’agents ; le tableau de benchmarks cité le place proche d’Astra sur DeepSWE et FrontierCode.
Limites
Il ne surpasse pas Astra de manière cohérente. Astra reste un meilleur candidat lorsque l’opération de l’ordinateur, l’exécution autonome avancée, la cybersécurité ou les outils natifs OpenAI sont au cœur du produit.
À privilégier / À éviter
À privilégier : agents premium de codage, analyse complexe et rédaction professionnelle. À éviter : si le workflow dépend fortement des outils spécifiques à Astra ou de sa capacité d’utilisation de l’ordinateur.
Claude Fable 5.1
Pourquoi le considérer
Claude Fable 5.1 est un modèle phare concurrent pour le raisonnement le plus difficile, la recherche, le codage et les agents longue durée, plutôt qu’un remplacement à faible coût.
Prix, contexte et cache
Ses tarifs 10 $/M à l’entrée et 50 $/M à la sortie correspondent au tarif d’Astra. La fenêtre de contexte de 1 M et un prix de lecture du cache de 0,25 $/M peuvent améliorer l’économie lorsque de grands prompts sont fréquemment réutilisés.
Où il performe bien
Il est particulièrement attractif pour le raisonnement soutenu et les agents fortement dépendants du cache ; dans la comparaison citée, il devance Astra sur Humanity’s Last Exam avec outils.
Limites
Il ne réduit pas le tarif standard par jeton, et Astra conserve des avantages sur plusieurs benchmarks agentiques et scientifiques ainsi que sur l’outillage natif OpenAI.
À privilégier / À éviter
À privilégier : qualité de raisonnement maximale et workflows longue-contexte répétés. À éviter : lorsque l’objectif principal est une forte réduction du prix standard par jeton.
GPT-5.6 Sol
Pourquoi le considérer
GPT-5.6 Sol offre la migration la plus simple pour les applications déjà construites autour du comportement et des outils compatibles OpenAI.
Prix, contexte et cache
La spécification citée liste 4 $/M à l’entrée et 20 $/M à la sortie, une fenêtre de contexte de 1,05 M et une sortie maximale de 128 K. Vérifiez les conditions actuelles d’entrée mise en cache avant la budgétisation finale.
Où il performe bien
Il reste proche d’Astra sur DeepSWE et GPQA Diamond tout en coûtant sensiblement moins dans le palier standard court-contexte.
Limites
L’écart se creuse sur les tâches représentées par Terminal-Bench et FrontierMath, de sorte que les économies peuvent disparaître si un taux d’achèvement plus faible entraîne des réessais ou des corrections manuelles.
À privilégier / À éviter
À privilégier : applications OpenAI existantes et charges générales qui n’ont pas besoin des capacités agentiques les plus fortes d’Astra. À éviter : lorsque la charge de travail bénéficie régulièrement des gains importants d’Astra sur les benchmarks.
Claude Sonnet 5
Pourquoi le considérer
Claude Sonnet 5 est un choix de production pragmatique pour un travail de connaissance compétent et répétable, ne nécessitant pas un modèle de pointe à chaque requête.
Prix, contexte et cache
Son tarif permanent cité est de 2 $/M à l’entrée et 10 $/M à la sortie avec une fenêtre de contexte de 1 M de jetons. Confirmez les conditions actuelles du cache pour les déploiements à forte réutilisation de prompts.
Où il performe bien
Il convient à la classification de tickets, l’extraction de documents, la RAG standard, la transformation de contenu, l’explication de code, l’appel de fonctions de routine et la génération structurée.
Limites
Il ne peut pas remplacer de manière fiable Astra sur chaque problème de raisonnement long-horizon ou de frontière.
À privilégier / À éviter
À privilégier : trafic de production à haut volume et automatisation métier de routine. À éviter : lorsque l’échec sur une tâche agentique difficile coûte plus cher que la prime d’un modèle phare.
Gemini 3.8 Flash
Pourquoi le considérer
Gemini 3.8 Flash combine entrée multimodale, grand contexte et faible coût d’API hébergée pour les documents, médias, codage et pipelines par lots.
Prix, contexte et cache
Le tarif d’introduction cité est de 0,75 $/M à l’entrée et 3,75 $/M à la sortie jusqu’au 31 décembre 2026, avec une fenêtre de contexte de 1 M et un cache à prix réduit pendant la période promotionnelle.
Où il performe bien
Il est bien adapté à l’extraction multimodale, aux PDF, audio, vidéo, images, grandes collections de documents, analyses par lots et charges de codage sensibles au coût.
Limites
La tarification promotionnelle est limitée dans le temps, et les tâches agentiques ou d’utilisation de l’ordinateur les plus difficiles nécessitent encore une validation spécifique à la charge par rapport à Astra.
À privilégier / À éviter
À privilégier : traitement multimodal à bas coût et par lots à grand volume. À éviter : lorsque l’application exige la meilleure exécution autonome indépendamment du coût en jetons.
DeepSeek V4.1 Flash
Pourquoi le considérer
DeepSeek V4.1 Flash est l’option orientée coût pour le raisonnement, le codage, la synthèse, l’extraction, la classification et le traitement hors ligne à haut débit.
Prix, contexte et cache
Le calendrier heures pleines/creuses cité liste l’entrée en cache à 0,007–0,014 $/M, l’entrée hors cache à 0,22–0,44 $/M, et la sortie à 0,66–1,32 $/M, avec une fenêtre de contexte de 1 M de jetons. Vérifiez la page de tarification V4.1 actuelle avant publication.
Où il performe bien
Il est attractif lorsque le coût en jetons domine et que l’application peut utiliser le routage, la validation ou des contrôles de qualité hors ligne pour gérer la variabilité.
Limites
Un prix de jeton beaucoup plus bas n’établit pas un succès autonome équivalent. La fiabilité, le comportement des outils, la latence et le taux d’acceptation doivent être mesurés sur la charge ciblée.
À privilégier / À éviter
À privilégier : traitement à grande échelle et sensible au coût avec validation. À éviter : lorsqu’un échec sur une exécution autonome à forte valeur dépasserait les économies de jetons.
GPT-6 Astra vs alternatives : Quel modèle gagne dans chaque catégorie ?
En combinant tarification, architecture, contexte et preuves de benchmarks, on obtient un tableau de décision plus utile que de classer les modèles de premier à sixième.
| Catégorie | Meilleur choix | Pourquoi |
|---|---|---|
| Alternative globale à Astra | Claude Opus 5 | Performances proches de la frontière à la moitié du prix |
| Raisonnement maximal | Claude Fable 5.1 | Raisonnement phare et performances long-horizon solides |
| Rester dans OpenAI | GPT-5.6 Sol | Écosystème API similaire avec des prix 60 % plus bas |
| Production à haut volume | Claude Sonnet 5 | Qualité élevée à 2 $/10 $ |
| Prix/performance multimodal | Gemini 3.8 Flash | Contexte 1M plus tarif d’introduction 2026 très bas |
| Coût d’API le plus bas | DeepSeek V4.1 Flash | 0,22–0,44 $ entrée et 0,66–1,32 $ sortie |
| Agents fortement orientés usage ordinateur | GPT-6 Astra | L’un des points de différenciation les plus clairs d’Astra |
| Flux scientifiques et mathématiques difficiles | GPT-6 Astra | Résultats très forts sur FrontierMath et agents scientifiques |
| Agents longs fortement dépendants du cache | Claude Fable 5.1 | Lectures de cache à 0,25 $/M |
Le résultat le plus important est que GPT-6 Astra gagne encore certaines catégories. Un article sur les alternatives ne devrait pas laisser entendre qu’un modèle moins cher le remplace universellement. Astra devient coûteux lorsqu’il est déployé partout ; il peut rester économique lorsque son taux d’achèvement plus élevé remplace plusieurs tentatives de modèles plus faibles.
Combien pouvez-vous réellement économiser en remplaçant l’API GPT-6 Astra ?
Considérez une charge consommant 1 million de jetons d’entrée non mis en cache et 200 000 jetons de sortie. En ignorant les remises de cache, frais d’outils, réessais, tarification par lots et surcharges long-contexte :
| Modèle | Coût API approximatif |
|---|---|
| GPT-6 Astra | 20,00 $ |
| Claude Fable 5.1 | 20,00 $ |
| Claude Opus 5 | 10,00 $ |
| GPT-5.6 Sol | 8,00 $ |
| Claude Sonnet 5 | 4,00 $ |
| Taux promotionnel Gemini 3.8 Flash | 1,50 $ |
| DeepSeek V4.1 Flash heures creuses | 0,35 $ |
Le calcul de base est :
total_cost =
(input_tokens / 1,000,000 * input_rate)
+
(output_tokens / 1,000,000 * output_rate)
Cet exemple simple montre aussi pourquoi le prix par jeton ne peut pas être la seule métrique. Si une requête Astra à 20 $ réussit du premier coup tandis qu’un modèle à 4 $ nécessite six tentatives, plusieurs réessais d’outils et une correction humaine, Astra était en réalité moins cher.
Une meilleure métrique de production est :
cost_per_accepted_task =
total_model_and_tool_cost
/
number_of_tasks_accepted_without_rework
Suivez ce nombre en parallèle de la latence, du succès des tâches, du taux de réessai, des erreurs d’appels d’outils et du taux d’escalade vers un humain.
Comment tester des alternatives à GPT-6 Astra via CometAPI ?
Un avantage pratique d’une couche d’API multi-modèles est que l’évaluation n’a pas besoin de devenir un projet d’intégration fournisseur. CometAPI fournit GPT-6 Astra API, GPT-5.6, Claude Fable 5.1, Claude Sonnet 5, Gemini 3.8 Flash et DeepSeek V4.1 Flash via un seul catalogue de modèles.
Avec un client compatible OpenAI, le modèle peut être rendu configurable plutôt que codé en dur :
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

model = "claude-fable-5-1"

response = client.chat.completions.create(
    model=model,
    messages=[
        {
            "role": "user",
            "content": "Review this migration plan and identify the three highest-risk assumptions.",
        }
    ],
)

print(response.choices[0].message.content)
Vous pouvez relancer le même ensemble d’évaluations en utilisant des IDs de modèle tels que :
gpt-6-astra
gpt-5.6
claude-fable-5-1
claude-sonnet-5
gemini-3.8-flash
deepseek-v4-flash
C’est généralement plus instructif que de choisir une alternative uniquement depuis un classement de benchmarks. Prenez 100–500 prompts de production représentatifs et enregistrez le succès des tâches, l’acceptation humaine, les réessais, les erreurs d’outils, le total de jetons, la latence et le coût total d’API.
Faut-il remplacer GPT-6 Astra par un seul modèle ou utiliser du routage de modèle ?
Pour de nombreuses applications, remplacer Astra par un modèle universel est une mauvaise optimisation. Une architecture plus efficace ressemble à ceci :
- Trafic de routine → Claude Sonnet 5, Gemini 3.8 Flash ou DeepSeek V4.1 Flash
- Raisonnement difficile → Claude Opus 5 ou GPT-5.6 Sol
- Tâches très difficiles et long-horizon → Claude Fable 5.1 ou GPT-6 Astra
- Workflows d’agents orientés usage ordinateur ou spécifiques à Astra → GPT-6 Astra
Cela fait d’Astra un modèle d’escalade plutôt que le modèle par défaut. Si seulement 10 % des requêtes nécessitent réellement des performances d’agent de frontière, router 100 % du trafic via Astra revient à payer sa prime pour les 90 % restants.
Quelle alternative à l’API GPT-6 Astra choisir ?
Choisissez Claude Opus 5 si vous voulez l’équilibre global qualité/prix le plus proche.
Choisissez Claude Fable 5.1 si le raisonnement maximal compte plus que la réduction du prix par jeton.
Choisissez GPT-5.6 Sol si vous utilisez déjà OpenAI et souhaitez le plus petit changement d’intégration.
Choisissez Claude Sonnet 5 si la majorité de votre trafic de production correspond à un travail de connaissance compétent mais ordinaire.
Choisissez Gemini 3.8 Flash si le multimodal, l’échelle et le faible coût d’API hébergée sont importants.
Choisissez DeepSeek V4.1 Flash si le coût en jetons est la contrainte dominante et que votre charge peut tolérer davantage d’évaluation et de validation.
Et choisissez GPT-6 Astra lui-même quand votre application bénéficie réellement d’une meilleure utilisation de l’ordinateur, de travaux logiciels autonomes difficiles, de raisonnement scientifique ou d’autres capacités agentiques.
La principale erreur n’est pas de « mauvais » choix de modèle de frontière. C’est de payer le prix d’un modèle de frontière pour des requêtes qui n’en avaient pas besoin.
FAQ
Quel est le meilleur substitut global à l’API GPT-6 Astra ?
Claude Opus 5 est l’un des substituts polyvalents les plus solides. Il offre une fenêtre de contexte de 1 M, de fortes capacités en codage et agents, et un tarif catalogue de 5 $/25 $—la moitié des prix standard d’Astra.
Quelle est l’alternative la moins chère à GPT-6 Astra ?
Parmi les modèles couverts ici, DeepSeek V4.1 Flash présente le prix par jeton le plus bas en première partie. Son tarif actuel en heures creuses est de 0,22 $/M à l’entrée non mise en cache et 0,66 $/M à la sortie. Il ne faut toutefois pas supposer qu’il égale le succès des tâches autonomes d’Astra simplement parce qu’il est moins cher.
Claude Fable 5.1 est-il meilleur que GPT-6 Astra ?
Aucun des deux ne gagne toutes les charges. La comparaison d’OpenAI donne à Astra des avantages significatifs sur FrontierMath Tier 4 et Terminal-Bench 4.0, tandis que Fable 5.1 obtient de meilleurs scores sur Humanity’s Last Exam avec outils.
GPT-5.6 Sol vaut-il encore la peine d’être utilisé après GPT-6 Astra ?
Oui. Son tarif API standard de 4 $/20 $ est nettement inférieur au 10 $/50 $ d’Astra tout en conservant une fenêtre de contexte de 1,05 M. Il peut donc être un meilleur défaut pour les charges où les gains d’Astra n’améliorent pas sensiblement l’achèvement des tâches.
Gemini 3.8 Flash est-il suffisant pour remplacer GPT-6 Astra ?
Pour certains travaux de codage, multimodaux, documentaires et de traitement par lots, oui. Il est nettement moins cher et dispose d’une fenêtre de contexte de 1 M. Pour les tâches d’agent autonome les plus difficiles et l’utilisation de l’ordinateur, Astra reste le choix le plus solide.
GPT-6 Astra a-t-il un désavantage de prix pour des prompts très longs ?
Oui. OpenAI applique un palier de prix plus élevé lorsque l’entrée dépasse 272K jetons, donc les requêtes long-contexte doivent être budgétées séparément.
Dois-je comparer les modèles selon le prix par jeton ou les scores de benchmark ?
Utilisez les deux comme métriques de filtrage. La métrique de production la plus importante est généralement le coût par tâche acceptée et terminée, incluant les jetons de raisonnement, réessais, appels d’outils, latence et retravail humain.
Puis-je utiliser plusieurs alternatives à GPT-6 Astra dans la même application ?
Oui. Dans de nombreuses applications, le routage de modèle est préférable à l’engagement de chaque requête vers un seul modèle. Un modèle à faible coût peut traiter les requêtes de routine, tandis que des modèles plus puissants gèrent des escalades de difficulté croissante.