
TL;DR : DeepSeek-V4.1-Flash-1017 est une mise à jour mineure mais très impactante du 17 octobre 2026 du modèle V4.1-Flash de DeepSeek. Elle offre de meilleurs résultats sur les benchmarks de raisonnement, de code, d’agentivité et de vision, tout en produisant des sorties plus courtes et en accomplissant les tâches plus rapidement—repoussant la frontière de Pareto performance/coût.
Points clés
- DeepSeek-V4.1-Flash-1017 Publié le 17 octobre 2026 comme mise à niveau gratuite de l’endpoint API
deepseek-flashexistant—aucun changement de code requis pour les utilisateurs actuels. - Gains rapportés par le fournisseur sur l’ensemble des 11 benchmarks listés par rapport au V4.1-Flas de septembreh, avec les plus fortes hausses sur les tâches d’agentivité et de codage.
- Architecture : Mixture-of-Experts à 552B paramètres avec design Encodeur–Décodeur causal (≈8B paramètres actifs à l’entrée/préremplissage, 16B en décodage/génération) ; fenêtre de contexte de 1M tokens ; jusqu’à 384K tokens en sortie ; prise en charge native de la vision.
- Tarification inchangée : Off-peak $0.15 / $0.60 par 1M de tokens d’entrée (cache manqué) / de sortie (peak double ces tarifs) ; les hits de cache peuvent descendre jusqu’à $0.003. CometAPI est tarifé 20 % en dessous du tarif officiel.
- Nouvelles APIs Search & Fetch ouvertes à tous les développeurs ($0.75 par 1 000 appels ; gratuites via certains outils côté serveur jusqu’au 31 octobre 2026).
- Solides capacités de « programmation guidée par les souhaits » pour la génération de projets de bout en bout (jeux, scènes 3D, dépôts complets). Compétitif face à des modèles fermés plus volumineux sur les benchmarks d’agent/codage, tout en restant bien moins cher et plus rapide pour de nombreux workloads de production.
- Poids open source MIT sur Hugging Face et ModelScope permettant l’auto-hébergement et le fine-tuning.
- Pour la production, des plateformes comme CometAPI offrent un accès OpenAI-compatible pratique aux modèles DeepSeek aux côtés de 500+ autres, souvent avec des prix compétitifs et un basculement simplifié.
DeepSeek continue de repousser les limites des modèles IA ouverts efficaces et hautes performances. Le 17 octobre 2026, l’entreprise a publié DeepSeek-V4.1-Flash-1017, une mise à jour ciblée du modèle V4.1-Flash (initialement lancé le 10 septembre 2026). Présenté comme apportant des améliorations substantielles en raisonnement, codage, agentivité et compréhension visuelle—tout en réduisant le temps d’exécution des tâches et la longueur des sorties—ce checkpoint se positionne comme le modèle efficient le plus puissant à ce jour pour des workloads réels d’agents et de codage.
Le modèle est disponible sur le site web de DeepSeek, l’app mobile et l’API (toujours nommée simplement deepseek-flash). Les poids sont publiés sous licence MIT, ce qui en fait l’une des options open-weight les plus solides pour les développeurs souhaitant des performances d’agent de niveau frontier sans les coûts de niveau frontier.
Qu’est-ce que DeepSeek V4.1-Flash-1017, exactement ?
DeepSeek-V4.1-Flash-1017 est un checkpoint daté (« 1017 » se référant à la sortie du 17 octobre) de la famille V4.1-Flash. DeepSeek le décrit comme une « mise à jour mineure », mais les améliorations sont larges et significatives : des scores plus élevés dans chaque catégorie de benchmark rapportée, une exécution plus rapide des tâches et des sorties plus courtes. L’entreprise le présente comme une véritable amélioration de Pareto—meilleure performance et meilleure efficacité coût simultanément.
Il hérite de l’architecture innovante introduite avec V4.1-Flash :
- Design Mixture-of-Experts (MoE) avec environ 552B paramètres de backbone (plus des paramètres Engram selon certains rapports). Nouvelle architecture Encodeur–Décodeur causal qui n’active qu’~8B paramètres par token lors du préremplissage/traitement d’entrée et ~16B lors de la génération en sortie.
- Cache KV fortement compressé (réductions revendiquées de 1/4 en HBM et 1/8 en stockage SSD par rapport aux générations précédentes), ce qui réduit drastiquement le coût des contextes longs et des interactions multi-tours pour les agents.
- Support multimodal natif (entrée texte + image → sortie texte). Fenêtre de contexte d’un million de tokens et longueur maximale de sortie de 384K tokens (les échantillonnages recommandés utilisent souvent ≥256K tokens max).
- Prise en charge des modes de pensée / non-pensée, appels d’outils, sortie JSON et effort de raisonnement ajustable.
Le modèle a été entraîné avec des techniques de reinforcement learning améliorées, incluant des boucles d’auto-retour d’information spécifiquement destinées à améliorer le développement de projets de bout en bout. Cela permet une « programmation guidée par les souhaits » plus fiable—transformer des objectifs en langage naturel de haut niveau en projets complets et fonctionnels, tels que des jeux web, des scènes 3D ou des dépôts de code complets.
Pour un développeur d’applications, cela change la question d’évaluation. Au lieu de vérifier si le modèle peut produire une fonction plausible, testez s’il peut comprendre une base de code existante, réaliser des modifications coordonnées, exécuter des vérifications et corriger des erreurs. Une démonstration convaincante établit une capacité qui mérite d’être testée ; elle n’établit pas la fiabilité sur des dépôts arbitraires.
La mise à jour rend également l’efficacité de la sortie digne d’une mesure séparée de la qualité de la réponse. Une réponse plus courte peut réduire le coût de génération, mais seulement si elle préserve l’implémentation, l’explication ou les preuves requises par la tâche. Supprimer une validation utile serait une régression, même si la facture de tokens diminue.
Spécifications de l’API DeepSeek V4.1-Flash-1017
| Spécification | DeepSeek V4.1-Flash-1017 |
|---|---|
| Identifiant natif de l’API | deepseek-flash |
| Fenêtre de contexte | 1M tokens |
| Sortie maximale | 384K tokens |
| Prise en charge de l’entrée | Texte et images |
| Modes de raisonnement | Pensée et non-pensée |
| Fonctionnalités développeur | Appels d’outils, sortie JSON, Responses API |
| Architecture | Encodeur–Décodeur causal MoE |
| Nombre de paramètres annoncé | 552B |
| Paramètres actifs | 8B à l’entrée ; 16B en sortie |
Comment DeepSeek V4.1-Flash-1017 se comporte-t-il sur les benchmarks ?
Des tests indépendants précoces (par ex., en side-by-side avec DeepSeek V4 Pro) ont montré que 1017 égalait la qualité sur des tâches pratiques tout en étant significativement plus rapide et moins cher, et en ajoutant la vision que Pro n’avait pas dans certaines configurations.
Les résultats sélectionnés, rapportés par le fournisseur, comparent la version de septembre avec la mise à jour du 17 octobre.
| Résultats officiels des benchmarks | Version de septembre | Mise à jour du 17 octobre | Variation absolue du score (points) |
|---|---|---|---|
| HLE sans outils | 36.8 | 42.6 | +5.8 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 |
| Agents’ Last Exam | 31.8 | 35.4 | +3.6 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 |
| Chartography avec outils | 78.9 | 83.0 | +4.1 |
Ce sont des résultats rapportés par le fournisseur, et non des réplications indépendantes. DeepSeek a utilisé Claude Code pour Terminal-Bench 4.0 et Mini-SWE-V2 pour DeepSWE v1.1. HLE est rapporté sans outils et utilise les scores principaux plutôt que le sous-ensemble text-only distinct ; Chartography utilise des outils. Le tableau de publication cité ne fournit pas une configuration complète par ligne pour chaque autre benchmark, donc on ne peut pas supposer des budgets de raisonnement, matériels et conditions d’arrêt équivalents. Les changements ci-dessus sont de simples différences de score, et non des améliorations relatives en pourcentage.
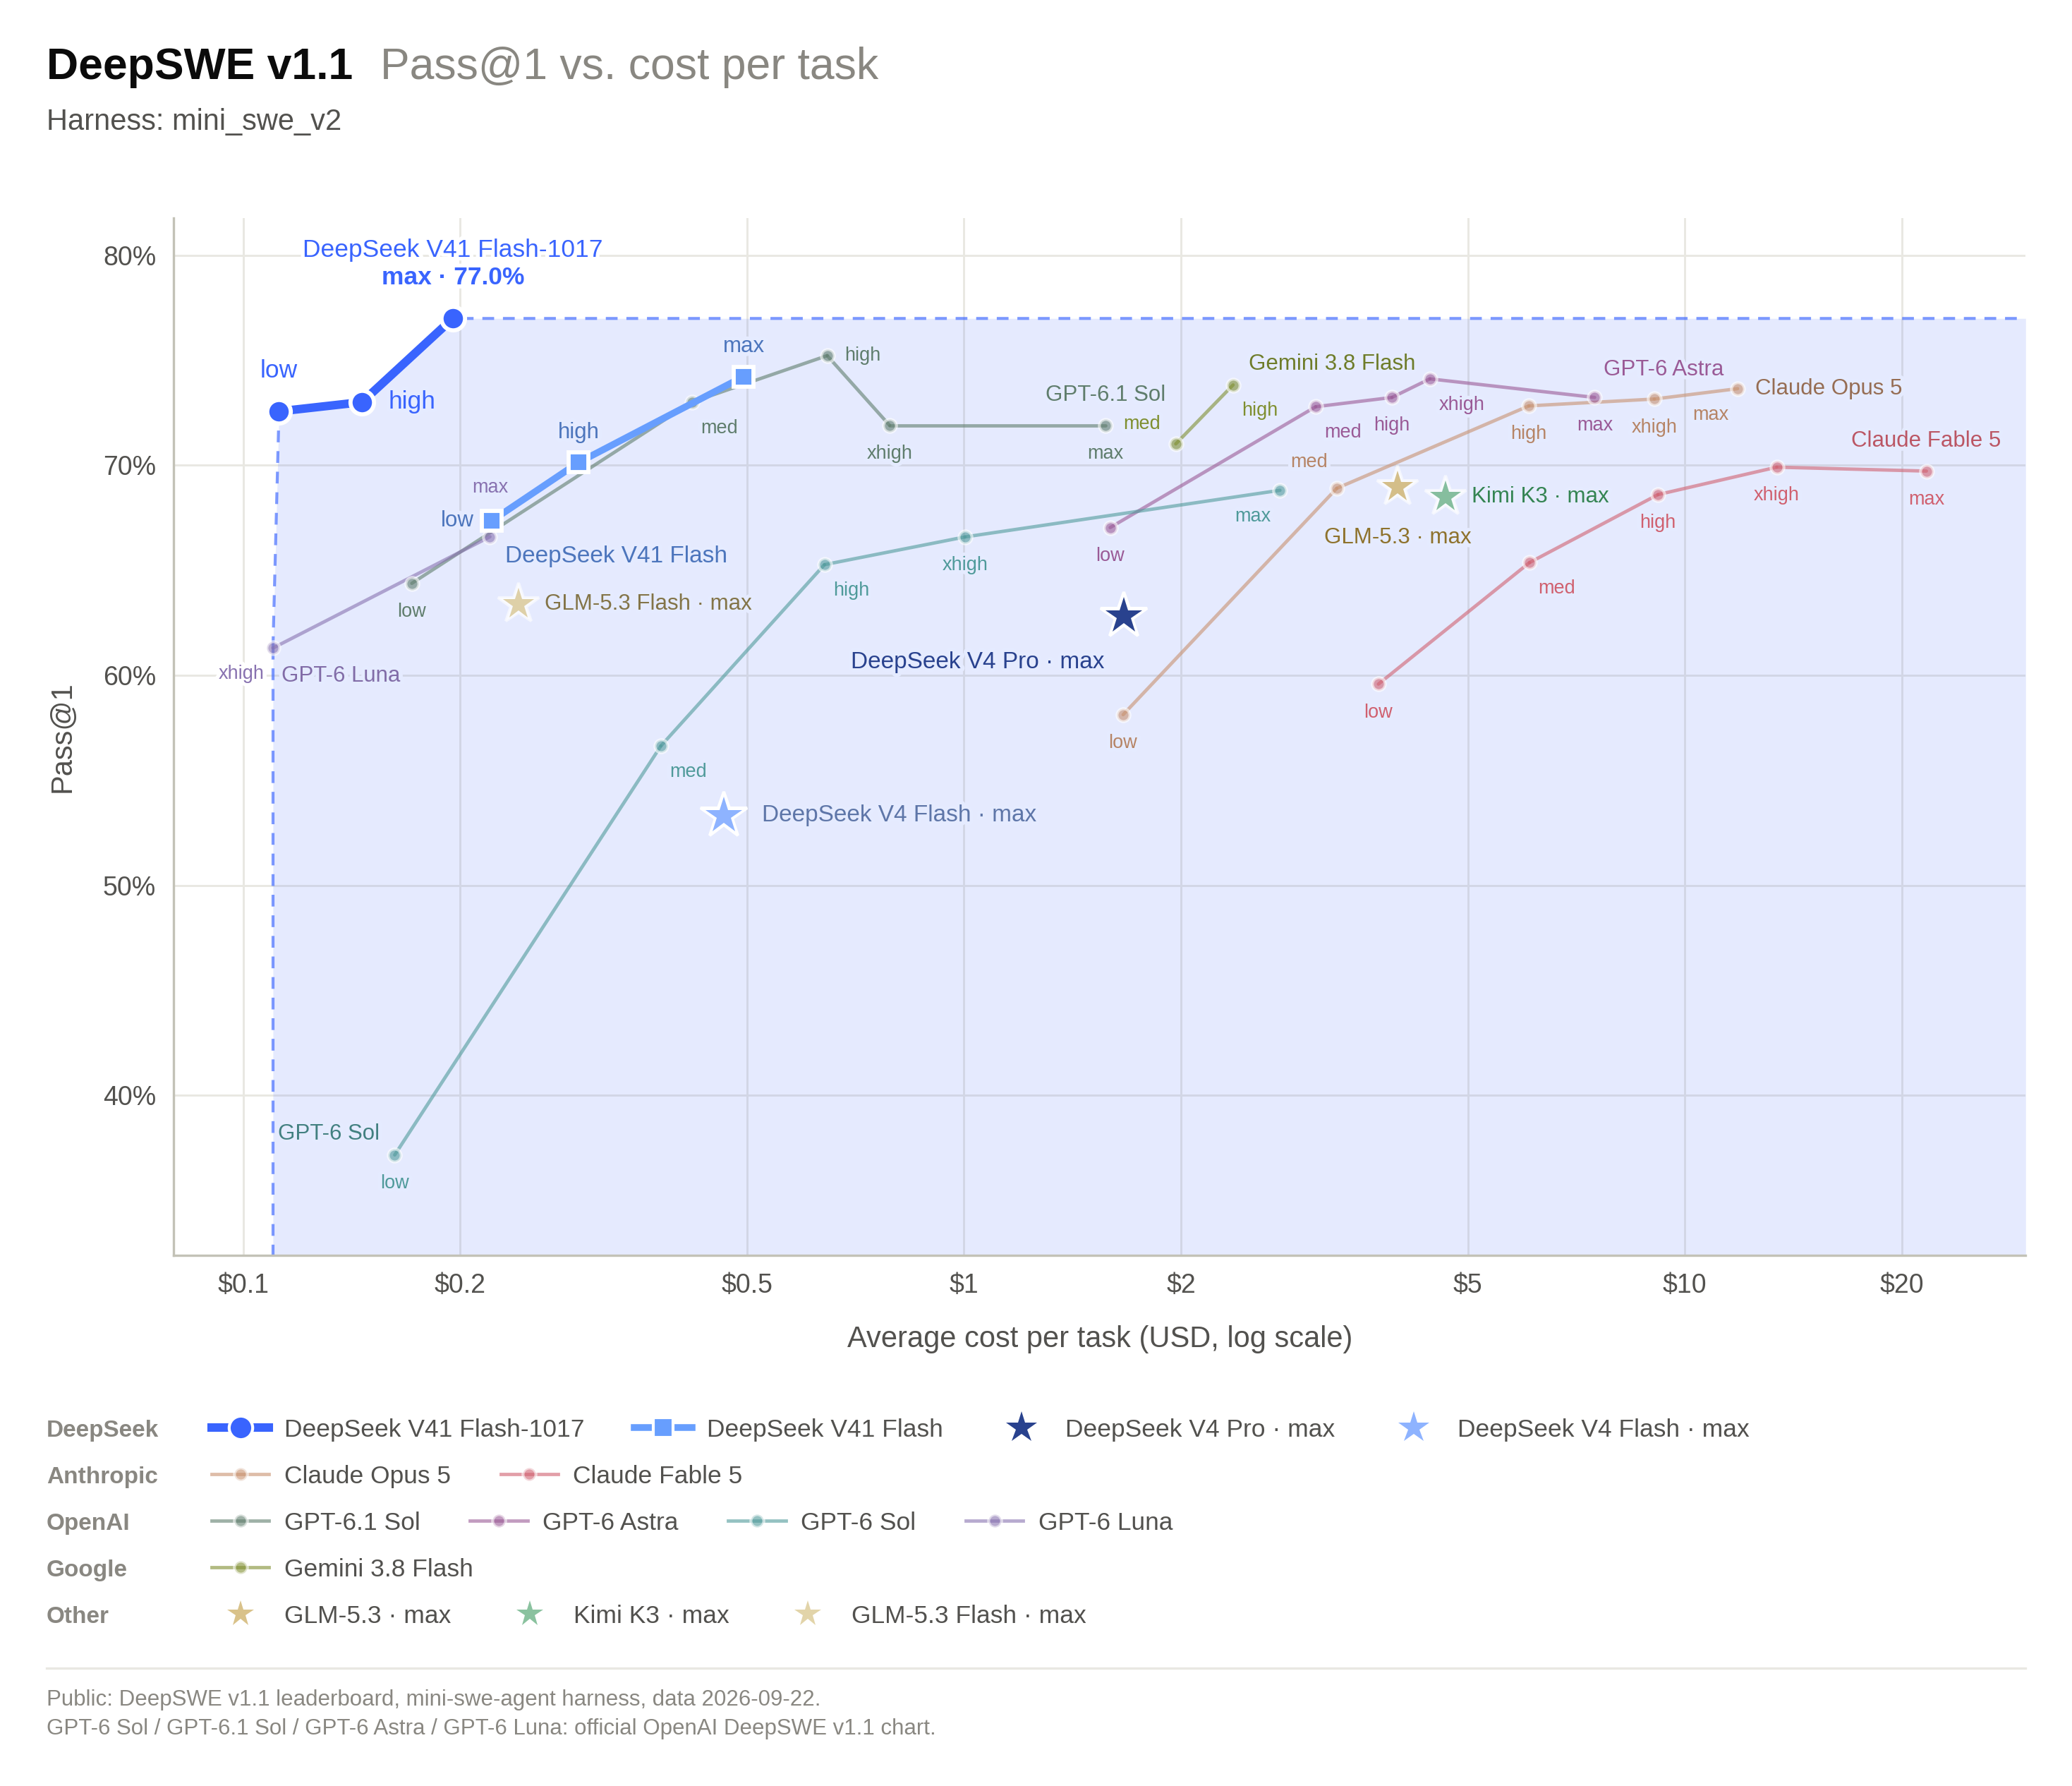
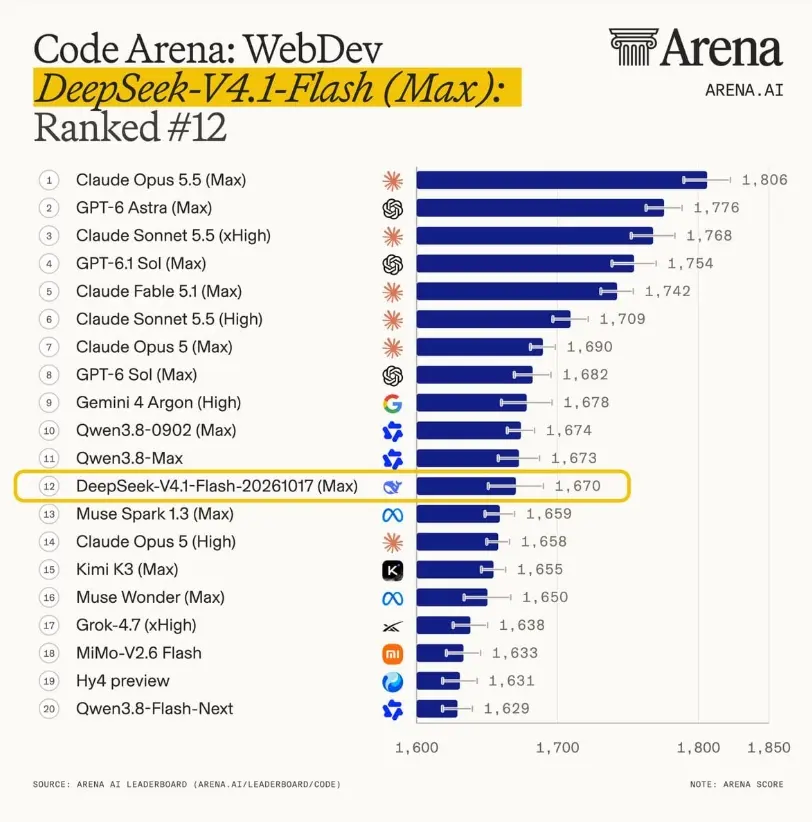
Le graphique performance/coût DeepSWE v1.1 de DeepSeek trace Pass@1 en fonction du coût moyen par tâche en USD sur un axe logarithmique, en utilisant le harnais Mini-SWE-V2. Différents réglages de raisonnement apparaissent comme des points distincts ; comparez un taux de réussite et une configuration appropriés avant de tirer une conclusion sur le coût.
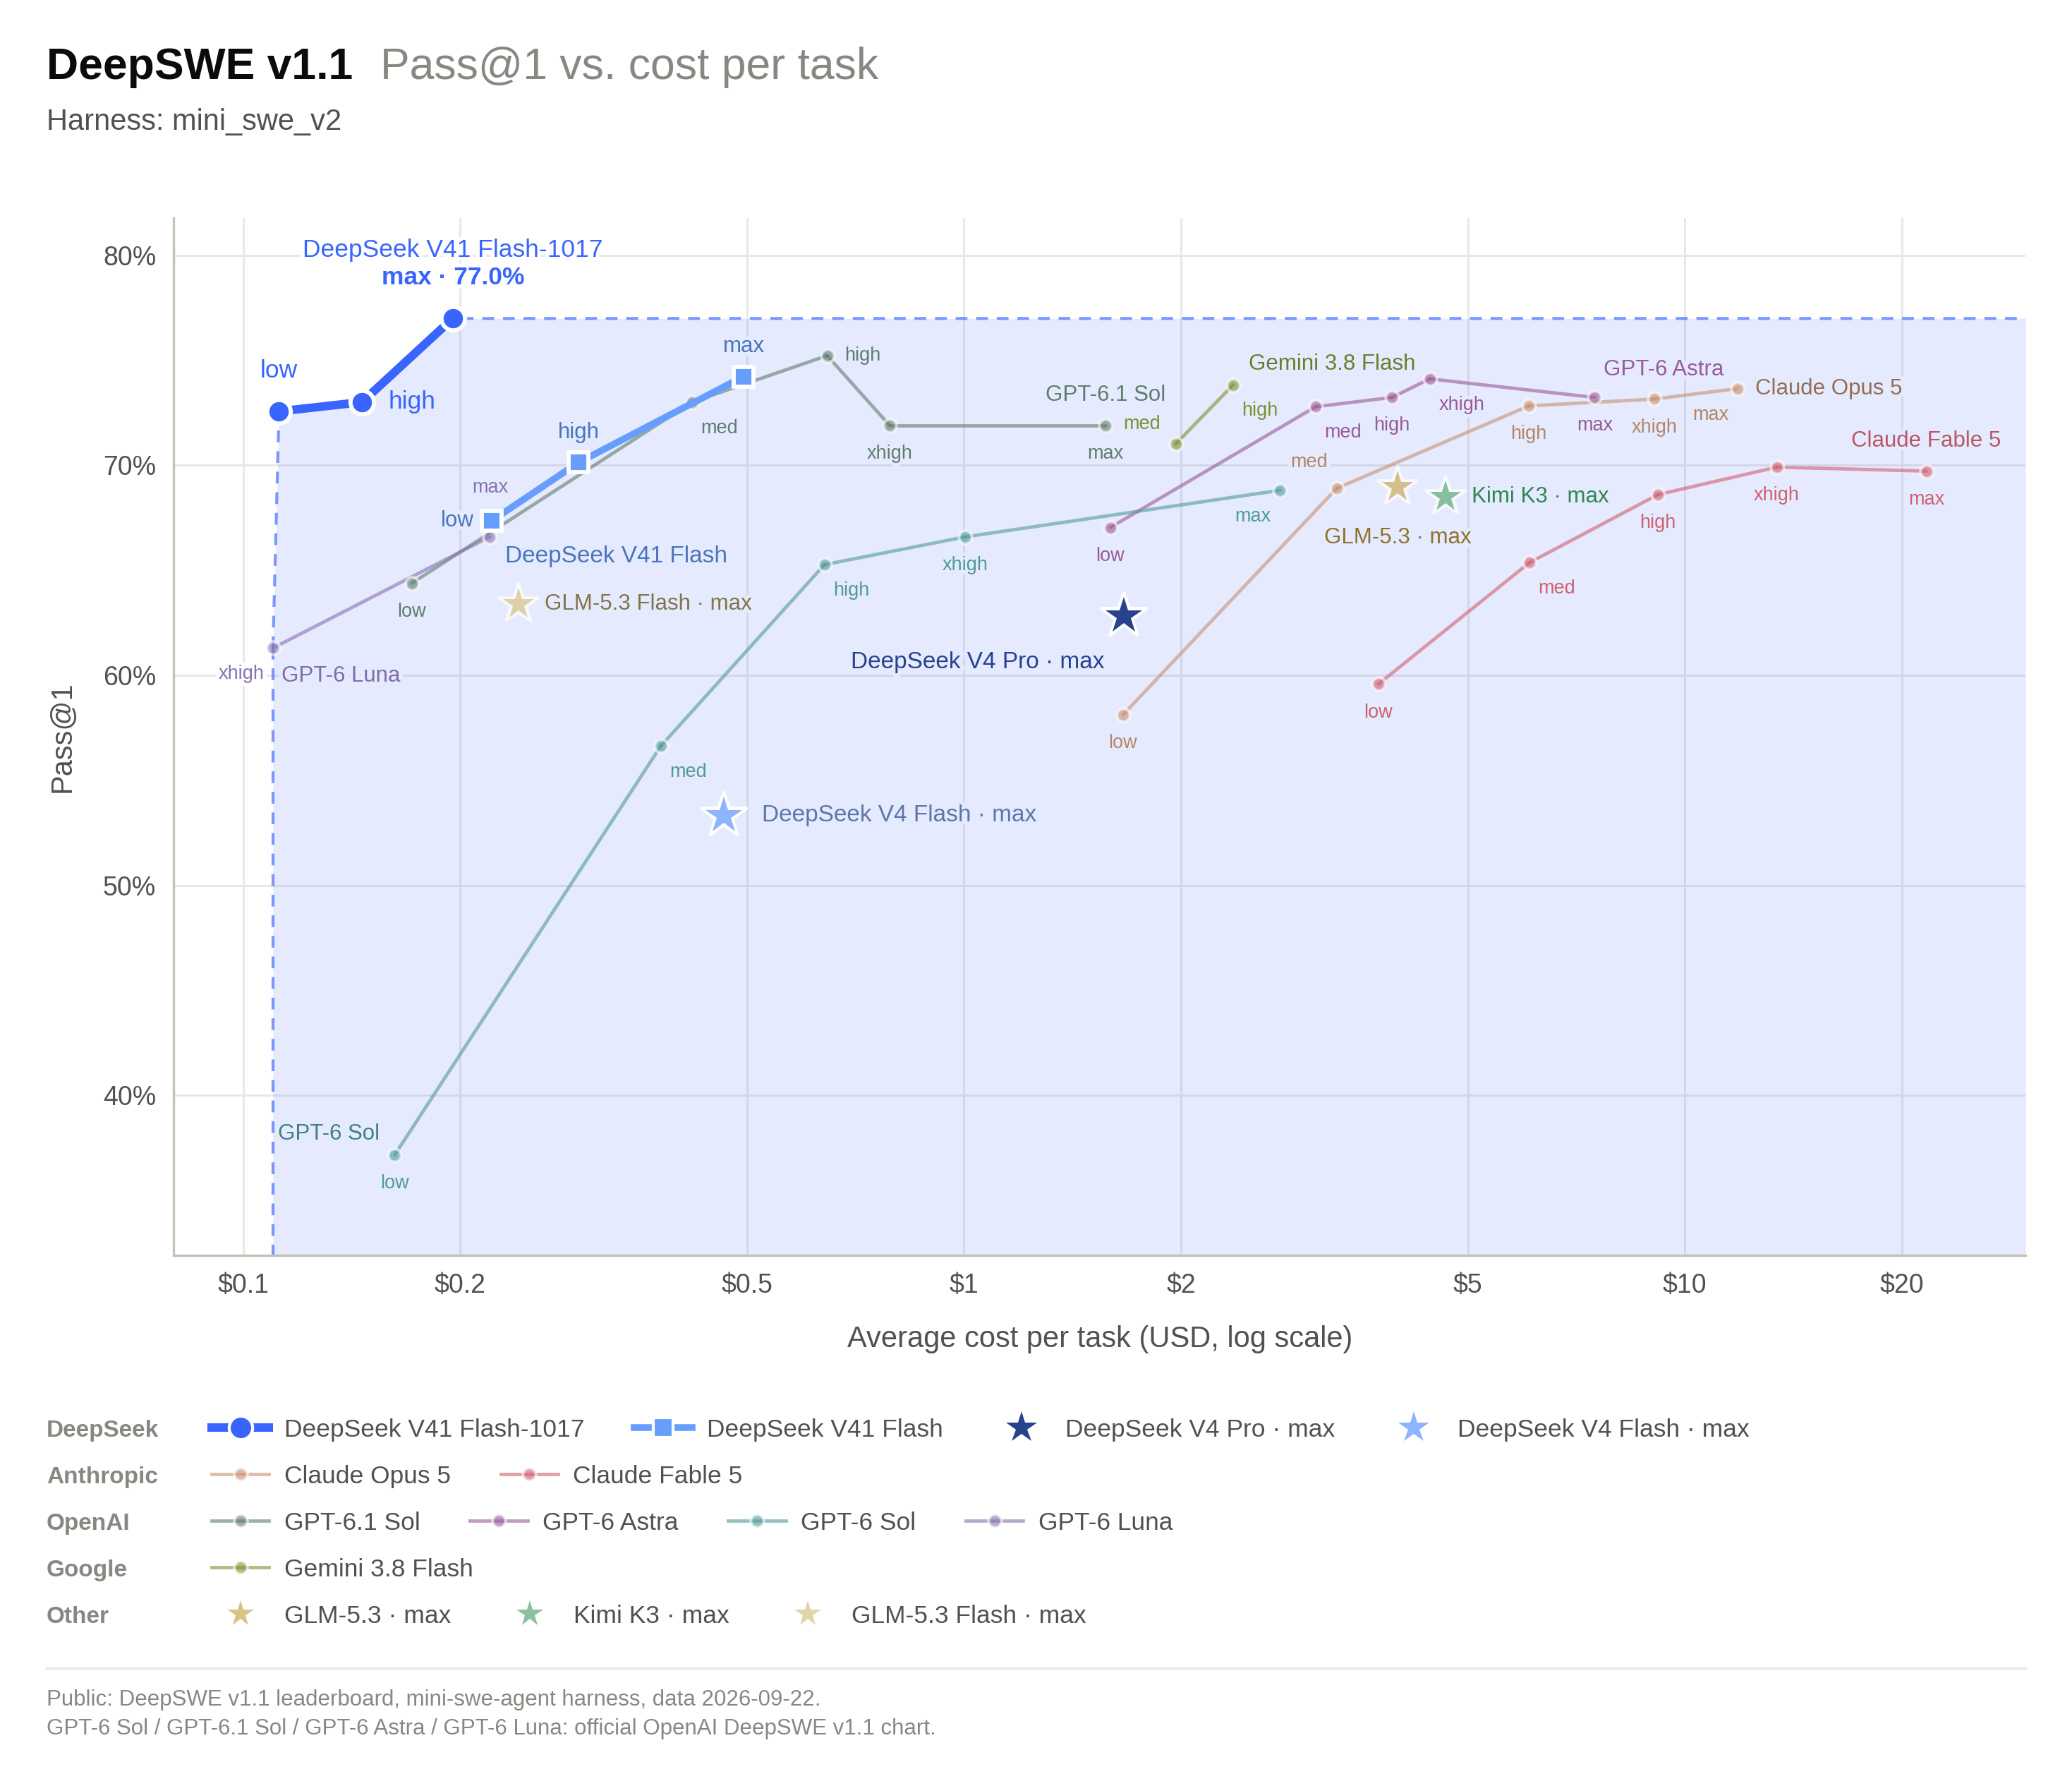
Code Arena: WebDev Leaderboard – Meilleur modèle open-source
Dans la dernière évaluation frontier de codage et développement web WebDev, DeepSeek-V4.1-Flash-1017 a non seulement surpassé le très réputé Kimi K3 (Max), mais a également atteint un ordre de grandeur d’amélioration en efficacité de coût d’inférence—avec une dépense opérationnelle environ dix fois inférieure à celle de son homologue. DeepSeek-V4.1-Flash-20261017 (Max) a officiellement pris la première place du leaderboard Code Arena: WebDev, remportant le titre de « numéro un des modèles open-source ».
Sur le leaderboard global, le modèle a obtenu la 12e place avec un score de 1670. À ce niveau élevé, il dépasse le modèle fermé leader, Claude Opus5 (High), et a réduit l’écart avec le modèle de haut niveau, GPT-6Sol (Max), à moins de 10 points.
Comment la mise à jour d’octobre se compare-t-elle à la version de septembre ?
Par rapport à la version de septembre, la mise à jour du 17 octobre montre ses gains les plus nets sur les benchmarks de codage sélectionnés : Terminal-Bench 4.0 passe de 31.2 à 42.3 (+11.1 points), tandis que ProgramBench augmente de 20.3 à 29.1 (+8.8 points). DeepSWE v1.1 s’améliore de 74.2 à 77.0 (+2.8 points). Ces résultats rapportés par le fournisseur soutiennent l’évaluation de la mise à jour pour les workflows terminal et les tâches de programmation plus larges ; ils n’impliquent pas des gains de productivité équivalents dans chaque base de code.
La publication met également davantage l’accent sur le développement de projets complets via du reinforcement learning avec auto-retour d’information. La vitesse et les économies de tokens restent dépendantes de la tâche, comme le montrent les deux exemples de la section suivante. Pour les intégrations natives de l’API existante, l’identifiant du modèle reste deepseek-flash. La décision de mise à niveau pratique devrait donc se baser sur l’acceptation des tâches, le coût total et le temps de bout en bout mesurés sur un travail représentatif.
Combien coûte DeepSeek V4.1-Flash-1017 ?
Son avantage en coût est énorme : Flash est généralement 10–40× moins cher par token que les meilleurs modèles fermés, et des sorties plus courtes amplifient encore les économies sur des agents à plusieurs étapes. Par rapport à son prédécesseur, 1017 est strictement meilleur sur les métriques rapportées tout en conservant le même prix—ce qui en fait une mise à niveau pure.
Tarifs en USD par million de tokens, tels qu’enregistrés dans l’article source au 19 octobre 2026. Les tarifs peak de CometAPI appliquent son multiplicateur publié de 2×.
| Catégorie de tokens | DeepSeek natif : off-peak | DeepSeek natif : peak | API DeepSeek V4.1 Flash sur CometAPI : base | CometAPI : fenêtre 2× |
|---|---|---|---|---|
| Entrée, cache hit | $0.003 | $0.006 | $0.0024 | $0.0048 |
| Entrée, cache miss | $0.15 | $0.30 | $0.12 | $0.24 |
| Sortie | $0.60 | $1.20 | $0.48 | $0.96 |
Les deux fournisseurs listent des fenêtres peak en semaine de 01:00–04:00 et 06:00–10:00 UTC. DeepSeek exclut les jours fériés chinois ; les conditions affichées par CometAPI ne précisent pas cette exemption. Les autres heures utilisent les tarifs off-peak/base. La colonne 2× de CometAPI est calculée à partir de ses prix de base publiés.
Pour l’API native de DeepSeek, 10 millions de tokens d’entrée non mis en cache plus 2 millions de tokens de sortie coûtent :
- Off-peak : (10 × $0.15) + (2 × $0.60) = $2.70.
- Peak : (10 × $0.30) + (2 × $1.20) = $5.40.
Pour un budget pilote, divisez tous les tokens et frais d’outils sur l’ensemble des tentatives par les tâches acceptées. Incluez la réutilisation du cache et les fenêtres peak ; rapportez séparément les coûts d’infrastructure et de revue humaine. Les exemples ci-dessus ne couvrent que les tokens du modèle.
Frais Search et Fetch
Les APIs Search et Fetch de DeepSeek coûtent chacune $0.75 par 1 000 requêtes réussies. Leur facturation est distincte de l’usage de tokens du modèle ; les requêtes échouées, résultats de recherche vides et timeouts ne sont pas facturés selon les règles documentées.
Pour les utilisateurs de l’API DeepSeek, les appels Search et Fetch côté serveur via DeepSeek Harness, Claude Code et Codex sont temporairement gratuits selon la politique de facturation officielle. La facturation de ces appels commence le 31 octobre 2026 à 16:00 UTC, équivalent au 1er novembre à minuit à Pékin. Cette exemption limitée ne rend pas tous les appels autonomes aux APIs Search et Fetch gratuits.
DeepSeek V4.1-Flash-1017 est-il toujours plus rapide et moins cher ?
Non. Le test à deux tâches d’EmpirioLabs a trouvé un temps et un usage de tokens de sortie plus faibles pour une animation d’aquarium, mais des valeurs plus élevées pour une animation de skyline :
| Tests de codage de première main d’EmpirioLabs | Version de septembre | Mise à jour du 17 octobre | Résultat observé |
|---|---|---|---|
| Temps d’achèvement Aquarium | 162 seconds | 124 seconds | Mise à jour d’octobre plus rapide |
| Tokens de sortie Aquarium | 41,833 | 33,149 | Mise à jour d’octobre en utilise moins |
| Temps d’achèvement Skyline | 163 seconds | 177 seconds | Mise à jour d’octobre plus lente |
| Tokens de sortie Skyline | 37,928 | 42,907 | Mise à jour d’octobre en utilise davantage |
Les deux versions ont produit des animations fonctionnelles dans ces tests sur la plateforme API d’EmpirioLabs le 18 octobre 2026. Chaque tâche a utilisé le même prompt et a demandé un fichier HTML autonome avec CSS et JavaScript inline, sans bibliothèques ou assets externes. Les deux modèles ont tourné avec les réglages par défaut, la pensée activée à son budget par défaut, et une limite de sortie de 65,536 tokens. Ils ont été exécutés simultanément pour chaque tâche, avec une tentative par modèle. Les temps couvrent toute la requête ; les comptes de tokens de sortie, incluant les tokens de raisonnement, proviennent des rapports d’usage d’API. Les captures ont été rendues dans un navigateur headless après six secondes. Ces deux exemples illustrent la variation des workloads plutôt que d’établir un classement général.
Comment accéder à DeepSeek V4.1-Flash-1017 ?
- API officielle DeepSeek — Utilisez le nom de modèle
deepseek-flashsur https://api.deepseek.com. - Poids ouverts — Téléchargez depuis Hugging Face ou ModelScope pour l’auto-hébergement.
- CometAPI — CometAPI ajoute DeepSeek-V4.1-Flash-1017 Voir les détails du modèle ID du modèle : deepseek-v4.1-flash-1017
Utiliser l’API native DeepSeek
Le quick start de l’API de DeepSeek et CometAPI confirment que deepseek-flash sert désormais la version du 17 octobre, sans changement de méthode d’appel.
Envoyez une demande de planification de projet via l’API avec Python. Installez le package Python OpenAI et définissez API_KEY dans votre environnement avant d’exécuter l’exemple.
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.deepseek.com",# https://api.cometapi.com/v1
)
response = client.chat.completions.create(
    model="deepseek-v4.1-flash-1017",
    messages=[
        {
            "role": "user",
            "content": (
                "Concevoir une petite application de suivi des tickets. "
                "Donner le modèle de données, le plan d’implémentation "
                "et les tests d’acceptation."
            ),
        }
    ],
)
print(response.choices[0].message.content)
Cela produit une réponse du modèle. Pour construire et valider automatiquement un projet, un environnement d’agent doit en outre fournir l’accès aux fichiers, l’exécution de commandes, des retours de test et des permissions appropriées.
CometAPI Recommandation : CometAPI liste déjà divers modèles DeepSeek et constitue un excellent moyen d’essayer V4.1-Flash-1017 aux côtés de Claude, GPT, Gemini, Grok, et des modèles spécialisés de codage/vision sans verrouillage fournisseur. Inscrivez-vous et obtenez une clé API, et pointez votre SDK OpenAI existant vers l’URL de base CometAPI. Cette approche est particulièrement puissante pour les frameworks d’agents qui bénéficient de router différents sous-tâches vers le modèle le plus économique ou le plus performant disponible.
Conclusion
DeepSeek-V4.1-Flash-1017 représente un saut intelligent et efficace des capacités d’IA ouverte. En améliorant les performances sur des benchmarks critiques d’agentivité et de codage tout en réduisant la longueur des sorties et le temps des tâches—à des prix bas inchangés—il renforce la position de DeepSeek comme leader de la performance par dollar. Que vous construisiez des agents logiciels autonomes, des applications multimodales ou des systèmes de production optimisés en coût, ce modèle mérite une évaluation sérieuse.
Combiné à des couches d’accès pratiques comme CometAPI, les développeurs peuvent intégrer des modèles à la pointe tels que V4.1-Flash-1017 dans des workflows robustes multi-fournisseurs avec un minimum de friction. À mesure que les évaluations indépendantes émergent et que l’écosystème d’outils (Harness, CodeBuddy, etc.) mûrit, attendez-vous à ce que ce checkpoint devienne un choix par défaut pour de nombreux workloads à grand volume et haute intelligence fin 2026 et au-delà.