
TL;DR
DeepSeek V4.1 Pro est un successeur futur référencé de V4 Pro, sans date de sortie établie par les sources officielles consultées au 14 octobre 2026. L’annonce Flash du 10 septembre fournit l’indice de sortie le plus clair. Les spécifications et évaluations disponibles de Flash aident les développeurs à se préparer, mais n’établissent pas les capacités de la version Pro. DeepSeek a précisé que V4 Pro reste disponible en réponse à la demande des utilisateurs. Les chiffres de benchmark ci-dessous décrivent la version Flash initiale, et non la mise à jour Flash-1017 du 17 octobre ; les intégrations doivent vérifier les versions de modèle propres à chaque fournisseur avant déploiement.
Points clés
- Statut de sortie : V4.1 Pro a été mentionné officiellement, mais aucune date de lancement spécifique n’est confirmée.
- Indice le plus important : l’annonce de V4.1 Flash a relié un futur V4.1 Pro à un plan de transition d’API.
- Statut de l’API : DeepSeek a confirmé la poursuite du service V4 Pro avec une facturation inchangée en réponse à la demande des utilisateurs ; le plan antérieur redirigeant les requêtes Pro vers Flash est caduc.
- Fondation technique : V4.1 Flash dévoile un backbone de 552B paramètres, un traitement asymétrique et une fenêtre de contexte de 1M tokens.
- Préparation : Évaluez les modèles existants et gardez les identifiants de modèle d’API configurables.
Quand DeepSeek V4.1 Pro sera-t-il publié ?
Au 14 octobre 2026, les sources officielles consultées pour cet article n’établissent aucune date de sortie pour DeepSeek V4.1 Pro. Son nom apparaît dans la communication produit de DeepSeek, mais une référence à un produit futur n’est pas un calendrier de lancement.
Le 10 septembre 2026, DeepSeek a introduit V4.1 Flash comme le plus petit membre d’une nouvelle famille d’architecture. Son annonce de lancement officielle décrivait un plan initial visant à rediriger l’ancienne API V4 Pro vers V4.1 Flash jusqu’à la future sortie de V4.1 Pro. La déclaration relie le successeur à une politique de migration concrète, mais n’établit ni date de sortie, ni statut d’entraînement, ni spécifications finales.
Chronologie de sortie de DeepSeek V4.1 Pro
| Date | Développement | Implication |
|---|---|---|
| 24 avril 2026 | Famille V4 en préversion publiée | Référence de la génération précédente |
| 13 août 2026 | Mise en disponibilité générale de V4 Pro | Référence du fleuron connu |
| 10 septembre 2026 | V4.1 Flash annoncé ; V4.1 Pro référencé | Nouvelle famille d’architecture introduite, Pro futur référencé mais aucune date de sortie confirmée |
| 14 septembre 2026 | Cible de migration V4 Pro initiale | Révisé par la suite |
| Sortie de V4.1 Pro | Aucune date annoncée | Calendrier non confirmé |
Les archives d’actualités officielles datent la sortie de la préversion V4 au 24 avril et la mise à disposition générale de V4 Pro au 13 août. La date de migration de septembre était une cible de transition de service, et non une date de sortie de V4.1 Pro.
L’annonce de septembre proposait de rediriger les requêtes V4 Pro vers Flash à partir du 14 septembre jusqu’à une future version Pro. Cependant, la documentation API actuelle liste V4 Pro comme un modèle distinct avec ses propres tarifs. DeepSeek a ensuite précisé dans son entrée de changelog officielle du 10 septembre qu’il continuerait à fournir le service d’API V4 Pro après le 14 septembre en réponse à la demande des utilisateurs, avec une facturation inchangée. La proposition de redirection antérieure doit donc être considérée comme un plan caduc, et non comme la politique actuelle de routage de V4 Pro. Le tableau de modèles actuel liste deepseek-v4-pro comme V4-Pro-0813 et deepseek-flash comme V4.1-Flash-1017 ; vérifiez le mappage des modèles de chaque fournisseur avant déploiement.
Une confirmation future devrait provenir d’une annonce dédiée de DeepSeek, d’un identifiant d’API pris en charge, ainsi que d’évaluations et de tarifs publiés pour la version Pro.
Qu’est-ce que DeepSeek a officiellement confirmé à propos de V4.1 Pro ?
Informations confirmées
Distinguer les déclarations officielles de la spéculation technique est essentiel avant le lancement. Les informations de V4.1 Flash apportent des éléments substantiels sur la famille d’architecture, mais ne deviennent pas automatiquement les spécifications de V4.1 Pro.
DeepSeek a référencé V4.1 Pro comme un futur membre de la famille V4.1, mais les sources examinées n’établissent pas sa date de sortie, son identifiant de modèle public, son nombre de paramètres, sa fenêtre de contexte, la prise en charge de la vision, les contrôles de raisonnement, les résultats de benchmark ou la tarification API. Les spécifications disponibles de V4.1 Flash fournissent un contexte pour la famille d’architecture, pas des caractéristiques confirmées de V4.1 Pro.
DeepSeek décrit V4.1 Flash comme le plus petit membre d’une nouvelle famille conçue pour l’évolutivité. Cela appuie l’existence d’une architecture future plus grande sans prouver que V4.1 Pro sera simplement une version agrandie. L’entraînement, les budgets de paramètres actifs, les schémas d’attention et les méthodes de post-entraînement restent non confirmés.
Rapports de la communauté / fuites
Dans un post X du 27 septembre 2026, @NFT_Chen a affirmé que DeepSeek V4.1 Pro était apparu en test interne avec un accès anticipé restreint par compte.
Le post de @NFT_Chen est un rapport communautaire non vérifié, pas une annonce officielle de DeepSeek. La capture d’écran montre visiblement le nom V4.1 Pro, un label Early access et plusieurs champs de configuration, mais elle n’établit pas la source de la capture, l’environnement de déploiement, la connexion à un modèle actif, la disponibilité de l’API publique ou les spécifications finales du produit. À traiter comme une piste à vérifier plutôt que comme la preuve d’une sortie confirmée.
La capture de configuration jointe affiche le nom DeepSeek V4.1 Pro, le slogan Early access, un niveau élevé d’effort de raisonnement, et des indicateurs pour l’utilisation des données d’entraînement, un accès non premium et l’absence de prise en charge multimodale. Elle contient également un identifiant FREEBUFF_AI_TRAINING_NOTICE.
Si elle est authentique et liée à une intégration active, l’entrée pourrait constituer un indice d’accès anticipé. Un indicateur de disponibilité n’est pas une garantie de service, et la prédiction de sortie imminente par l’auteur n’est pas une fenêtre de sortie confirmée. Traitez la capture comme une piste à vérifier, pas comme une spécification de la version Pro.
Que sait-on de DeepSeek V4.1 Pro ?
V4.1 Flash offre la base technique la plus claire pour la famille à venir. V4.1 Flash utilise une architecture encodeur-décodeur causale avec des chemins de calcul distincts pour le pré-remplissage et le décodage.
Selon la fiche technique du modèle, le modèle publié contient 40 couches Transformer réparties entre un encodeur de 20 couches et un décodeur de 20 couches.
| Spécification | DeepSeek V4 Pro | V4.1 Flash | V4.1 Pro |
|---|---|---|---|
| Paramètres du backbone | 1,6T | 552B | Non annoncé |
| Paramètres activés | 49B | 8B en entrée / 16B en sortie | Non annoncé |
| Architecture | MoE | Encodeur-Décodeur causal MoE | Non annoncé |
| Fenêtre de contexte | 1M | 1M | Non annoncé |
| Sortie maximale | 384K | 384K | Non annoncé |
| Entrée image native | Non présent dans la configuration listée | Pris en charge | Non annoncé |
| Empreinte du cache KV | Non directement comparable | ~890 octets/token | Non annoncé |
| Contrôle du raisonnement | Bas / élevé / max | Continu 1–100 | Non annoncé |
| Disponibilité | API | API et poids ouverts | Non annoncé |
Bien que V4.1 Flash contienne 552B de paramètres de backbone, seuls environ 8B de paramètres sont activés par token en entrée et 16B lors de la génération.
Potentiel de passage à l’échelle de l’encodeur-décodeur causal
La séparation entre pré-remplissage et décodage pourrait permettre aux futurs membres de la famille d’augmenter la capacité de représentation tout en maîtrisant les coûts d’inférence. V4.1 Flash présente également Compressed Sparse Attention 2 et un cache KV en FP4. La manière dont V4.1 Pro héritera ou non de ces caractéristiques reste inconnue.
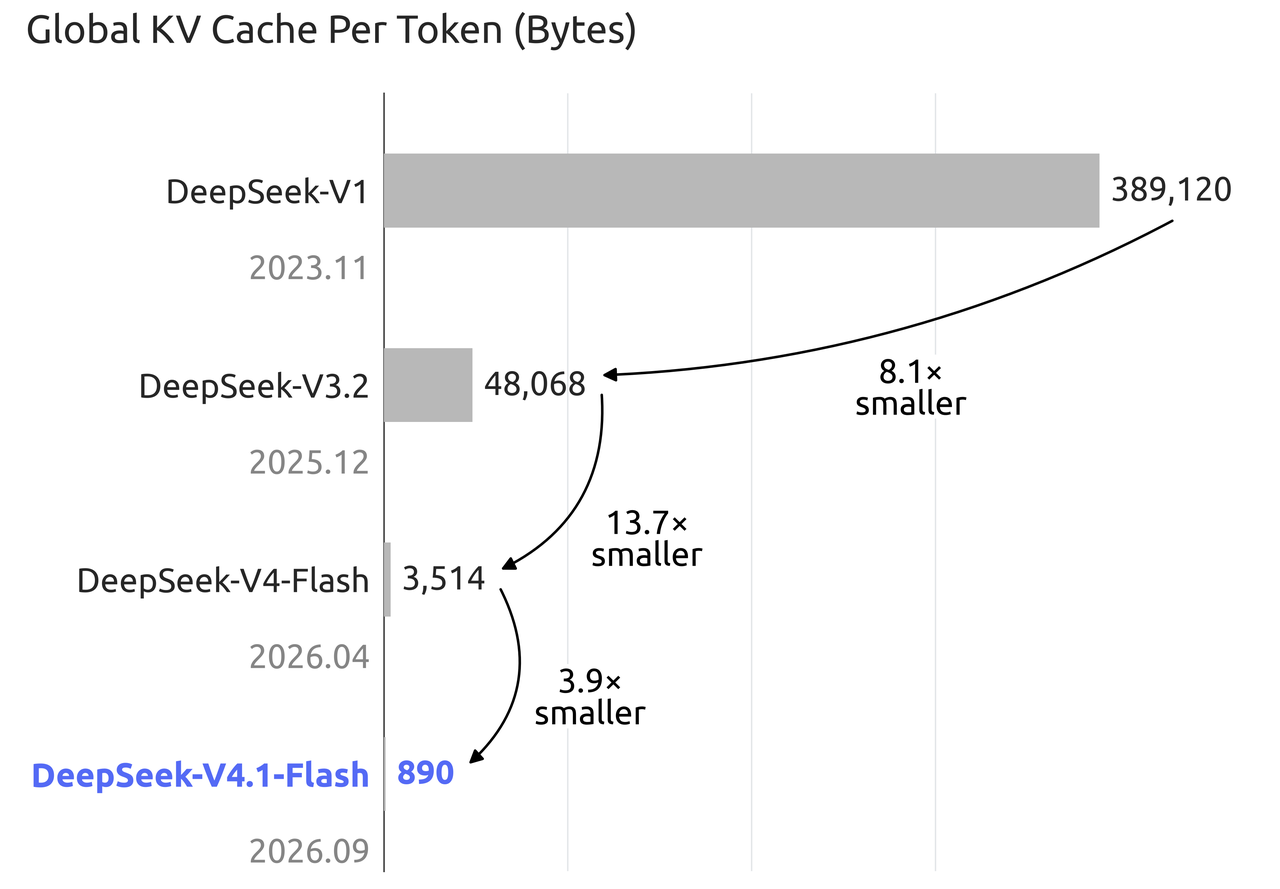
DeepSeek rapporte une empreinte de cache KV globale d’environ 890 octets par token pour V4.1 Flash, contre 3 514 octets pour V4 Flash. Il s’agit d’une comparaison du cache KV global, pas d’une mesure de la mémoire totale de service.
Les deux graphiques originaux reproduits dans cet article sont publiés dans la fiche modèle officielle de DeepSeek ; aucun des deux n’est un résultat de V4.1 Pro.
DeepSeek V4.1 Pro vs V4 Pro vs V4.1 Flash
Un point de départ utile est la différence observée entre les modèles existants, pas un benchmark Pro inventé. Le tableau ci-dessous compare le modèle V4 Pro 0813 publié avec la version initiale de V4.1 Flash de septembre.
Comparaison de benchmarks DeepSeek
| Benchmark (métrique) | V4 Pro 0813 | V4.1 Flash | Flash − Pro (points de pourcentage) |
|---|---|---|---|
| GPQA Diamond (Pass@1) | 92,4 | 90,9 | −1,5 |
| HLE, texte seul (Pass@1) | 42,7 | 39,1 | −3,6 |
| Terminal-Bench 2.1 (Pass@1) | 87,9 | 90,6 | +2,7 |
| Terminal-Bench 3.0 (Pass@1) | 11,8 | 30,0 | +18,2 |
| DeepSWE v1.1 (Resolved) | 62,7 | 74,2 | +11,5 |
| CyberGym (Pass@1) | 83,3 | 88,1 | +4,8 |
| HLE avec outils (Pass@1) | 60,0 | 63,9 | +3,9 |
| Agents’ Last Exam (Pass@1) | 25,7 | 31,8 | +6,1 |
Note de version (19 octobre 2026) :
Ce ne sont pas des résultats de V4.1-Flash-1017.
confirme que le site, l’application et l’API sont passés à Flash-1017. Le tableau est conservé comme comparaison historique avec V4 Pro 0813. N’interprétez pas les écarts de scores comme une comparaison avec la dernière version de Flash ; relancez des évaluations appariées avant de prendre une décision de sélection de modèle actuelle.
Le tableau officiel d’évaluation des modèles instruct est la source des résultats de benchmark rapportés par l’éditeur ci-dessus. Pour une comparaison cohérente, les scores HLE sont basés sur le sous-ensemble texte seul pour les deux modèles. Tous les écarts de score sont exprimés en points de pourcentage plutôt qu’en gains relatifs en pourcentage.
Conditions et limites des benchmarks
Les évaluations instruct de Flash utilisent reasoning_effort=100, temperature=1.0 et top_p=0.95. Terminal-Bench utilise DeepSeek Harness Minimal avec un contexte de 1M tokens ; DeepSWE v1.1 utilise mini-SWE. Ces paramètres décrivent les exécutions Flash rapportées et ne doivent pas être supposés reproduire la configuration de chaque modèle comparé.
L’étude cross-scaffold accompagnante précise des conteneurs Linux, max_steps=500, huit échantillons par tâche pour DeepSWE et trois pour Terminal-Bench 2.1, sans accès réseau pour ce dernier. Ces détails appartiennent à cette étude, pas automatiquement à chaque ligne du tableau principal. La fiche modèle ne fournit pas une configuration matérielle unique partagée pour tous les scores listés ; aucune revendication de débit normalisé matériel n’est faite ici.
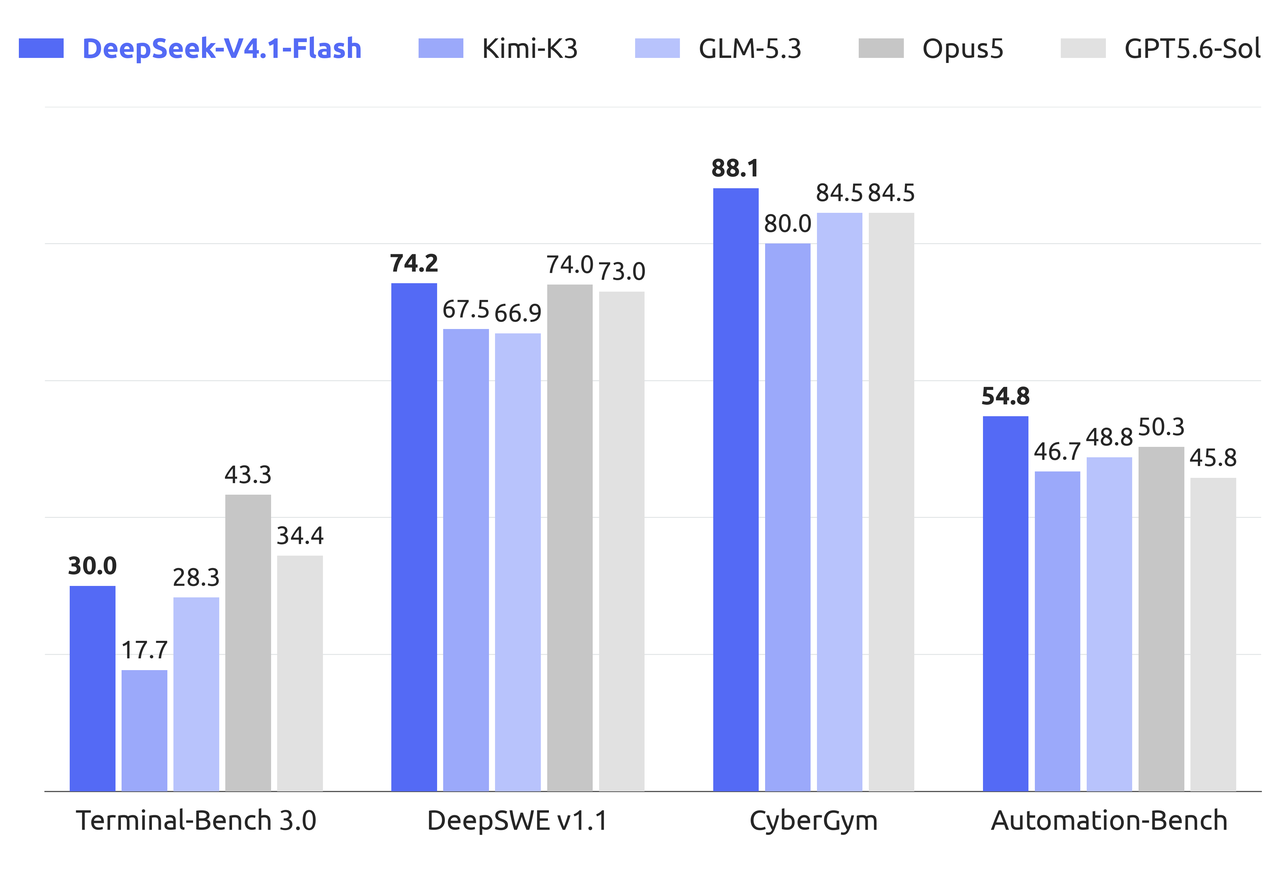
Le graphique original de performance des agents de DeepSeek compare Flash à des modèles de pointe sélectionnés. Sa valeur de 17,7 pour Terminal-Bench 3.0 appartient à Kimi K3, pas à V4 Pro. Le tableau ci-dessus fournit la comparaison distincte avec V4 Pro.
Cette comparaison historique montre pourquoi un modèle plus petit n’est pas forcément moins bon pour chaque tâche. Par rapport à la version initiale de Flash de septembre, V4 Pro devançait certains tests de raisonnement tandis que Flash menait sur plusieurs évaluations de terminal, de codage et basées sur les outils. Ces classements ne doivent pas être transposés à Flash-1017 sans tests actualisés et comparables.
Combien pourrait coûter DeepSeek V4.1 Pro ?
DeepSeek n’a pas annoncé la tarification de V4.1 Pro. La tarification actuelle du fournisseur d’origine fournit une référence, pas une prévision. Les tarifs distinguent les périodes de pointe et hors pointe, l’entrée avec hit et miss de cache, et la sortie générée.
Les chiffres suivants proviennent de la documentation tarifaire de DeepSeek ; les tarifs peuvent changer.
Tarifs et limites vérifiés le 14 octobre 2026. Les périodes de pointe sont 01:00–04:00 et 06:00–10:00 UTC, du lundi au vendredi, hors jours fériés chinois. Tous les autres créneaux sont hors pointe. Il s’agit des tarifs de première partie de DeepSeek, pas d’un devis CometAPI ; la facturation propre à chaque fournisseur doit être vérifiée séparément.
| Prix par 1 M de tokens | Flash heures creuses | Flash heures de pointe | V4 Pro heures creuses | V4 Pro heures de pointe |
|---|---|---|---|---|
| Entrée (cache hit) | 0,003 $ | 0,006 $ | 0,022 $ | 0,044 $ |
| Entrée (cache miss) | 0,15 $ | 0,30 $ | 0,66 $ | 1,32 $ |
| Sortie | 0,60 $ | 1,20 $ | 1,98 $ | 3,96 $ |
Dans l’instantané tarifs et limites du 14 octobre, V4.1 Flash et V4 Pro prennent tous deux en charge une fenêtre de contexte de 1M tokens. La concurrence indiquée est de 2 500 pour Flash et 500 pour V4 Pro, avec les mêmes limites en pointe et hors pointe. Ce sont des limites de première partie ; confirmez les limites de votre fournisseur avant déploiement.
Aux tarifs publiés en heures creuses, l’entrée non mise en cache de Flash est environ 77 % moins chère que V4 Pro et la sortie générée environ 70 % moins chère. Sa tarification plus basse peut être particulièrement pertinente pour les actions répétées d’agents et les workflows riches en documents.
Compromis qualité/coût pour V4.1 Pro
À titre d’illustration uniquement, un modèle coûtant 0,01 $ par tentative avec un taux de réussite de 60 % a un coût API attendu de 0,0167 $ par tâche réussie, tandis qu’un modèle à 0,03 $ avec un taux de réussite de 95 % coûte environ 0,0316 $. Ces chiffres ne sont pas des performances mesurées de DeepSeek ; ils supposent des tentatives indépendantes avec une probabilité de réussite constante. Le modèle à plus fort taux de réussite peut rester préférable s’il réduit les coûts de revue, de reprise ou d’autres coûts métiers.
Comment les développeurs doivent-ils se préparer pour l’API DeepSeek V4.1 Pro ?
Les développeurs peuvent valider les interfaces compatibles existantes, les modèles actuels et des protocoles de test réutilisables sans supposer d’identifiant V4.1 Pro. L’essentiel est de dissocier le choix du modèle de la logique applicative.
Commencer avec un modèle DeepSeek disponible
Les développeurs peuvent accéder à l’API DeepSeek V4 Pro dans CometAPI et à l’API DeepSeek V4.1 Flash dans CometAPI pour construire une base actuelle. L’exemple utilise l’identifiant CometAPI deepseek-v4.1-flash. L’API propre de DeepSeek utilise deepseek-flash ; les identifiants et clés sont spécifiques au fournisseur et ne doivent pas être interchangés.
Installez le package openai et définissez COMETAPI_KEY avant exécution. Ceci est un exemple d’intégration minimal ; validez-le dans votre propre compte avant une utilisation en production.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

model = os.getenv("DEEPSEEK_MODEL", "deepseek-v4.1-flash")

response = client.chat.completions.create(
    model=model,
    messages=[
        {"role": "system", "content": "You are a careful coding assistant."},
        {"role": "user", "content": "Explain how to optimize Python API latency."}
    ]
)

print(response.choices[0].message.content)
L’identifiant de modèle dans cet exemple fait référence à Flash, pas à une variante Pro non annoncée. Un identifiant de modèle officiel futur peut être substitué seulement après confirmation et tests.
Construire une suite d’évaluation DeepSeek reproductible
| Zone de test | Tâche suggérée | Mesure principale |
|---|---|---|
| Raisonnement | Questions scientifiques vérifiées | Précision |
| Codage | Modifications multi-fichiers d’un dépôt | Tests réussis |
| Agents | Recherche assistée par outils | Taux d’achèvement |
| Sortie structurée | JSON contraint par schéma | Validité |
| Contexte long | Récupération de documents | Rappel |
| Vision | Compréhension de graphiques/documents | Précision d’extraction |
| Latence | Requêtes répétées contrôlées | P50 / P95 |
| Coût | Évaluation du flux de travail complet | Coût par réussite |
Utilisez ces résultats sur les modèles disponibles pour choisir une base, pas pour prédire les performances de V4.1 Pro. Les éléments de benchmark ci-dessus sont antérieurs à Flash-1017. Pour les workflows de terminal et d’outils, testez aussi l’achèvement à long horizon et les appels d’outils redondants ; mesurez la latence sous une charge contrôlée. Ce sont des objectifs d’évaluation, pas des promesses officielles de V4.1 Pro.
Utilisez des invites, des outils, des données et des budgets de raisonnement cohérents autant que possible. Des réglages de harnais différents peuvent produire des gains apparents non liés au modèle sous-jacent.
Préparer une stratégie de déploiement progressive
- Compatibilité : tester l’authentification, le streaming, les schémas, les appels d’outils et les limites de tokens.
- Évaluation en parallèle : traiter des échantillons de tâches réelles sans modifier les sorties de production.
- Déploiement contrôlé : diriger une petite part des requêtes éligibles vers le nouveau modèle.
- Retour arrière : conserver l’itinéraire précédent vérifié jusqu’à atteindre les objectifs de fiabilité et de budget.
Faut-il attendre DeepSeek V4.1 Pro ou utiliser V4.1 Flash maintenant ?
Si un modèle disponible répond à vos besoins, commencez avec lui et gardez l’itinéraire de modèle configurable pour une future évaluation de la version Pro. Gardez l’itinéraire de modèle configurable et réévaluez lorsqu’une date de sortie, un identifiant d’API pris en charge et des résultats d’évaluation seront publiés.
| Exigence | Option pratique | Raison |
|---|---|---|
| Faible coût par token | Évaluer V4.1 Flash | Tarifs publiés plus bas |
| Agents à grande échelle | Tester Flash d’abord | Scores d’agents et concurrence |
| Raisonnement difficile | Comparer V4 Pro et Flash | Points forts différents selon les tâches |
| Système V4 Pro existant | Conserver l’intégration vérifiée | Éviter les régressions |
| Entrée visuelle native | Tester Flash | Prise en charge officielle de la vision |
| Workflows critiques | Évaluation spécifique à la tâche | Privilégier l’exactitude réelle aux classements |
Gardez l’identifiant du modèle configurable si vous envisagez d’évaluer V4.1 Pro plus tard.
Conclusion
DeepSeek V4.1 Pro a été officiellement mentionné, mais sa date de sortie, son identifiant d’API public, ses tarifs et ses résultats de benchmark restent non confirmés dans les sources consultées. Les développeurs peuvent utiliser dès maintenant les itinéraires V4 Pro et V4.1 Flash disponibles, tout en gardant la sélection du modèle configurable et en relançant des évaluations appariées avant d’adopter toute future version Pro.