
TL;DR
GLM-5.3 Flash est le meilleur défaut pour la plupart des charges de production : il ajoute une entrée visuelle native et une fenêtre de contexte de 1M de jetons, tandis que son tarif catalogue standard est nettement inférieur. GLM-5.3 reste le meilleur choix lorsque la profondeur de codage maximale, le raisonnement difficile à long horizon ou la performance en cybersécurité importent davantage que le coût unitaire.
Ce n’est pas une histoire « petit modèle vs grand modèle ». Flash est un MoE de 320B totaux/18B actifs entraîné à partir d’une nouvelle base multimodale avec une attention hybride clairsemée et linéaire. Le modèle phare est un MoE de 744B totaux/40B actifs dont les gains de GLM‑5.3 proviennent d’un post‑entraînement à l’échelle sur la base GLM‑5.2.
Points clés
- Choisissez Flash pour le codage multimodal, la compréhension de documents, les agents navigateur ou GUI, l’automatisation à grand volume et les applications sensibles au coût.
- Choisissez le modèle phare pour les tâches d’ingénierie les plus difficiles à l’échelle d’un dépôt, le raisonnement plus profond assisté par outils et la recherche en sécurité défensive.
- Les deux modèles prennent en charge un contexte de 1M de jetons, le raisonnement toujours activé, l’appel de fonctions, le streaming et le déploiement en poids ouverts.
- Sur des benchmarks rapportés par Z.ai et alignés, le modèle phare mène sur DeepSWE, NL2Repo, HLE avec outils et Agents’ Last Exam ; Flash mène sur AutomationBench, Toolathlon et GDPval‑AA v2.
- Des tests indépendants donnent au modèle phare un Intelligence Index plus élevé et une sortie plus rapide, tandis que Flash a un temps jusqu’au premier jeton légèrement meilleur et un coût mixte bien plus bas.
GLM-5.3 Flash vs GLM-5.3 en un coup d’œil
| Dimension | GLM-5.3 Flash | GLM-5.3 | Résultat pratique |
|---|---|---|---|
| Positionnement | Modèle d’agent et de codage multimodal natif et efficace | Modèle phare pour raisonnement texte, codage, agents à long horizon, cybersécurité | Selon la charge de travail |
| Taille du modèle | 320B totaux / 18B actifs | 744B totaux / 40B actifs | Flash active 55 % de paramètres en moins |
| Modèle de base | Base multimodale nouvellement entraînée sur 30T de jetons | Même base que GLM‑5.2 ; gains issus du post‑entraînement | Voies de développement différentes |
| Entrée / sortie | Entrées texte + visuelles / sortie texte | Entrée texte / sortie texte | Flash pour les workflows visuels |
| Contexte / sortie max | 1M / 128K | 1M / 128K | Égalité |
| Effort de raisonnement | faible, élevé, max ; raisonnement toujours activé | faible, élevé, max ; raisonnement toujours activé | Égalité |
| Indice d’intelligence indépendant | 57 | 60 à effort max | GLM‑5.3 |
| Vitesse de sortie indépendante | 50.2 tokens/s | 76.6 tokens/s | GLM‑5.3 dans l’API testée |
| Prix catalogue officiel entrée/sortie | $0.15 / $0.50 par 1M de jetons | $1.40 / $4.40 par 1M de jetons | Flash |
| Meilleure adéquation | Routage par défaut, agents multimodaux, passage à l’échelle | Tâches texte et sécurité les plus critiques et complexes | Utiliser un routage sélectif |
Sources : Documentation des modèles Z.ai et comparaison Artificial Analysis.
Qu’est-ce que GLM-5.3 Flash ?
Z.ai présente Flash comme le premier modèle multimodal natif de la série GLM‑5. Il possède 320B de paramètres totaux et 18B actifs, mais « Flash » ne signifie pas « petit ». Le checkpoint complet reste un très grand modèle ; son efficacité vient de l’activation d’un sous‑ensemble d’experts plus petit et d’une refonte de la pile d’attention.
Sa base a été entraînée sur un corpus multimodal de 30 billions de jetons. La vision native est intégrée dans la boucle de codage, permettant au modèle d’inspecter des captures d’écran, interfaces rendues, graphiques, mises en page et autres retours visuels avant d’affiner sa prochaine action.
Spécifications de GLM-5.3 Flash
| Spécification | GLM-5.3 Flash |
|---|---|
| Développeur | Z.ai / Zhipu AI |
| ID du modèle | glm-5.3-flash |
| Type de modèle | Mixture-of-Experts multimodal natif |
| Paramètres totaux / actifs | 320B / 18B |
| Couches | 45 |
| Architecture | Attention hybride clairsemée + attention linéaire ; mHC ; MTP |
| Corpus d’entraînement | Corpus de pré-entraînement multimodal de 30T jetons |
| Modalités d’entrée | Entrées texte et visuelles, y compris images et workflows vidéo/fichiers pris en charge |
| Modalité de sortie | Texte |
| Contexte / sortie max | 1M / 128K jetons |
| Raisonnement | Toujours activé ; effort faible, élevé, max |
| Outils | Appel de fonctions, appels d’outils en streaming, workflows structurés |
| Poids / licence | Poids ouverts ; Apache‑2.0 dans le dépôt officiel |
Sources : Documentation Flash de Z.ai et le dépôt officiel GLM‑5.
Qu’est-ce que GLM-5.3 ?
Le modèle phare est optimisé pour l’ingénierie logicielle complexe, les agents à long horizon et la cybersécurité. Z.ai indique qu’il utilise la même base que GLM‑5.2 ; la mise à niveau provient d’un post‑entraînement à l’échelle plutôt que d’un nouveau pré‑entraînement.
Le dépôt officiel liste le checkpoint à 744B de paramètres totaux dont 40B actifs. Par rapport à Flash, il active plus de deux fois plus de paramètres par jeton et alloue davantage de capacité aux raisonnements multi‑étapes difficiles.
Spécifications de GLM-5.3
| Spécification | GLM-5.3 |
|---|---|
| Développeur | Z.ai / Zhipu AI |
| ID du modèle | glm-5.3 |
| Type de modèle | Modèle phare texte Mixture‑of‑Experts |
| Paramètres totaux / actifs | 744B / 40B |
| Modèle de base | Base GLM‑5.2 ; tous les gains de GLM‑5.3 proviennent du post‑entraînement |
| Entrée / sortie | Texte / texte |
| Contexte / sortie max | 1M / 128K jetons |
| Raisonnement | Toujours activé ; effort faible, élevé, max |
| Outils | Appel de fonctions, appels d’outils en streaming, mise en cache du contexte, sortie structurée |
| Focalisation principale | Codage complexe, agents à long horizon, ingénierie, cybersécurité |
| Poids / licence | Poids ouverts sous la licence GLM‑5.3 distincte ; code du dépôt de support sous Apache‑2.0. |
Sources : documentation du modèle phare Z.ai et dépôt officiel GLM‑5.
Architecture : pourquoi Flash est moins cher sans être petit
Flash alterne des blocs d’attention linéaire et d’attention clairsemée et utilise mHC autour des composants d’attention et de MoE. Son mécanisme IndexPool compresse quatre vecteurs de clés d’indexeur en un seul. Z.ai rapporte un calcul d’attention par couche 3,01× inférieur et un cache KV par couche 4,44× plus petit que le modèle phare à une longueur de séquence de 1M de jetons.
Ce sont des comparaisons au niveau de l’architecture, pas des multiplicateurs garantis de latence de bout en bout. La vitesse réelle d’une API dépend aussi du matériel, de la quantification, du batching, de la longueur du raisonnement, du logiciel de service et de la charge du fournisseur.
Architecture d’attention hybride de GLM‑5.3‑Flash et comparaison du calcul/cache en contexte long.
Source : documentation officielle de l’architecture Z.ai
Performances de référence : où chaque modèle l’emporte
La comparaison la plus propre sépare les benchmarks de tâches rapportés par le fournisseur des mesures API indépendantes. Même lorsque les noms de benchmarks correspondent, les versions des harnais, les configurations d’outils, la gestion du contexte et l’effort de raisonnement peuvent différer. Le tableau ci‑dessous utilise les valeurs les plus proches dans l’évaluation du modèle phare et l’évaluation de Flash, en traitant les petits écarts comme directionnels plutôt que définitifs.
| Benchmark | GLM-5.3 Flash | GLM-5.3 | Score le plus élevé | Ce que ça évalue |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 88.2 | GLM-5.3 | Codage terminal et agentique |
| DeepSWE v1.1 | 63.4 | 66.9 | GLM-5.3 | Ingénierie logicielle |
| NL2Repo | 56.3 | 58.0 | GLM-5.3 | Génération de dépôt |
| Toolathlon Verified | 78.4 | 73.0 | Flash | Utilisation d’outils |
| AutomationBench | 48.8 | 48.2 | Quasi égalité / Flash | Automatisation de l’utilisation de l’ordinateur |
| Agents’ Last Exam | 26.3 | 28.5 | GLM-5.3 | Raisonnement d’agent à long horizon |
| HLE with tools | 55.3 | 62.5 | GLM-5.3 | Raisonnement difficile assisté par outils |
| GDPval-AA v2 | 1773 Elo | 1769 Elo | Quasi égalité / Flash | Travail de connaissance professionnel |
Sources : évaluation du modèle phare et évaluation de Flash. Comparer de manière directionnelle car les configurations d’évaluation peuvent différer.
Codage et ingénierie de dépôt
Le modèle phare a un plafond de performance plus élevé. Il devance Flash de 3,5 points sur DeepSWE et de 1,7 point sur NL2Repo. Sur Z.ai Code Bench v1.0, avec les deux modèles évalués à l’aide de Claude Code 2.1.207, le modèle phare atteint 34.5% à effort max, tandis que Flash atteint 29.0 % — un avantage de 5.5 points.
Flash reste suffisamment compétitif pour être le premier modèle testé pour la maintenance routinière de dépôts, la génération de tests, le débogage, le refactoring et les agents de codage à grand volume. N’escalader vers le modèle phare que les tâches les plus difficiles ou les trajectoires échouées.
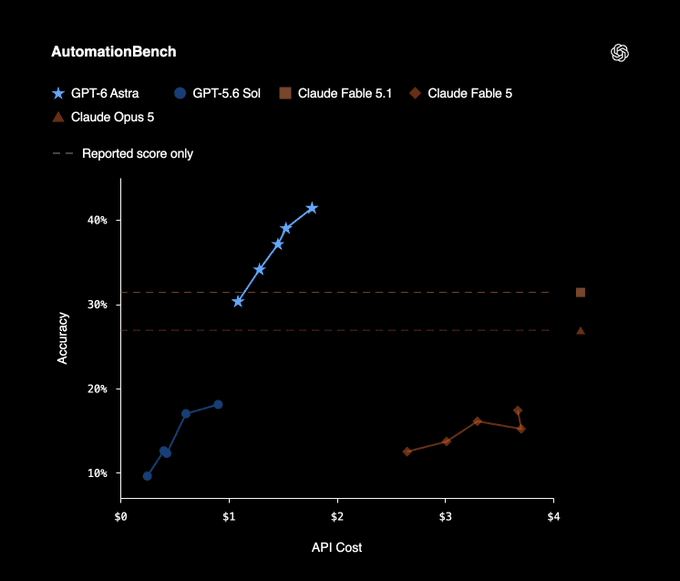
Évaluation en six benchmarks par Z.ai de GLM‑5.3‑Flash et d’autres modèles de codage/agents.
Source : documentation officielle Flash de Z.ai
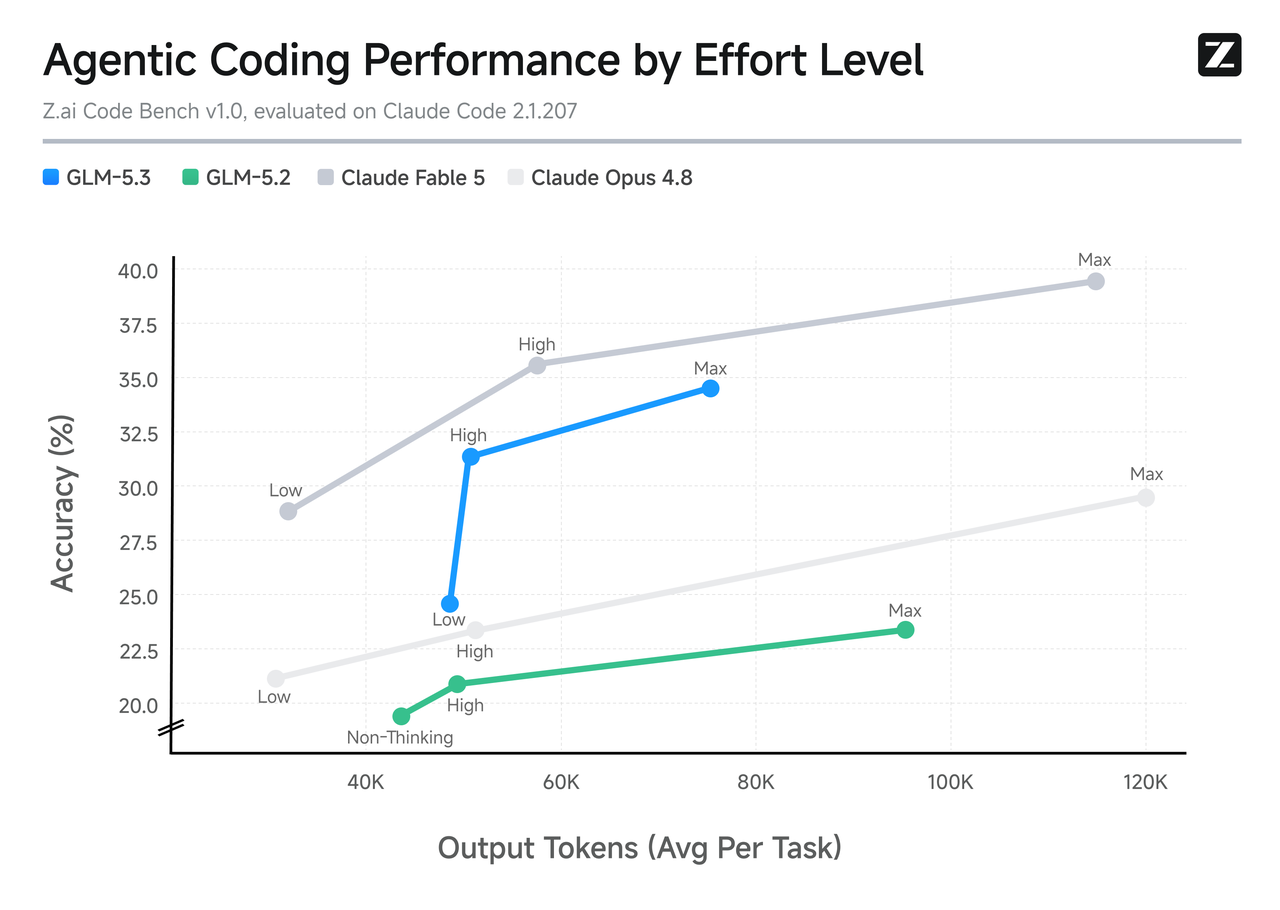
Précision du codage agentique GLM‑5.3 et utilisation de jetons de sortie selon les niveaux d’effort de raisonnement.
Source : documentation officielle du modèle phare
Utilisation d’outils, automatisation et travail de connaissance
Flash n’est pas uniformément plus faible. Il obtient 78.4 sur Toolathlon Verified contre 73.0 pour le modèle phare, et devance sur AutomationBench 48.8 contre 48.2. Il est essentiellement à égalité sur GDPval‑AA v2. Cela rend Flash particulièrement attractif lorsque la tâche consiste moins en une chaîne de raisonnement extrêmement difficile qu’en une coordination fiable des outils au fil de nombreuses requêtes peu coûteuses.
Intelligence, vitesse et latence indépendantes
| Mesure indépendante | GLM-5.3 Flash | GLM-5.3 (max) | Résultat |
|---|---|---|---|
| Indice d’intelligence Artificial Analysis | 57 | 60 | GLM-5.3 |
| Vitesse de sortie | 50.2 tokens/s | 76.6 tokens/s | GLM-5.3 |
| Temps jusqu’au premier jeton | 1.49 s | 1.61 s | Flash |
| Fenêtre de contexte | 1M | 1M | Égalité |
| Prix pondéré dans la comparaison AA | $0.10 / 1M jetons | $0.90 / 1M jetons | Flash |
Source : comparaison API alignée Artificial Analysis.
Le résultat indépendant ajoute une correction importante à l’hypothèse « Flash signifie plus rapide ». Flash répond légèrement plus tôt, mais l’endpoint du modèle phare testé génère des jetons plus rapidement une fois la sortie commencée. Traitez ces mesures comme des instantanés spécifiques au fournisseur, non comme des propriétés immuables du modèle.
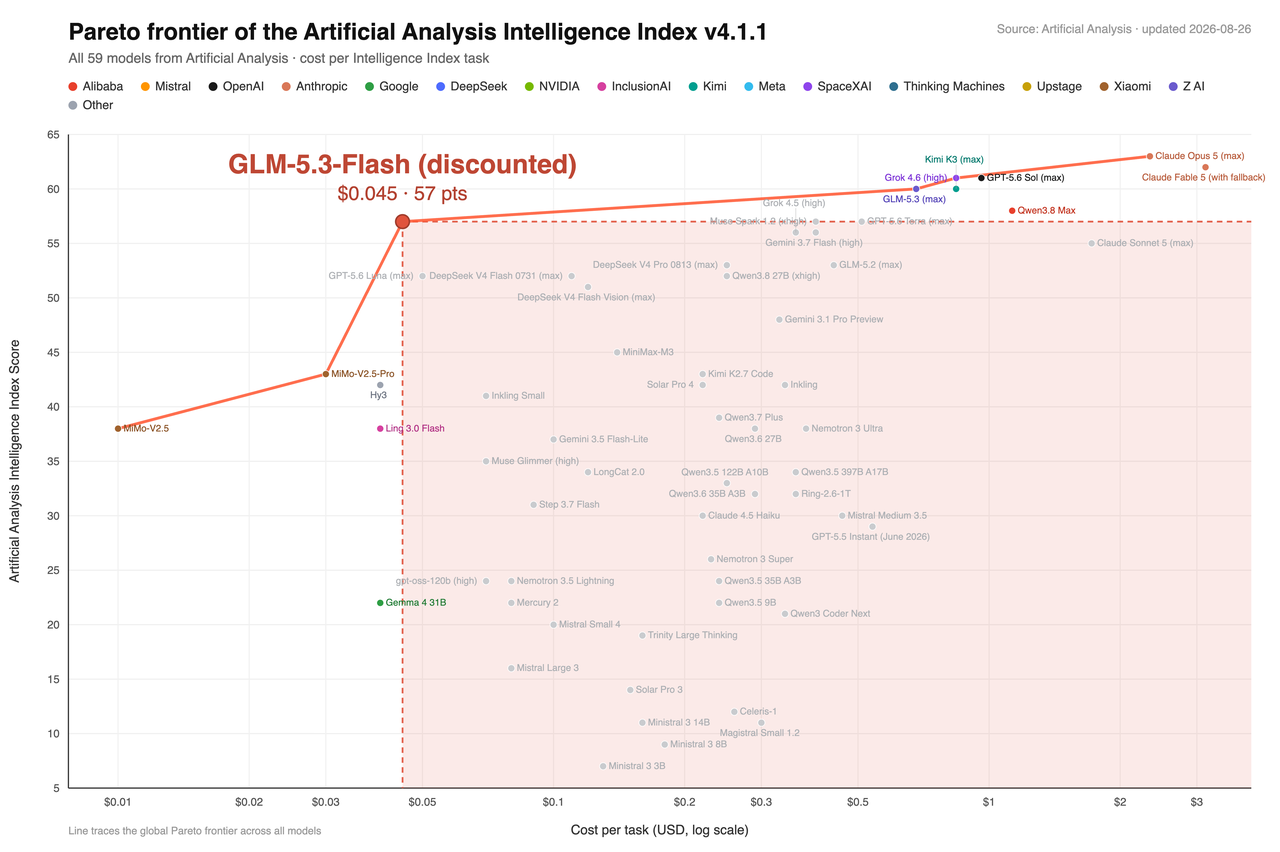
Frontière coût–intelligence d’Artificial Analysis reproduite dans la documentation officielle Flash de Z.ai.
Source : documentation officielle Flash de Z.ai
Multimodalité : Flash a l’avantage net
Flash accepte des entrées visuelles et les intègre dans des workflows agentiques. Il peut inspecter des captures d’écran, des images de page, des graphiques, des états d’interface, des enregistrements d’écran et des fichiers pris en charge, puis utiliser les preuves visuelles pendant le codage ou l’utilisation d’outils. Le modèle phare prend actuellement en charge l’entrée texte uniquement.
- Frontend et design‑to‑code : Flash peut inspecter une capture d’écran de référence et valider l’implémentation rendue.
- Workflows Document et Office : Flash peut raisonner sur la structure de page, les graphiques, la mise en page et le placement des images.
- Utilisation du navigateur et de l’ordinateur : Flash peut combiner l’état visuel avec des appels d’outils et des corrections itératives.
- Travail de dépôt purement texte : le modèle phare reste préférable lorsque l’entrée est du code et du texte et que la tâche exige une profondeur de raisonnement maximale.
Contexte long et contrôles de raisonnement
GLM‑5.3 Flash prend en charge une fenêtre de contexte de 1M de jetons et jusqu’à 128K jetons de sortie ; GLM‑5.3 fournit les mêmes limites. Les deux maintiennent le raisonnement activé et acceptent les niveaux d’effort faible, élevé et max. Z.ai recommande « max » pour le codage difficile et la reproduction de benchmarks.
La capacité de contexte n’est donc pas le principal différenciateur. La différence réside dans l’économie de service des longues séquences et dans la quantité de capacité de raisonnement mobilisable pour les tâches les plus dures. Flash est architecturalement moins coûteux en contexte long ; le modèle phare a un plafond de qualité plus élevé.
Cybersécurité : GLM-5.3 est le spécialiste
La cybersécurité est la capacité la plus distinctive du modèle phare. Z.ai rapporte 84.5 sur CyberGym et 54.4 sur ExploitBench. Avec des budgets normalisés de deux et six heures, il a complété 105 et 130 tâches ExploitGym.
Flash n’a pas d’accent équivalent au lancement ni de suite cyber publique assortie. Pour la revue de code, le développement sécurisé et la découverte autorisée de vulnérabilités, utilisez le modèle phare comme modèle principal et conservez l’approbation humaine, des outils isolés, des journaux d’audit et des contrôles de divulgation dans le workflow.
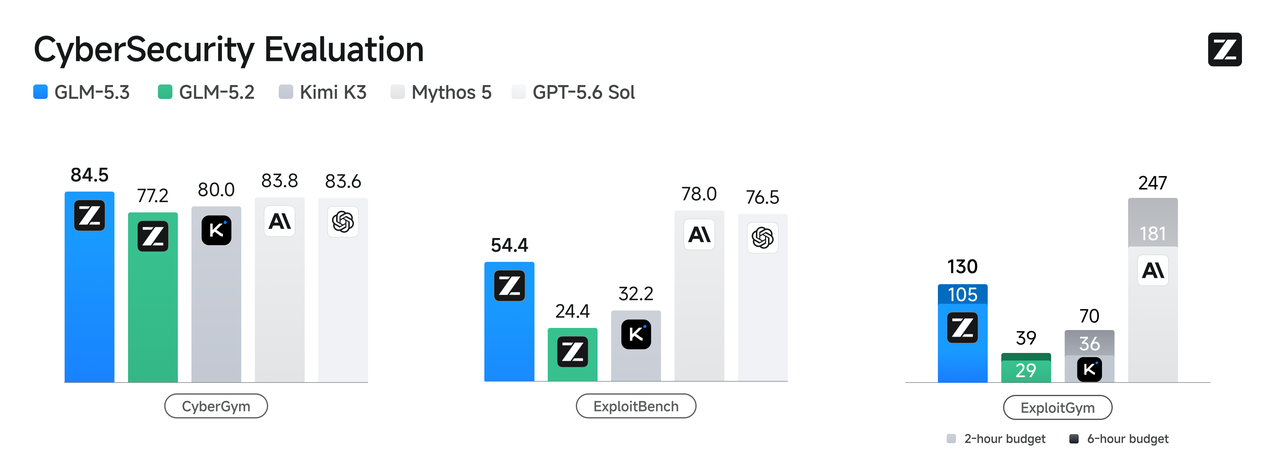
Performance de GLM‑5.3 sur des benchmarks de découverte de vulnérabilités et de chaînes d’exploitation.
Source : documentation officielle cybersécurité de Z.ai
Coût et déploiement
Tarification API
Z.ai liste Flash à $0.15 par million de jetons d’entrée et $0.50 par million de jetons de sortie avant promotions, contre $1.40 et $4.40 pour le modèle phare.
| Voie d’accès | Entrée Flash | Flash mis en cache | Sortie Flash | Entrée 5.3 | 5.3 mis en cache | Sortie 5.3 |
|---|---|---|---|---|---|---|
| Tarif standard Z.ai | $0.15 | $0.03 | $0.50 | $1.40 | $0.26 | $4.40 |
| Tarif promotionnel Flash Z.ai | $0.075 | $0.015 | $0.25 | $1.40 | $0.26 | $4.40 |
| Voie CometAPI | $0.06 | Vérifier la voie en direct | $0.20 | $1.12 | Vérifier la voie en direct | $3.528 |
Les prix sont en USD par 1M de jetons. Sources : tarification Z.ai, voie Flash et voie GLM‑5.3. Les promotions peuvent changer.
Exemple de coût mensuel
Pour une charge utilisant 100M de jetons d’entrée et 20M de jetons de sortie, les tarifs CometAPI actuels produisent une estimation de $10.00 pour Flash contre $182.56 pour le modèle phare, avant effets de cache ou frais d’outils. Dans cet exemple, Flash réduit la facture de jetons d’environ 94,5 %.
| Composant de coût | GLM-5.3 Flash | GLM-5.3 |
|---|---|---|
| Coût d’entrée | 100 × $0.06 = $6.00 | 100 × $1.12 = $112.00 |
| Coût de sortie | 20 × $0.20 = $4.00 | 20 × $3.528 = $70.56 |
| Total | $10.00 | $182.56 |
Poids ouverts et auto-hébergement
Les deux modèles disposent de checkpoints FP8 et BF16 téléchargeables. Les poids de GLM‑5.3 Flash sont publiés sous licence MIT. GLM‑5.3 utilise la licence GLM‑5.3 distincte, qui exige un examen de sécurité avant usage commercial par des opérateurs Model‑as‑a‑Service dont les revenus agrégés dépassent US$10 billion sur 12 mois consécutifs. Le dépôt GitHub GLM‑5 d’accompagnement est sous Apache‑2.0.
Flash est plus facile à servir que le modèle phare, mais ce n’est pas un modèle pour GPU grand public. Le checkpoint 320B, les composants multimodaux, le cache KV et le contexte 1M exigent toujours une infrastructure conséquente. L’auto‑hébergement est surtout attractif lorsque le contrôle des données, le service personnalisé ou une forte utilisation soutenue justifient le coût opérationnel.
Quel modèle choisir ?
Choisir GLM-5.3 Flash si ?
- Vous avez besoin de compréhension d’images, captures d’écran, graphiques, documents, navigateur ou GUI.
- Vous exécutez des agents de codage à grand volume, des workflows de recherche ou de l’automatisation métier.
- Vous voulez une forte utilisation d’outils et des performances en travail de connaissance au plus bas coût par jeton.
- Vous avez besoin d’une fenêtre de contexte de 1M mais ne voulez pas les économies du modèle phare sur chaque requête.
- Vous envisagez l’auto‑hébergement et 320B/18B est plus pratique que 744B/40B.
Choisir GLM-5.3 si ?
- Vous résolvez les tâches d’ingénierie les plus difficiles à l’échelle d’un dépôt.
- Votre évaluation récompense un raisonnement plus profond plus que le faible coût unitaire.
- Vous avez besoin du meilleur résultat sur DeepSWE, HLE avec outils ou Agents’ Last Exam.
- Vous construisez des workflows de sécurité défensive ou de découverte de vulnérabilités autorisés.
- Un taux de réussite plus élevé peut compenser une prime de jetons d’environ un ordre de grandeur.
Matrice de décision par cas d’usage
| Charge de travail | Modèle de départ recommandé | Pourquoi |
|---|---|---|
| Chat et automatisation à fort volume | GLM-5.3 Flash | Coût beaucoup plus bas ; forte utilisation d’outils |
| Codage visuel et débogage d’IU | GLM-5.3 Flash | Entrée visuelle native |
| Analyse de documents, graphiques et Office | GLM-5.3 Flash | Workflows professionnels multimodaux |
| Maintenance de dépôt routinière | Commencer avec Flash | Escalader les tâches échouées ou inhabituellement difficiles |
| Ingénierie de dépôt difficile à grande échelle | GLM-5.3 | Plafond de codage plus élevé |
| Recherche à long horizon avec outils | GLM-5.3 | Meilleur résultat HLE avec outils |
| Sécurité défensive et découverte de vulnérabilités | GLM-5.3 | Entraînement et benchmarks cyber dédiés |
| Auto‑hébergement sensible au coût | GLM-5.3 Flash | Empreinte active et totale plus petite |
| Charge mixte incertaine | Routage hybride | Flash par défaut ; escalade vers le modèle phare |
Une meilleure stratégie de production : router, ne pas remplacer
Pour la plupart des équipes, le meilleur design n’est pas un choix exclusif. Utilisez Flash comme route par défaut, puis n’escaladez que les tâches à forte complexité, à validation échouée, sensibles à la sécurité, ou dont la valeur économique attendue justifie la prime du modèle phare.
- Envoyez les tâches visuelles, routinières et à grand volume vers Flash.
- Mesurez le taux d’acceptation, les jetons, la latence, les échecs d’outils et l’intervention humaine.
- Escaladez les tâches texte échouées ou à haut risque vers le modèle phare.
- Faites transiter le travail sensible à la sécurité via des contrôles d’autorisation et de sandbox supplémentaires.
- Optimisez le coût par résultat accepté plutôt que le rang de benchmark ou le prix seul.
Comment tester les deux modèles via CometAPI
CometAPI référence la voie GLM‑5.3 Flash et la voie GLM‑5.3 derrière la même URL de base compatible OpenAI. Créez une clé API, puis exécutez la même tâche texte via les deux identifiants de modèle. Pour un test équitable, conservez le prompt, l’effort de raisonnement, les définitions d’outils, la sortie maximale et la grille d’acceptation identiques.
Python
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["glm-5.3-flash", "glm-5.3"]

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "user",
                "content": "Review this migration plan and identify its three highest-risk assumptions.",
            }
        ],
    )
    print(model, response.choices[0].message.content)
Pour l’évaluation multimodale, utilisez la documentation de la voie Flash en direct pour vérifier le schéma de contenu image pris en charge. La comparaison avec le modèle phare doit utiliser un équivalent texte uniquement car il n’accepte pas l’entrée visuelle.
Limites de cette comparaison
- Plusieurs scores de codage et d’agents sont rapportés par le fournisseur. La reproduction indépendante peut utiliser des outils, prompts et paramètres d’inférence différents.
- Des noms de benchmarks appariés ne garantissent pas toujours des versions de harnais ou des stratégies de gestion du contexte identiques.
- Les réductions au niveau de l’architecture du calcul d’attention et du cache KV ne prédisent pas directement la latence d’API.
- Les prix, promotions, disponibilités de modèles, limites de taux et capacités des voies peuvent changer ; vérifiez les pages de modèles en direct avant le déploiement.
- Des poids ouverts ne rendent pas l’auto‑hébergement peu coûteux à plein contexte pour l’un ou l’autre checkpoint.
- Les capacités en cybersécurité sont à double usage et exigent autorisation, sandboxing, journalisation, revue d’experts et divulgation responsable.
Conclusion
GLM‑5.3 Flash est le défaut pratique. Il préserve le contexte long, ajoute la vision native, performe fortement en utilisation d’outils et en travail professionnel, et modifie suffisamment l’économie pour permettre un déploiement beaucoup plus large. GLM‑5.3 est le modèle d’escalade spécialiste : plus coûteux, texte uniquement, mais plus fort sur le codage, le raisonnement et les tâches de cybersécurité les plus difficiles.
Le verdict final est donc fondé sur la charge de travail : commencez avec Flash, mesurez le taux réel d’acceptation, et routez vers le modèle phare uniquement lorsque sa capacité de raisonnement additionnelle produit suffisamment de résultats supplémentaires réussis pour justifier la prime.
Foire aux questions
GLM-5.3 Flash est-il meilleur que GLM-5.3 ?
Pas universellement. Flash est meilleur en prix, multimodalité et sur plusieurs benchmarks d’outils/automatisation. Le modèle phare est plus fort sur le codage le plus difficile, le raisonnement assisté par outils et les charges de cybersécurité.
GLM-5.3 Flash est-il un petit modèle ?
Non. Il a 320B de paramètres totaux et en active 18B par jeton. Il est plus efficace que le modèle phare 744B/40B, mais exige toujours un matériel substantiel pour l’auto‑hébergement.
Quel modèle est le moins cher ?
Flash est nettement moins cher. Le tarif catalogue standard de Z.ai est environ un dixième du prix du modèle phare, et les voies CometAPI actuelles montrent un écart encore plus grand tant que la promotion est active.
Quel modèle est le plus rapide ?
Cela dépend de la métrique et du fournisseur. Artificial Analysis a mesuré un temps jusqu’au premier jeton légèrement inférieur pour Flash mais une vitesse de sortie plus élevée pour le modèle phare.
Quel modèle prend en charge les images ?
Flash prend en charge l’entrée visuelle native. Le modèle phare prend actuellement en charge l’entrée texte uniquement.
Les deux modèles prennent-ils en charge un contexte de 1M de jetons ?
Oui. Flash prend en charge 1M de contexte et jusqu’à 128K de sortie ; le modèle phare fournit les mêmes limites.
Quel modèle est meilleur pour le codage ?
Utilisez Flash pour les agents de codage routiniers et à grand volume. Utilisez le modèle phare pour les tâches d’ingénierie à l’échelle d’un dépôt les plus difficiles ou lorsque l’échec coûte plus que la différence de prix.
Quel modèle est meilleur pour la cybersécurité ?
Le modèle phare. Z.ai l’a spécifiquement entraîné et évalué pour la découverte de vulnérabilités et le raisonnement sur les chaînes d’exploitation. Utilisez‑le uniquement dans des environnements autorisés et contrôlés.
Les deux modèles peuvent-ils être auto‑hébergés ?
Oui. Le dépôt de Z.ai répertorie des checkpoints téléchargeables et des frameworks de service pris en charge, mais les deux restent de grands projets d’infrastructure.
Quelle est la meilleure stratégie de déploiement ?
Utilisez Flash comme route par défaut et escaladez les tâches texte difficiles, échouées ou sensibles à la sécurité vers le modèle phare. Mesurez le coût par résultat accepté.