
TL;DR
GLM 5.4 est un nom communautaire pour un successeur possible de la famille GLM de Z.ai. Au 14 octobre 2026, la documentation officielle du modèle et les dossiers de sortie examinés pour cet article n’établissent pas de lancement, de fiche de spécifications ni d’identifiant d’API pour GLM-5.4. Union Alpha est une piste de rumeur, tandis qu’un lancement en octobre est une possibilité fondée sur la cadence. La question utile est de savoir si une future version améliore la fiabilité en programmation et le coût par tâche complétée ; les modèles GLM existants fournissent la référence pour cette évaluation.
Points clés
- Statut de sortie : Les sources officielles examinées le 14 octobre 2026 ne confirment pas GLM-5.4 ; aucune date de lancement exacte n’est établie.
- Preuves des rumeurs : L’association d’Union Alpha avec GLM-5.4 reste non vérifiée, et la synthèse citée n’identifie pas de publication d’attribution originale.
- Référence de performance : Les résultats existants de GLM-5.3 sont un contexte utile, mais ce ne sont pas des mesures de GLM-5.4.
- Architecture : GLM-5.3-Flash montre une direction différente axée sur l’efficacité et la multimodalité ; l’héritage par GLM-5.4 reste une question ouverte.
- Action des développeurs : Évaluer maintenant les modèles disponibles et exiger des identifiants de modèle vérifiés, la compatibilité et des mesures au niveau des tâches avant de mettre à niveau.
GLM 5.4 a-t-il été publié ?
GLM 5.4 est un nom non officiel pour un GLM potentiel successeur. L’index de la documentation officielle et les archives de publication examinés au 14 octobre 2026 identifient des modèles GLM existants mais n’établissent pas de sortie produit GLM-5.4. Il s’agit d’une vérification des sources datée, et non d’une preuve qu’aucun développement privé n’existe.
Deux trajectoires de développement documentées expliquent pourquoi un successeur possible attire l’attention.
Z.ai confirme que GLM-5.3 réutilise le modèle de base GLM-5.2 et obtient ses gains via le post-entraînement. GLM-5.3-Flash utilise au contraire une nouvelle base multimodale et une architecture d’attention hybride. Ces faits décrivent des modèles existants, et non une conception GLM-5.4 divulguée.
En pratique, une voie améliore un modèle existant par entraînement supplémentaire, tandis que l’autre redessine l’architecture pour réduire les coûts de calcul et prendre en charge de nouvelles capacités.
Un futur GLM-5.4 pourrait s’appuyer sur l’une ou l’autre direction, mais il n’y a pas encore suffisamment d’éléments pour déterminer l’approche que Z.ai sélectionnera.
Quelle est la fiabilité des rumeurs et fuites sur GLM-5.4 ?
Informations confirmées
La base technique confirmée provient de GLM-5.3 et GLM-5.3-Flash, pas de GLM-5.4. Le nom GLM-5.4, les spécifications finales, la date de sortie et les résultats de benchmarks restent non confirmés dans les sources officielles examinées pour cet article.
Rapports communautaires / Fuites
Un post X du 8 octobre 2026 par @NFT_Chen attribue une direction de développement possible GLM-5.4/5.5 à des commentaires de Tang Jie. Le post décrit trois priorités de scaling : étendre le pré-entraînement, renforcer le post-entraînement via SFT, RLHF et RLVR, et étendre le raisonnement et l’exécution d’agents sur des tâches plus difficiles et plus longues.
L’auteur interprète la prochaine direction comme des agents autonomes plus longs et une auto-amélioration récursive (RSI). Il s’agit d’un compte rendu communautaire d’une présentation, plutôt qu’une annonce de sortie de Z.ai. Les noms de versions et les affirmations de développement restent attribués au post ; ils n’établissent pas une date de lancement, une architecture finale, un nombre de paramètres, ni une capacité d’auto-amélioration démontrée pour GLM-5.4.
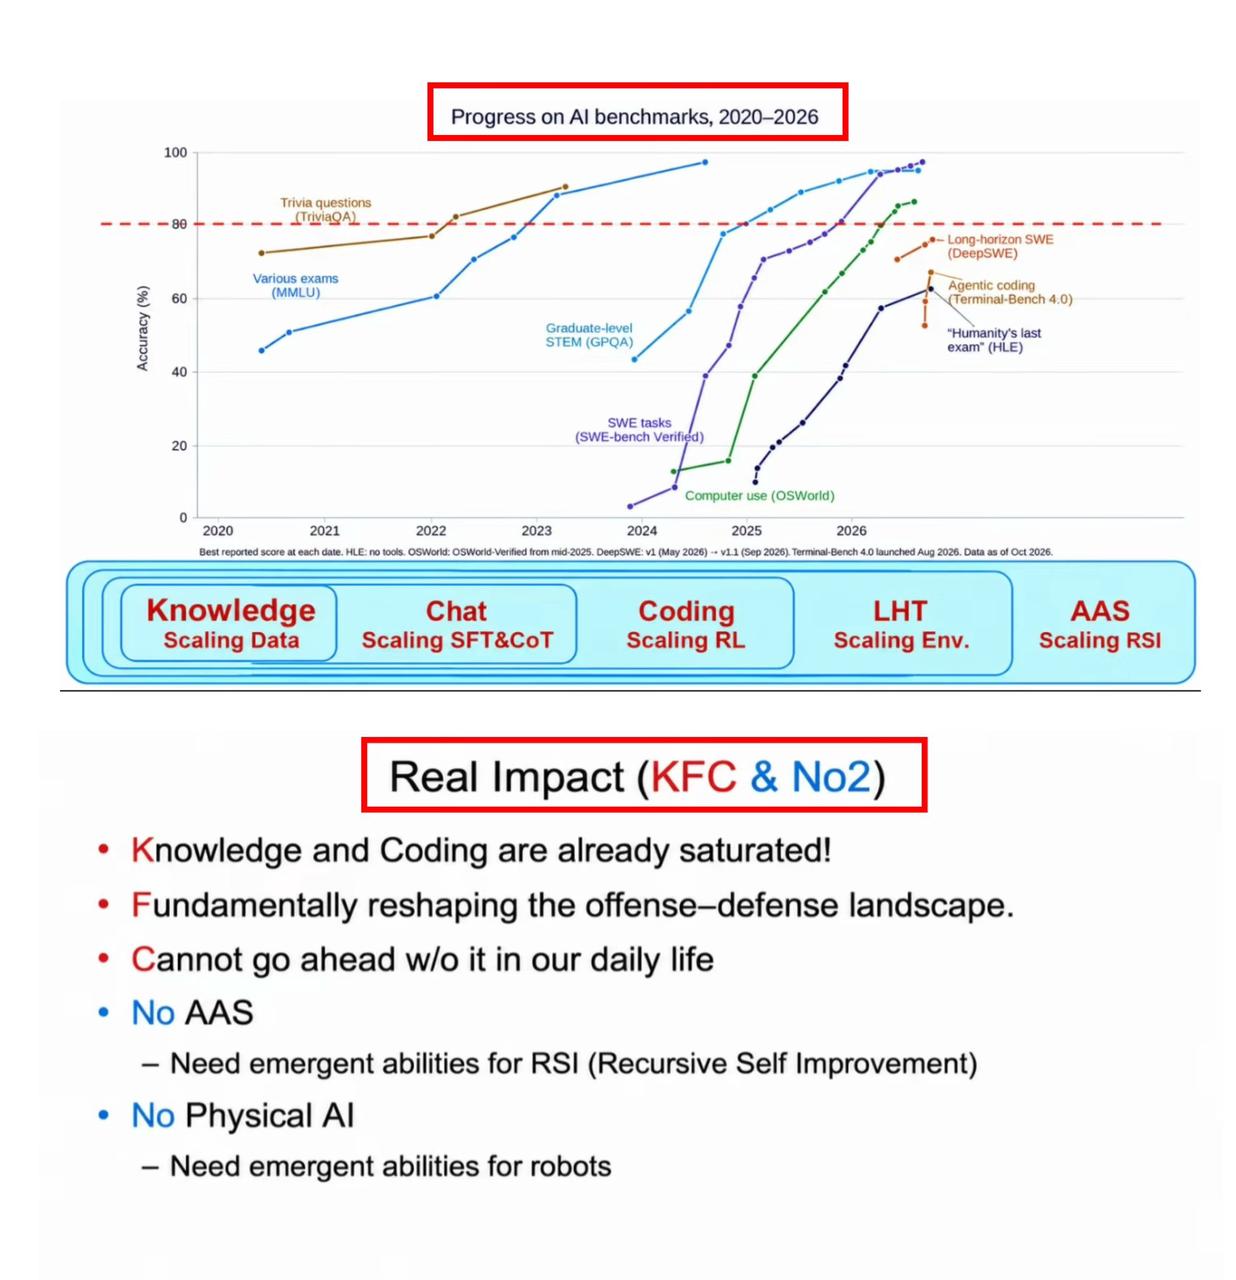
Image de diapositive de présentation jointe au post X original de @NFT_Chen, 8 octobre 2026. Elle traite des progrès sur les benchmarks et de la RSI comme direction future ; ce n’est pas un rapport de benchmark GLM-5.4.
Photographie de la présentation jointe au post X original de @NFT_Chen, 8 octobre 2026.
Analyse
Une analyse utile des rumeurs demande quelle observation changerait la conclusion. Un identifiant de modèle officiel, une annonce de sortie ou une correspondance divulguée à partir d’un alias anonyme renforceraient matériellement le dossier. Un motif de nommage similaire ou un simple intervalle de sortie ne peut pas le faire. D’anciennes spéculations sur d’autres futurs numéros de version GLM n’établissent pas les spécifications de GLM-5.4.
Quand GLM 5.4 pourrait-il être publié ?
La chronologie des notes de version de Z.ai consigne GLM-5 le 12 février, GLM-5.1 le 7 avril, GLM-5.2 le 16 juin, GLM-5.3 le 18 août et GLM-5.3-Flash le 26 août 2026. Ce sont des dates consignées dans les notes de version ; il ne faut pas les confondre avec chaque annonce de recherche ou date de disponibilité chez un fournisseur.
La progression approximative de deux mois des versions principales fait d’octobre une fenêtre analytique raisonnable à surveiller. Elle n’établit pas un lancement en octobre, un jour spécifique, ni même le prochain nom de version. Sans source de prévision traçable et sa méthodologie, une prédiction exacte au 20 octobre ou au 23 octobre impliquerait une précision supérieure à ce que les éléments probants permettent.
Un lancement plus tardif, un nom différent ou une variante de produit distincte restent possibles. Les développeurs doivent planifier autour des API actuellement disponibles plutôt que d’une estimation calendaire.
Quelles sont les spécifications attendues de GLM 5.4 ?
Aucune fiche de spécifications fiable pour GLM-5.4 n’est disponible. Plutôt que d’attribuer du matériel et des paramètres de modèle supposés à un produit non sorti, il est plus informatif de comparer les derniers modèles GLM documentés et d’identifier ce qui reste inconnu.
| Spécification | GLM-5.3 | GLM-5.3-Flash | GLM-5.4 |
|---|---|---|---|
| Sortie | August 18, 2026 | August 26, 2026 | Non annoncé |
| Base du modèle | Base GLM-5.2 ; post-entraînement | Nouvelle base multimodale | Inconnu |
| Architecture | Base MoE | MoE ; attention hybride clairsemée-linéaire | Inconnu |
| Support de contexte | API avec contexte 1M documenté | 1M | Inconnu |
| Multimodalité native | Entrée texte uniquement | Entrées texte, image, vidéo et fichier | Inconnu |
| Accent principal | Programmation, agents, cybersécurité | Efficacité, programmation, multimodalité | Inconnu |
| Benchmarks publiés | Disponibles | Disponibles | Non disponibles |
| Poids du modèle | Publiés | Publiés | Non disponibles |
Le tableau rapporte les capacités documentées des modèles existants. Les entrées GLM-5.4 restent inconnues plutôt que d’hériter de valeurs d’un prédécesseur. Le contexte d’évaluation d’un modèle, la fenêtre de contexte API et la longueur maximale de sortie sont des limites distinctes.
L’aperçu d’architecture de GLM-5.3-Flash rapporte 320B paramètres totaux, 18B paramètres activés et une attention hybride clairsemée-linéaire. Ce sont des spécifications divulguées pour Flash et elles ne doivent pas être attribuées à GLM-5.4.
Programmation agentique comme direction de mise à niveau potentielle
La programmation agentique est l’un des domaines les plus crédibles à surveiller. GLM-5.3 a déjà démontré que le scaling du post-entraînement peut améliorer substantiellement les performances sur des tâches d’ingénierie multi-étapes. Ses développeurs ont mis l’accent sur le travail sur des dépôts complexes, des horizons d’exécution plus longs et une meilleure résolution de problèmes pilotée par outils.
Un futur modèle pourrait étendre ces capacités via une meilleure interaction avec l’environnement, une planification plus fiable et moins d’appels d’outils échoués.
L’évaluation la plus utile ne consisterait pas simplement à mesurer le pourcentage de questions de programmation répondues correctement. Elle mesurerait la capacité d’un agent à mener à bien des tâches compliquées de bout en bout, y compris le débogage, les tests, la révision et la récupération après des échecs.
Architecture multimodale efficiente comme direction possible
GLM-5.3-Flash fournit un point de référence architectural pour le développement futur, tandis qu’aucune source officielle examinée n’établit son utilisation dans GLM-5.4.
Z.ai décrit un corpus de pré-entraînement multimodal de 30T tokens dans le cadre de la conception orientée efficacité de GLM-5.3-Flash. Cela décrit l’échelle des données d’entraînement d’un modèle existant et ne constitue pas un engagement de feuille de route pour GLM-5.4.
L’aperçu officiel de Flash rapporte un calcul d’attention 3.01× plus faible et des exigences de cache KV 4.44× plus faibles par rapport à GLM-5.3 dans la comparaison indiquée. Ce sont des résultats d’efficacité au niveau des composants, pas une garantie d’accélération en production ni de remise d’API.
Ce sont des améliorations d’ingénierie significatives, mais rien ne confirme que GLM-5.4 héritera de la même architecture. Un modèle de prochaine génération plus grand pourrait privilégier la performance de raisonnement maximale, tandis qu’une variante Flash séparée pourrait continuer à optimiser la latence et le coût.
GLM 5.4 vs GLM-5.3 vs GLM-5.3-Flash
Référence de benchmark GLM-5.3
Les données de benchmark disponibles étayent une analyse de la trajectoire de performance de GLM-5.3, pas une mesure directe de GLM-5.4. Les valeurs ci-dessous sont les évaluations rapportées par Z.ai pour des modèles existants. Elles n’ont pas été reproduites indépendamment pour cet article et ne mesurent pas GLM-5.4. Chaque benchmark utilise son propre jeu de tâches et sa méthode de scoring ; les différences de scores ne doivent pas être interprétées comme des gains équivalents à travers les tâches.
| Benchmark et méthodologie | GLM-5.2 | GLM-5.3 | GLM-5.3-Flash | Différence GLM-5.3 vs GLM-5.2 |
|---|---|---|---|---|
| Terminal Bench 3.0 | 4.6 | 28.3 | Non rapporté dans la comparaison Flash citée | +23.7 points |
| DeepSWE v1.1 | 46.2 | 66.9 | 63.4 | +20.7 points |
| AutomationBench v1.0.6 | 26.2 | 48.2 | 48.8 | +22.0 points |
| CyberGym | 77.2 | 84.5 | Non rapporté dans la comparaison Flash citée | +7.3 points |
| ExploitBench | 24.4 | 54.4 | Non rapporté dans la comparaison Flash citée | +30.0 points |
| HLE with Tools | 54.7 | 62.5 | 55.3 | +7.8 points |
| GDPval-AA v2 | 1508 | 1769 | Non rapporté dans la comparaison Flash citée | +261 Elo |
| Toolathlon Verified | 59.9 | Non rapporté dans la comparaison GLM-5.3 citée | 78.4 | Non disponible |
Le tableau combiné place côte à côte les résultats de modèles existants ; il ne contient aucune mesure de GLM-5.4. Une valeur non rapportée n’est pas un score nul. Gardez à l’esprit les conditions d’évaluation propres à chaque benchmark et traitez les différences de GDPval-AA comme des Elo, et non comme des points de pourcentage.
Méthodologie : DeepSWE v1.1 utilise mini-swe-agent, température 0.95, top_p 1.0, un délai d’expiration de six heures et un contexte 400K. AutomationBench utilise la v1.0.6. HLE with Tools utilise température 1.0, top_p 0.95, une limite de génération de 163,840 tokens et une limite de contexte de 300K avec gestion du contexte. GDPval-AA v2 utilise une échelle Elo ; sa différence n’est donc pas un gain en points de pourcentage.
Pour CyberGym et ExploitBench, Z.ai rapporte Claude Code 2.1.207 avec effort de raisonnement maximal, sans outils web, température 1.0, top_p 1.0 et une limite de sortie de 128,000 tokens. CyberGym rapporte pass@1 en exécution unique sur 1,507 tâches avec délai par tâche illimité. ExploitBench utilise jusqu’à 300 rounds d’interaction et moyenne la couverture sur 41 tâches à travers trois révisions. Les notes de bas de page de la fiche modèle fournissent les détails d’environnement spécifiques aux benchmarks.
Méthodologie Flash : DeepSWE utilise mini-swe-agent, contexte 400K et un délai d’expiration de six heures ; AutomationBench utilise la v1.0.6. Toolathlon Verified rapporte pass@1 moyenné sur trois exécutions indépendantes via le service d’évaluation officiel. HLE utilise les paramètres d’échantillonnage et de gestion du contexte décrits ci-dessus. Voir la méthodologie de la fiche modèle Flash. Ces résultats de benchmark n’établissent pas la latence en production ni le coût.
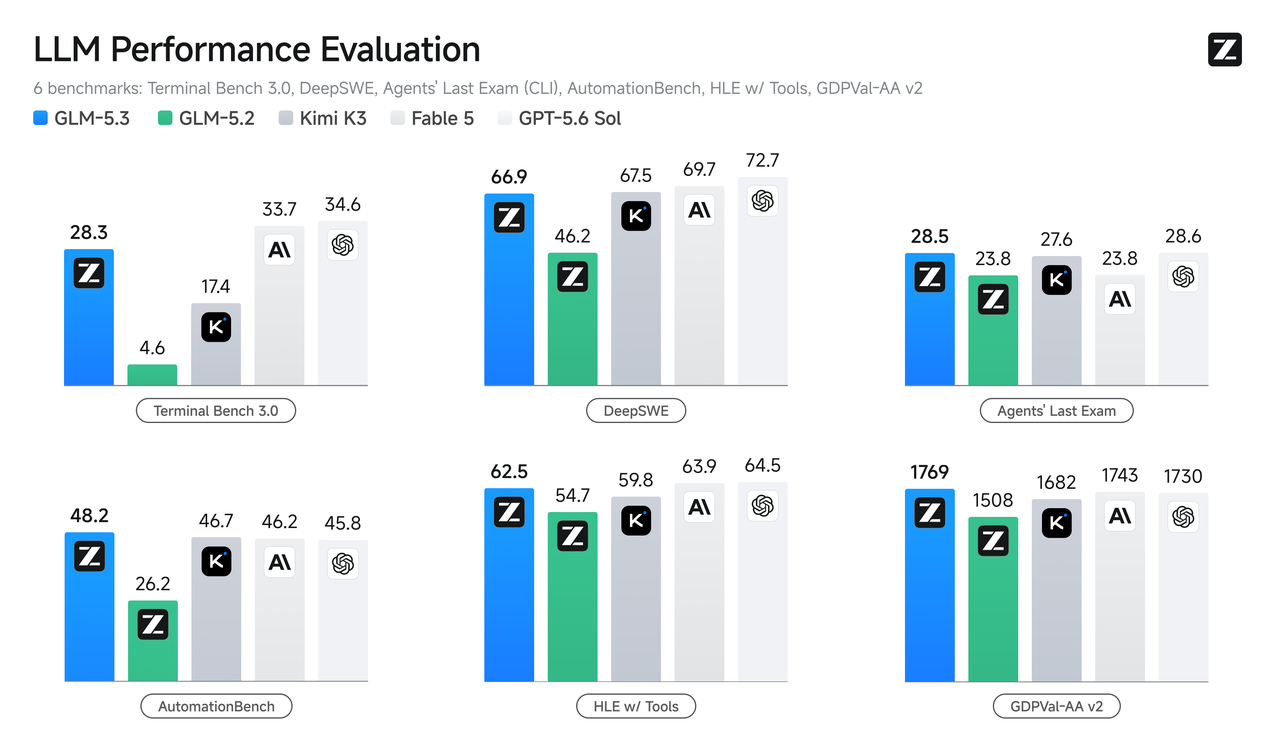
Graphique officiel des performances de GLM-5.3, reproduit à partir de l’annonce de benchmark de Z.ai. L’image montre des évaluations de modèles prédécesseurs ; elle ne contient aucun résultat GLM-5.4.
Les plus grandes améliorations apparaissent dans des tâches nécessitant une interaction soutenue avec un environnement. Terminal Bench 3.0 est passé de 4.6 à 28.3, tandis que ExploitBench est passé de 24.4 à 54.4.
Ces gains suggèrent que le post-entraînement et les environnements orientés agents peuvent transformer de manière spectaculaire la performance d’un modèle sans changer son architecture de base sous-jacente. Cependant, ils ne doivent pas être extrapolés en une prédiction numérique pour GLM-5.4.
Capacités et adéquation à la production
Pour la production, GLM-5.3 est la référence la plus solide pour la programmation complexe, l’ingénierie à long horizon et l’évaluation en cybersécurité. GLM-5.3-Flash ajoute des entrées visuelles natives et met l’accent sur l’utilisation efficiente des outils. Les offres GLM-5.2, GLM-5.3 et Flash existantes fournissent une base ; aucune capacité ni disponibilité équivalente de GLM-5.4 n’est établie dans les sources examinées pour cet article.
Les modèles documentés prennent en charge jusqu’à 1M de contexte, mais cette limite ne garantit pas un contexte utilisable identique ou une performance de tâche identique sur chaque endpoint. Faites votre choix en utilisant des charges de travail représentatives et le coût par tâche réussie.
Un futur GLM-5.4 devra offrir une amélioration mesurable pour justifier une migration. Améliorer la précision des benchmarks tout en doublant les coûts de complétion de tâches peut ne pas être attrayant pour des déploiements en production. À l’inverse, un gain de précision modeste et beaucoup moins d’appels d’outils pourrait être précieux à l’échelle.
Comparez le succès des tâches, les tokens d’entrée et de sortie, la latence, les appels d’outils échoués et le coût par tâche réussie sous le même harnais d’évaluation. Des descriptions qualitatives de modèles ne sont pas un test contrôlé en face à face.
Quel est l’état actuel de l’API GLM-5.4 sur CometAPI ?
CometAPI a créé une page dédiée au modèle GLM 5.4 avec une entrée d’identifiant de modèle stable. Cependant, la page étiquette encore le modèle comme “Coming soon” et le décrit comme un modèle pré-lancement. Les développeurs doivent vérifier l’identifiant de modèle réel, l’accès au compte, la disponibilité du point de terminaison, les paramètres pris en charge, les limites de contexte et la tarification avant de tenter une utilisation en production.
Pour une intégration documentée actuellement, utilisez un modèle GLM disponible tel que GLM-5.2 ou GLM-5.3. La page GLM-5.4 de CometAPI doit actuellement être traitée comme une entrée de catalogue pré-lancement jusqu’à ce que l’identifiant de modèle et le point de terminaison soient confirmés comme appelables.
Préparation à l’intégration de l’API GLM 5.4
La préparation la plus pratique consiste à éviter de coupler la logique applicative à une seule version de modèle. Un identifiant de modèle configurable facilite l’évaluation des mises à niveau sans réécrire le pipeline de requêtes.
Gardez l’identifiant de modèle configurable et utilisez un modèle GLM disponible pour établir une base de fonctionnement. Avant de basculer vers GLM-5.4, confirmez un identifiant de modèle appelable, l’accès au compte, les paramètres de requête pris en charge, les limites de contexte et de sortie, le comportement de streaming et la compatibilité des appels d’outils. Prévoyez une option de retour arrière.
Quand GLM-5.4 deviendra officiellement disponible, vérifiez l’identifiant de modèle, les paramètres pris en charge, les limites de contexte et la compatibilité du point de terminaison. Exécutez l’ancien et le nouveau modèle sur le même jeu de données d’évaluation, en suivant le taux de succès, la latence, les tokens de sortie, les échecs d’appels d’outils et le coût par exécution réussie.
À quoi pourrait ressembler la tarification de l’API GLM 5.4 ?
Aucun prix officiel d’API GLM-5.4 n’a été annoncé. Il serait donc trompeur de publier un tarif spécifique de tokens d’entrée ou de sortie comme s’il s’agissait d’une fuite authentique.
La famille GLM actuelle illustre pourquoi la seule taille de modèle est insuffisante pour prédire la tarification. GLM-5.3-Flash a introduit des optimisations d’architecture conçues pour livrer une intelligence compétitive à un coût d’inférence sensiblement plus faible.
L’Artificial Analysis Intelligence Index v4.1.1 de Z.ai rapporte un score de 57 pour un coût estimé remisé de 0.045 $ par tâche pour GLM-5.3-Flash. Ce coût d’évaluation n’est pas un tarif de tokens d’entrée/sortie et ne prédit pas la tarification de GLM-5.4.
La tarification future de GLM-5.4 pourrait dépendre de l’architecture, de l’effort de raisonnement, des remises sur tokens mis en cache, de l’infrastructure d’hébergement et des variantes. Pour la planification en production, le coût par tâche réussie est souvent plus précieux que le tarif d’entrée par token le plus bas.
Les développeurs doivent-ils attendre GLM 5.4 ?
Pour la plupart des développeurs, attendre un modèle non annoncé est inutile. Les modèles GLM existants offrent des capacités documentées en programmation et en agents, qui peuvent être testées dans des applications réelles.
Les équipes construisant des assistants de programmation ou des agents d’ingénierie multi-étapes peuvent établir une base avec GLM-5.3. Les applications mettant l’accent sur la compréhension visuelle, le long contexte et des appels répétés efficients peuvent évaluer GLM-5.3-Flash.
Construisez un harnais d’évaluation maintenant et réservez un créneau de comparaison future pour GLM-5.4. Lorsqu’il sera disponible, sa sortie sera pertinente s’il améliore les résultats qui comptent pour une application particulière.
Les chercheurs doivent surveiller une nouvelle architecture de base, des changements dans les benchmarks à long horizon et la fiabilité de bout en bout. Les entreprises doivent prioriser la disponibilité, le coût, la latence, la compatibilité et la qualité sur des données de production représentatives.
Conclusion
GLM 5.4 est une étape plausible dans la famille de modèles en évolution rapide de Z.ai, mais son récit actuel reste plus spéculatif que confirmé.
Union Alpha est un indice d’identité non vérifié, et la cadence des sorties ne soutient qu’une hypothèse de calendrier large. Aucun des deux n’établit une date de lancement. Les sources officielles examinées au 14 octobre 2026 fournissent une base pour les modèles existants plutôt qu’une sortie GLM-5.4 confirmée.
Ce qui est vérifiable, c’est le progrès déjà réalisé par GLM-5.3 et GLM-5.3-Flash. Des gains significatifs en programmation agentique, en évaluation de cybersécurité et en efficacité d’inférence établissent une référence exigeante pour tout successeur.
La question clé est de savoir si Z.ai peut fournir une exécution autonome fiable, un raisonnement plus solide et un coût compétitif par tâche complétée. Tant que des spécifications et des benchmarks officiels n’apparaissent pas, GLM-5.4 doit être traité comme une sortie potentielle plutôt qu’un produit disponible.
FAQ
Comment vérifier une fiche API GLM 5.4 ?
Vérifiez que le fournisseur fournit un identifiant de modèle appelable, un point de terminaison pris en charge, les conditions d’accès et la tarification actuelle. Comparez ensuite l’identité à une annonce ou une documentation officielle de Z.ai. Une fiche de fournisseur peut établir l’offre de ce fournisseur, mais n’authentifie pas à elle seule le développeur sous-jacent d’un modèle anonyme.
Quelles vérifications de compatibilité compter avant une migration vers GLM 5.4 ?
Validez les paramètres de requête, les réglages de raisonnement, le schéma des appels d’outils, la sortie structurée, le comportement de streaming, les limites de contexte et la sortie maximale sur votre point de terminaison réel. Incluez des tests négatifs pour les paramètres non pris en charge et gardez le modèle existant disponible pour retour arrière. La compatibilité OpenAI décrit une interface ; elle ne garantit pas un comportement de modèle identique.
Comment évaluer GLM 5.4 pour des agents de programmation ?
Utilisez un ensemble fixe de tâches de dépôt représentatives avec les mêmes outils, permissions, délais et harnais pour les deux modèles. Comptez les modifications testées réussies, la récupération après des échecs d’outils, l’utilisation de tokens, la latence et le coût total. Enregistrez chaque exécution et répétez suffisamment les tâches pour exposer la variabilité plutôt que de promouvoir un seul exemple favorable.
Qu’est-ce qui justifierait d’attendre GLM 5.4 ?
Attendre est raisonnable uniquement lorsqu’une capacité à venir documentée répond à un besoin que les modèles disponibles ne peuvent pas satisfaire, et que le délai s’inscrit dans votre calendrier de livraison. En l’état de simple rumeur, construisez sur un modèle disponible et gardez la sélection de modèle configurable. Définissez les seuils de capacité et de coût qu’une version ultérieure doit atteindre avant de remplacer votre référence.