
Mise à jour de la sortie de Grok 4.7 : des prévisions à la disponibilité officielle
Informations vérifiées : 16 octobre 2026.
Grok 4.7 a été officiellement publié le 21 septembre 2026. Les références antérieures à un lancement le 12 septembre relevaient d’estimations préalables et ne doivent pas être considérées comme la date de sortie effective.
L’annonce officielle du lancement décrit des améliorations en programmation, travail de connaissance, tâches de plus longue durée et vérification des propres résultats du modèle. Elle confirme la disponibilité via l’API Grok, Cursor et Grok Build. Pour l’identifiant exact du modèle API, les fonctionnalités prises en charge, les limites de contexte et les tarifs actuels, consultez la documentation officielle Grok 4.7.
Les résultats officiels montrent des progrès mesurables par rapport à Grok 4.6. Par exemple, la comparaison de lancement indique un score Terminal-Bench 4.0 de 37.6% pour Grok 4.7 au niveau d’effort « xhigh », contre 20.3% pour Grok 4.6 au niveau « high ». Ce sont des résultats rapportés par le fournisseur dans les conditions d’évaluation indiquées ; les performances en application dépendront des invites, des outils, du niveau d’effort de raisonnement et de la difficulté des tâches.
Pour les développeurs, la question utile est désormais de savoir si Grok 4.7 exécute leurs charges de travail de manière plus fiable et économique. Testez-le sur des modifications de dépôts, la création de documents et des enchaînements d’outils en plusieurs étapes, en mesurant l’achèvement réussi, la latence, les reprises et le coût total par tâche.
Source : Annonce officielle du lancement de Grok 4.7.
Points clés
- La date attendue du 12 septembre est déduite du compte à rebours de dix jours de Musk, et non d’une annonce calendaire distincte publiée par xAI.
- Les déclarations sur l’échelle de 2.1T et l’utilisation de données SpaceX sont des affirmations préalables à la sortie ; les paramètres actifs, le routage, l’architecture et la méthodologie d’entraînement ne sont pas publiés.
- Grok 4.6 affiche déjà de solides résultats en travail de connaissance et en agentique, dont 61.3% sur FrontierCode v1.1 (Extended), mais il est à la traîne du modèle de comparaison le plus fort sur plusieurs évaluations de programmation difficiles.
- Grok 4.7 doit être jugé sur le taux de tâches acceptées, la fiabilité sur long horizon, l’efficacité des jetons, la latence et le coût par résultat réussi — et non sur le seul nombre de paramètres.
- CometAPI intégrera Grok 4.7 dès que xAI publiera officiellement le modèle et que l’accès à l’endpoint de production sera disponible ; les développeurs doivent néanmoins valider l’ID du modèle en ligne, le prix et le comportement des réponses avant toute migration.
Qu’est-ce que Grok 4.7 ?
Grok 4.7 est l’héritier annoncé de Grok 4.6 et devrait poursuivre l’orientation de xAI sur la programmation, l’ingénierie, les agents longue durée et le travail de connaissance professionnel. Les éléments publics se résument actuellement à des déclarations du fondateur et à un compte à rebours de sortie, plutôt qu’à un dossier technique complet de lancement.
La distinction la plus importante porte sur trois objets : le modèle Grok 4.7 annoncé, les signaux préalables décrivant sa possible échelle et son entraînement, et la référence de production Grok 4.6 en ligne. Les développeurs devraient traiter Grok 4.7 comme un candidat à évaluer jusqu’à ce que xAI publie la documentation finale et qu’une requête de production aboutisse contre l’endpoint publié.
Date de sortie et chronologie de Grok 4.7
Quand la sortie de Grok 4.7 est-elle attendue ?
La déclaration de Musk du 2 septembre selon laquelle le modèle arriverait dans dix jours pointe vers environ le 12 septembre 2026
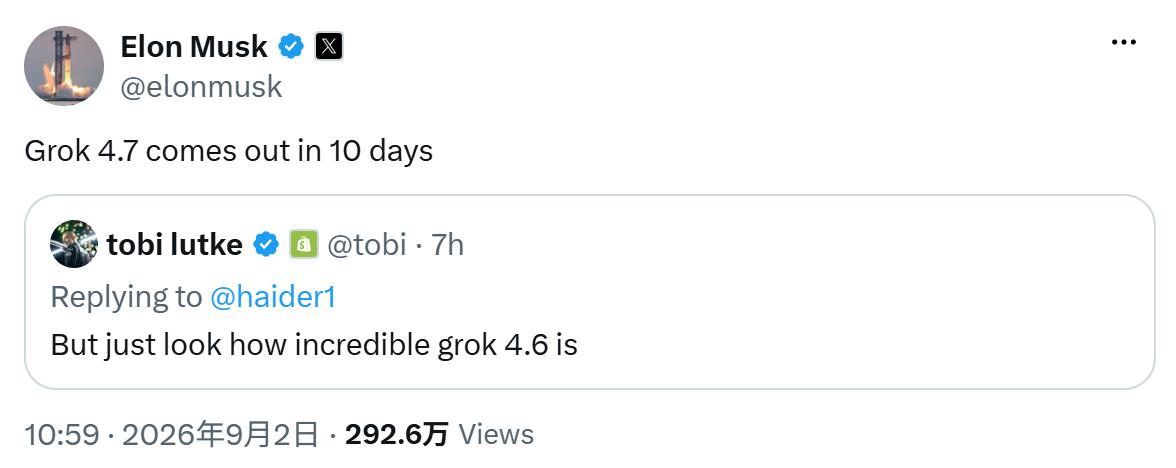
Source : Elon Musk sur X, 2 septembre 2026
Chronologie de la sortie de Grok 4.7
| Date | Signal public | Interprétation |
|---|---|---|
| Fin juillet 2026 | Musk a décrit un modèle d’environ 2.1T, une efficacité de jetons améliorée et un service quelque peu plus lent. | Attentes quant à l’échelle et à l’efficacité, déclarées par le fondateur. |
| 12 août 2026 | L’entraînement initial a été décrit comme terminé ; l’entraînement complémentaire aurait inclus des données SpaceX. | Une mise à jour sur l’avancement de l’entraînement, pas une confirmation de sortie. |
| 2 septembre 2026 | « Grok 4.7 sort dans 10 jours. » | Le compte à rebours public de lancement le plus clair à ce jour. |
| 12 septembre 2026 | Date calendaire dérivée du compte à rebours. | Cible attendue ; la disponibilité finale exige une annonce xAI et un endpoint fonctionnel. |
Spécifications de Grok 4.7 : informations confirmées vs non confirmées
La manière la plus utile de lire les informations actuelles sur Grok 4.7 consiste à distinguer les déclarations directes du fondateur des spécifications non publiées par xAI. La nouvelle publication confirme uniquement le nom du modèle et un compte à rebours ; elle n’ajoute ni paramètres techniques ni résultats de benchmarks.
| Spécification | Statut actuel de Grok 4.7 | Niveau de preuve |
|---|---|---|
| Calendrier de sortie | Autour du 12 septembre, déduit du compte à rebours de dix jours du 2/9 | Cible annoncée par le fondateur |
| Échelle du modèle | Environ 2.1T de paramètres | Déclaration du fondateur |
| Entraînement initial | Décrit comme terminé au 12 août | Déclaration du fondateur |
| Entraînement complémentaire | Inclut des données substantielles de SpaceX | Déclaration du fondateur |
| Qualité relative | Prétendue nettement meilleure que Grok 4.6 | Affirmation non vérifiée |
| Efficacité des jetons | Amélioration revendiquée par rapport à Grok 4.6 | Affirmation non vérifiée |
| Vitesse de service | Attendue comme quelque peu plus lente | Déclaration du fondateur |
| Fenêtre de contexte | Non publiée par xAI | Inconnue |
| Modalités d’entrée/sortie | Non publiées par xAI | Inconnues |
| ID du modèle API final | Non confirmé dans la documentation xAI | Inconnu |
| Tarification officielle | Non publiée par xAI | Inconnue |
| Benchmarks officiels | Aucun publié pour Grok 4.7 | Inconnu |
La revendication d’environ 2.1T de paramètres ne précise pas les paramètres actifs, la parcimonie, le routage par experts, le coût d’inférence ni la puissance d’entraînement effective. Le nombre de paramètres à lui seul ne peut établir la qualité en production.
Pourquoi le signal d’entraînement SpaceX pourrait compter davantage que 2.1T
La divulgation potentiellement la plus conséquente est le complément de données d’entreprise SpaceX. Un corpus d’ingénierie de haute qualité pourrait améliorer le raisonnement technique, la conception, le débogage, l’optimisation et le travail d’agents sur long horizon, où la distribution des tâches et la qualité post-entraînement comptent souvent plus que la seule échelle.
Cette orientation est cohérente avec la stratégie des modèles publiés par xAI. Le rapport d’entraînement de Grok 4.6 décrit une phase complémentaire plus longue avec des données d’ingénierie de haute qualité, suivie d’un affinement supervisé et d’un apprentissage par renforcement couvrant la programmation, les STEM, le développement web, l’optimisation de noyau et la conception assistée par ordinateur.
Cela rend l’affirmation sur Grok 4.7 techniquement plausible, non prouvée. Un véritable avantage devrait devenir visible après la sortie dans des tests d’ingénierie reproductibles, les taux d’achèvement des tâches, la latence et le coût par résultat réussi.
Grok 4.7 vs Grok 4.6 : ce que montre la ligne de base en performance
Il n’existe pas encore de scores officiels pour Grok 4.7. Le point de comparaison responsable est l’évaluation Grok 4.6 publiée par xAI. La vue d’ensemble complète du modèle figure dans l’analyse détaillée de Grok 4.6 par CometAPI ; le tableau ci-dessous ne conserve que les lignes de benchmarks les plus pertinentes pour la décision.
| Évaluation officielle | Grok 4.6 High | Grok 4.5 High | GPT-5.6 Sol Max | Claude Fable 5 Max |
|---|---|---|---|---|
| AA Intelligence Index | 61 | 56 | 61 | 62 |
| GDPVal-AA v2 | 1753 | 1526 | 1728 | 1741 |
| CursorBench v3.2 | 69.9% | 66.7% | 67.2% | 70.5% |
| DeepSWE v1.1 | 65.9% | 54.0% | 73.0% | 70.0% |
| FrontierCode v1.1 (Extended) | 61.3% | 56.6% | 60.6% | 63.6% |
| Terminal-Bench v3.0 | 26.0% | 15.7% | 34.6% | 34.1% |
Résultat de base : Grok 4.6 montre un réel avantage sur Grok 4.5 sur chaque ligne présentée. Il égale GPT-5.6 Sol sur l’indice d’intelligence global, mène ce groupe sur GDPVal-AA v2 et devance GPT-5.6 Sol sur FrontierCode. Ses principaux écarts publiés restent DeepSWE et Terminal-Bench.
Ces résultats fixent une norme concrète pour Grok 4.7. Si le modèle plus grand et l’entraînement complémentaire orienté ingénierie se transfèrent en production, l’avancée attendue serait un renforcement de la programmation au niveau dépôt et de l’accomplissement des tâches terminal sans perdre la force de Grok 4.6 en travail de connaissance. Un objectif ambitieux crédible est de devenir compétitif avec le Claude Fable 5.1 publié sur la programmation et les workflows d’agents longue durée. C’est une hypothèse à tester, pas une revendication de benchmark actuelle.
Grok 4.7 vs Grok 4.6 : percées attendues et recommandations de mise à niveau
Les signaux divulgués et déclarés par le fondateur suggèrent cinq domaines d’amélioration possibles pour Grok 4.7. Comme xAI n’a pas publié de données d’évaluation finales, chaque attente doit être convertie en test d’acceptation mesurable.
Programmation au niveau dépôt
Grok 4.6 est déjà performant sur CursorBench et FrontierCode, mais ses résultats DeepSWE et Terminal-Bench laissent une marge visible d’amélioration. Grok 4.7 devrait démontrer un taux d’acceptation de correctifs plus élevé, moins de régressions et une meilleure récupération en ligne de commande sur les mêmes dépôts avant de remplacer 4.6.
Fiabilité des agents sur long horizon
Le signal lié aux données SpaceX et l’orientation actuelle de xAI en matière d’entraînement d’agents suggèrent un accent sur le travail d’ingénierie multi-étapes. Mesurez les workflows complétés, les échecs d’appels d’outils, les reprises, les interventions humaines et la récupération après erreur — pas seulement la qualité du texte final.
Travail de connaissance et raisonnement technique
Grok 4.6 mène déjà l’ensemble de comparaison sur GDPVal-AA v2. Grok 4.7 devrait préserver cet avantage tout en améliorant le transfert vers les revues de conception, la synthèse de recherche, le débogage, l’optimisation et d’autres tâches techniques complexes.
Efficacité des jetons
Un modèle plus grand peut rester moins cher par tâche réussie s’il atteint des résultats corrects en moins d’étapes. Comparez les jetons d’entrée, d’entrée mis en cache, de sortie, les reprises et le coût pour le même résultat accepté.
Compromis de service
Si Grok 4.7 est plus lent, les gains de qualité doivent compenser la latence. Relevez le temps jusqu’au premier jeton, le débit soutenu, le temps total écoulé pour compléter la tâche, le taux d’erreur et le coût sous une concurrence réaliste.
Benchmarks de Grok 4.7 : 5 tests pour vérifier une véritable amélioration par rapport à Grok 4.6
- Réussite en ingénierie logicielle : mesurez les problèmes résolus, les tests passants, le taux de régression et l’acceptation de correctifs sur des dépôts représentatifs.
- Fiabilité des agents sur long horizon : suivez les workflows complétés, les échecs d’appels d’outils, les reprises, la récupération et les interventions humaines sur des exécutions multi-étapes.
- Transfert vers l’ingénierie réelle : testez la conception, le débogage, l’optimisation, le raisonnement scientifique et les tâches liées à la CAO avec des critères de notation divulgués.
- Efficacité en jetons par tâche réussie : comparez le total de jetons et la dépense nécessaires pour atteindre le même résultat accepté.
- Latence et coût sous charge de production : évaluez le temps jusqu’au premier jeton, le débit, le temps total écoulé, le taux d’erreur et le coût à une concurrence réaliste.
Ce que les développeurs doivent faire avant le 12 septembre — et le rôle de CometAPI
Liste de contrôle pré-lancement pour développeurs
- Constituez un jeu d’évaluation fixe à partir de workflows réels de programmation, de recherche, d’ingénierie et d’agents.
- Exécutez-le contre Grok 4.6 et enregistrez le taux de réussite, les reprises, les appels d’outils, la latence, les jetons et le coût total.
- Gardez la sélection du modèle configurable et évitez de coder en dur un identifiant provisoire Grok 4.7.
- Surveillez les notes de version xAI et la page modèle CometAPI pour confirmation de disponibilité.
- Après le lancement, vérifiez le contexte, les modalités, les contrôles de raisonnement, la tarification, les limites de débit et le périmètre de déploiement.
- Rejouez le même jeu d’évaluation avant de basculer du trafic de production.
CometAPI fournit une couche d’API unifiée pour accéder à plusieurs fournisseurs de modèles IA via un seul compte et un même schéma d’intégration. Une page de suivi Grok 4.7 est déjà disponible. CometAPI intégrera Grok 4.7 dès que xAI le publiera officiellement et que l’accès de production sera disponible.
D’ici là, traitez tout identifiant, prix ou champ de capacité pré-sortie comme provisoire. Avant d’envoyer du trafic de production, confirmez que la route est en ligne, qu’une requête réelle réussit, que le modèle retourné est la version voulue et que la tarification actuelle est visible dans la console.
Perspectives tarifaires de Grok 4.7 vs Grok 4.6
Le tarif standard publié de Grok 4.6 est de $2 par 1 million de jetons d’entrée et $6 par 1 million de jetons de sortie en dessous du seuil de long contexte. Les notes de version de xAI listent des tarifs plus élevés pour les requêtes au-delà de 200,000 jetons de prompt. La tarification de Grok 4.7 n’a pas été officiellement annoncée.
| Base tarifaire publiée | Entrée / 1M | Sortie / 1M | Statut |
|---|---|---|---|
| Grok 4.6, prompt < 200K | $2 | $6 | Publié |
| Grok 4.6, prompt > 200K | $4 | $12 | Palier long contexte publié |
| Grok 4.7 | Non annoncé | Non annoncé | À confirmer après lancement |
Trois orientations tarifaires restent plausibles : parité avec Grok 4.6 pour accélérer l’adoption, palier premium si le coût de service est sensiblement plus élevé, ou tarifs différenciés selon la longueur de contexte et la vitesse. Ce sont des scénarios de planification, pas une prévision d’xAI.
Liste de contrôle pré-lancement
- Constituez un jeu d’évaluation fixe à partir de workflows réels de programmation, de recherche, d’ingénierie et d’agents.
- Exécutez-le contre Grok 4.6 et enregistrez le taux de réussite, les reprises, les appels d’outils, la latence, les jetons et le coût total.
- Gardez la sélection du modèle configurable et évitez de coder en dur un identifiant provisoire Grok 4.7.
- Surveillez les notes de version xAI et la page modèle CometAPI pour confirmation de disponibilité.
- Après le lancement, vérifiez le contexte, les modalités, les contrôles de raisonnement, la tarification, les limites de débit et le périmètre de déploiement.
- Rejouez le même jeu d’évaluation avant de basculer du trafic de production.
Grok 4.7 : ce qu’il faut surveiller ensuite
Quatre événements transformeraient le compte à rebours actuel en un lancement de produit vérifiable : un post de sortie officiel de xAI ; une documentation du modèle couvrant le contexte, les modalités et les contrôles de raisonnement ; une tarification API finale et des identifiants de modèle ; et des évaluations reproductibles en benchmark ou en production.
La question la plus utile au lancement n’est pas de savoir si 2.1T paraît grand. C’est de savoir si Grok 4.7 accomplit les tâches d’ingénierie et d’agent difficiles de manière plus fiable — et à un meilleur coût par résultat réussi — que la ligne de base publiée.
FAQ
Quand la sortie de Grok 4.7 est-elle attendue ?
Le compte à rebours de dix jours du 2 septembre annoncé par Musk pointe vers environ le 12 septembre 2026. Il s’agit d’une cible déduite, pas d’une date calendaire distincte publiée par xAI.
Grok 4.7 a-t-il déjà été lancé ?
Grok 4.7 a été teasé/annoncé publiquement mais n’a pas encore fait l’objet d’une publication complète de documentation officielle d’API/modèle.
Grok 4.7 est-il un modèle de 2.1 mille milliards de paramètres ?
Musk l’a décrit comme ayant environ 2.1T de paramètres. xAI n’a pas encore publié de document d’architecture confirmant les paramètres actifs ou les détails de routage.
Grok 4.7 sera-t-il meilleur que Grok 4.6 ?
Musk a revendiqué une amélioration substantielle, mais aucun tableau de benchmarks officiel pour Grok 4.7 n’existe. Considérez cette revendication comme non vérifiée tant que des résultats reproductibles ne sont pas disponibles.
Grok 4.7 sera-t-il disponible via CometAPI ?
Une page de suivi CometAPI existe déjà, mais la disponibilité finale, l’identifiant, la tarification et les formats pris en charge doivent être confirmés après le lancement officiel.
Conclusion
L’histoire de Grok 4.7 est passée d’une estimation large de début septembre à un compte à rebours concret. La dernière déclaration de Musk pointe vers environ le 12 septembre 2026, tandis que les posts précédents décrivent un modèle d’environ 2.1T et un entraînement complémentaire avec des données substantielles de SpaceX.
Ce sont des signaux de pré-sortie inhabituellement précis, mais ce ne sont ni une fiche de modèle, ni une suite de benchmarks, ni un contrat d’API. Les développeurs devraient conserver Grok 4.6 comme référence mesurable, préparer dès maintenant une évaluation contrôlée et attendre que xAI et CometAPI confirment l’accès de production avant de prendre des décisions de migration ou de budget.