
Exécuter Qwen3.8-Max en local est désormais possible, mais l’expression « Qwen 3.8 Max en local » mérite une précision importante. Le produit Max hébergé par Alibaba et le checkpoint téléchargeable sont étroitement liés, mais ce ne sont pas des produits identiques.
Qwen a d’abord lancé le service Max hébergé début août 2026 et a publié Qwen3.8-2.4T-A95B en poids ouverts le 12 août 2026. Ce checkpoint est le modèle que vous déployez réellement sur votre propre infrastructure.
Ce n’est pas un tutoriel Ollama « sur un PC de jeu ». Le checkpoint non quantifié est un modèle Mixture-of-Experts de 2,4 billions de paramètres, et la recette vLLM actuelle dimensionne ses poids BF16 à 4,45 TiB. Même les variantes orientées production en virgule flottante 4 bits occupent encore environ 1,3–1,5 TiB de poids.
Réponse rapide : l’auto‑hébergement complet de la classe Qwen 3.8 Max est un déploiement de centre de données. Un point de départ de production pratique est un checkpoint FP4 sur 8× B300 ou 8× MI355X ; les déploiements H200 nécessitent davantage de GPU. Pour une station de travail classique, utilisez plutôt Qwen3.8-27B.
Qwen 3.8 Max vs. le modèle ouvert que vous déployez réellement
Le checkpoint téléchargeable Qwen3.8-2.4T-A95B est officiellement décrit comme un modèle de langage causal à 2,4 T de paramètres, avec environ 95 B de paramètres activés par token. Le service Max hébergé ajoute des capacités au niveau produit qui ne sont pas présentes dans le checkpoint ouvert actuel.
| Spécification | Service Qwen3.8-Max hébergé | Checkpoint ouvert Qwen3.8-2.4T-A95B |
|---|---|---|
| Paramètres totaux | 2.4T | 2.4T |
| Paramètres actifs | ~95B | ~95B |
| Architecture | MoE sparse | MoE sparse |
| Entrée | Texte, image, vidéo | Texte |
| Contexte | Contexte géré 1 M | 262 144 natif ; extensible jusqu’à ~1,01 M |
| Comportement de raisonnement | Raisonnement géré / options sans raisonnement | Raisonnement requis ; effort de raisonnement configurable |
| Outils intégrés | Disponibles sur le service managé | L’application doit fournir les outils |
| Auto‑hébergement | Aucune gestion des poids requise | Oui ; checkpoint ouvert |
Le produit hébergé expose des entrées texte, image et vidéo avec un contexte de 1 000 000 tokens. En revanche, le checkpoint ouvert est uniquement texte et possède un contexte natif de 262 144 tokens. Cette différence est importante si votre application dépend d’entrées multimodales ou d’outils intégrés gérés.
Architecture et spécifications de Qwen 3.8
CometAPI couvre déjà les bases du modèle dans What is Qwen3.8 Max, donc ce guide de déploiement concentre la discussion d’architecture sur les détails qui affectent la mémoire, le parallélisme et le service.
| Spécification pertinente pour le déploiement | Qwen3.8-2.4T-A95B |
|---|---|
| Paramètres totaux / activés | 2.4T / ~95B par token |
| Agencement des couches | 92 couches : 69 Gated DeltaNet + 23 attention complète |
| Routage MoE | 512 experts routés ; 10 routés + 1 partagé actifs |
| Têtes d’attention complète | 64 requête / 4 clé‑valeur |
| Contexte natif | 262 144 tokens |
| Contexte étendu | Jusqu’à environ 1 010 000 tokens |
| Multi‑Token Prediction | Pris en charge |
| Modalité du checkpoint ouvert | Texte uniquement |

Architecture hybride officielle de Qwen utilisée dans le guide de déploiement SGLang Qwen3.8.
N’interprétez pas « 95 B de paramètres actifs » comme une empreinte mémoire de modèle de 95 B. L’activation sparse réduit le calcul par token, mais le système de service doit toujours avoir accès à l’ensemble complet des poids des experts.
Instantané des benchmarks de Qwen 3.8 Max
Comme l’aperçu existant de Qwen3.8 Max sur CometAPI détaille déjà les benchmarks, cet article n’utilise qu’un sous‑ensemble pertinent pour le déploiement, tiré du tableau de benchmarks officiel de la model card Qwen.
| Benchmark | Qwen3.8-Max | Qwen3.7-Max | GPT-5.6 Sol (max) |
|---|---|---|---|
| Terminal Bench 2.1 | 86.6 | 74.5 | 88.8 |
| SWE-bench Pro | 67.7 | 60.6 | 64.6 |
| PaperBench | 93.0 | 64.8 | 90.5 |
| FrontierSWE | 73.5 | 40.7 | — |
| CoWorkBench | 74.8 | 64.6 | 71.5 |
| GPQA Diamond | 92.6 | 92.4 | 94.1 |
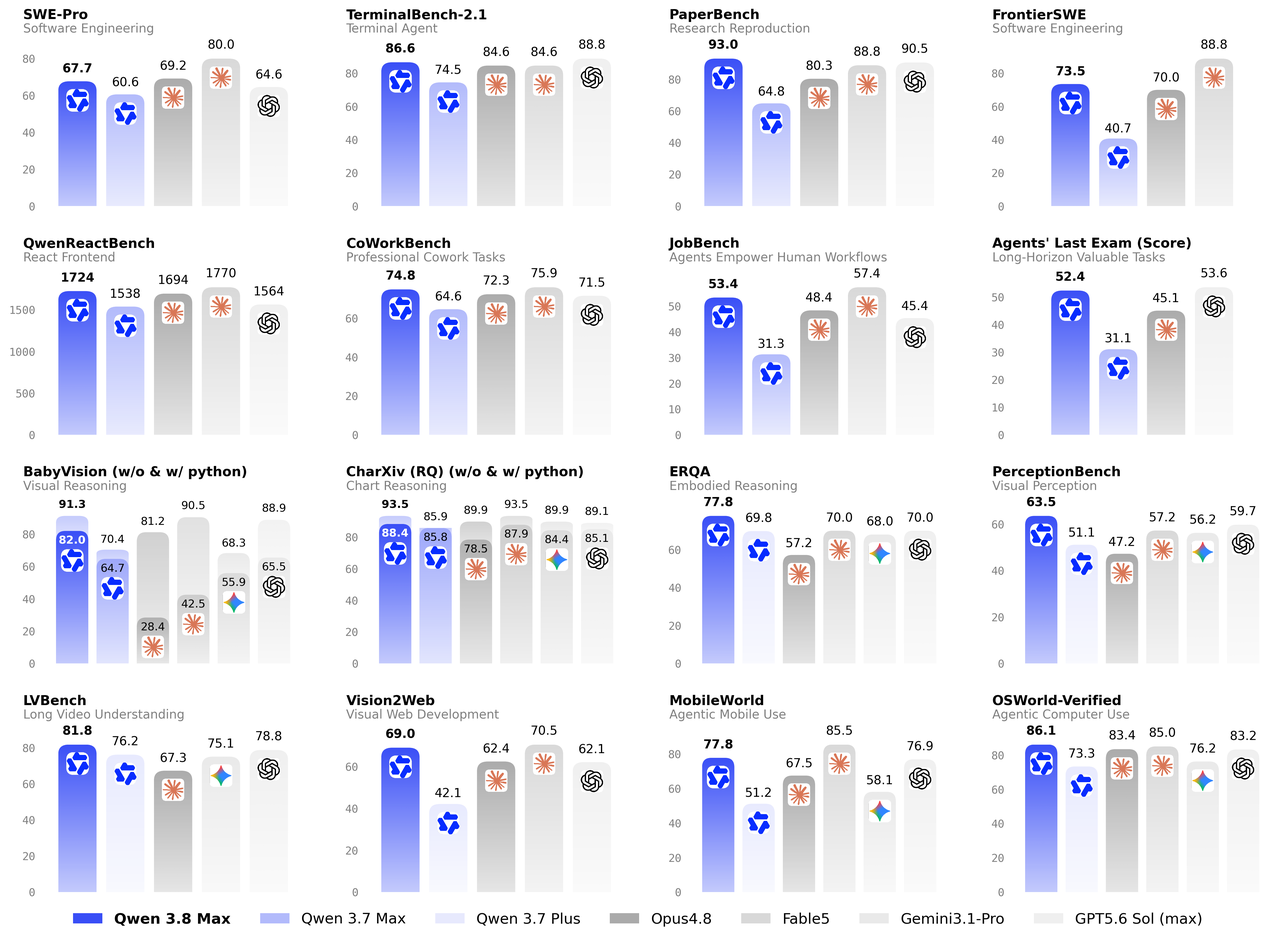
Graphique de performance officiel de Qwen3.8 publié par l’ équipe Qwen.
Les plus grands gains rapportés par rapport à Qwen3.7-Max dans ce sous‑ensemble sont PaperBench et FrontierSWE. Qwen3.8‑Max dépasse également GPT‑5.6 Sol sur SWE‑bench Pro et PaperBench, tandis que GPT‑5.6 Sol reste en tête sur Terminal Bench 2.1. Pour les décisions de déploiement, considérez ces données comme un contexte de capacités ; les mesures de mémoire et de débit de service ci‑dessous sont plus pertinentes opérationnellement.
Les tableaux de benchmarks ne sont pas des classements universels. Les harnais, délais, limites de contexte, accès aux outils et la quantification peuvent modifier les résultats. Benchmarquez exactement le checkpoint, la précision, le moteur de service et la distribution d’invites que vous prévoyez d’utiliser.
Quel matériel Qwen3.8 nécessite‑t‑il pour un déploiement local ?
Exigences GPU pour Qwen3.8-2.4T-A95B
C’est la question clé du déploiement. La recette vLLM Qwen3.8 actuelle publie les empreintes des checkpoints et des nombres de GPU réalistes avec marge à l’exécution, ce qui est plus utile que d’estimer la VRAM à partir du nombre de paramètres uniquement.
| Précision | Empreinte des poids | B300 (268 GB) | MI355X (288 GB) | H200 (141 GB) | Meilleur ajustement |
|---|---|---|---|---|---|
| BF16 | 4.45 TiB | 24 GPU | 24 GPU | 48 GPU | Fidélité maximale / recherche |
| FP8 | 2.27 TiB | 16 GPU | 16 GPU | 32 GPU | Production haute fidélité |
| MXFP4 | 1.45 TiB | — | 8 GPU | 16 GPU | Déploiement AMD pratique |
| NVFP4 W4A4 | 1.32 TiB | 8 GPU | — | 16 GPU | Déploiement NVIDIA pratique |
Pour la plupart des organisations qui ont réellement besoin d’un Qwen3.8 auto‑hébergé, FP4 est le point de départ pratique. La configuration NVIDIA phare est NVFP4 W4A4 sur 8× B300 ; la route AMD correspondante est MXFP4 sur 8× MI355X.
Un serveur 8× H200 ne suffit pas pour ces déploiements « full‑model » recommandés. La recette officielle dimensionne H200 à 16 GPU pour FP4, 32 pour FP8 et 48 pour BF16.
Exigences de VRAM pour Qwen3.8‑27B
Qwen3.8‑27B est l’alternative pratique pour une station de travail. La mémoire des poids bruts est d’environ 54 GB en BF16, 27 GB en FP8 et 13,5 GB en précision 4 bits. La surcharge à l’exécution et le cache KV augmentent l’exigence réelle, en particulier pour de longues longueurs de contexte.
| Précision | Mémoire de poids approximative | Conseils pratiques de déploiement |
|---|---|---|
| BF16 | ~54 GB | Utilisez un GPU de 64–80 GB, selon le contexte et la surcharge de service. |
| FP8 / INT8 | ~27 GB | Un GPU de 40–48 GB offre une marge d’exécution plus pratique. |
| 4‑bits | ~13,5 GB | Un GPU grand public de 20–24 GB peut convenir à des contextes modérés. |
Ces chiffres sont des estimations de planification dérivées du nombre de paramètres. Confirmez le checkpoint exact, le format de quantification, le moteur de service, la longueur de contexte et les réglages du cache KV avant de dimensionner le matériel de production.
Qwen3.8 peut‑il tourner sur des GPU grand public ?
Le modèle complet Qwen3.8‑2.4T‑A95B n’est pas pratique sur des GPU grand public ordinaires, même avec une quantification agressive. Un projet communautaire a démontré une version UD‑Q1_0 fortement compressée de 397 GB répartie sur quatre systèmes DGX Spark, mais cette voie est une quantification extrême expérimentale plutôt que la ligne de base pour un service sensible à la qualité.
Pour une station de travail ou un home lab, le modèle le plus approprié est Qwen3.8‑27B, dont les poids ouverts ont été publiés le 14 août 2026. Ce modèle est de plusieurs ordres de grandeur plus facile à héberger et constitue la bonne option si « local » signifie une seule station de travail plutôt qu’un cluster de GPU.
Avant d’installer Qwen 3.8 Max
Planifiez l’infrastructure avant d’exécuter une commande d’installation. Vous avez besoin de Linux, d’une pile d’accélérateurs compatible, d’un stockage local ou partagé suffisant pour le checkpoint, d’interconnexions GPU à haute bande passante et, lors de franchissements inter‑nœuds, d’un réseau conçu pour l’inférence distribuée. La recette vLLM recommande actuellement vLLM nightly et Transformers 5.4.0 ou plus récent.
bash
uv venv
source .venv/bin/activate

uv pip install -U vllm \
  --extra-index-url https://wheels.vllm.ai/nightly

uv pip install -U "transformers>=5.4.0"
Comment déployer Qwen 3.8 en FP8 avec vLLM
FP8 est un choix judicieux lorsque vous voulez un checkpoint fourni par Qwen et que vous pouvez vous permettre une infrastructure multi‑nœuds. Le checkpoint officiel est Qwen/Qwen3.8-2.4T-A95B-FP8.
Pour un déploiement B300‑class à deux nœuds et 16 GPU, exécutez le nœud principal avec :
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
On the worker node, use the same topology with a different node rank and no API server:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 1 \
  --master-addr "$HEAD_ADDR" \
  --headless \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
Ne copiez pas l’exemple 16 GPU tel quel sur des serveurs H200 sans redimensionner la topologie. La même variante FP8 est actuellement dimensionnée à 32× H200 dans la recette vLLM.
Comment exécuter Qwen 3.8 sur un seul serveur 8× B300
Pour NVIDIA Blackwell, la configuration « full‑model » la plus pratique est NVFP4. vLLM valide actuellement NVFP4 W4A4 avec parallélisme tensoriel sur huit GPU B300.
bash
vllm serve Inferact/Qwen3.8-2.4T-A95B-NVFP4 \
  --tensor-parallel-size 8 \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
La build NVFP4 d’Inferact est un checkpoint quantifié plutôt que l’artefact BF16 d’origine de Qwen. Validez la qualité du modèle sur votre propre jeu d’acceptation avant de le considérer comme un substitut direct au BF16 ou FP8.
Comment déployer Qwen 3.8 avec SGLang
SGLang a ajouté un support Day‑0 pour Qwen3.8 le 12 août et est particulièrement attrayant pour le service à haut débit, le prefix caching, le parallélisme d’experts, le décodage spéculatif et la désagrégation prefill/decode.
bash
SGLANG_ENABLE_MOE_DEFERRED_FINALIZE=1 \
SGLANG_FLASHINFER_MNNVL_CUTEDSL_AR_FUSION=1 \
sglang serve \
  --trust-remote-code \
  --model-path RadixArk/Qwen3.8-2.4T-A95B-NVFP4 \
  --tp-size 8 \
  --context-length 200000 \
  --preferred-sampling-params '{"top_k": 20}' \
  --attention-backend trtllm_mha \
  --linear-attn-prefill-backend flashinfer \
  --linear-attn-decode-backend flashinfer \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --host 0.0.0.0 \
  --port 30000
SGLang rapporte 346 tokens de sortie/s à taille de lot 1 sur TP8 B300 avec MTP, et un débit agrégé nettement supérieur dans des architectures de service désagrégées. Considérez ces chiffres comme des mesures de la pile de service, pas comme des benchmarks de qualité du modèle.
Tester l’endpoint local compatible OpenAI
vLLM et SGLang exposent des API compatibles OpenAI, ce qui simplifie l’intégration applicative.
python
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant Redis architecture for three regions."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
La model card officielle recommande temperature = 1.0, top_p = 0.95 et top_k = 20 comme paramètres d’échantillonnage de base. Pour un travail agentique, laissez suffisamment de budget de sortie pour le raisonnement plutôt que de dimensionner max_tokens uniquement pour la réponse finale visible.
Activer la fenêtre de contexte 1 M
Le checkpoint ouvert Qwen3.8‑2.4T‑A95B a un contexte natif de 262 144 tokens et peut être étendu à environ 1,01 M. La recette vLLM documente le schéma suivant :
bash
VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 \
vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --max-model-len 1010000 \
  --hf-overrides '{"max_position_embeddings": 1010000}' \
  --reasoning-parser qwen3 \
  ...
Ne faites pas de 1 M la valeur par défaut simplement parce que c’est pris en charge. Des contextes maximums plus grands réservent davantage de capacité de cache et peuvent réduire fortement la concurrence. Dimensionnez --max-model-len selon la charge réelle.
Comment améliorer les performances d’inférence de Qwen3.8 ?
Utiliser MTP‑3 pour réduire la latence utilisateur
Qwen3.8 inclut Multi‑Token Prediction. Dans les mesures publiées par vLLM, MTP‑3 fait passer la sortie par utilisateur de 130 à 307 tok/s pour FP8 TP16 et de 133 à 304 tok/s pour NVFP4 TP8.
bash
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
Utiliser fastsafetensors pour accélérer le démarrage
Pour des modèles à l’échelle du téraoctet, le temps de démarrage compte. Dans une mesure vLLM, le chargement des poids est passé de 545 s à 306 s avec fastsafetensors et le chargement lazy.
bash
--load-format fastsafetensors \
--safetensors-load-strategy lazy
Utiliser le parallélisme d’experts pour augmenter le débit concurrent
Pour une forte concurrence, Qwen3.8 bénéficie des architectures « expert‑parallel », car il dispose de 512 experts routés. vLLM rapporte jusqu’à 3 200 tok/s/GPU au total pour FP8 EP et jusqu’à 4 300 tok/s/GPU au total pour une configuration NVFP4 DEP16 optimisée.
Régler --max-model-len pour équilibrer VRAM et concurrence
Réglez --max-model-len sur la séquence la plus longue dont la charge a réellement besoin. Une valeur plus élevée réserve davantage de capacité de cache KV, augmente la pression mémoire et peut réduire le nombre de requêtes simultanées même lorsque les poids du modèle tiennent déjà.
Commencez avec un percentile représentatif de production plutôt que le contexte maximum annoncé par le modèle. Testez la limite choisie avec la même précision, le même schéma de lot et le même moteur de service qu’en production, puis augmentez‑la seulement lorsque des requêtes réelles nécessitent davantage de contexte.
Déploiement local de Qwen 3.8 Max vs API
Des poids ouverts ne rendent pas automatiquement l’inférence locale économique. La bonne décision dépend de l’utilisation, de la résidence des données, des effectifs, des objectifs de disponibilité et de la nécessité éventuelle des fonctionnalités multimodales du modèle managé.
| Dimension | Qwen3.8-2.4T-A95B auto‑hébergé | Qwen3.8-Max via CometAPI |
|---|---|---|
| Infrastructure | Serveur multi‑GPU ou cluster | Aucune infrastructure GPU |
| Modalité d’entrée | Texte | Texte, image, vidéo |
| Contexte | 262 K natif ; ~1,01 M étendu | 1 M géré |
| Contrôle des données | Maximum | API cloud |
| Opérations | Vous gérez la supervision, les mises à jour et la HA | Géré par le fournisseur |
| Meilleur cas d’usage | Résidence des données, utilisation soutenue, équipe infra | La plupart des équipes applicatives et charges variables |
Si vous possédez déjà des accélérateurs adaptés et avez une utilisation constamment élevée, l’auto‑hébergement peut se justifier. Si vous devez acheter un cluster uniquement pour ce modèle, Qwen3.8‑Max sur CometAPI est généralement la voie la plus simple. Le guide API existant couvre l’intégration hébergée, tandis que le guide de tarification couvre la modélisation des coûts ; cet article se concentre donc sur le déploiement local.
Problèmes courants de déploiement local de Qwen 3.8
Le serveur sature la mémoire GPU au démarrage
Réduisez d’abord --max-model-len si le cache est en cause. Si les poids eux‑mêmes ne tiennent pas, la réduction du contexte ne résoudra pas le problème racine ; passez à un checkpoint validé de précision inférieure ou ajoutez des GPU.
Le parallélisme tensoriel échoue avec une taille invalide
Qwen3.8 possède 64 têtes d’attention dans ses couches d’attention complète, donc vLLM exige que TP divise 64. Les tailles TP simples sont 1, 2, 4, 8, 16 et 32. La VRAM agrégée brute ne suffit donc pas à elle seule pour choisir une topologie.
Le serveur met longtemps à démarrer
Charger un à plusieurs téraoctets de poids plus la compilation JIT des kernels peut prendre plusieurs minutes. Augmentez VLLM_ENGINE_READY_TIMEOUT_S et sondez un véritable endpoint d’inférence plutôt que de supposer une courte fenêtre de démarrage.
Le modèle local ne peut pas traiter une image
C’est attendu. The open 2.4T checkpoint is text-only
Le checkpoint ouvert Qwen3.8‑2.4T‑A95B est texte uniquement. Cette limitation est spécifique à Qwen3.8‑2.4T‑A95B. Qwen3.8‑27B prend en charge l’entrée visuelle lorsque ses fichiers distincts de projection vision sont chargés.
Le contexte 1 M réduit fortement le débit
Réduisez --max-model-len à la plus longue séquence dont votre charge a réellement besoin. La plus grande fenêtre de contexte prise en charge n’est pas nécessairement le meilleur réglage de production ; choisissez une limite de contexte qui équilibre besoins de charge, utilisation du cache KV et concurrence.
Ollama ou LM Studio peuvent‑ils exécuter Qwen 3.8 Max ?
L’écosystème peut empaqueter des poids Qwen3.8 fortement quantifiés pour une inférence de style llama.cpp, mais cela ne doit pas être confondu avec un flux de travail Ollama desktop normal. Une build quantifiée occupant des centaines de gigaoctets nécessite toujours des centaines de gigaoctets de mémoire accessible et implique des compromis significatifs en qualité et performance.
Pour un développement local ordinaire, Qwen3.8‑27B est la cible appropriée. Le modèle complet 2,4 T doit être traité comme un modèle de serveur/cluster même lorsque des quantifications communautaires extrêmes le rendent techniquement amorçable sur du matériel inhabituel.
Quelle méthode de déploiement choisir ?
Pour NVIDIA Blackwell, un déploiement NVFP4 sur 8× B300 est actuellement le point de départ « full‑model » le plus propre. Pour AMD, 8× MI355X avec MXFP4 est la configuration pratique correspondante. Utilisez FP8 lorsque vous privilégiez la provenance du checkpoint et la qualité par rapport à la taille de l’infrastructure, et BF16 uniquement lorsque la fidélité maximale justifie des exigences mémoire à l’échelle de plusieurs racks.
Pour une station de travail, utilisez Qwen3.8‑27B. Pour les équipes applicatives qui ont besoin des capacités Max sans exploiter un cluster GPU, utilisez le modèle Qwen3.8‑Max sur CometAPI.
Conclusion
Qwen3.8‑Max a franchi une étape importante depuis son lancement API initial : la famille Qwen de classe Max dispose désormais d’un checkpoint ouvert 2,4 T que les organisations peuvent exploiter entièrement sur leur propre infrastructure.
Mais des poids ouverts ne signifient pas du matériel grand public. L’empreinte BF16 de 4,45 TiB, le checkpoint FP8 de 2,27 TiB et les variantes FP4 de 1,3–1,5 TiB font de Qwen3.8‑2.4T‑A95B l’un des modèles ouverts les plus gourmands en infrastructure disponibles. L’avantage pratique est que vLLM et SGLang prennent déjà en charge l’architecture, et FP4 rend faisable un déploiement sur un seul nœud 8× B300 ou 8× MI355X.
Auto‑hébergez lorsque le contrôle des données, une utilisation soutenue et la possession de l’infrastructure justifient le cluster. Sinon, utilisez l’API Max managée — ou Qwen3.8‑27B lorsque ce que vous voulez réellement est un modèle Qwen performant sur une seule station de travail.