
TL;DR
DeepSeek-V4.1-Flash est open-weight et peut être auto-hébergé, mais « local » ne signifie pas « sur un PC de gaming ». DeepSeek le décrit comme une ossature Mixture-of-Experts de 552B paramètres utilisant une architecture d’encodeur-décodeur causal (CED), avec seulement 8B de paramètres actifs pendant le traitement du prompt et 16B pendant la génération. Le modèle complet reste une cible de déploiement à l’échelle frontière.
La recette de déploiement vLLM actuelle situe le checkpoint à environ 511 GB sur disque et environ 614 GB de VRAM minimale, ce qui rend un serveur de classe 8×H200 ou un système à très grande mémoire bien plus réaliste qu’une station grand public.
Pour les équipes qui n’ont besoin que d’un accès et non d’un contrôle au niveau des poids, l’API DeepSeek V4.1 Flash dans CometAPI est nettement plus simple que la maintenance d’un serveur d’inférence multi-GPU.
Points clés
- DeepSeek-V4.1-Flash utilise une ossature MoE de 552B avec 8B de paramètres actifs pendant le préremplissage et 16B pendant le décodage ; les paramètres actifs ne représentent pas l’exigence de mémoire résidente.
- Sa fenêtre de contexte de 1,048,576 jetons et un cache KV global de 890 octets par jeton réduisent la pression sur le cache, mais les poids du modèle dominent toujours la planification de capacité.
- Le checkpoint officiel est d’environ 511 GB sur disque. La recette vLLM estime environ 614 GB de VRAM utilisable agrégée comme budget minimal pour charger le modèle et son surcoût d’exécution ; c’est une estimation de base, pas une garantie pour chaque taille de lot, longueur de contexte ou configuration multimodale.
- vLLM est la voie la plus claire pour un service de production, tandis que SGLang cible l’inférence distribuée avancée ; la route actuelle d’Ollama est hébergée dans le cloud plutôt qu’un véritable local.
- L’auto-hébergement est particulièrement intéressant pour la confidentialité, l’opération en environnement isolé, la recherche au niveau des poids ou l’utilisation soutenue d’un cluster ; la plupart des développeurs trouveront une API hébergée plus simple.
Qu’est-ce que DeepSeek-V4.1-Flash ? Architecture, paramètres et taille du modèle
DeepSeek a officiellement publié V4.1-Flash le 10 septembre 2026 comme le plus petit modèle de sa nouvelle famille d’architectures, avec compréhension visuelle native. Malgré le nom « Flash », ce n’est pas un petit modèle dense.
Son principal changement architectural est le design d’encodeur-décodeur causal (CED). Le modèle répartit le calcul de façon asymétrique entre l’ingestion du prompt et la génération de jetons, réduisant le calcul actif tout en conservant un très grand pool d’experts.
| Spécifications | DeepSeek-V4.1-Flash |
|---|---|
| Architecture | MoE multimodal avec encodeur-décodeur causal |
| Paramètres de l’ossature | 552B |
| Paramètres actifs, entrée | 8B |
| Paramètres actifs, sortie | 16B |
| Couches Transformer | 40 : 20 encodeur + 20 décodeur |
| Fenêtre de contexte | 1,048,576 jetons |
| Cache KV global | 890 octets/jeton |
| Modalités | Entrée texte + image, sortie texte |
| Licence des poids | MIT |
| Échantillonnage recommandé | Température 1.0 ; top_p 0.95 ou 1.0 |
| Poids officiels | Hugging Face |
| Options principales de service local | vLLM, SGLang, DeepSeek reference inference |
La distinction entre paramètres actifs et paramètres résidents est essentielle. Le routage MoE réduit la quantité de calcul utilisée pour un jeton donné, mais le serveur doit toujours avoir accès aux poids des experts susceptibles d’être sélectionnés. C’est pourquoi un modèle « 8B actifs » peut tout de même nécessiter des centaines de gigaoctets de stockage et de mémoire d’accélérateur.
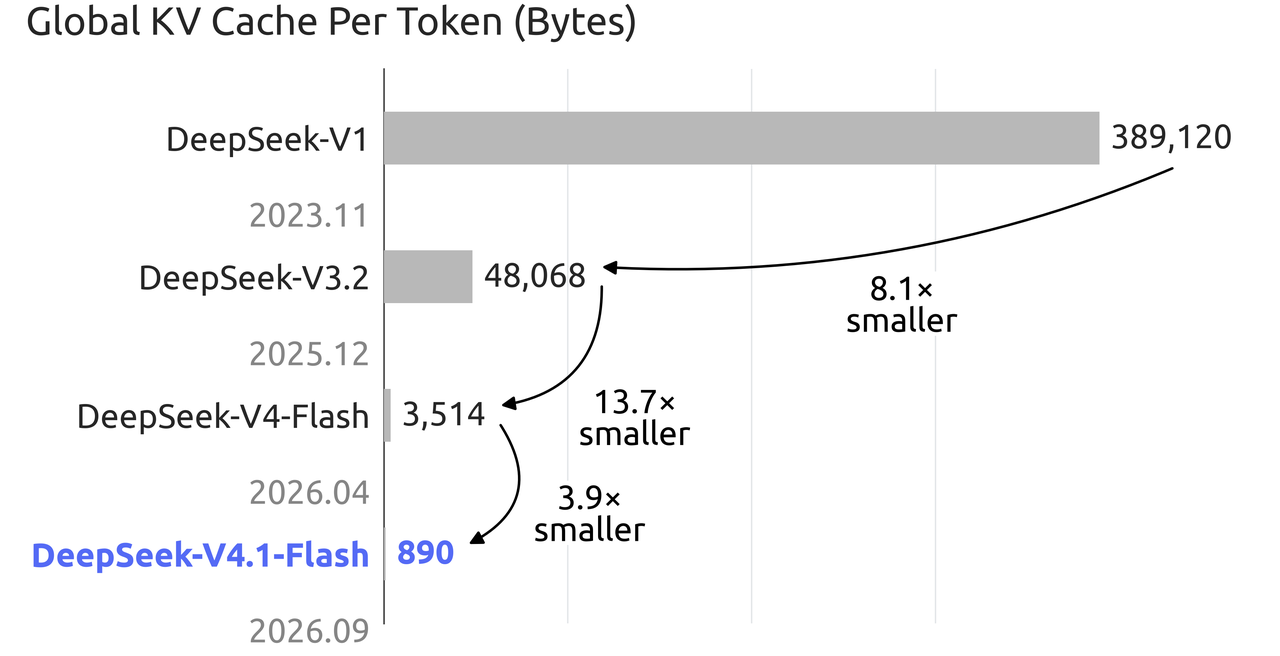
Le graphique officiel de DeepSeek sur le cache KV montre une baisse du cache global de 3,514 octets par jeton dans V4 Flash à 890 octets par jeton dans V4.1 Flash, soit une réduction d’environ 3,9×. Cela compte pour l’inférence à un million de jetons, mais cela n’élimine pas l’exigence mémoire bien plus importante créée par les poids du modèle eux-mêmes.
Quelle est la qualité de DeepSeek-V4.1-Flash avant de le déployer ?
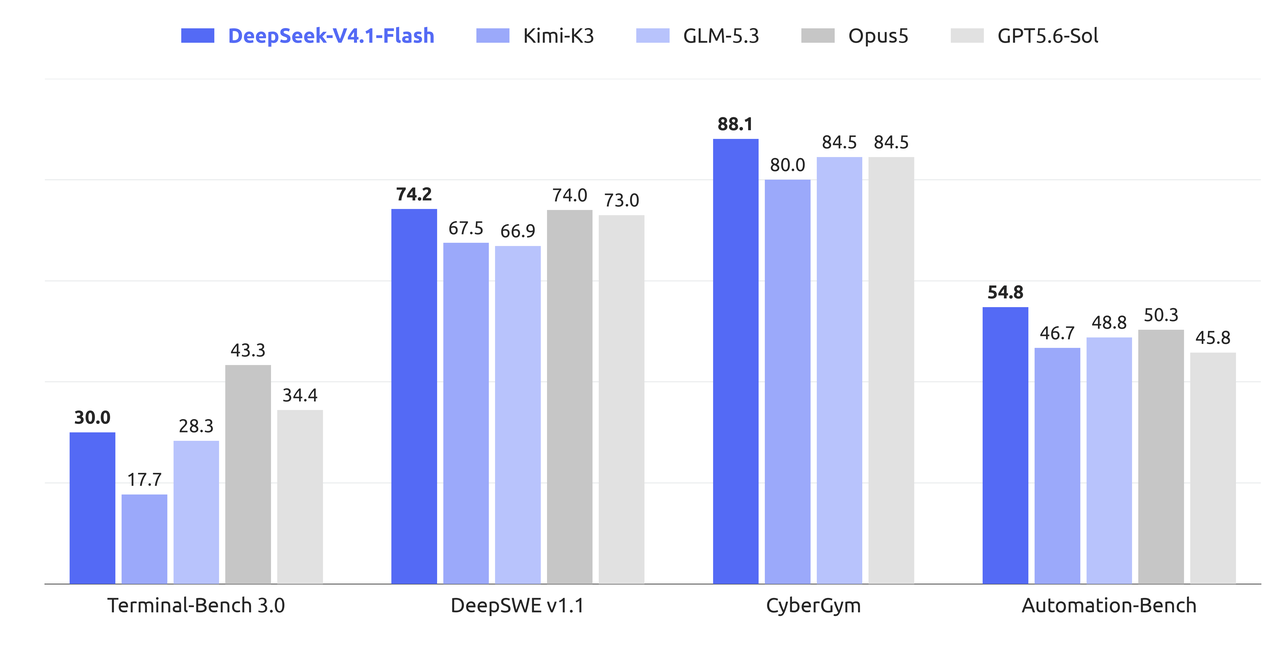
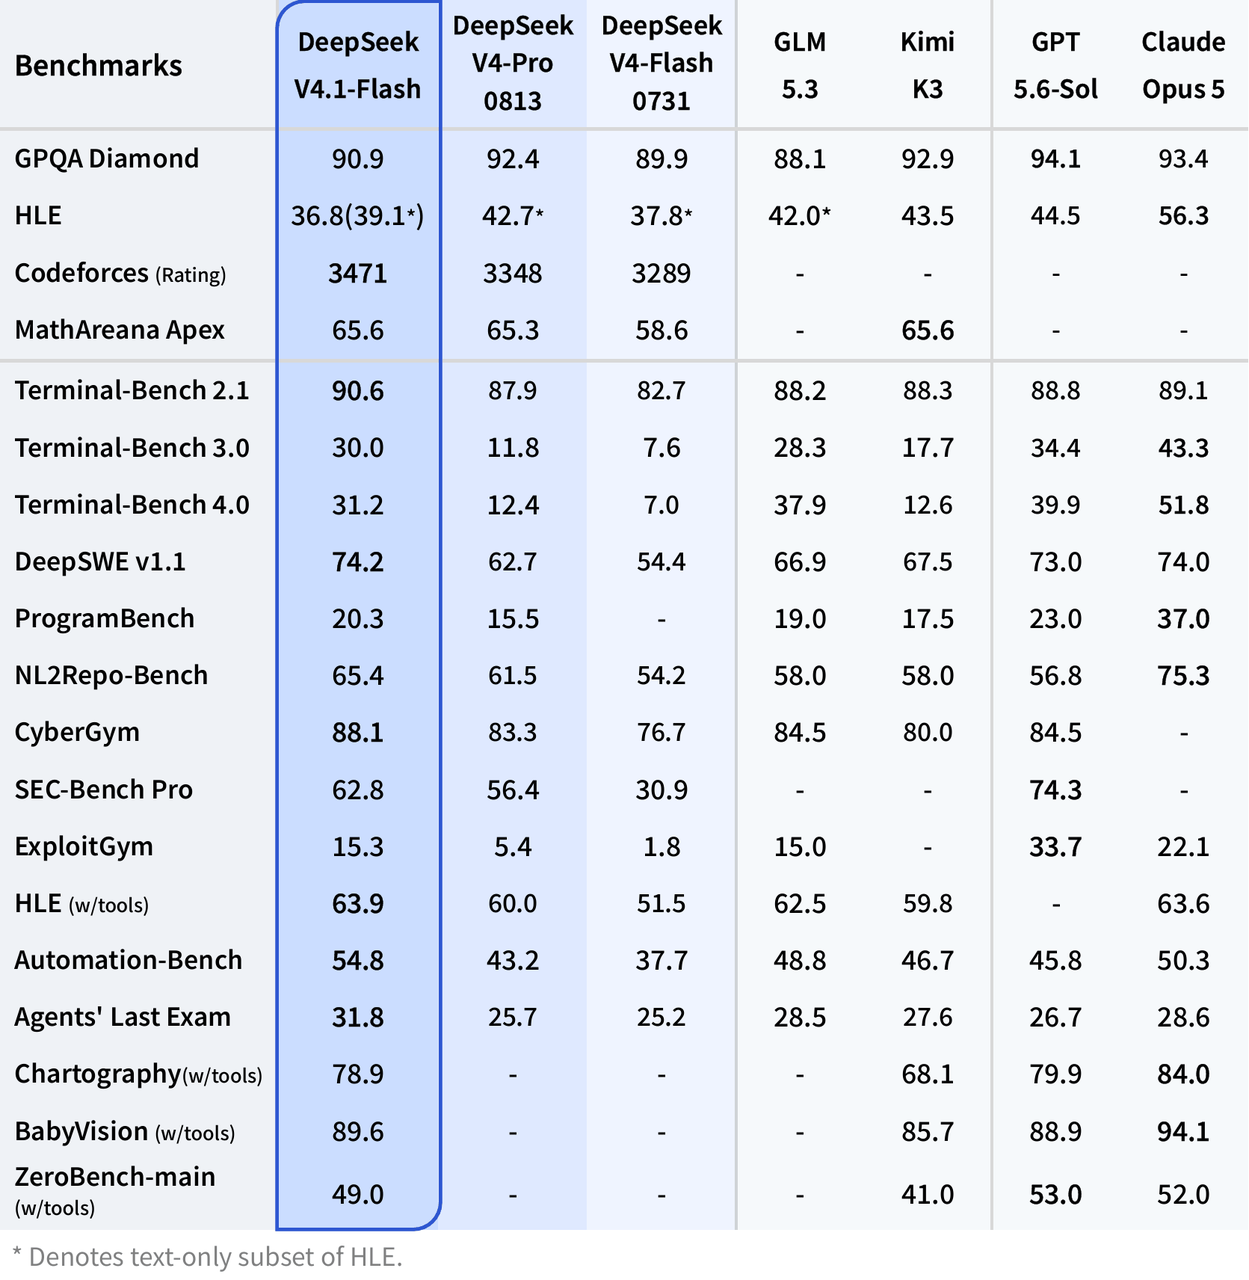
Le tableau de benchmarks publié par DeepSeek positionne V4.1-Flash principalement comme une mise à niveau majeure pour le codage agentique, l’opération de terminal, l’automatisation et les charges de travail d’ingénierie logicielle. Ce sont des résultats de benchmarks rapportés par le fournisseur, à considérer comme des mesures de référence plutôt que des garanties de performance applicative.
Pour la reproductibilité, la fiche modèle officielle recommande une température de 1.0 et top_p 0.95, tandis que l’effort de raisonnement et les budgets de jetons varient selon l’évaluation. Les chiffres ci-dessous sont des résultats de référence exécutés par le fournisseur, non des garanties de performance matérielle neutre ; il convient de consulter les détails spécifiques des bancs d’essai avant de les reproduire.
| Benchmark | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 | DeepSeek V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Codeforces Rating | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | 7.6 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | 7.0 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
Le motif compte davantage que chaque score isolé. V4.1-Flash ne mène pas tous les benchmarks, mais le saut depuis V4 Flash 0731 est particulièrement important sur Terminal-Bench, DeepSWE, l’automatisation et la cybersécurité. Cela rend le déploiement local particulièrement pertinent pour les agents de codage privés, l’analyse à l’échelle d’un dépôt, l’automatisation interne et l’infrastructure d’agents en environnement isolé.
Peut-on vraiment exécuter DeepSeek-V4.1-Flash en local ?
Oui, mais le terme « local » doit être qualifié. La dernière recette vLLM pour DeepSeek-V4.1-Flash décompose le checkpoint à environ un demi-téraoctet et recommande un budget de VRAM bien plus grand une fois le surcoût d’exécution inclus.
| Composant | Taille approximative stockée |
|---|---|
| Routed + DSpark experts | 259.5 GiB |
| Engram tables | 183.1 GiB |
| Attention, dense projections and routers | 6.9 GiB |
| Embeddings, LM head and norms | 3.9 GiB |
| UE8M0 block scales | 21.9 GiB |
| Point de contrôle complet | ~476 GiB / ~511 GB |
| Budget minimal de VRAM recommandé par vLLM | ~614 GB |
La principale surprise est que V4.1-Flash est déjà fortement compressé en interne. Les poids des experts routés utilisent des formats de faible précision, donc le checkpoint officiel n’est pas simplement un énorme modèle BF16 attendant une conversion aisée en 4 bits.
Exigences matérielles pour DeepSeek-V4.1-Flash
| Configuration matérielle | Statut pratique | Commentaires |
|---|---|---|
| 1× RTX 4090 / 5090 | Non | Bien en dessous de l’empreinte mémoire du modèle |
| 2–4 GPU grand public | Non pour le checkpoint complet officiel | La VRAM agrégée demeure insuffisante |
| Station 128 GB | Non | Les paramètres actifs ne déterminent pas la mémoire résidente des poids |
| Station 256 GB | Non pour la voie de service officielle | Toujours bien en dessous de l’empreinte du checkpoint officiel |
| 512 GB de RAM système + offload GPU | Expérimental | Territoire communauté/offload, non équivalent à un service de production vérifié |
| 4× GPU datacenter à grande mémoire | Dépend du matériel | Possible avec des accélérateurs modernes suffisamment grands ; vérifier la recette runtime |
| 8× H200 | Oui, classe documentée | Environ 1,128 GB de HBM agrégée |
| Système de classe GB200 NVL4 | Oui | vLLM cite un tray de 768 GB comme capable d’héberger le modèle |
Important : 8B de paramètres actifs ne signifie pas 8 GB de VRAM. « Actifs » décrit la part du réseau MoE participant au calcul d’un jeton. L’ensemble complet d’experts doit toujours être stocké quelque part et accessible au moteur d’inférence.
Quel runtime utiliser pour DeepSeek-V4.1-Flash ?
| Runtime | Statut actuel V4.1-Flash | Meilleur usage |
|---|---|---|
| vLLM | Recette de déploiement disponible ; image récente requise | Service de production compatible OpenAI |
| SGLang | Pris en charge via les builds de déploiement DeepSeek-V4.1 actuels | Inférence distribuée hautes performances |
| DeepSeek reference inference | Implémentation officielle TP8 de référence | Recherche d’architecture et validation |
| Transformers | Intégration du modèle exposée sur Hugging Face | Développement et expérimentation ; matériel toujours requis |
| Ollama | La voie de bibliothèque officielle utilise actuellement :cloud | Appel cloud pratique, pas équivalent à l’auto-hébergement |
Pour l’auto-hébergement en production, vLLM est actuellement le point de départ le plus clair. Les consignes de déploiement SGLang fournissent une autre voie prise en charge pour l’inférence distribuée avancée.
Comment exécuter DeepSeek-V4.1-Flash en local avec vLLM
C’est la voie pratique pour un serveur Linux multi-GPU.
Tous les exemples de commandes ci-dessous sont reformatés sous forme de blocs de code spécifiques à la langue avec de brèves descriptions en anglais.
Étape 1 : Vérifiez votre environnement
- Linux.
- Docker.
- NVIDIA Container Toolkit.
- Plusieurs centaines de gigaoctets d’espace SSD libre.
- Une configuration multi-GPU prise en charge.
- Environ 614 GB de mémoire d’accélérateur utilisable agrégée pour le profil de service des poids officiels actuel.
- Un réseau rapide si le modèle n’est pas déjà mis en cache localement.
Étape 2 : Téléchargez les poids de DeepSeek-V4.1-Flash
Les poids officiels sont hébergés dans le dépôt Hugging Face DeepSeek-V4.1-Flash sous licence MIT.
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
Assurez-vous que le système de fichiers hébergeant ~/.cache/huggingface dispose de bien plus de 511 GB libres. Les fichiers temporaires et d’autres artefacts du moteur peuvent augmenter l’usage disque de pointe.
Étape 3 : Démarrez DeepSeek-V4.1-Flash avec vLLM
Selon la recette vLLM actuelle, la prise en charge de DeepSeek-V4.1 nécessite une image vLLM suffisamment récente. Une configuration de départ texte seule à huit GPU peut ressembler à ceci :
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  vllm/vllm-openai:nightly \
  deepseek-ai/DeepSeek-V4.1-Flash \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 8 \
  --language-model-only \
  --tokenizer-mode deepseek_v41 \
  --tool-call-parser deepseek_v41 \
  --reasoning-parser deepseek_v41 \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.90 \
  --max-model-len 131072
Deux choix délibérés ici. D’abord, --language-model-only désactive l’encodeur de vision pour les charges de travail texte seules. Ensuite, démarrer à 131,072 jetons est plus sûr que d’activer immédiatement la fenêtre de contexte complète d’un million de jetons. Une fois le serveur stable, vous pouvez l’augmenter :
--max-model-len 1048576
Le réglage de parallélisme tensoriel approprié dépend de la topologie de l’accélérateur, ne copiez donc pas aveuglément --tensor-parallel-size 8 sur chaque serveur.
Étape 4 : Testez l’endpoint local DeepSeek-V4.1-Flash
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "What is 17 * 19? Return only the integer."
      }
    ]
  }'
323
Étape 5 : Appelez votre serveur local DeepSeek-V4.1-Flash avec Python
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Explain the difference between TCP and UDP in three bullets."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
Comment activer le mode de réflexion de DeepSeek-V4.1-Flash en local ?
V4.1-Flash prend en charge des contrôles explicites de raisonnement via son template de chat. Un exemple :
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Find the most efficient algorithm for this scheduling problem."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
Si le modèle semble renvoyer peu ou pas de contenu final avec une petite valeur de max_tokens, vérifiez si le mode réflexion consomme le budget de génération avant de supposer que le déploiement est défaillant.
Comment exécuter DeepSeek-V4.1-Flash avec le code de référence ?
DeepSeek inclut aussi une implémentation d’inférence TP8 minimale dans le dépôt du modèle. Elle est destinée principalement comme code de référence lisible plutôt que serveur de production à haut débit.
cd inference
python -m pip install -r requirements.txt
export HF_CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-HF
export SAVE_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

python convert.py \
  --hf-ckpt-path "${HF_CKPT_PATH}" \
  --save-path "${SAVE_PATH}" \
  --model-parallel "${MP}" \
  --expert-dtype fp4 \
  --tokenizer-path "${HF_CKPT_PATH}"
export CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

torchrun --nproc-per-node "${MP}" generate.py \
  --ckpt-path "${CKPT_PATH}" \
  --config config.json \
  --interactive \
  --temperature 0.6
Cette voie est utile pour inspecter CED, le routage MoE, la mémoire Engram, le décodage spéculatif et les détails d’implémentation associés. Pour un service de production normal, vLLM ou SGLang sont plus faciles à opérer.
Peut-on exécuter DeepSeek-V4.1-Flash en local avec Ollama ?
Pas au même sens que l’exécution d’un modèle Ollama 7B ou 32B classique. Ollama expose actuellement V4.1-Flash via :
ollama run deepseek-v4.1-flash:cloud
La partie importante est :cloud. L’entrée de bibliothèque Ollama actuelle utilise une route cloud, donc cette commande n’équivaut pas à télécharger les poids complets et exécuter l’inférence entièrement sur votre machine.
Déploiement local de DeepSeek-V4.1-Flash vs API : lequel a le plus de sens ?
| Dimension | DeepSeek-V4.1-Flash local | API hébergée |
|---|---|---|
| Matériel initial | Très élevé | Aucun |
| Mémoire d’accélérateur | ~614 GB cible officielle pratique | Gérée par le fournisseur |
| Contrôle du modèle | Complet | Limité |
| Données sur site | Oui | Non |
| Modification des poids | Oui | Non |
| Maintenance | À votre charge | Gérée par le fournisseur |
| Complexité d’installation | Élevée | Faible |
| Scalabilité | Nécessite une infrastructure | Basée sur API |
| Idéal pour | Environnements isolés, privés, recherche, clusters à forte utilisation | La plupart des développeurs et applis en production |
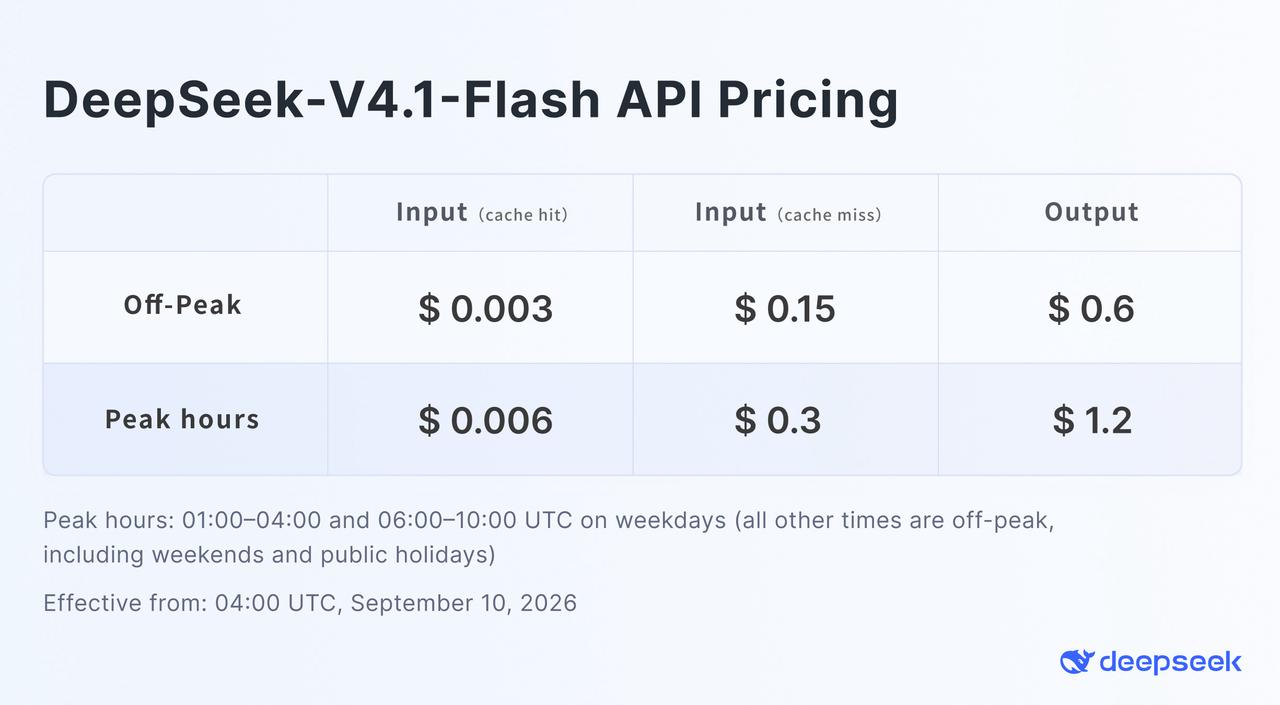
La tarification officielle hors pointe de DeepSeek est présentée dans son visuel de tarification V4.1-Flash. Pour les développeurs n’ayant pas besoin de posséder physiquement les poids, l’API DeepSeek V4.1 Flash dans CometAPI fournit une alternative compatible OpenAI.
L’exemple suivant utilise l’identifiant de modèle de CometAPI. Ce n’est pas l’identifiant utilisé par l’API officielle de DeepSeek.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Review this Python function and identify possible race conditions."
        }
    ]
)

print(response.choices[0].message.content)
La décision pratique est simple : le déploiement local devient convaincant lorsque la confidentialité, l’opération en environnement isolé, l’expérimentation au niveau des poids, une utilisation lourde et prévisible ou des exigences réglementaires l’emportent sur le coût d’infrastructure. Pour un développement applicatif ordinaire, un endpoint hébergé évite des centaines de gigaoctets de gestion de modèle et l’orchestration multi-GPU.
Quels problèmes pouvez-vous rencontrer lors de l’exécution locale de DeepSeek-V4.1-Flash ?
Le serveur manque de mémoire avant le début de la génération
Le checkpoint complet, et non le chiffre 8B/16B de paramètres actifs, détermine l’essentiel de l’exigence mémoire. Vérifiez le parallélisme tensoriel, l’utilisation mémoire GPU, le chargement de la vision et la HBM disponible.
DeepSeek-V4.1-Flash met longtemps à démarrer
Un checkpoint d’un demi-téraoctet prend du temps à être téléchargé, mappé, initialisé et shardé. De longs délais d’attente de disponibilité du moteur sont normaux pour cette classe de modèle.
La réponse est vide ou se termine par finish_reason=length
Le mode réflexion peut consommer le budget de génération. Augmentez max_tokens, réduisez l’effort de raisonnement ou désactivez la réflexion pour des requêtes simples.
Les appels d’outils ne se parsant pas correctement
Assurez-vous que le serveur utilise le tokenizer DeepSeek V4.1, le parseur d’appels d’outils, le parseur de raisonnement et les options d’auto-choix d’outil.
L’entrée vision ne fonctionne pas
Si vous avez lancé avec --language-model-only, vous avez intentionnellement désactivé l’encodeur visuel. Redémarrez avec la prise en charge multimodale activée avant de tester les images.
Devriez-vous exécuter DeepSeek-V4.1-Flash en local ?
DeepSeek-V4.1-Flash est particulièrement intéressant du point de vue de l’auto-hébergement car son architecture réduit sensiblement le calcul par jeton et le coût du cache KV, mais cela ne transforme pas un modèle open-weight de frontière en un modèle de bureau.
Pour un labo de recherche, une plateforme IA d’entreprise, une pile d’agents de codage privée ou un environnement isolé, vLLM et SGLang rendent l’auto-hébergement techniquement réaliste. Pour un développeur avec une ou deux GPU, ce n’est pas une cible de déploiement du modèle complet pratique. Dans ce cas, utiliser DeepSeek V4.1 Flash via CometAPI donne accès au modèle sans transformer le service en un grand projet d’infrastructure.
FAQ
DeepSeek-V4.1-Flash est-il open source ?
Ses poids et son dépôt sont publiés sous licence MIT, qui permet un large usage, modification et redistribution sous réserve des termes de la licence.
Puis-je exécuter DeepSeek-V4.1-Flash sur une RTX 4090 ou RTX 5090 ?
Pas le modèle officiel complet. Un seul GPU grand public ne dispose que d’une petite fraction de la mémoire requise par le checkpoint complet.
8B de paramètres actifs signifie-t-il que DeepSeek-V4.1-Flash n’a besoin que de 8 GB de VRAM ?
Non. Le chiffre 8B décrit les paramètres participant pendant le traitement du prompt. L’ensemble complet d’experts et l’état de support doivent toujours être stockés et accessibles.
De combien de VRAM DeepSeek-V4.1-Flash a-t-il besoin ?
La recette vLLM actuelle utilise environ 614 GB comme chiffre de planification pour le checkpoint officiel plus le surcoût d’exécution. Les besoins réels varient selon le matériel, la taille de lot, le contexte, la prise en charge vision et la configuration de service.
Quelle est la taille de DeepSeek-V4.1-Flash sur disque ?
La décomposition vLLM actuelle situe le checkpoint à environ 476 GiB, soit environ 511 GB.
DeepSeek-V4.1-Flash peut-il exécuter un contexte de 1M de jetons en local ?
L’architecture prend en charge jusqu’à 1,048,576 jetons, mais l’usage mémoire pratique dépend aussi de la taille de lot, des tampons runtime, de l’état vision et d’autres surcoûts.
Puis-je exécuter DeepSeek-V4.1-Flash en local avec Ollama ?
L’entrée Ollama actuelle utilise une route :cloud, ce qui n’est pas équivalent à exécuter les poids complets entièrement sur votre propre machine.
vLLM ou SGLang est-il meilleur pour DeepSeek-V4.1-Flash ?
Les deux visent un service hautes performances. vLLM dispose actuellement d’une recette particulièrement détaillée spécifique à V4.1, tandis que SGLang convient également aux déploiements distribués avancés.
Quel est le moyen le plus simple d’utiliser DeepSeek-V4.1-Flash sans matériel local ?
Utilisez une API hébergée. DeepSeek fournit sa propre API, tandis que CometAPI propose un endpoint DeepSeek-V4.1-Flash compatible OpenAI aux côtés d’autres modèles IA.