
TL;DR
MiniMax M3.1 Flash est un modèle d’IA haute vitesse conçu pour les agents autonomes, l’ingénierie logicielle, l’utilisation de l’ordinateur et l’automatisation de workflows complexes. Officiellement lancé le 19 octobre 2026, il combine une fenêtre de contexte d’1 million de tokens avec une profondeur de raisonnement configurable et des coûts d’inférence plus bas.
MiniMax annonce jusqu’à 200+ tokens de sortie par seconde, une réduction de 70% des coûts de charge de travail des agents par rapport à son prédécesseur, et des performances compétitives sur Automation-Bench, DeepSWE et OSWorld. À $0.15 par million de tokens d’entrée et $0.60 par million de tokens de sortie, le modèle rend les workflows d’agents IA multi-étapes plus économiques.
Key Takeaways
- Performances de MiniMax M3.1 Flash : les benchmarks déclarés par le fournisseur incluent Automation-Bench 62.8, DeepSWE v1.1 73.7 et OSWorld 2.0 61.7, mettant en évidence ses capacités en automatisation d’agents, en codage et en utilisation de l’ordinateur.
- Tarification de l’API MiniMax M3.1 Flash : les tarifs officiels sont $0.15/M en entrée, $0.60/M en sortie et $0.015/M en entrée mise en cache. Les tarifs CometAPI sont $0.80/M en entrée et $3.20/M en sortie au 21 octobre 2026, sans tarif de cache publié sur la page du modèle.
- Vitesse d’inférence de MiniMax M3.1 Flash : MiniMax indique 200+ tokens/s dans des conditions favorables et un débit P50 supérieur à 170 tokens/s, soutenant des workflows d’agents réactifs.
- Efficacité des agents MiniMax M3.1 Flash : cinq niveaux d’effort de raisonnement permettent aux développeurs d’équilibrer réussite des tâches, latence et coûts globaux des agents IA.
- Accès à l’API MiniMax M3.1 Flash : les développeurs peuvent accéder au modèle via MiniMax ou explorer l’intégration CometAPI en utilisant des identifiants de modèle et des tarifs spécifiques au fournisseur.
What Is MiniMax M3.1 Flash?
MiniMax M3.1 Flash est un modèle de langage de nouvelle génération optimisé pour le raisonnement agentique, le codage, l’utilisation d’outils et l’exécution autonome de workflows. MiniMax a officiellement présenté M3.1 Flash le 19 octobre 2026.
Plutôt que de se concentrer exclusivement sur l’intelligence conversationnelle ou des scores isolés, il cible le coût total d’achèvement des tâches via un raisonnement répété, des appels d’outils et une exécution multi-étapes. MiniMax a également associé son développement initial à Space Bunny, un modèle déployé anonymement qui, selon eux, a traité plus de 200 trillions de tokens avant l’annonce ; il s’agit d’une valeur d’utilisation déclarée, et non d’un nombre de tokens d’entraînement publié.
Pour les développeurs construisant des assistants de codage autonomes, des collègues IA en entreprise et des agents basés navigateur, M3.1 Flash offre trois avantages pertinents : une grande capacité de contexte, une génération rapide et une utilisation de tokens peu coûteuse.
What Are MiniMax M3.1 Flash’s Specifications?
| Spécifications de l’API | MiniMax M3.1 Flash |
|---|---|
| Développeur | MiniMax |
| Date de sortie officielle | October 19, 2026 |
| Famille de modèles | MiniMax M3 |
| Fenêtre de contexte | 1,000,000 tokens |
| Capacités principales | Agent automation, coding, reasoning, computer use |
| Modalités d’entrée | Text, image, and video via MiniMax's OpenAI-compatible API; confirm support on other providers |
| Modalité de sortie | Text |
| Reasoning controls | Low, medium, high, xhigh, max |
| Vitesse de sortie rapportée | Up to 200+ tokens/s |
| Vitesse P50 rapportée | 170+ tokens/s |
| Canaux d’accès | MiniMax API, M Plan, MiniMax Code |
| Poids ouverts | Announced for future release |
| Nombre de paramètres spécifique à M3.1 | Not established in the announcement |
Une grande fenêtre de contexte est utile pour le codage à l’échelle d’un dépôt et les workflows riches en documents, mais ne garantit pas un rappel parfait. En production, les agents doivent toujours utiliser une récupération sélective, des réponses d’outils structurées et une compression du contexte.
Cinq réglages d’effort de raisonnement permettent aux développeurs de réserver un calcul intensif pour la planification et le débogage complexes, au lieu de dépenser un effort maximal pour chaque classification, extraction ou simple étape de sélection d’outil. Étant donné qu’une seule requête d’agent peut déclencher des dizaines d’invocations du modèle, de petites économies sur les étapes routinières peuvent réduire de manière significative le coût total.
How Does MiniMax M3.1 Flash Perform on Benchmarks?
MiniMax rapporte des résultats de benchmarks couvrant l’automatisation métier, l’ingénierie logicielle, l’utilisation de l’ordinateur, la cybersécurité et le raisonnement multimodal. Il s’agit d’évaluations déclarées par le fournisseur, qui ne remplacent pas des tests indépendants d’un déploiement réel.
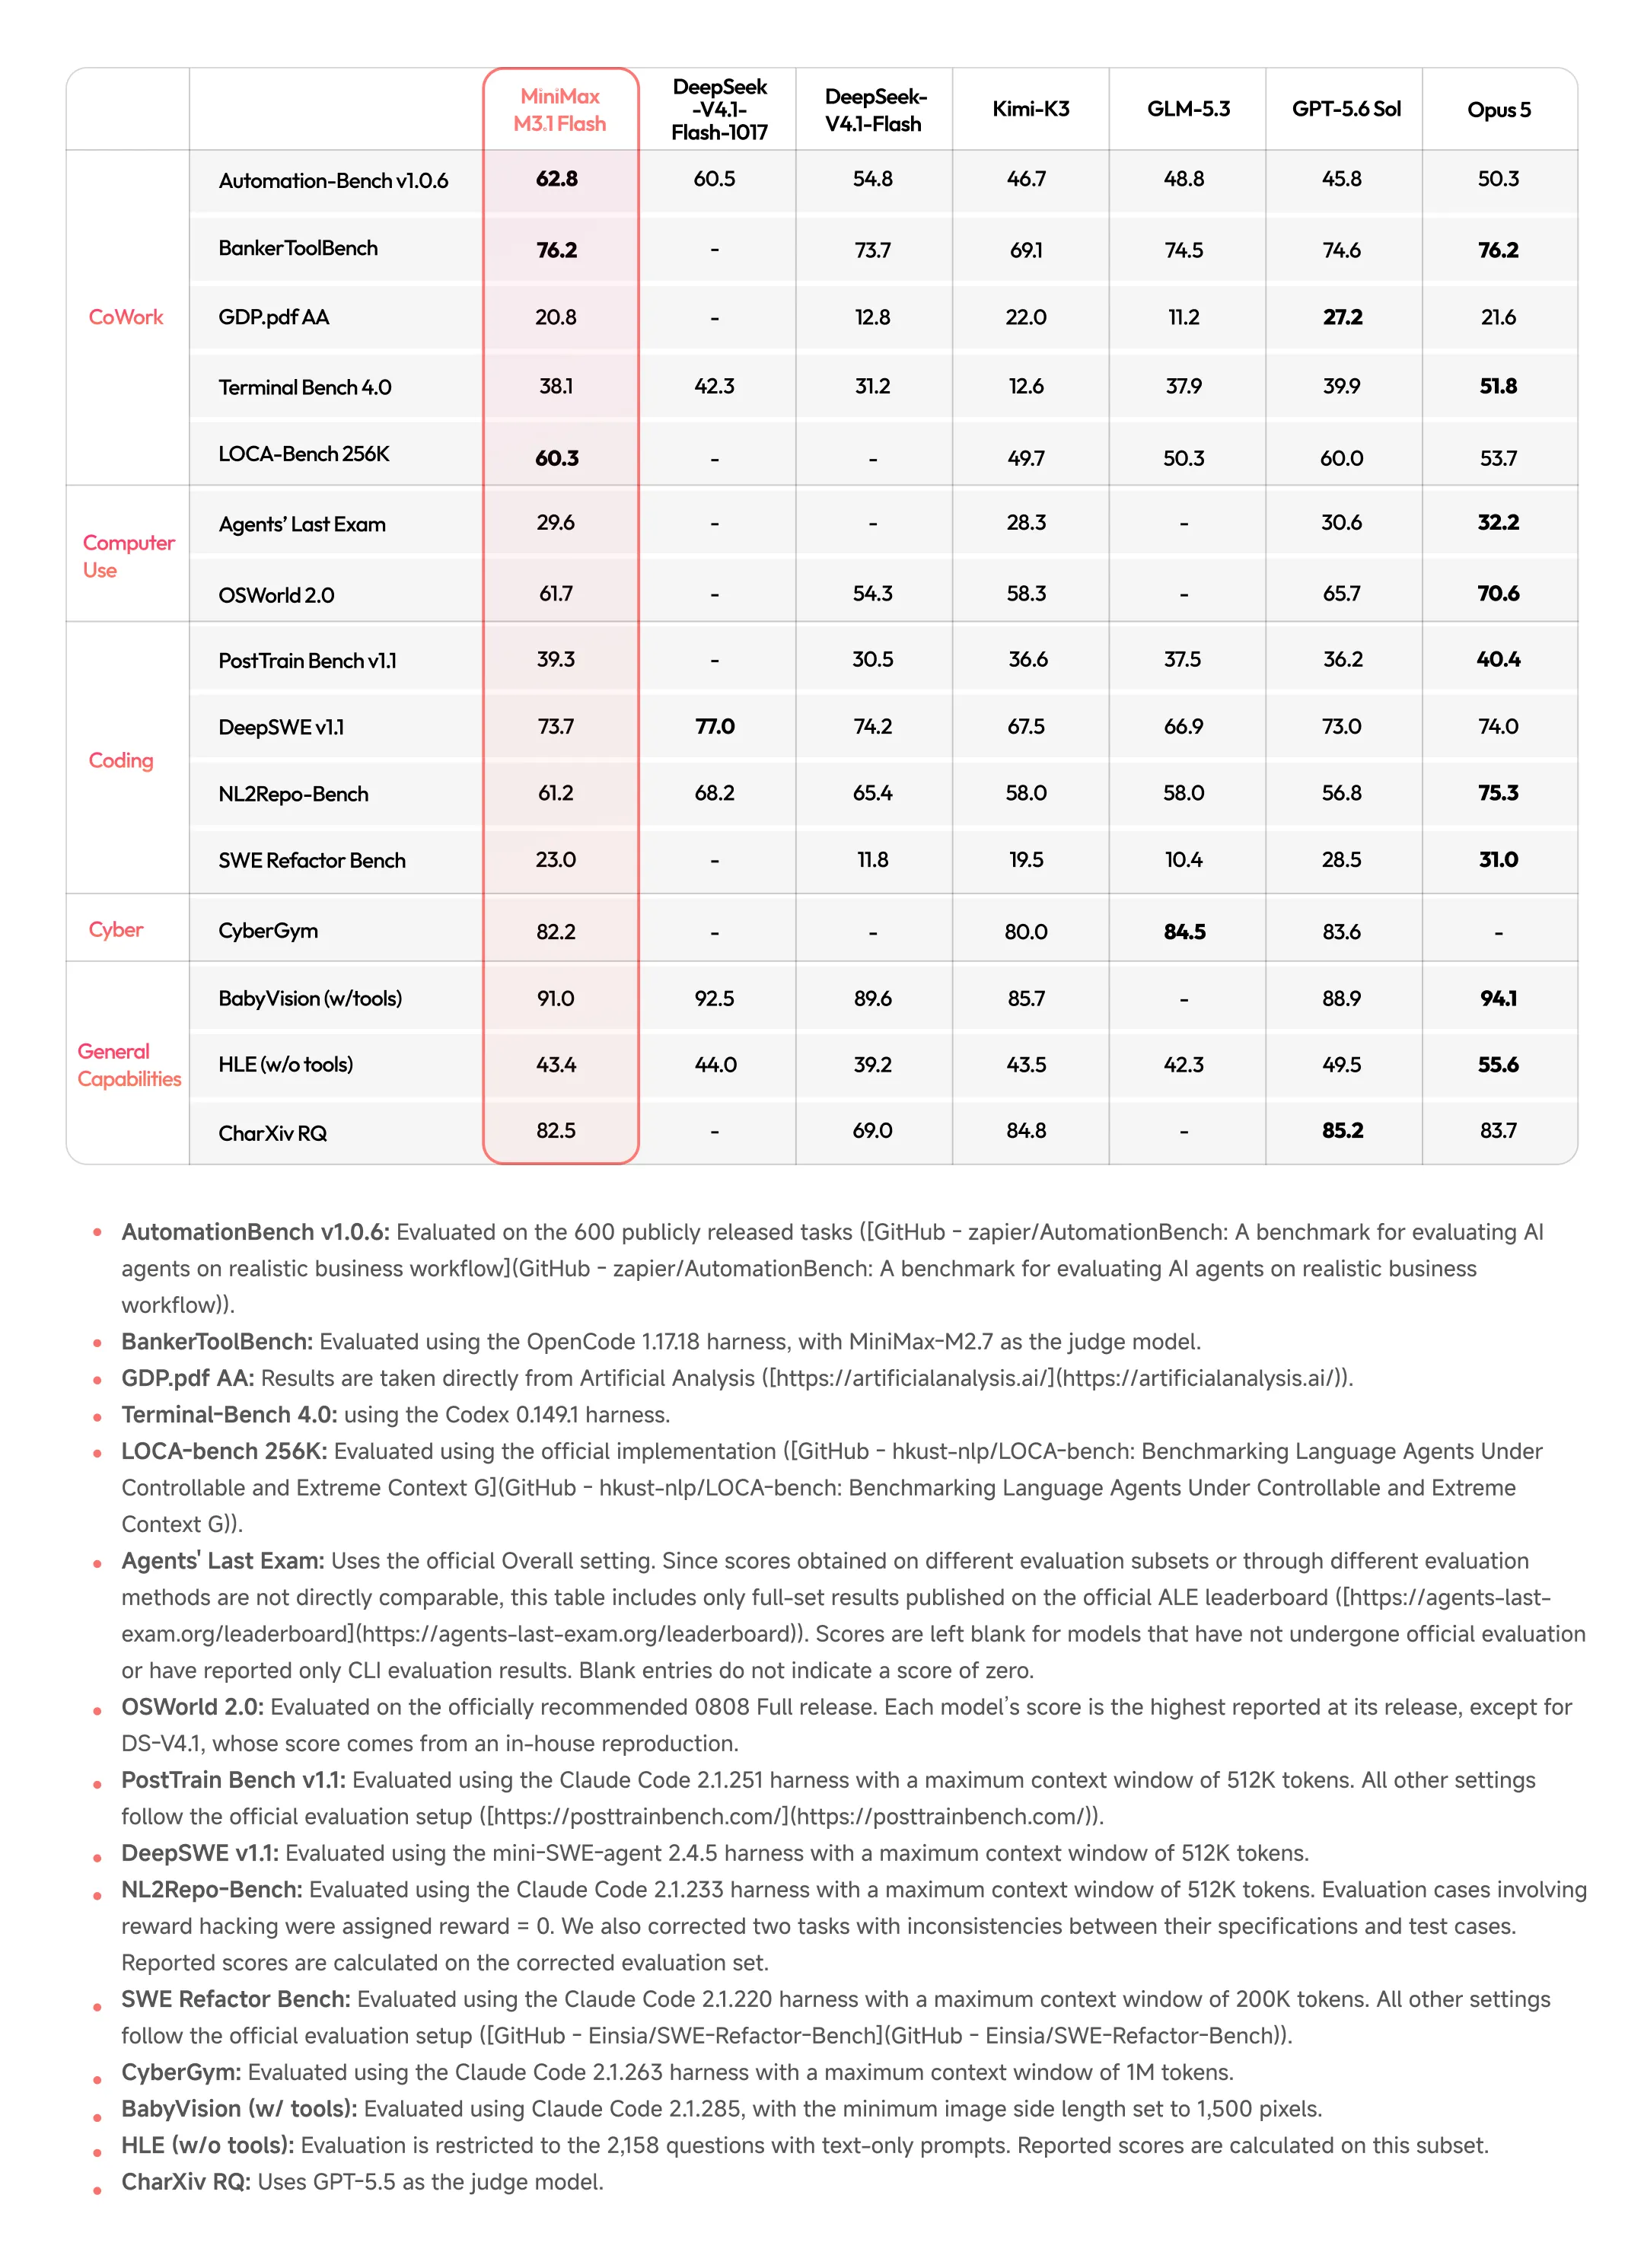
Comparaison officielle des benchmarks de MiniMax, incluant les notes d’évaluation. Les scores sont déclarés par le fournisseur et ne représentent pas un test indépendant uniforme.
| Résultats officiels de benchmark | M3.1 Flash | Ce que cela mesure |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | Automatisation d’entreprise multi-étapes |
| BankerToolBench | 76.2 | Raisonnement financier et outils |
| LOCA-Bench 256K | 60.3 | Exécution d’agent à long contexte |
| DeepSWE v1.1 | 73.7 | Ingénierie logicielle autonome |
| Terminal Bench 4.0 | 38.1 | Résolution de problèmes en terminal |
| OSWorld 2.0 | 61.7 | Interaction bureau / ordinateur |
| Agents’ Last Exam | 29.6 | Tâches économiques complexes |
| CyberGym | 82.2 | Résolution de problèmes de cybersécurité |
| BabyVision with tools | 91.0 | Raisonnement visuel avec outils |
| HLE without tools | 43.4 | Connaissances et raisonnement difficiles |
Automation-Bench v1.0.6 utilise 600 tâches publiques. BankerToolBench utilise OpenCode 1.17.18 avec MiniMax-M2.7 comme juge ; Terminal Bench 4.0 utilise Codex 0.149.1. DeepSWE v1.1 utilise mini-SWE-agent 2.4.5 avec une limite de contexte de 512K. OSWorld utilise la version 0808 Full : le tableau combine le score de version le plus élevé de chaque modèle, sauf DeepSeek V4.1, que MiniMax a reproduit en interne. Ces configurations différentes limitent les conclusions inter-modèles directes.
Pour l’automatisation métier, privilégiez Automation-Bench et BankerToolBench ; pour les agents de codage, examinez DeepSWE et les résultats basés sur le terminal. OSWorld évalue des interactions avec un environnement informatique plutôt que de simplement générer des instructions. Un score agrégé unique ne remplace pas une analyse spécifique à la tâche.
How Fast Is MiniMax M3.1 Flash?
Les systèmes d’agents effectuent fréquemment de nombreux appels de modèle séquentiels, de sorte que le débit seul ne décrit pas la réactivité.
| Indicateur de vitesse | Performance rapportée |
|---|---|
| Débit de sortie de pointe au quotidien | 200+ tokens/s |
| Débit médian de sortie (P50) | 170+ tokens/s |
| Amélioration de l’inférence en ligne | Nearly 3× vs prior generation |
| Réduction du coût de charge d’agent | 70% vs predecessor |
Ces chiffres de vitesse et de coût de charge de travail sont ceux déclarés par le fournisseur lors du lancement de MiniMax, et ne garantissent pas un débit ou des économies pour chaque application. Le matériel de service, la concurrence, la longueur des prompts et la variabilité d’un run à l’autre ne sont pas entièrement spécifiés dans l’annonce.
La latence de bout en bout inclut également le délai du premier token, les surcoûts de raisonnement, le temps d’outil, les réessais et les dépendances entre les étapes. Un générateur plus rapide peut perdre son avantage si un agent a besoin de plus d’appels pour accomplir la même tâche.
How Much Does MiniMax M3.1 Flash API Cost?
MiniMax a annoncé des tarifs standard plats pour M3.1 Flash sans niveau long-contexte séparé dans sa description tarifaire initiale. Pendant ce temps, l’API MiniMax M3.1 Flash Preview sur CometAPI propose une structure de prix distincte avec une remise de 20% par rapport à ses tarifs de référence affichés.
| Catégorie de tarification | Official M3.1 Flash | CometAPI Preview (≤512K) | CometAPI Preview (>512K) |
|---|---|---|---|
| Input tokens / 1M | $0.15 | $0.24 | $0.48 |
| Output tokens / 1M | $0.60 | $0.96 | $1.92 |
| Cached input / 1M | $0.02 | $0.05 | $0.10 |
| Pricing structure | Flat rate | Short-context tier | Long-context tier |
La tarification officielle de l’API MiniMax rend M3.1 Flash particulièrement attractif pour les charges de travail d’agents. Les tokens de sortie coûtent quatre fois le tarif d’entrée standard, tandis que l’entrée mise en cache coûte un dixième. Les instructions répétées et les historiques d’outils peuvent donc devenir une cible majeure d’optimisation.
La tarification Preview de CometAPI démarre à $0.24 par million de tokens d’entrée et $0.96 par million de tokens de sortie, ce qui représente une remise de 20% par rapport à ses prix de référence Preview affichés. Cependant, ces tarifs restent plus élevés que les nouveaux prix officiels annoncés de M3.1 Flash car les deux offres utilisent des bases tarifaires différentes.
Pour les développeurs, la distinction clé est que CometAPI fournit une expérience d’intégration unifiée, tandis que la version officielle propose actuellement des tarifs de tokens publiés plus bas. Avant le déploiement, vérifiez la version de modèle active, le niveau de longueur de contexte et les règles de facturation pour estimer avec précision le coût des workflows d’agents autonomes.
MiniMax M3.1 Flash Cost per Agent Task
Coût d’inférence estimé = (uncached input tokens × input rate + cached input tokens × cache rate + output tokens × output rate) / 1,000,000.
| Charge de travail illustrative | Uncached input | Cached input | Output | Coût estimé |
|---|---|---|---|---|
| Assistant d’outil simple | 10K | 0 | 2K | $0.0027 |
| Revue de pull request | 40K | 20K | 8K | $0.0111 |
| Agent de codage multi-étapes | 100K | 200K | 30K | $0.0360 |
| Recherche d’entreprise | 300K | 700K | 80K | $0.1035 |
| Grand workflow autonome | 1M | 3M | 200K | $0.3150 |
Calculs illustratifs, et non une facturation observée. Suppose que les lectures mises en cache bénéficient du tarif de cache annoncé ; exclut les frais d’outils, de recherche, de navigateur, d’infrastructure et de relecture humaine.
Reasoning Effort and Task Cost
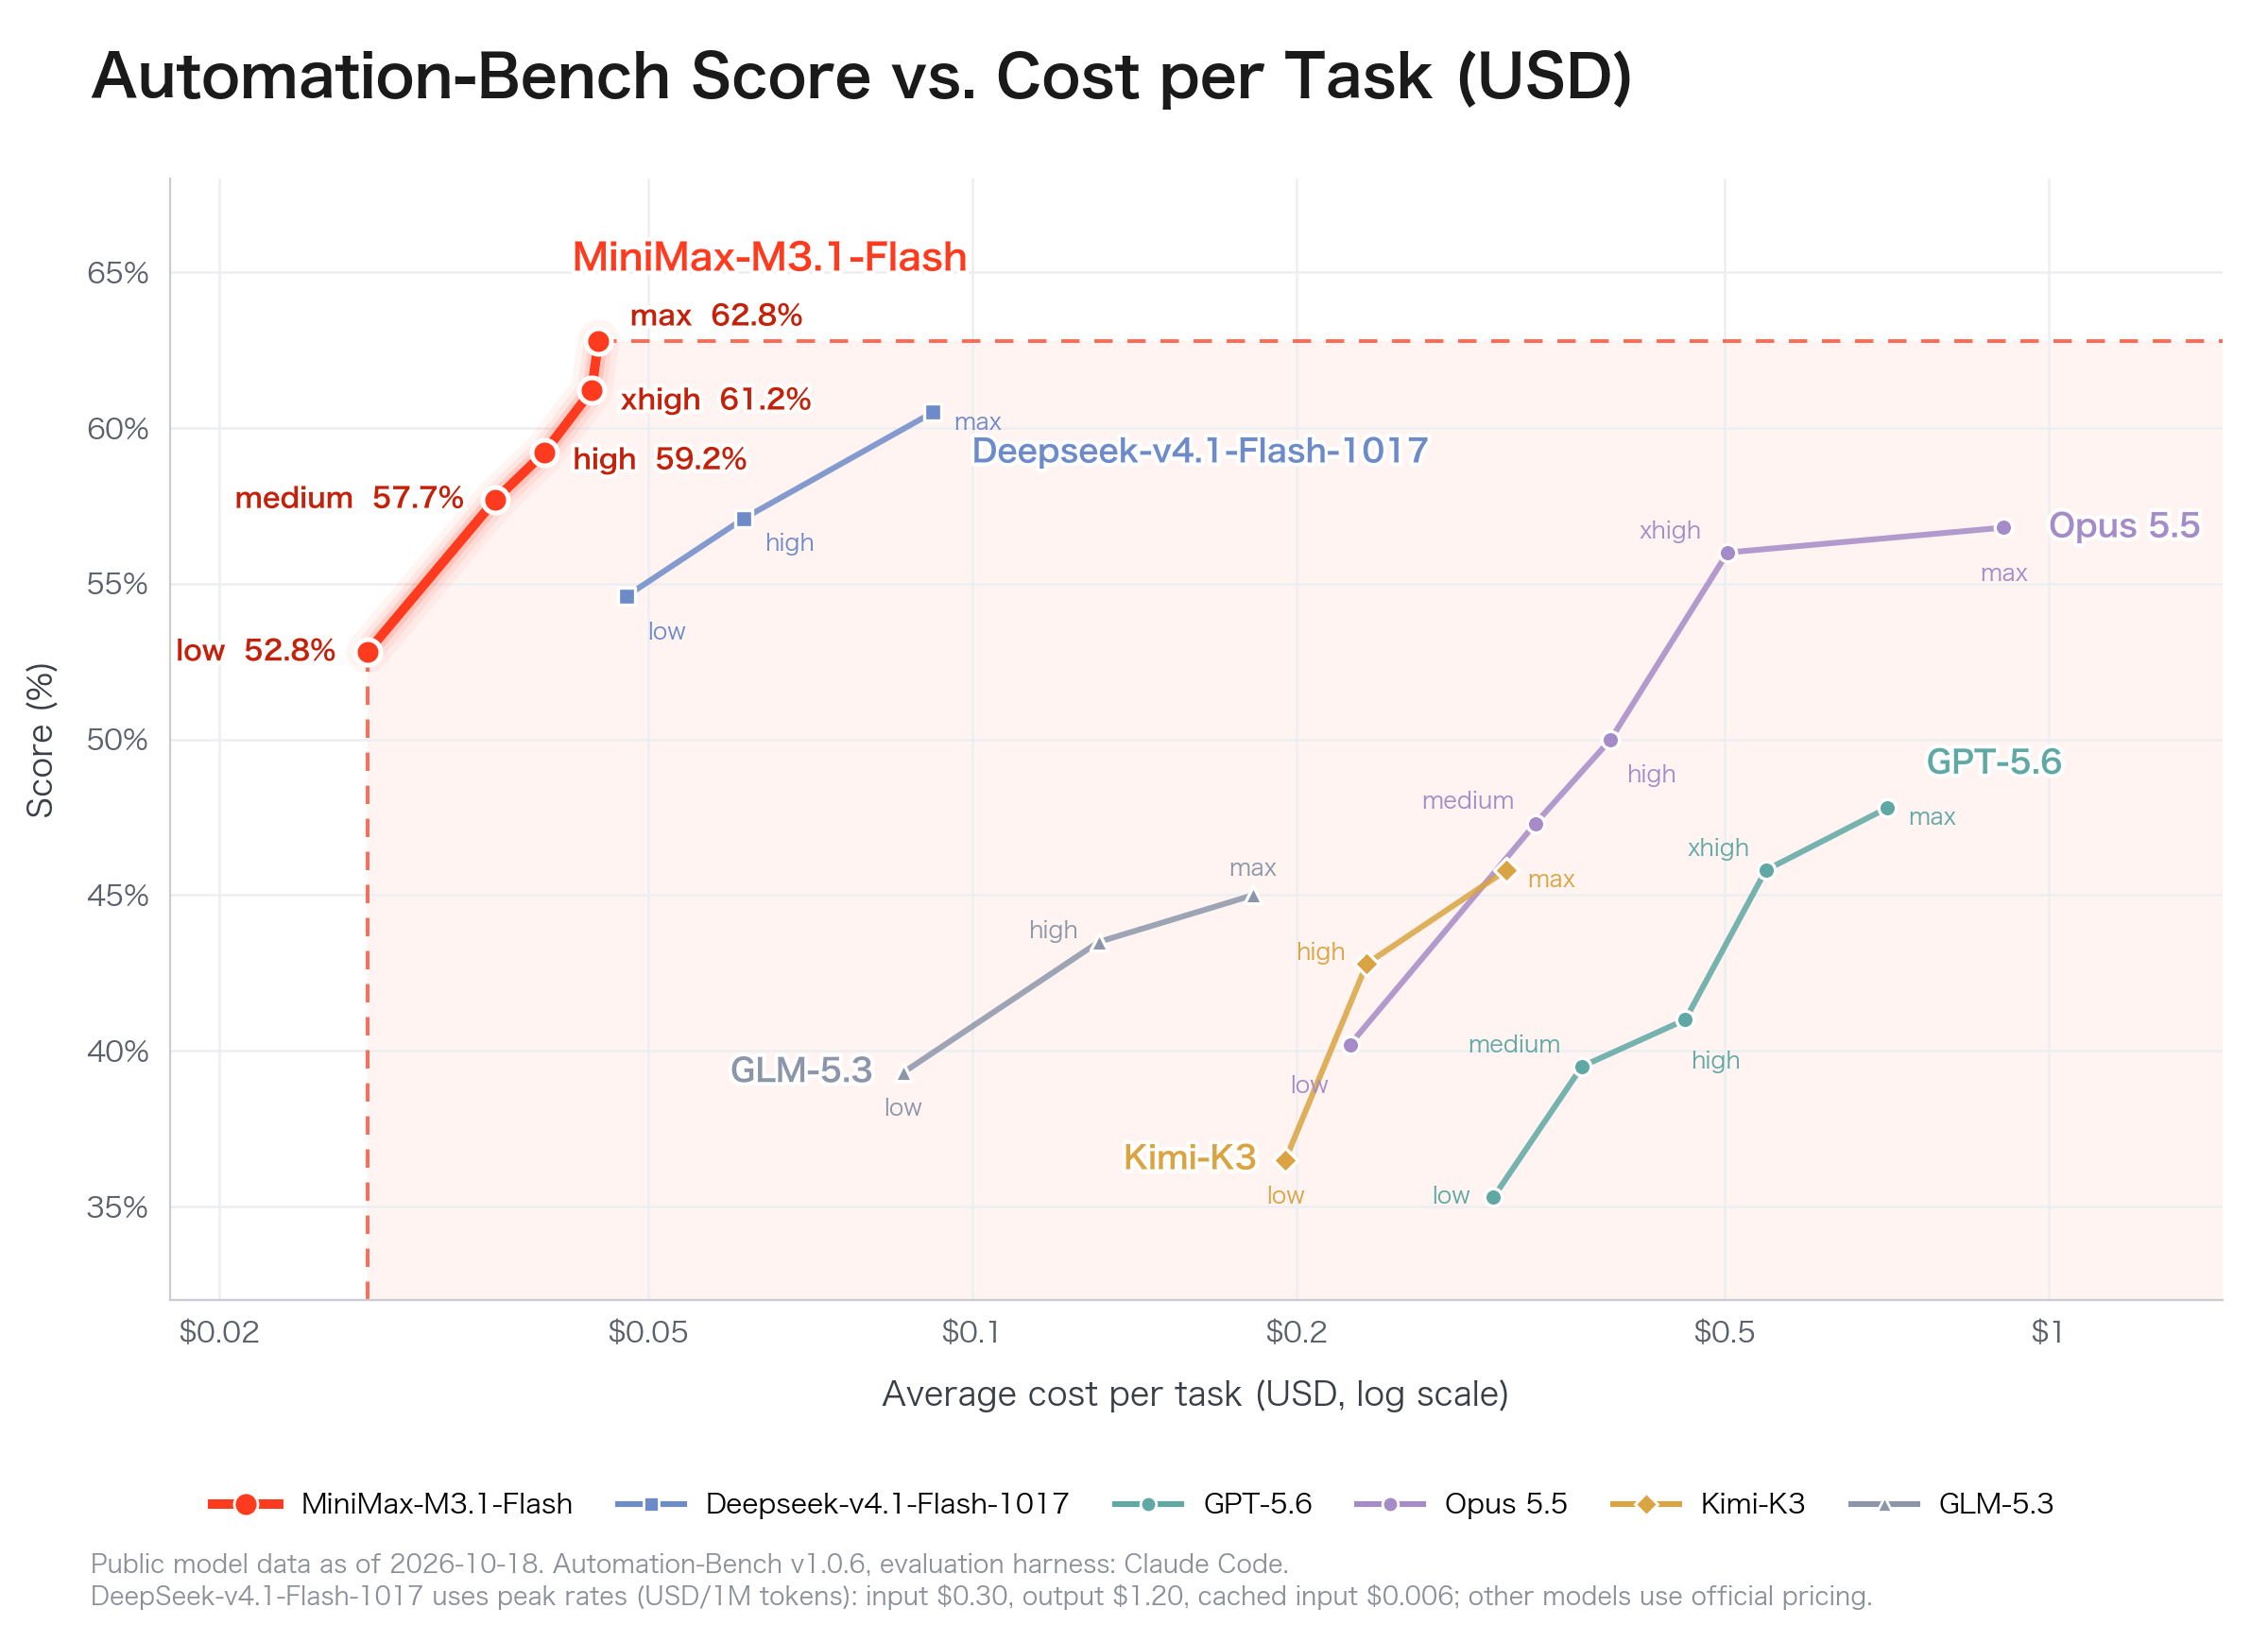
L’analyse des coûts d’Automation-Bench par MiniMax relie l’effort de raisonnement au succès au benchmark et aux dépenses d’inférence par tâche.
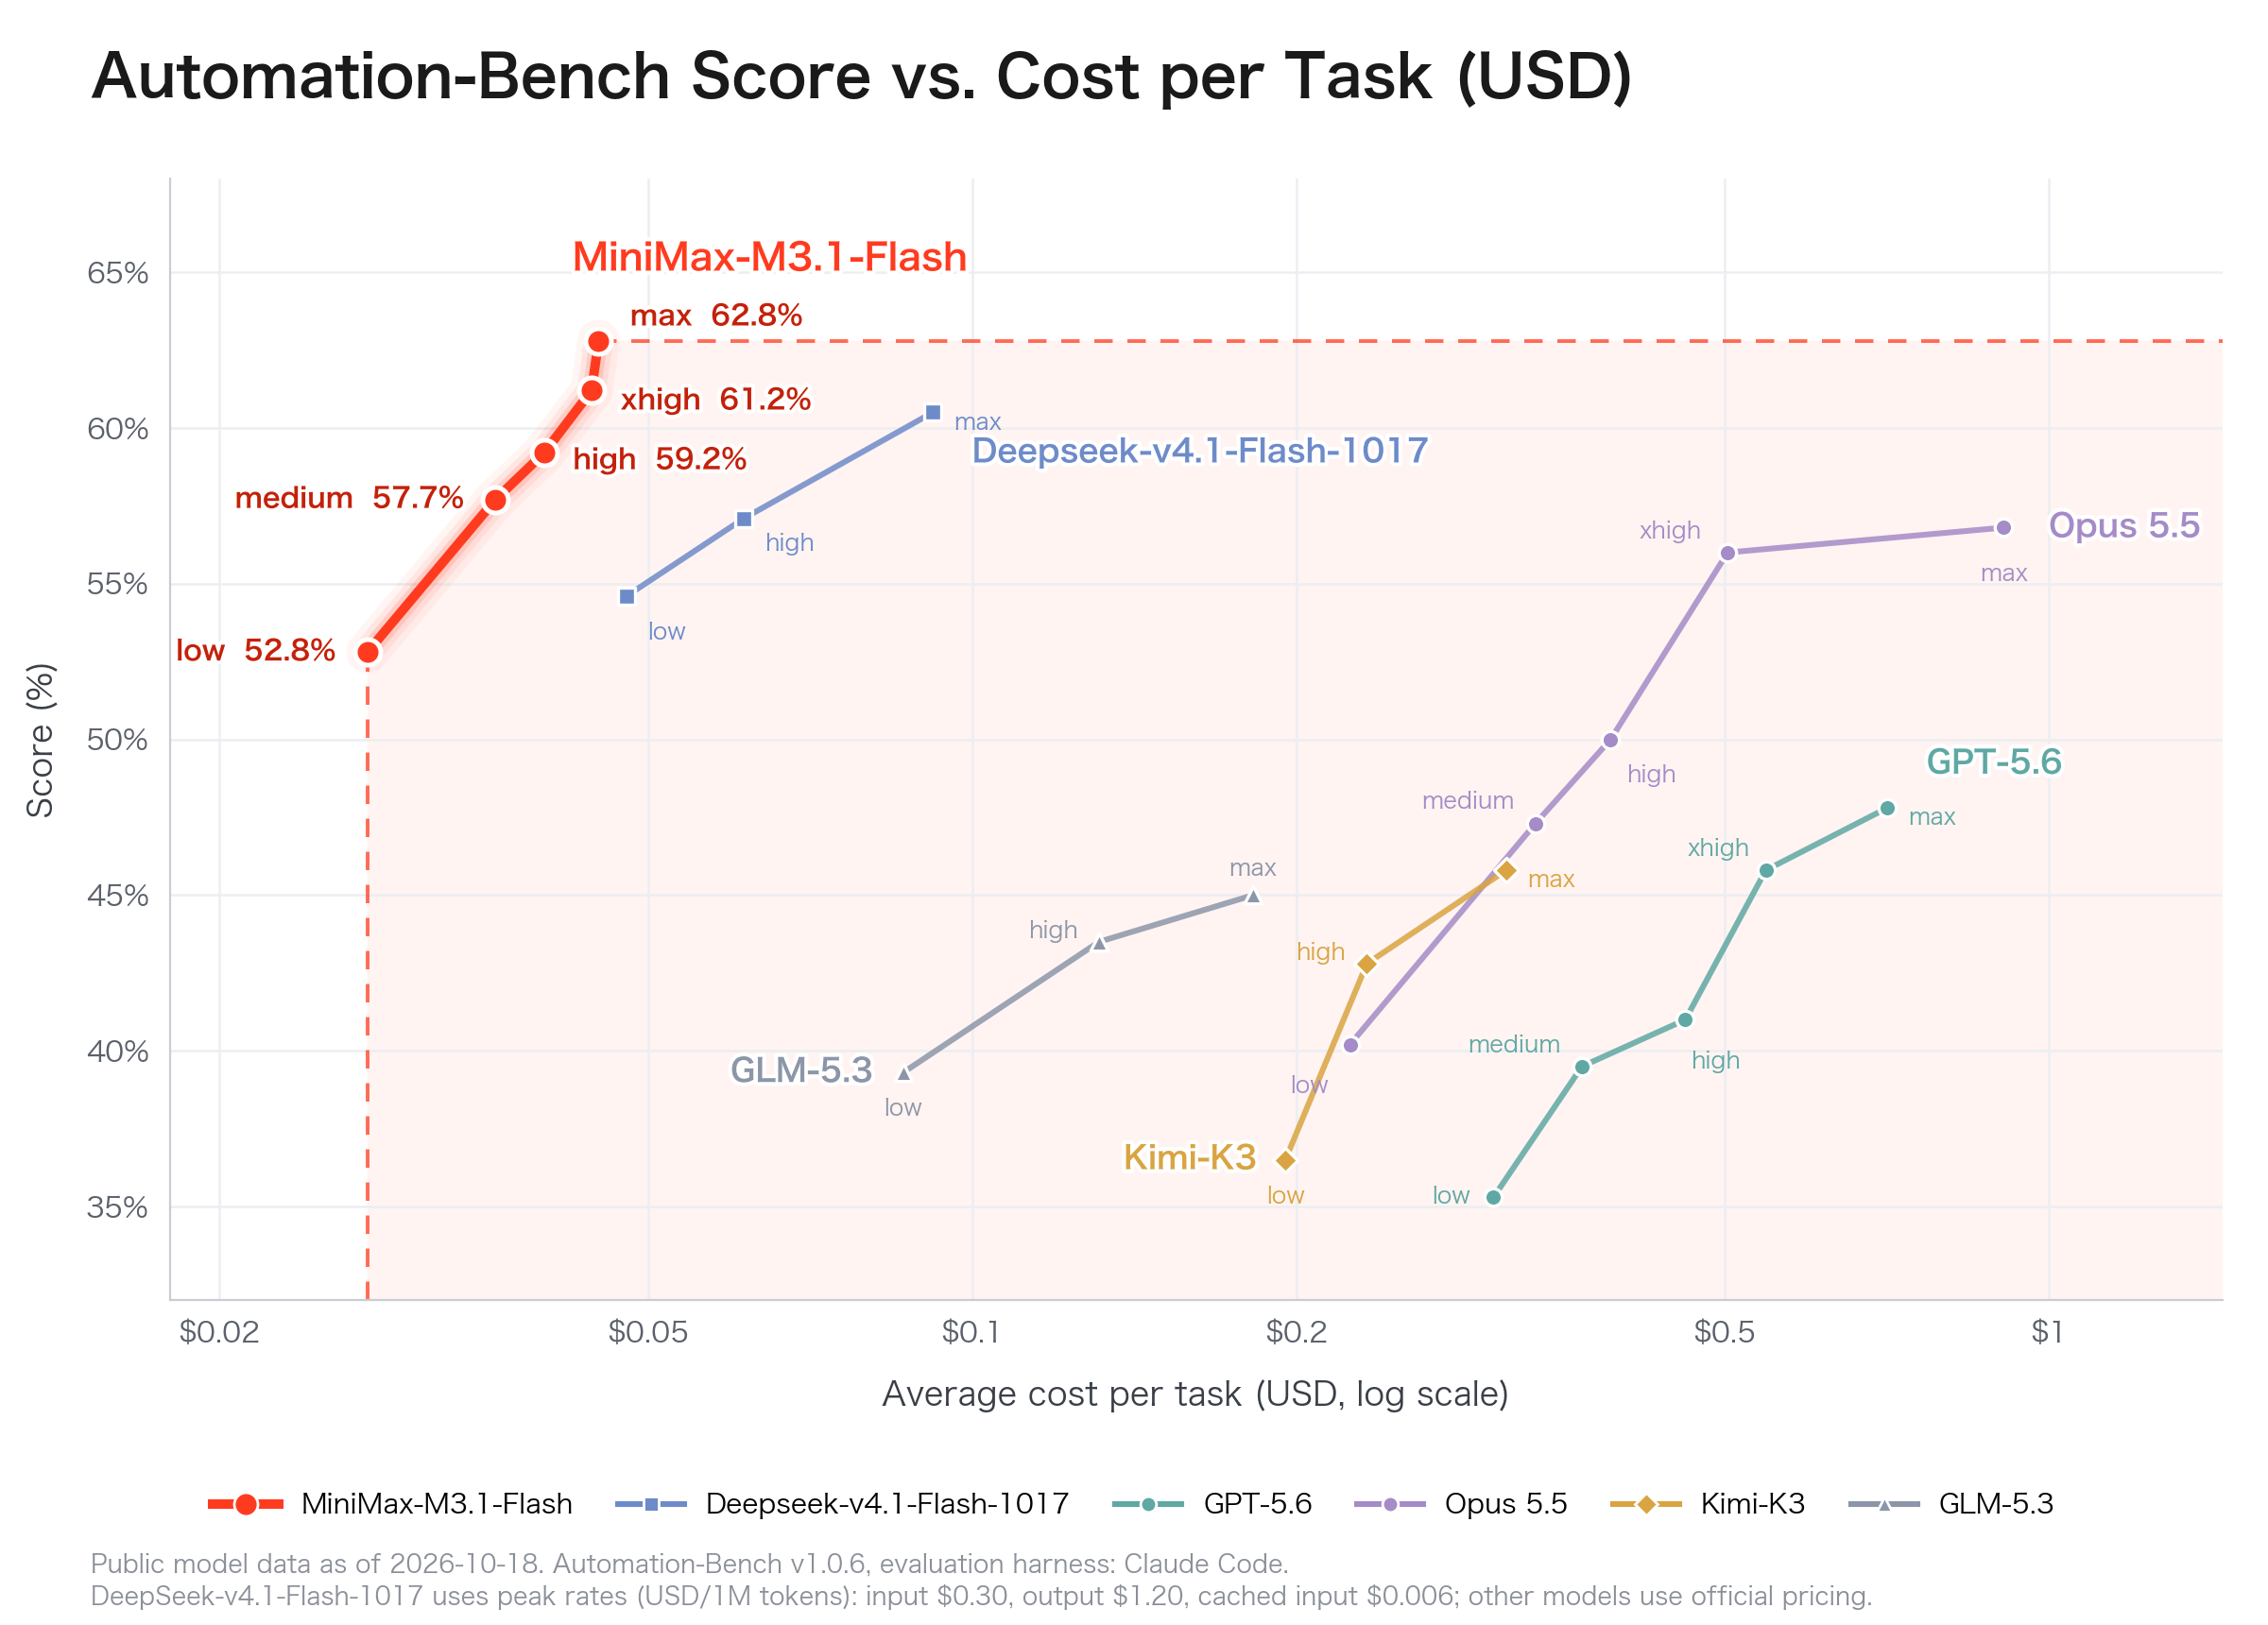
Courbe officielle de MiniMax score-versus-coût sur Automation-Bench. L’axe horizontal est logarithmique ; les coûts en dollars exacts ne sont pas imprimés pour les points MiniMax individuels.
Les notes d’évaluation du graphique officiel spécifient Automation-Bench v1.0.6 avec le harnais Claude Code et des données de modèles publiques au 18 octobre 2026. DeepSeek utilise des tarifs de tokens de pointe ; les autres modèles utilisent la tarification officielle. Les détails matériels et les intervalles de confiance sur répétitions ne sont pas précisés.
| Effort de raisonnement | Score Automation-Bench étiqueté |
|---|---|
| Low | 52.8% |
| Medium | 57.7% |
| High | 59.2% |
| Xhigh | 61.2% |
| Max | 62.8% |
Le tableau comparatif officiel actuel et le point à effort maximal indiquent tous deux 62.8. La courbe de coût compare les réglages d’effort au sein de la configuration du fournisseur ; elle n’établit pas un coût en dollars fixe pour un agent en production.
L’étiquette de score augmente de 10 points de pourcentage du mode low au mode max. Pour le déploiement, comparez medium et les efforts plus élevés sur un ensemble de tâches fixe, en comptant les tentatives échouées et les réessais dans la dépense totale. Choisissez le réglage qui atteint la cible de qualité au coût le plus bas par tâche acceptée.
How Can Developers Access MiniMax M3.1 Flash Through CometAPI?
Les développeurs peuvent accéder à l’API MiniMax M3.1 Flash sur CometAPI. Le catalogue public consulté le 20 octobre 2026 affiche l’ID de modèle minimax-m3.1-flash même si son URL conserve un suffixe preview. Utilisez l’ID de modèle disponible pour votre compte, plutôt que de dériver un identifiant d’API à partir de l’URL de la page.
Envoyez une requête POST à https://api.cometapi.com/v1/chat/completions avec Authorization: Bearer YOUR_COMETAPI_KEY et Content-Type: application/json. Dans le corps JSON, définissez model sur minimax-m3.1-flash (si activé pour votre compte) et fournissez un tableau messages. Consultez la documentation CometAPI pour les détails de la requête.
Pourquoi utiliser CometAPI ? Sa clé d’API unifiée, son format de requête compatible et son tableau de bord d’usage peuvent simplifier le travail avec plusieurs fournisseurs de modèles. Pour MiniMax M3.1 Flash, mettez en balance cette commodité d’intégration avec les prix spécifiques au fournisseur ci-dessus et vérifiez les fonctionnalités disponibles pour votre compte.
Which AI Agents Benefit Most From MiniMax M3.1 Flash?
| Cas d’usage | Pourquoi cela peut convenir | Considérations de déploiement |
|---|---|---|
| Automatisation entreprise | Solides résultats Automation-Bench | Valider les outils et les reprises |
| Assistants de codage | Performance compétitive sur DeepSWE | Exécuter des tests et revoir les correctifs |
| Support client | Bas prix en entrée et cache | Surveiller la précision |
| Agents de recherche | Fenêtre de contexte 1M | Vérifier les preuves et les sources |
| Agents d’utilisation de l’ordinateur | Capacité OSWorld | Gérer les changements d’UI et la récupération |
| Revue de code sécurité | Résultat CyberGym | Vérification indépendante |
Les avantages sont les plus forts lorsqu’un agent accomplit suffisamment de tâches correctement pour compenser les réessais, l’orchestration et les coûts de relecture. L’utilisation en production doit mesurer à la fois la performance au niveau du modèle et du workflow.
Is MiniMax M3.1 Flash the Best Value for AI Agents?
MiniMax M3.1 Flash est une option solide pour des agents sensibles aux coûts impliquant du contexte répété et des outils structurés, mais le prix de token le plus bas ne produit pas toujours le coût le plus bas par tâche réussie. Des appels échoués, des réessais supplémentaires et une intervention humaine peuvent effacer les économies. Évaluez le taux d’achèvement accepté, le temps de bout en bout, le coût total par tâche réussie et le taux d’intervention humaine.
FAQ
Why can MiniMax M3.1 Flash return an empty answer?
Sur l’API native de MiniMax compatible OpenAI, les tokens de réflexion consomment le budget de génération. Une limite trop faible peut terminer une requête avec finish_reason défini à length avant qu’un texte de réponse visible ne soit produit. Inspectez la raison de fin et l’utilisation des tokens, augmentez le budget de complétion lorsque cela est approprié, et traitez reasoning_content séparément de la réponse finale. Confirmez la même sémantique de réponse via une route tierce.
How should MiniMax M3.1 Flash tool-call history be stored?
Conservez le message complet de l’assistant, incluant les appels d’outils et le contenu de raisonnement, avant d’ajouter les résultats d’outil correspondants. Enregistrer uniquement la réponse visible peut supprimer des informations nécessaires à l’étape suivante. Maintenez les IDs d’appel d’outil et l’ordre des messages, et validez le comportement de relecture en utilisant l’endpoint réel du fournisseur. Les consignes d’historique de conversation de MiniMax décrivent les exigences de l’API native.
How can teams detect MiniMax M3.1 Flash routing changes?
Conservez une petite suite de régression avec des entrées fixes, une structure de sortie attendue et des assertions sur les appels d’outils. Enregistrez l’ID de modèle demandé, l’identifiant de modèle renvoyé le cas échéant, le fournisseur, l’horodatage et l’usage facturé. Relancez-la après les mises à jour du fournisseur ; un alias stable seul ne démontre pas que le checkpoint sous-jacent ou le comportement sont inchangés.
How should a MiniMax M3.1 Flash migration be staged?
Commencez par des tâches en lecture seule ou rejouées, puis dirigez une petite part du trafic en direct tout en conservant un fallback testé. Définissez des seuils de rollback pour les appels d’outils invalides, les délais d’expiration et les tâches infructueuses avant d’augmenter le trafic. Examinez des exemples de régressions plutôt que de se fier uniquement aux scores moyens, car un petit nombre d’échecs coûteux peut annuler des prix de tokens plus bas.
Conclusion
MiniMax M3.1 Flash améliore l’économie des agents IA autonomes grâce à des tokens peu coûteux, un raisonnement configurable, une grande fenêtre de contexte et de solides résultats déclarés en automatisation et en codage. Son avantage clé est l’équilibre entre performance, latence et coût par tâche — et non une supériorité absolue sur chaque benchmark.
Les développeurs doivent valider les taux de réussite réels des workflows et les coûts totaux des agents, puis choisir la route MiniMax M3.1 Flash dont la configuration active, les fonctionnalités prises en charge et la facturation correspondent à leurs exigences.