
TLDR MiniMax M4 n’a pas été lancé. MiniMax s’est publiquement engagé à une nouvelle génération de ses modèles M-series (et Hailuo vidéo) au second semestre 2026. L’actuel fleuron reste MiniMax M3 (lancé le 1er juin 2026 : ~428B au total / ~23B de paramètres actifs, contexte de 1M de tokens via MiniMax Sparse Attention, multimodal natif, poids ouverts, 59,0 % sur SWE-Bench Pro).
Une mise à jour d’efficacité en milieu de cycle, Minimax M3.1 Flash, a été lancée le 19 octobre 2026, offrant environ une inférence 3× plus rapide et ~70 % de réduction des coûts agentiques. Les développeurs peuvent déjà accéder à la gamme MiniMax en production (incluant M3 et M3.1 Flash) via des passerelles unifiées comme CometAPI pour un routage, une supervision et un contrôle des coûts simplifiés.
Points clés
- MiniMax M4 n’est pas publié au 20 octobre 2026. L’entreprise s’est seulement engagée à « une nouvelle génération de modèles M-series et Hailuo au second semestre 2026 ».
- Modèles en production actuels : MiniMax M3 (1er juin 2026) et le modèle axé efficacité M3.1 Flash (19 octobre 2026).
- M3 a introduit MSA (MiniMax Sparse Attention) permettant un contexte pratique de 1M de tokens, une compréhension native image/vidéo, de bons scores en codage/agents, et des poids ouverts.
- M3.1 Flash privilégie la vitesse et le coût (revendique ~3× d’accélération d’inférence et 70 % de baisse des coûts agentiques) tout en conservant le contexte 1M et des entrées multimodales ; des poids ouverts sont attendus peu après le lancement.
- Un rapport de juillet 2026 décrivait un effort interne d’environ 2,7 trillions de paramètres (nom interne M3 Pro) avec une possible publication en poids ouverts dès le T3 2026 ; cela ne s’est pas matérialisé publiquement et est distinct de l’engagement plus large de « nouvelle génération ».
- Améliorations attendues pour M4 (spéculatif, fondé sur la trajectoire) : gains supplémentaires en codage/agents, efficacité affinée sur long contexte, capacités multimodales ou d’utilisation de l’ordinateur renforcées, et tarification agressive maintenue.
- Recommandation d’accès : Utiliser une passerelle multi-fournisseurs telle que CometAPI pour router le trafic entre MiniMax M3/M3.1 Flash (et futur M4) et d’autres modèles de pointe avec facturation unifiée, observabilité et logique de repli.
MiniMax M4 arrive-t-il vraiment bientôt ?
Informations confirmées
La question principale n’est pas de savoir si MiniMax développe de futurs systèmes d’IA, mais s’il existe des preuves concrètes qu’un modèle nommé MiniMax M4 approche de sa sortie.
MiniMax a publié M3 en juin 2026 et a officiellement lancé M3.1 Flash le 19 octobre 2026. Il s’agit d’une sortie intermédiaire confirmée, pas d’une preuve d’un calendrier M4. Annonce de lancement officielle.
Les archives de recherche officielles incluent désormais M3.1 Flash. Aucune annonce de lancement M4 n’a été trouvée dans les sources officielles consultées au 20 octobre 2026.
| Catégorie de preuve | Constat | Évaluation |
|---|---|---|
| Annonce officielle de M4 | Non vérifiée | Non confirmé |
| Identifiant public du modèle M4 | Non vérifié | Non confirmé |
| Capture de benchmark M4 fuitée | Aucune preuve indépendante vérifiée trouvée | Non confirmé |
| Endpoint API M4 | Non vérifié | Non confirmé |
| Tarification M4 | Non publiée | Inconnu |
| Poids du modèle M4 | Non vérifiés | Inconnu |
| Lancement de MiniMax M3 | 1er juin 2026 | Confirmé |
| Sortie de M3.1 Flash | 19 octobre 2026 ; disponible via MiniMax API, M Plan et MiniMax Code | Confirmé |
Rapports de la communauté / fuites
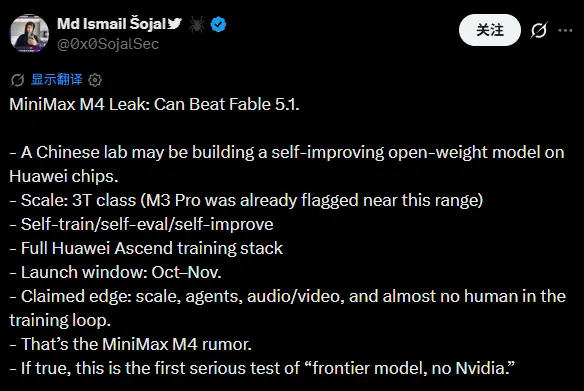
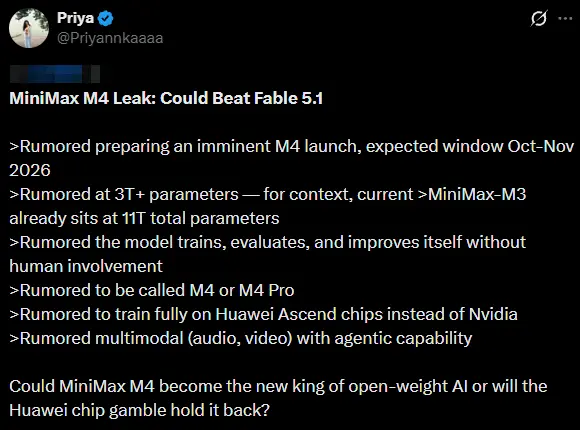
Deux posts X datés du 27 septembre 2026 évoquent une possible sortie de M4. Ils établissent que ces affirmations circulaient dans la communauté, non que MiniMax les ait confirmées. Les deux sont traités ici comme des rapports communautaires non vérifiés ; le badge de vérification payant des auteurs n’établit pas l’exactitude des affirmations.
Dans un post de @0x0SojalSec, l’auteur suggère un modèle d’environ trois trillions de paramètres, une publication en poids ouverts, et un entraînement sur du matériel Huawei Ascend. L’extrait lisible décrit aussi une boucle dans laquelle le modèle participe à son propre entraînement et évaluation. Ce sont des affirmations de l’auteur, pas des spécifications M4 vérifiées.
Un post de Priya (@Priyannkaaaa) suggère une possible sortie en octobre-novembre 2026 et un nombre de paramètres dépassant trois trillions. Il avance aussi une affirmation non vérifiée sur la taille du modèle M3 précédent. Cette comparaison n’est pas adoptée comme référence factuelle dans cet article.
À quelle date MiniMax M4 pourrait-il sortir ?
Les modèles antérieurs restent des points de référence utiles, y compris MiniMax M2.5 API dans CometAPI. Leurs dates établissent un historique, pas une prévision de la prochaine sortie.
MiniMax n’a pas confirmé de date de lancement pour M4. La fenêtre octobre-novembre 2026 mentionnée dans le post communautaire de Priya est une rumeur, pas un calendrier officiel ; l’extrait sous-jacent et ses limites sont discutés dans Rapports de la communauté / fuites. L’historique des sorties de la famille de modèles montre à la fois des générations majeures et des versions intermédiaires, mais les intervalles de lancements passés ne permettent pas de prédire de manière fiable la prochaine sortie.
| Jalon | Calendrier de sortie officiel | Signification |
|---|---|---|
| MiniMax M2.5 | 12 février 2026 | Codage et productivité |
| MiniMax M2.7 | 18 mars 2026 | Améliorations des workflows d’agents |
| MiniMax M3 | 1er juin 2026 | Contexte 1M et multimodalité |
| M3.1 Flash | 19 octobre 2026 — sortie officielle | Modèle axé sur l’efficacité pour le code et les agents |
| MiniMax M4 | Non annoncé | Aucun calendrier vérifié |
Une annonce produit officielle MiniMax serait le signal le plus fort. La documentation API ou un identifiant de modèle authentifié fourniraient un appui supplémentaire. Des résultats de benchmarks et des fiches de modèle publiques permettraient d’évaluer les améliorations techniques, tandis que la tarification officielle et les limites de débit détermineraient la viabilité en production.
Prix de MiniMax M4 — Ce que suggèrent les fuites et les générations précédentes
Aucune tarification officielle n’existe pour M4. Toutes les valeurs ci-dessous sont des extrapolations à partir des grilles tarifaires M3 et M3.1 Flash en production (USD, par million de tokens, approximatives à la mi-octobre 2026) :
| Modèle | Entrée / 1M | Sortie / 1M | Entrée mise en cache | Contexte | Notes |
|---|---|---|---|---|---|
| MiniMax M3 | $0.30 | $1.20 | ~$0.06 | 1M | « Permanent 50% off » sur la liste de prix ; palier supérieur pour >512k de contexte |
| MiniMax M3.1 Flash | $0.15 | $0.60 | $0.015 | 1M | ~50 % moins cher que M3 ; optimisé pour le débit agentique |
| Fourchette M4 attendue (spécul.) | $0.20–$0.40 | $0.80–$1.50 | Structure de remise similaire | 1M+ | Devrait rester parmi les offres en poids ouverts de pointe les moins chères |
Sources pour la tarification actuelle : documentation de la plateforme MiniMax, agrégateurs indépendants et annonces de lancement.
MiniMax a à plusieurs reprises positionné ses modèles à une fraction du coût des principaux modèles propriétaires occidentaux tout en les égalant ou les dépassant sur certains benchmarks de codage et d’agents. Un M4 complet devrait poursuivre cette stratégie, avec d’éventuels paliers premium pour un contexte étendu, une latence prioritaire ou un effort de raisonnement plus élevé.
Recommandation CometAPI : Plutôt que de gérer directement plusieurs clés API MiniMax et grilles tarifaires, routez via une passerelle unifiée comme CometAPI. Cela permet de passer sans couture entre M3, M3.1 Flash et, le moment venu, M4, avec des mécanismes de repli automatiques, de l’analytique d’usage, et souvent une meilleure tarification effective via l’agrégation de volume—particulièrement utile pour les charges agentiques qui consomment un grand nombre de tokens.
Ce que MiniMax M3.1 Flash révèle sur la prochaine génération
MiniMax M3.1 Flash fournit une référence plus actuelle pour évaluer ce qu’un futur modèle MiniMax M4 pourrait offrir. Officiellement présenté le 19 octobre 2026, M3.1 Flash se concentre sur les workflows agentiques, le développement logiciel, l’utilisation de l’ordinateur et la cybersécurité, tout en mettant l’accent sur une inférence plus rapide et des coûts d’usage plus faibles. Ces améliorations offrent des indices utiles sur les priorités d’ingénierie actuelles de MiniMax, bien qu’elles n’établissent ni date de sortie pour M4 ni ne confirment ses spécifications futures.
1. La fiabilité des agents devient aussi importante que l’intelligence brute
L’un des thèmes les plus clairs de l’annonce M3.1 Flash est l’accent mis sur l’achèvement de tâches complexes et multi-étapes. MiniMax rapporte des améliorations sur les workflows agentiques, le codage, l’utilisation de l’ordinateur et l’automatisation d’entreprise.
Cette orientation suggère que la prochaine génération de modèles pourrait être jugée moins sur des performances de question-réponse isolées que sur sa capacité à mener des workflows entiers de manière fiable.
Par exemple, un agent d’ingénierie logicielle peut avoir besoin d’inspecter un dépôt, d’identifier un défaut, de modifier plusieurs fichiers, d’exécuter des tests, de diagnostiquer des échecs et de vérifier le correctif final. La réussite dépend non seulement de la qualité du raisonnement, mais aussi du choix des outils, du suivi d’état, de la récupération d’erreur et de la cohérence sur plusieurs étapes.
Un éventuel modèle M4 pourrait prolonger cette direction en améliorant la planification à long horizon, en réduisant les appels d’outils inutiles et en se rétablissant plus efficacement après des actions échouées. Ce sont des cibles d’évaluation raisonnables, pas des fonctionnalités confirmées de M4.
2. L’efficacité d’inférence pourrait devenir un avantage concurrentiel majeur
MiniMax indique que M3.1 Flash offre près de trois fois la vitesse d’inférence en ligne de son prédécesseur et réduit de 70 % les coûts d’usage pour les tâches agentiques. L’entreprise attribue aussi ses gains d’efficacité à une sparsité plus agressive.
Ces affirmations soulignent une distinction importante entre l’intelligence du modèle et l’efficacité opérationnelle pratique. Un modèle qui termine une tâche avec moins de reprises, une latence plus faible et une consommation de tokens réduite peut être plus précieux qu’un modèle qui obtient un score de benchmark légèrement supérieur mais requiert sensiblement plus de ressources.
Pour une éventuelle sortie M4, les questions pertinentes incluront sa capacité à soutenir un haut débit sur des tâches longues, à préserver la qualité de sortie sous des budgets d’inférence plus serrés, et à réduire le coût total d’achèvement d’une tâche.
Les améliorations rapportées de M3.1 Flash sont des revendications de l’entreprise et doivent être évaluées indépendamment sur des charges de travail comparables avant d’être considérées comme des garanties de performance générale.
3. Le codage et l’utilisation de l’ordinateur sont des domaines à surveiller
L’annonce M3.1 Flash rapporte un score de 73,7 % sur DeepSWE v1.1, 61,7 sur OSWorld V2, et 82 % sur CyberGym. Ces résultats couvrent différents aspects de l’ingénierie logicielle, de l’interaction avec l’ordinateur et de la cybersécurité, respectivement.
Ensemble, ils fournissent un point de départ plus utile pour évaluer de futurs modèles qu’un unique benchmark généraliste.
Si MiniMax introduit M4, les développeurs devraient chercher des preuves qu’il améliore l’achèvement pratique des tâches plutôt que de produire seulement un score phare plus élevé. Des tests utiles pourraient inclure des corrections de bogues au niveau dépôt, des workflows inter-applications, l’automatisation du navigateur, l’analyse de vulnérabilités et la récupération après des appels d’outils échoués.
Les comparaisons de benchmarks doivent préserver la version du jeu de données, l’environnement d’exécution, l’échafaudage d’agent, les limites de ressources et la méthodologie de scoring. Sans conditions comparables, les différences de scores entre modèles peuvent ne pas refléter de véritables gains de capacité.
4. Le long contexte et le raisonnement multimodal nécessitent encore une évaluation pratique
MiniMax M3 prend déjà en charge une fenêtre de contexte allant jusqu’à un million de tokens et des entrées multimodales natives, incluant images et vidéo. La version M3.1 Flash conserve une fenêtre de contexte d’un million de tokens et combine compréhension multimodale avec des capacités davantage orientées agents.
Cela signifie qu’une fenêtre de contexte plus grande seule ne constituerait pas forcément une raison convaincante pour passer à M4.
Des avancées plus significatives pourraient inclure une meilleure récupération depuis de grands dépôts, une cohérence renforcée sur de longs documents, une interprétation visuelle plus précise, et une coordination plus fiable entre perception et exécution d’outils.
Par exemple, un agent de développement pourrait avoir besoin d’inspecter un enregistrement d’écran, d’identifier une défaillance d’interface utilisateur, de localiser le code applicatif pertinent, d’implémenter un correctif et d’en vérifier le résultat. La qualité du workflow complet compte davantage que la capacité du modèle à traiter un grand input isolé.
Ces scénarios représentent des priorités d’évaluation possibles pour M4, pas des capacités annoncées par MiniMax.
5. Les futures sorties de modèles pourraient être évaluées au coût par tâche accomplie
L’annonce M3.1 Flash renforce l’importance d’évaluer l’économie des modèles au niveau du flux de travail. Les prix au token ne capturent pas le coût total d’utilisation d’un agent.
Une comparaison plus utile considère la probabilité de mener une tâche à bien, le nombre d’essais requis, la consommation de tokens, les coûts d’outils, la latence et l’intervention humaine.
Les développeurs qui se préparent à une future sortie M4 devraient établir une base avec les modèles disponibles et utiliser le même ensemble de tâches pour comparer les sorties suivantes. Cela permet de déterminer si un nouveau modèle apporte des améliorations significatives de productivité plutôt que de simplement modifier les classements de benchmarks.
Quelle est la solidité des benchmarks de MiniMax M3, et que M4 devrait-il dépasser ?
MiniMax a publié un ensemble substantiel de résultats de benchmarks pour M3, fournissant des cibles mesurables pour un futur modèle. Les valeurs suivantes sont des résultats M3 rapportés, pas des prédictions M4.
| Benchmark | Score MiniMax M3 rapporté | Ce que cela évalue | Cible de vérification pour M4 |
|---|---|---|---|
| SWE-Bench Pro | 59,0 % | Ingénierie logicielle réelle | Résolution de tâches vérifiée plus élevée |
| Terminal-Bench 2.1 | 66,0 % | Exécution d’agent en terminal | Plus d’opérations de bout en bout réussies |
| SWE-fficiency | 34,8 % | Efficacité sur les tâches de code | Meilleure perf. à budget comparable |
| KernelBench Hard | 28,8 % | Optimisation de kernels GPU | Kernels plus corrects et plus rapides |
| MCP Atlas | 74,2 % | Tâches orientées outils et MCP | Meilleure sélection et exécution d’outils |
Ce sont des résultats rapportés par le fournisseur lors de l’annonce du 1er juin 2026, non des reproductions indépendantes. Les suites mesurent des résultats différents, leurs pourcentages ne doivent donc pas être moyennés en un score d’exactitude unique.
Performances en codage et ingénierie logicielle
Ce que nous avons confirmé (M3)
- SWE-Bench Pro : 59,0 %
- Terminal-Bench 2.1 : 66,0 %
- Résultats solides sur des tâches réelles de correction de bogues, développement frontend/backend et optimisation de kernels (évaluations internes MiniMax montrant des itérations autonomes de plusieurs heures).
Ce que M3.1 Flash ajoute : Des gains supplémentaires revendiqués sur des benchmarks de codage, d’agents et de cybersécurité, ainsi qu’un débit de tokens sensiblement plus élevé et un coût par trajectoire d’agent complétée nettement inférieur.
Ce qui reste non confirmé / attendu pour M4 : Des scores absolus plus élevés sur des benchmarks de type SWE-Bench et de codage interactif multi-tours, une meilleure gestion de projets à long horizon, et une capacité améliorée à maintenir la cohérence sur des sessions multi-fichiers et multi-jours. Tout modèle à l’échelle 2,7T (s’il est publié) devrait encore élever le plafond de capacité, bien que le nombre de paramètres actifs et la sparsité déterminent le coût réel.
Efficacité long contexte et architecture
Confirmé : M3 a introduit MSA (MiniMax Sparse Attention), offrant un contexte pratique de 1M de tokens avec un coût par token revendiqué de 1/20e par rapport à la génération précédente à attention dense, des accélérations de >9× au préremplissage et >15× au décodage à des longueurs extrêmes, tout en égalant l’attention complète sur la plupart des capacités.
Améliorations attendues : Affinage des schémas de sparsité, meilleur support pour des contextes encore plus longs ou une récupération plus dense dans la fenêtre, empreinte mémoire réduite pour l’auto-hébergement, et gestion améliorée de documents longs multimodaux entrelacés.
Capacités multimodales et d’utilisation de l’ordinateur
Confirmé : Compréhension native des images et des vidéos dès les premières étapes d’entraînement, plus une utilisation démontrée de l’ordinateur (opération de bureau) dans MiniMax Code et des harnais d’agent.
Attendu pour M4 : Intégration plus étroite de la compréhension vidéo avec la planification d’agent, pipelines document/capture d’écran vers code plus robustes, et contrôle multi-application de l’ordinateur plus fiable sur de plus longs horizons.
Workflows agentiques, utilisation d’outils et auto-amélioration
Confirmé : M2.7 a déjà expérimenté des boucles d’auto-amélioration récursives. M3 et M3.1 Flash mettent l’accent sur la collaboration multi-agents, la recherche dynamique d’outils, les tâches autonomes de longue durée et les boucles producteur-vérificateur dans MiniMax Code.
Attendu : Équipes d’agents multi-jours plus robustes, meilleure récupération après des échecs d’outils, support natif pour des écosystèmes d’outils plus vastes, et potentiellement une poursuite des techniques d’auto-amélioration ou de recherche évolutionnaire à plus grande échelle.
Prix de MiniMax M4 — Ce que suggèrent les fuites et les générations précédentes
Aucune tarification officielle n’existe pour M4. Toutes les valeurs ci-dessous sont des extrapolations à partir des grilles tarifaires M3 et M3.1 Flash en production (USD, par million de tokens, approximatives à la mi-octobre 2026) :
| Modèle | Entrée / 1M | Sortie / 1M | Entrée mise en cache | Contexte | Notes |
|---|---|---|---|---|---|
| MiniMax M3 | $0.30 | $1.20 | ~$0.06 | 1M | « Permanent 50% off » sur la liste de prix ; palier supérieur pour >512k de contexte |
| MiniMax M3.1 Flash | $0.15 | $0.60 | $0.015 | 1M | ~50 % moins cher que M3 ; optimisé pour le débit agentique |
| Fourchette M4 attendue (spécul.) | $0.20–$0.40 | $0.80–$1.50 | Structure de remise similaire | 1M+ | Devrait rester parmi les offres en poids ouverts de pointe les moins chères |
MiniMax a à plusieurs reprises positionné ses modèles à une fraction du coût des principaux modèles propriétaires occidentaux tout en les égalant ou les dépassant sur certains benchmarks de codage et d’agents. Un M4 complet devrait poursuivre cette stratégie, avec d’éventuels paliers premium pour un contexte étendu, une latence prioritaire ou un effort de raisonnement plus élevé.
Recommandation CometAPI : Plutôt que de gérer directement plusieurs clés API MiniMax et grilles tarifaires, routez via une passerelle unifiée comme CometAPI. Cela permet de passer sans couture entre M3, M3.1 Flash et, le moment venu, M4, avec des mécanismes de repli automatiques, de l’analytique d’usage, et souvent une meilleure tarification effective via l’agrégation de volume—particulièrement utile pour les charges agentiques qui consomment un grand nombre de tokens.
MiniMax M3 vs M3.1 Flash vs direction attendue pour M4
| Dimension | M3 API dans CometAPI (juin 2026) | MiniMax M3.1 Flash (oct. 2026) | Direction attendue pour M4 (S2 2026+) |
|---|---|---|---|
| Statut | En production, poids ouverts | En production, poids imminents | Non publié |
| Paramètres (approx.) | 428B au total / ~23B actifs | Échelle similaire | Inconnu (MoE possiblement plus grand) |
| Contexte | 1M tokens (MSA) | 1M tokens | 1M+ avec efficacité accrue |
| Codage (SWE-Bench Pro) | 59,0 % | Gains supplémentaires revendiqués | Scores absolus plus élevés attendus |
| Vitesse d’inférence | Base solide | ~3× plus rapide revendiqué | Optimisation supplémentaire |
| Coût agentique | Compétitif | ~70 % plus bas revendiqué | Tarification agressive maintenue |
| Multimodal | Image + vidéo natifs | Idem + affiné | Intégration plus profonde |
| Poids ouverts | Oui | Prévu prochainement | Très probable |
| Prix API (entrée/sortie) | $0.30 / $1.20 | $0.15 / $0.60 | Fourchette attendue $0.20–0.40 / $0.80–1.50 |
Sélection de modèle selon le workflow développeur
Utilisez le M3.1 Flash publié comme candidat d’évaluation actuel et conservez M3 et tout workflow M2.7 établi pour comparaison. Mesurez l’achèvement des tâches acceptées, les reprises, les interventions humaines et le coût total sur la même charge. Ajustez l’effort de manière délibérée plutôt que de supposer que le « maximum de réflexion » est toujours le meilleur point de fonctionnement.
M4 n’est pas encore un choix de production exploitable. La préparation la plus utile est de construire une suite de benchmarks reproductible sur les modèles existants afin qu’une future sortie puisse être évaluée rapidement.
Comment accéder aux modèles MiniMax actuels (et se préparer à M4)
En attendant M4, la voie pratique est d’utiliser les modèles en production :
- Obtenez une clé API MiniMax depuis la plateforme officielle.
- Ou, pour la fiabilité en production, passez par une passerelle multi-modèles telle que CometAPI. CometAPI fournit un endpoint et une clé uniques pouvant cibler MiniMax M3, M3.1 Flash et d’autres fournisseurs, avec tableaux de bord d’usage intégrés, gestion des limites de débit, et la possibilité de changer de modèle sans modifications de code.
- Pour les agents de codage, associez le modèle à MiniMax Code (desktop/CLI) ou à des frameworks ouverts qui supportent déjà des endpoints MiniMax compatibles Anthropic ou OpenAI.
- Surveillez les canaux officiels de MiniMax et les catalogues d’agrégateurs ; dès qu’un nouvel identifiant de modèle M-series apparaît, des passerelles comme CometAPI le mettent généralement en avant rapidement.
Cette approche minimise l’enfermement tout en permettant d’évaluer M3 vs M3.1 Flash (et à terme M4) sur des charges réelles avec une observabilité cohérente.
Conclusion
MiniMax M4 reste un modèle futur défini par un engagement d’entreprise clair mais de haut niveau plutôt que par des spécifications concrètes. La génération M3 a déjà établi MiniMax comme un concurrent sérieux en poids ouverts pour le codage, les agents et le travail multimodal à long contexte ; M3.1 Flash a ensuite repoussé la frontière de l’efficacité. Quelle que soit la forme que prendra la « nouvelle génération » du S2 2026—qu’elle s’appelle M3.5, M4, ou autrement—elle héritera d’une base solide d’attention clairsemée, de poids ouverts et de tarification agressive.
Pour les développeurs et équipes qui construisent des agents de production aujourd’hui, la recommandation actionnable est simple : intégrez les modèles MiniMax en production (M3 et M3.1 Flash) via une couche flexible multi-fournisseurs telle que CometAPI. Cela offre des avantages immédiats en capacités et en coûts tout en vous positionnant pour adopter M4 dès son apparition sur des endpoints publics—avec un minimum de changements de code et une visibilité complète sur les performances et les dépenses.