Spécifications techniques de MiniMax M3.1-Flash-Preview
| Élément | MiniMax M3.1-Flash-Preview |
|---|---|
| ID du modèle | MiniMax-M3.1-Flash-Preview |
| Famille de modèles | Série MiniMax M3.1, modèle de codage Preview |
| Statut de publication | Preview ; annoncé le 27 septembre 2026 |
| Objectif principal | Développement logiciel au quotidien, des corrections de bogues à la livraison de fonctionnalités complètes |
| Fenêtre de contexte | 1,000,000 tokens |
| Modalités d’entrée | Texte, image et vidéo |
| Modalité de sortie | Texte |
| Contrôle du raisonnement | reasoning_effort: low, medium, high, xhigh, max |
| Comportement de réflexion | Un raisonnement adaptatif est requis ; la documentation publique consultée n’indique pas la possibilité de désactiver la réflexion |
| Sortie maximale | Non publié séparément dans la documentation publique consultée |
| Nombre de paramètres | Non divulgué publiquement |
| Poids ouverts | Aucun point de contrôle/dépôt de modèle public identifié |
MiniMax a annoncé M3.1-Flash-Preview pour MiniMax Code le 27 septembre 2026, en le positionnant autour des tâches de développement quotidiennes telles que la correction de bogues et la livraison de fonctionnalités complètes. La couverture publique actuelle identifie de manière cohérente une fenêtre de contexte de 1 M de tokens et un effort de raisonnement ajustable, tout en notant qu’un tableau de référence autonome et un prix par token n’ont pas été publiés.
Qu’est-ce que MiniMax M3.1-Flash ?
MiniMax M3.1-Flash-Preview est un modèle de texte orienté codage en Preview, conçu pour des workflows de développement logiciel itératifs plutôt que la seule génération de code. MiniMax décrit le workflow comme couvrant la compréhension des exigences, la localisation des problèmes, l’implémentation, les tests de régression et la vérification des changements par rapport aux fonctionnalités existantes.
Ses contrôles distinctifs documentés sont son long contexte et une échelle d’effort de raisonnement à cinq niveaux. Les niveaux disponibles sont low, medium, high, xhigh et max, permettant aux développeurs d’équilibrer profondeur de raisonnement et latence selon la complexité de la tâche.
Principales fonctionnalités de MiniMax M3.1-Flash-Preview
- Contexte de 1 M de tokens : La description publiée du modèle attribue au modèle Preview une fenêtre de contexte d’un million de tokens, le rendant adapté aux grands dépôts, aux spécifications longues et aux sessions prolongées d’agents de codage.
- Entrée multimodale native : Les descriptions publiques du modèle listent le texte, l’image et la vidéo comme entrées, tandis que le modèle renvoie du texte.
- Cinq niveaux d’effort de raisonnement :
low,medium,high,xhighetmaxoffrent un contrôle plus fin de la profondeur de raisonnement qu’un simple interrupteur de réflexion on/off. - Workflow de codage de bout en bout : MiniMax positionne spécifiquement le modèle pour la localisation de bogues, l’implémentation, la gestion des cas limites, l’achèvement des tests de régression et la validation des changements.
- Déploiement orienté Preview : Le lancement public initial se fait via MiniMax Code et Token Plan plutôt que via une offre autonome entièrement documentée en pay-as-you-go.
- Adapté aux agents de codage : Le modèle est destiné à des interactions de développement répétées où le contexte du dépôt, la sortie des outils, les tests et les corrections itératives comptent davantage que la génération de code en one-shot.
MiniMax M3.1-Flash-Preview vs autres modèles de codage MiniMax
| Modèle | Orientation | Contexte | Données de benchmark publiques | Accès/statut |
|---|---|---|---|---|
| M3.1-Flash-Preview | Codage quotidien, développement itératif | 1M | Pas encore publiées | Preview ; MiniMax Code / Token Plan |
| M3 | Codage de pointe + travail agentique, multimodalité native | Jusqu’à 1M | Publiées par MiniMax | API, Token Plan, MiniMax Code |
| M2.7 | Ingénierie logicielle + large travail agent/productivité | Non utilisé ici comme une spécification M3.1 copiée | Publiées par MiniMax | API, Token Plan, Agent |
M3 est le point de référence le plus documenté : MiniMax publie son architecture, sa méthodologie d’évaluation en codage/agent et la disponibilité de l’API. M2.7 dispose également d’un bilan de benchmarks publics et d’une intégration API. M3.1-Flash-Preview est plus récent et présente actuellement une empreinte de documentation publique plus restreinte ; les comparaisons doivent donc se concentrer sur le positionnement documenté plutôt que sur la prétention à une victoire de benchmark. 4
Cas d’utilisation représentatifs
- Correction de bogues à l’échelle du dépôt : Fournissez au modèle une grande base de code, une description du problème, des journaux et des tests, et utilisez son long contexte pour préserver le contexte pertinent du projet.
- Implémentation de fonctionnalités : Utilisez le modèle pour passer d’une exigence en langage naturel aux changements de code et aux tests de régression.
- Revue de code et remédiation : Demandez-lui d’identifier les cas limites, de proposer des correctifs et de vérifier que les changements ne perturbent pas le comportement existant.
- Débogage multimodal : Fournissez des captures d’écran, des diagrammes ou des vidéos avec les exigences textuelles lorsque le contexte visuel fait partie du problème d’ingénierie.
- Sessions longues d’agents de codage : Exploitez la grande fenêtre de contexte pour les spécifications, les fichiers du dépôt, la sortie du terminal et les résultats de test itératifs.
- Développement sensible à la vitesse : Sélectionnez un niveau d’effort de raisonnement plus faible pour les modifications de routine et augmentez l’effort pour des changements multi-étapes plus complexes.
Comment accéder à l’API MiniMax M3.1-Flash-Preview
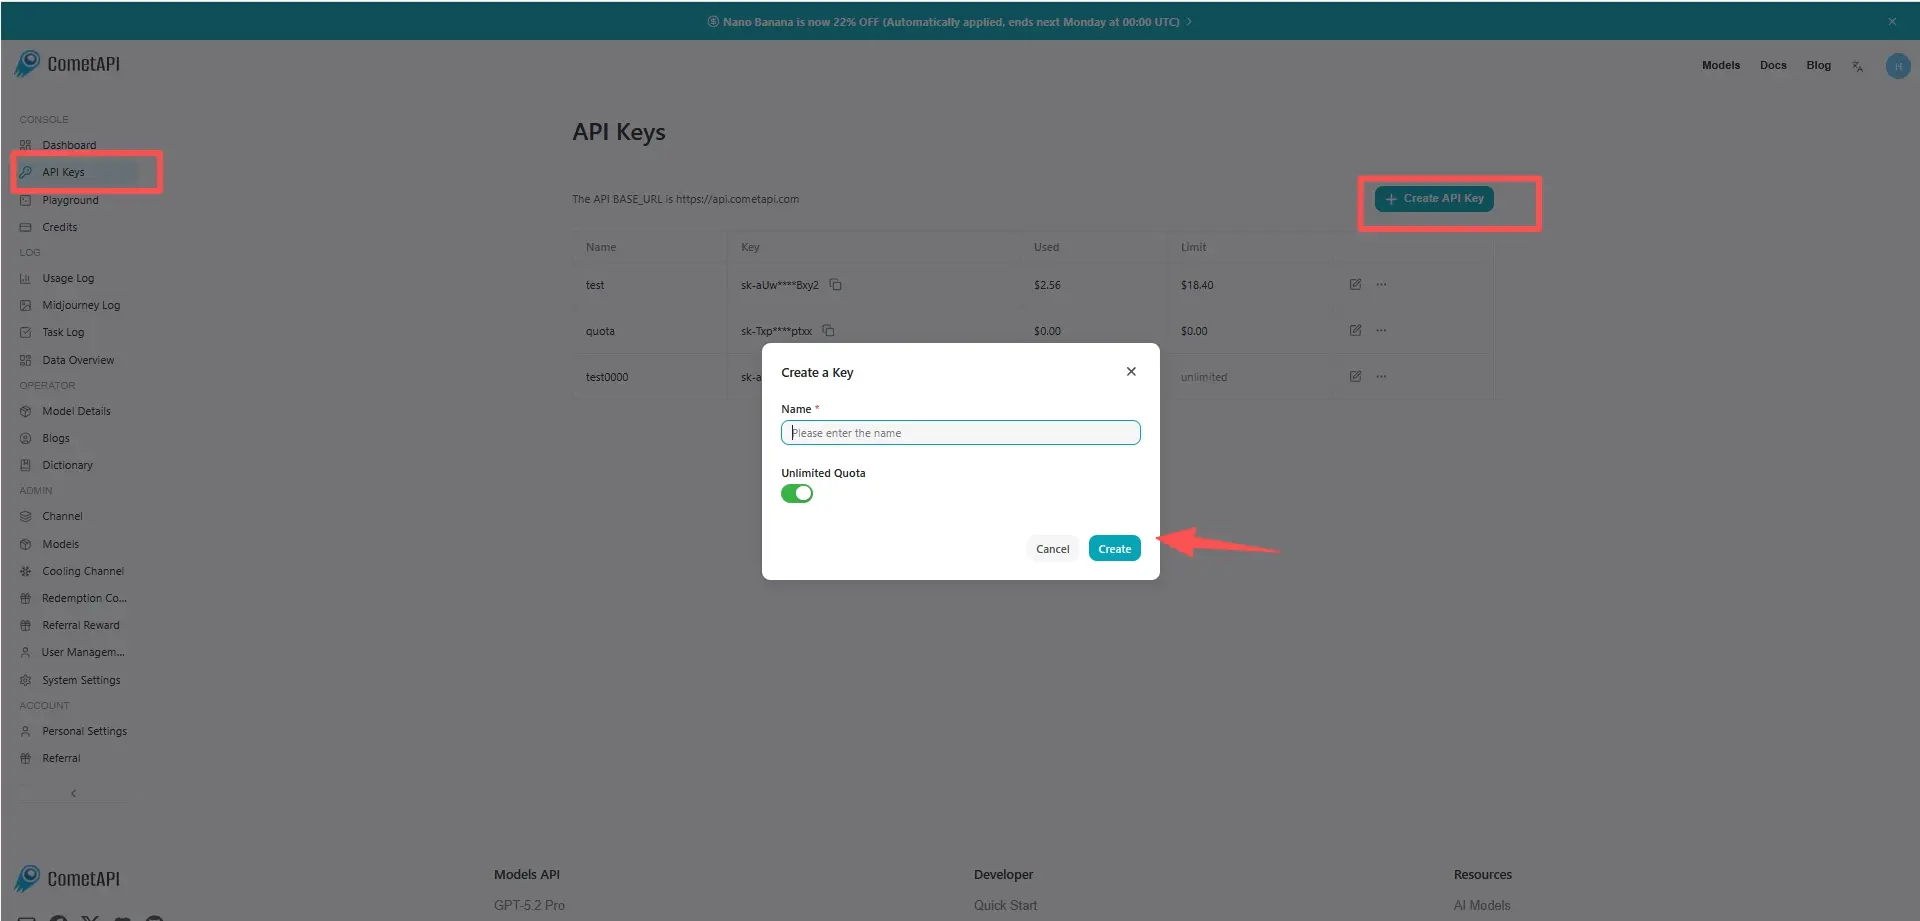
Étape 1 : S’inscrire pour obtenir une clé API
Connectez-vous à cometapi.com. Si vous n’êtes pas encore utilisateur, veuillez d’abord vous inscrire. Connectez-vous à votre console CometAPI. Obtenez la clé API d’identification d’accès de l’interface. Cliquez sur “Add Token” dans la section API token du centre personnel, récupérez la clé de token : sk-xxxxx et soumettez.
Étape 2 : Envoyer des requêtes à l’API MiniMax M3.1-Flash-Preview
Sélectionnez l’endpoint “minimax-m3.1-flash-preview” pour envoyer la requête API et définissez le corps de la requête. La méthode et le corps de la requête sont obtenus depuis la documentation API de notre site Web. Notre site Web propose également des tests Apifox pour votre commodité. Remplacez <YOUR_API_KEY> par votre clé CometAPI réelle depuis votre compte. L’URL de base est Chat Completions.
Insérez votre question ou demande dans le champ content — c’est à cela que le modèle répondra. Traitez la réponse de l’API pour obtenir la réponse générée.
Étape 3 : Récupérer et vérifier les résultats
Traitez la réponse de l’API pour obtenir la réponse générée. Après traitement, l’API renvoie le statut de la tâche et les données de sortie.