

TL;DR
Muse Wonder, Claude Opus 5.5 et GPT-6 Sol sont des modèles hautes capacités, positionnés pour la programmation et les workflows à base d’agents. Le nouveau Muse Wonder de Meta met l’accent sur la mémoire persistante et l’exécution soutenue ; Opus 5.5 arrive en tête de l’indice d’intelligence agrégé cité ; GPT-6 Sol propose les tarifs d’entrée et de sortie standard les plus bas pour le contexte court dans cette comparaison, tandis que son palier long contexte est tarifé séparément. Choisissez en fonction de la qualité des tâches représentatives, de la fiabilité et du coût total, plutôt que d’un score unique de classement.
Points clés
- Intelligence globale : Claude Opus 5.5 obtient 58 contre 52 pour Muse Wonder sur l’Intelligence Index v4.3 rapporté.
- Programmation long terme : Muse Wonder affiche 78.8 sur DeepSWE 1.1 et 53.1 sur SWE-Marathon ; Opus 5.5 enregistre 74.2 et 46.3 dans le tableau de Meta.
- Raisonnement à bas coût : GPT-6 Sol démarre à 2 $ en entrée / 10 $ en sortie par million de jetons via l’API standard à contexte court d’OpenAI.
- Agents centrés sur la mémoire : Muse Wonder introduit Active Memory et Active Focus.
- La disponibilité compte : Muse Wonder Full est un produit séparé et plus restreint que le Muse Wonder standard accessible aux développeurs.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol en un coup d’œil
Choisissez Muse Wonder pour des agents persistants et des travaux d’ingénierie de longue durée, Claude Opus 5.5 pour une programmation large et des workflows fortement orientés terminal, et GPT-6 Sol pour des coûts de jetons standard plus bas en contexte court.
| Facteur de décision | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Démarrer les tests avec | Agents persistants et ingénierie prolongée | Programmation orientée terminal et workflows pro | Programmation et automatisation sensibles au budget |
| Fenêtre de contexte | 1,048,576 jetons | 1M jetons | 1,050,000 jetons |
| Point fort publié | DeepSWE 78.8 ; SWE-Marathon 53.1 | Intelligence Index 58 ; ProgramBench 70.5 | Entrée/sortie standard 2 $/10 $ par 1M jetons |
| Entrée / sortie standard par 1M jetons | 4 $ / 20 $ | 4 $ / 20 $ | 2 $ / 10 $ ; palier contexte court |
| Accès fournisseur | Meta Model API ; Full est un produit par abonnement séparé | Anthropic API | OpenAI API |
| Métrique de sélection | Qualité des tâches acceptées et coût total | Qualité des tâches acceptées et coût total | Qualité des tâches acceptées et coût total |
| Éditeur | Meta | Anthropic | OpenAI |
| Date de sortie | 12 octobre 2026 | 22 septembre 2026 | 16 septembre 2026 |
| Modalités d’entrée | Texte, image, audio, vidéo ; entrées PDF documentées | Texte, image | Texte, image |
| Sortie | Texte | Texte | Texte |
| Capacité distinctive | Active Memory et Active Focus | Workflows d’outillage et de sous-agents | Effort de raisonnement configurable et outils d’API |
Cette synthèse résume les spécifications datées et les résultats publiés examinés ci-dessous. Les lignes de benchmark utilisent des méthodes d’évaluation différentes, et des tarifs de jetons bas n’impliquent pas un coût inférieur par tâche réussie. Muse Wonder standard et Muse Wonder Full sont deux options d’accès distinctes.
Les spécifications ont été vérifiées le 13 octobre 2026. Les modalités et fonctionnalités prises en charge dépendent de l’endpoint et de la surface de publication sélectionnés, y compris la disponibilité audio. Les capacités au niveau du modèle ne garantissent pas la prise en charge sur chaque route d’accès.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol : aperçu et spécifications
Muse Wonder : workflows d’agents persistants
Meta a présenté Muse Wonder et Muse Wonder Full le 12 octobre 2026. Muse Wonder standard met l’accent sur les tâches professionnelles de longue durée, la mémoire persistante des agents et la reprise après obstacles. Active Memory vise à retrouver un contexte utile antérieur, tandis qu’Active Focus est conçu pour maintenir la progression sur des travaux multi-étapes. Meta cite la programmation, la recherche, l’analyse financière et l’assistance personnelle comme scénarios clés.
Claude Opus 5.5 : programmation professionnelle et utilisation d’outils
Claude Opus 5.5 cible la programmation, le raisonnement et des workflows professionnels multi-outils. Anthropic l’a publié le 22 septembre 2026. Sa fenêtre de contexte est d’un million de jetons, tandis que les résultats de programmation rapportés ci-dessous montrent des forces variables selon les benchmarks.
GPT-6 Sol : raisonnement économique
GPT-6 Sol vise à combiner un raisonnement solide et l’usage d’outils avec une inférence relativement abordable. Il prend en charge des workflows programmatiques via l’écosystème API d’OpenAI. Ses tarifs standard en contexte court sont plus bas que ceux listés pour Claude Opus 5.5, bien que l’économie de bout en bout dépende aussi des réessais et de l’usage de jetons de raisonnement.
OpenAI décrit GPT-6 Sol comme un modèle pour la programmation complexe et les workflows à base d’agents ; son annonce de sortie fournit les résultats d’évaluation utilisés ci-dessous. Cet article compare les versions de modèle spécifiées, pas tous les modèles plus récents de chaque éditeur.
Architecture et contrôles de raisonnement
Les sources citées ici ne fournissent pas, pour les trois modèles, une ventilation comparable du nombre de paramètres et de l’architecture. Aucun classement dense vs mixture-of-experts n’est donc justifié. Active Memory et Active Focus décrivent des capacités d’agent chez Meta ; ce ne sont pas des substituts à une architecture neuronale divulguée. GPT-6 Sol expose un effort de raisonnement configurable, tandis que les scores rapportés de Meta et Claude dépendent aussi de l’effort et du protocole d’évaluation. Considérez ces réglages comme faisant partie de la configuration comparée, et non comme des mesures de calcul interchangeables.
Résultat de la comparaison : Les trois offrent de larges fenêtres de contexte et des API pour développeurs. Muse Wonder documente des modalités d’entrée plus larges au niveau du modèle ; Opus 5.5 et GPT-6 Sol mettent l’accent sur des workflows texte et image. La capacité de contexte et la disponibilité des fonctionnalités doivent encore être vérifiées sur l’endpoint sélectionné.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol : performances
Résultats publiés et limites des sources
La fiche modèle officielle de Meta propose des comparaisons directes Muse Wonder vs Claude Opus 5.5. OpenAI publie séparément les résultats de GPT-6 Sol, si bien qu’on ne peut pas placer les trois modèles sur un classement entièrement contrôlé sans harmoniser harnais d’évaluation, versions et réglages.
| Benchmark | Muse Wonder | Claude Opus 5.5 | Score le plus élevé |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.3 | 52 | 58 | Opus |
| Personal Superintelligence Index | 54.3 | 55.2 | Opus |
| Harvey LAB-AA | 10.0 | 4.2 | Muse |
| Vals Finance Agent V2 | 56.6 | 58.6 | Opus |
| AutomationBench-AA | 39.1 | 41.2 | Opus |
| JobBench | 70.5 | 75.4 | Opus |
| MemoryBench | 85.6 | 81.5 | Muse |
| Terminal-Bench 4.0-AA | 52.0 | 59.6 | Opus |
| DeepSWE 1.1 | 78.8 | 74.2 | Muse |
| SWE-Marathon | 53.1 | 46.3 | Muse |
| ProgramBench | 50.0 | 70.5 | Opus |
| HealthBench Pro | 60.5 | 65.6 | Opus |
La méthodologie officielle de la fiche modèle distingue les tests internes, les évaluations tierces et les scores des concurrents rapportés par les éditeurs. Le tableau reproduit les valeurs rapportées ; il n’établit pas un essai uniforme et indépendant sur toutes les lignes.
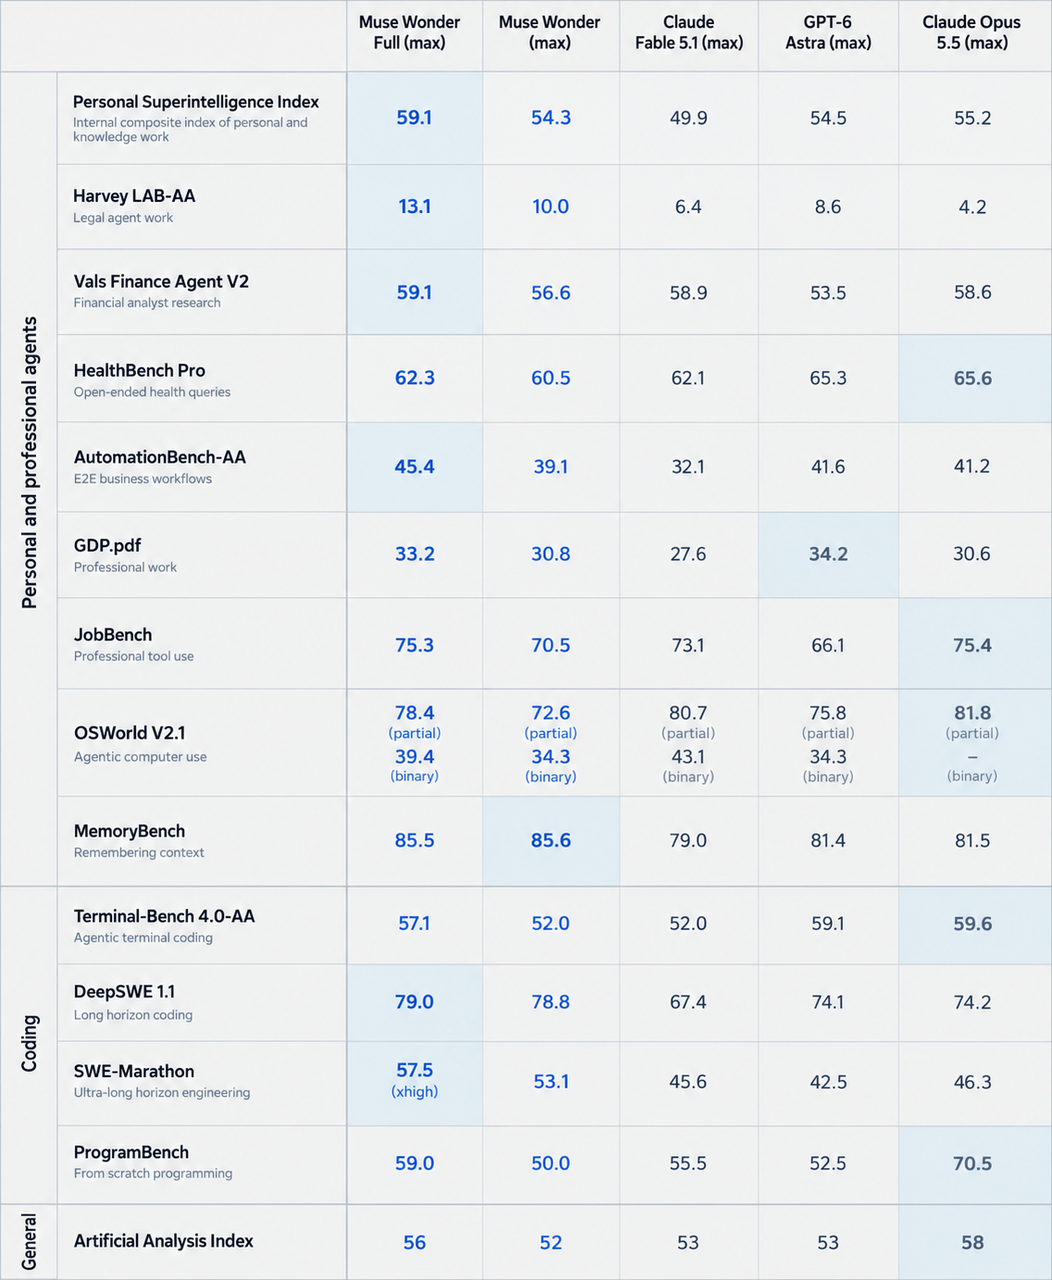
Tableau de scores original des benchmarks extrait de la fiche modèle de Muse Wonder de Meta, reproduit sans redessin. Le modèle OpenAI supplémentaire figurant sur cette image officielle est GPT-6 Astra, pas GPT-6 Sol. Les tableaux environnants identifient les modèles pertinents pour cet article.
Conditions d’évaluation
DeepSWE v1.1 couvre 113 tâches sur 91 dépôts et cinq langages, notées par des tests fonctionnels et de non-régression en pass@1 ; la fiche de scores de Meta utilise les résultats Datacurve pour Muse Wonder et Opus 5.5. SWE-Marathon utilise des tests de projet et rapporte pass@1 d’Abundant AI ; les harnais d’agent varient, et le score de Wonder Full est indiqué xhigh. ProgramBench utilise mini-swe-agent et mesure les rollouts réussissant au moins 95 % des tests cachés, avec internet désactivé après la configuration. MemoryBench est un test interne de Meta sur des conversations de 64K–100K jetons noté par un juge LLM. Ces environnements et métriques ne doivent pas être réduits à un score général unique de précision.
Programmation et ingénierie logicielle
Muse Wonder est en tête sur DeepSWE 1.1 et SWE-Marathon rapportés. Claude Opus 5.5 est en tête sur Terminal-Bench 4.0-AA et ProgramBench. Cette répartition suggère que l’ingénierie de long terme, l’usage d’outils en ligne de commande et la reconstruction de programmes sollicitent des compétences différentes.
Résultats de GPT-6 Sol et comparabilité inter-sources
| Évaluation publiée par OpenAI | GPT-6 Sol | Paramétrage rapporté |
|---|---|---|
| DeepSWE 1.1 | 68.8% | Maximum reasoning |
| AutomationBench 1.0.6 | 33.2% | xhigh reasoning |
| Agents' Last Exam V1 | 56.4% | Maximum reasoning |
| OSWorld 2.0 offline | 60.5% | xhigh reasoning |
Les résultats d’évaluation publiés par OpenAI rapportent les scores ci-dessus. Son résultat OSWorld est une récompense partielle sur l’ensemble offline v2026.08.08, plutôt qu’un taux strict d’accomplissement de tâches. OpenAI indique que les évaluations ont utilisé son environnement de recherche ou l’API ; les configurations en production peuvent différer.
Les scores DeepSWE rapportés impliquent un écart de 10.0 points de pourcentage entre Muse Wonder et GPT-6 Sol, et de 5.4 points entre Opus 5.5 et GPT-6 Sol. Ce sont des différences arithmétiques entre publications, pas des estimations contrôlées d’un avantage dû uniquement au modèle. Des configurations d’agent, prompts, niveaux d’effort et budgets d’outils différents peuvent influer sur le résultat.
Mémoire et agents de longue durée
Muse Wonder cible des agents devant se souvenir des décisions antérieures, retrouver le contexte et poursuivre un travail interrompu. Active Memory peut aider un assistant de recherche à mémoriser des faits spécifiques à un projet, tandis qu’Active Focus soutient l’action itérative lorsqu’un plan antérieur n’aboutit pas. Ces capacités produit ne remplacent pas la vérification d’état, les permissions, les pistes d’audit ou les confirmations humaines obligatoires pour les actions sensibles.
Performances de Muse Wonder Full
Muse Wonder Full est une option produit distincte. Meta propose Muse Wonder standard via son API, tandis que Full est restreint aux abonnements Power Usage et Maximum Usage dans Muse Code. Un score plus élevé ne fait pas de Full un remplacement de l’API standard du modèle.
Les résultats rapportés de Wonder Full sont 56 sur l’Intelligence Index, 59.1 sur Personal Superintelligence, 13.1 sur Harvey LAB-AA et 45.4 sur AutomationBench-AA. Il obtient aussi 79.0 sur DeepSWE 1.1, 57.5 sur SWE-Marathon, 85.5 sur MemoryBench et 75.3 sur JobBench. Ces résultats publiés décrivent le produit Full accessible séparément ; ce ne sont pas de nouvelles mesures issues d’une comparaison à harnais commun.
Par rapport aux scores de Muse Wonder standard ci-dessus, Full s’améliore sur sept de ces huit mesures rapportées ; MemoryBench est légèrement inférieur à 85.5 contre 85.6. Opus 5.5 reste en tête de l’Intelligence Index rapporté avec 58.
Latence et fiabilité
Les éléments cités ne fournissent pas une comparaison de latence appariée entre les trois modèles. Mesurez le temps jusqu’à la première sortie utile, le temps de tâche de bout en bout en médiane et au 95e centile, la fréquence des timeouts et la complétion sans intervention. Maintenez constants les entrées de tâche, les permissions d’outils, la concurrence et les critères d’acceptation ; consignez les réglages d’effort et les budgets de réessai. Une génération de jetons plus rapide n’établit pas à elle seule une complétion plus rapide d’une tâche multi-étapes.
Résultat de la comparaison : Muse Wonder est en tête des tests d’ingénierie soutenue cités, tandis qu’Opus 5.5 mène les tests de terminal et de reconstruction de programmes. GPT-6 Sol demeure un candidat à prix de jetons plus bas, mais les publications disponibles ne prouvent pas un classement de qualité ou de vitesse en environnement égal sur les trois.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol : coût
Tarifs officiels des jetons API
| Prix par 1M de jetons | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Entrée standard | 4 $ | 4 $ | 2 $ |
| Sortie standard | 20 $ | 20 $ | 10 $ |
| Entrée mise en cache | 0.20 $ | 0.20 $ | 0.20 $ |
| Entrée long contexte | 4 $ | 4 $ | 4 $ |
| Sortie long contexte | 20 $ | 20 $ | 15 $ |
| Entrée mise en cache long contexte | 0.20 $ | 0.20 $ | 0.40 $ |
Meta publie 4 $ en entrée, 20 $ en sortie et 0.20 $ pour l’entrée mise en cache par million de jetons. Anthropic indique Opus 5.5 à 4 $ en entrée, 20 $ en sortie et 0.20 $ pour les hits de cache par million de jetons. Le tableau des tarifs d’OpenAI liste GPT-6 Sol à 2 $/10 $ pour l’entrée/sortie en contexte court et 4 $/15 $ pour le long contexte ; les tarifs d’entrée mise en cache varient aussi selon le palier. Appliquez le palier de contexte par requête, le mode de traitement pertinent et les conditions de l’endpoint avant d’estimer une charge de travail.
Pour GPT-6 Sol, les requêtes contenant plus de 272,000 jetons d’entrée sont facturées à des tarifs plus élevés :
- Jetons d’entrée : 2× le tarif standard, passant de 2 $ à 4 $ par million de jetons.
- Jetons d’entrée mis en cache : 2× le tarif standard, passant de 0.20 $ à 0.40 $ par million de jetons.
- Jetons de sortie : 1.5× le tarif standard, passant de 10 $ à 15 $ par million de jetons.
Ces tarifs plus élevés s’appliquent à l’ensemble de la requête, pas seulement aux jetons dépassant 272,000. Une requête avec 272,001 jetons d’entrée bascule donc dans le palier de tarification long contexte pour tous ses jetons d’entrée, d’entrée mise en cache et de sortie.
À titre de comparaison, Muse Wonder et Claude Opus 5.5 n’imposent pas de surprime équivalente pour le long contexte dans leurs tarifs API standard.
Cette distinction est particulièrement importante pour l’analyse de grands documents, la programmation à l’échelle d’un dépôt et les agents IA de longue durée, où l’avantage tarifaire de GPT-6 Sol en contexte court peut se réduire à mesure que les requêtes s’allongent.
Tarification CometAPI et conditions de facturation
Au moment de la revue, CometAPI indiquait Opus 5.5 à 3.20 $ en entrée / 16 $ en sortie et GPT-6 Sol à 1.60 $ en entrée / 8 $ en sortie par million de jetons. Ce sont des tarifs indépendants de CometAPI et ils ne doivent pas être confondus avec les prix officiels des fournisseurs ci-dessus. Confirmez la route applicable, le palier de contexte et les conditions de facturation de votre compte avant d’estimer le coût ; les prix et conditions peuvent changer.
Coût par tâche acceptée
Calculez le coût par tâche acceptée comme la dépense totale facturée du modèle et des outils, y compris les réessais et recours facturés, divisée par le nombre de sorties répondant aux critères d’acceptation prédéfinis. Déclarez séparément le temps de revue humaine ou convertissez-le avec un taux horaire explicite. Suivez les requêtes échouées et les frais réels de manière indépendante : un échec ne détermine pas en soi si une requête a été facturée.
Résultat de la comparaison : GPT-6 Sol a les tarifs d’entrée et de sortie standard les plus bas pour le contexte court, tandis que Muse Wonder et Opus 5.5 partagent les mêmes tarifs de base listés. Le coût réel par tâche acceptée dépend de la route de facturation sélectionnée, de l’usage du cache, des paliers de contexte, des frais d’outils, des réessais et de l’effort de revue.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol : comparaison et sélection
Sélection fondée sur les capacités et la charge de travail
- Pour une programmation large et des workflows orientés terminal, commencez par Claude Opus 5.5 car il mène l’Intelligence Index, Terminal-Bench et ProgramBench cités. Validez-le sur le refactoring, l’exécution d’outils et la cohérence au niveau du programme.
- Pour des projets d’ingénierie prolongés, commencez par Muse Wonder car ses résultats DeepSWE et SWE-Marathon rapportés sont plus forts que ceux d’Opus 5.5. Mesurez l’achèvement des tâches, la reprise après obstacles et le coût total de la tâche.
- Pour des agents personnels persistants, commencez par Muse Wonder car il propose Active Memory et Active Focus et obtient un score MemoryBench supérieur à celui d’Opus 5.5. Testez le rappel, les corrections, la continuité et l’isolation des projets.
- Pour des workflows multi-étapes avec outils, évaluez les trois modèles. Muse propose Active Focus, Opus met l’accent sur l’orchestration d’outils et GPT-6 Sol prend en charge les outils de l’API Responses. Comparez la pile d’agent complète, y compris les permissions d’outils, les réessais et la gestion d’état.
- Pour les documents professionnels et l’analyse, évaluez Muse Wonder ou Claude Opus 5.5. Muse a des forces spécialisées, tandis qu’Opus a l’indice agrégé cité le plus fort. Utilisez des documents représentatifs et des critères d’acceptation spécifiques à la tâche.
- Pour l’automatisation à grand volume et sensible aux coûts, commencez par GPT-6 Sol car il propose les tarifs standard les plus bas en contexte court. Vérifiez le coût par tâche acceptée, les paliers de contexte, la latence et les réessais.
- Pour l’option la plus haut de gamme de Meta, évaluez Muse Wonder Full si vous y avez accès. Il affiche des scores plus élevés sur plusieurs tâches spécialisées, mais il est distinct du modèle API standard. Confirmez l’accès par abonnement et la pertinence avant de tester.
Programmation professionnelle
Claude Opus 5.5 est un bon choix par défaut pour les équipes exigeant un assistant d’ingénierie généraliste, en particulier lorsque l’exécution d’outils, le refactoring et la cohérence au niveau du programme comptent. Ses avantages rapportés sur Terminal-Bench et ProgramBench renforcent ce constat, bien que les équipes doivent valider la pile d’agent complète et pas uniquement le modèle.
Automatisation à grande échelle
GPT-6 Sol est attractif quand les requêtes sont nombreuses et que la sensibilité au coût est élevée. Même un léger déficit de qualité peut être acceptable pour des tâches à faible risque et facilement vérifiables comme la rédaction de documentation, l’extraction de champs structurés ou l’explication de code. Pour des exécutions autonomes longues, suivez la qualité, les jetons, la latence et les réessais conjointement.
Liste de contrôle pour l’évaluation en production
L’évaluation en production doit suivre six métriques : l’exactitude, mesurée par les réponses acceptées ou les tests réussis ; la fiabilité, mesurée par les tâches achevées sans secours humain ; la latence, mesurée par la durée de la tâche de bout en bout ; l’usage de jetons, mesuré par le total facturé en entrée et sortie ; l’efficacité de l’agent, mesurée par les appels d’outils et les réessais correctifs ; et le coût effectif, calculé comme la dépense totale divisée par les tâches acceptées.
Résultat de la comparaison : Mettez Muse Wonder en short-list pour les comportements d’agent persistant et l’ingénierie prolongée, Opus 5.5 pour des workflows de programmation étendus avec de fortes exigences terminal, et GPT-6 Sol lorsque le coût des jetons est une contrainte majeure. Ne promouvez un candidat qu’après qu’il atteint des seuils de qualité et de fiabilité spécifiques à la tâche.
Où accéder à Muse Wonder, Claude Opus 5.5 et GPT-6 Sol ?
Accès via les fournisseurs officiels
Utilisez Meta Model API pour Muse Wonder standard, Anthropic API pour Opus 5.5, ou OpenAI API pour GPT-6 Sol. Muse Wonder Full est disponible via les plans d’abonnement Muse Code spécifiés plutôt qu’en remplacement direct du modèle API standard. Vérifiez l’accès au compte, les limites d’usage et les fonctionnalités de requête prises en charge pour la route que vous sélectionnez.
Accès via CometAPI
Une passerelle unifiée peut simplifier l’authentification, la facturation et le routage. Utilisez un modèle plus performant pour la revue d’architecture complexe et un modèle moins coûteux pour la rédaction répétitive à faible risque. L’identifiant du modèle et le format de requête pris en charge doivent toujours être vérifiés par rapport à l’endpoint API cible.
Les développeurs peuvent accéder à l’API Claude Opus 5.5 dans CometAPI et à l’API GPT-6 Sol dans CometAPI pour évaluer des charges de travail représentatives. Confirmez la surface d’API prise en charge pour chaque modèle plutôt que de supposer qu’une passerelle partagée rend tous les formats de requête interchangeables.
Les routes CometAPI citées dans cet article couvrent Opus 5.5 et GPT-6 Sol. Cet article n’établit pas de route CometAPI pour Muse Wonder ou Wonder Full ; utilisez la route fournisseur confirmée lors de l’évaluation de ces produits.
Conclusion
Aucun modèle ne l’emporte sur toutes les charges de travail. Muse Wonder est le candidat le plus solide à tester pour le comportement d’agent persistant et les tâches d’ingénierie de longue durée. Claude Opus 5.5 est un solide candidat pour une programmation large, des workflows fortement orientés terminal et le travail de connaissance, et il arrive en tête de l’Artificial Analysis Intelligence Index rapporté par Meta. GPT-6 Sol propose les tarifs de jetons standard les plus bas en contexte court et est attractif pour l’automatisation sensible aux coûts. Les équipes de production doivent faire le choix final à partir de la qualité des tâches acceptées, de la fiabilité, de la latence, des réessais, de l’usage d’outils et du coût total sur des charges de travail représentatives.
FAQ
Comment les équipes peuvent-elles tester équitablement Muse Wonder, Opus 5.5 et GPT-6 Sol ?
Utilisez un ensemble de tâches réelles en réserve avec des critères d’acceptation fixes, des artefacts d’entrée identiques et des permissions d’outils documentées. Enregistrez chaque version de modèle, le niveau d’effort, le harnais d’agent, le timeout et le budget de jetons. Exécutez des essais répétés lorsque les sorties varient, rapportez les échecs comme les succès, et séparez une comparaison à harnais commun d’une comparaison de système configuré au mieux. Cela produit des preuves applicables à votre workflow plutôt qu’à la configuration de benchmark d’une autre équipe.
Une passerelle API peut-elle préserver l’état d’un agent lors d’un changement de modèle ?
Une adresse de passerelle partagée ne garantit pas en soi la portabilité de l’état de conversation, des identifiants d’appels d’outils ou des références de réponses stockées. Conservez un enregistrement canonique côté application des messages, sorties d’outils et état de tâche validé. Testez l’état et la sémantique des outils de chaque route avant de router un travail en cours vers un autre modèle ; sinon, un fallback moins cher peut perdre des informations nécessaires pour terminer correctement.
Comment les équipes doivent-elles budgéter les réessais et la revue humaine ?
Définissez un résultat accepté avant les tests, puis divisez la dépense totale facturée (modèle et outils) par les résultats acceptés. Rapportez la main-d’œuvre de revue séparément ou incluez-la avec un taux horaire déclaré. Comptez les tentatives échouées, les appels correctifs et les modèles de secours, et comparez à la fois les tâches typiques et les tâches à coût élevé. Cela évite de considérer un prix de jeton plus bas comme une réduction garantie du coût du travail utile.
Que doit inclure l’évaluation d’un agent sensible à la mémoire ?
Testez si l’agent se souvient des faits pertinents, intègre les corrections, ignore les instructions obsolètes et maintient l’isolation entre projets. Incluez des suivis différés et des mises à jour contradictoires plutôt qu’un seul prompt long. Vérifiez le comportement mémoire au niveau de l’application ainsi qu’au niveau du modèle, car la persistance, la récupération et la suppression dépendent du système déployé.