
TLDR OpenAI Bel est une exécution interne de pré‑entraînement non confirmée (nom de code) rapportée pour la première fois sur X le 25 août 2026 par @synthwavedd. L’allégation décrit un modèle de base terminé avec plus de 10 000 milliards de paramètres au total—successeur d’une exécution antérieure appelée Doug—destiné à servir de fondation pour des systèmes post‑GPT‑6 et potentiellement un modèle « seuil d’AGI » après un renforcement d’apprentissage supplémentaire.
Au 13 octobre 2026, OpenAI n’a jamais utilisé le nom Bel (ou Doug dans des documents produits publics), n’a publié aucun nombre de paramètres, date de sortie, benchmarks ou carte système, et Bel n’est disponible ni via API ni dans ChatGPT.
Points clés
- Bel provient d’un seul post sur X de @synthwavedd le 25 août 2026 ; OpenAI ne l’a jamais confirmé.
- Échelle revendiquée : >10 T de paramètres totaux, dans une classe de taille similaire à GPT-4.5 selon le post d’origine.
- Positionné dans la rumeur comme successeur de « Doug » et base pour des systèmes post‑GPT‑6 / Astra après RL.
- GPT-6 Astra est disponible publiquement depuis début septembre 2026 et constitue le porte‑étendard actuel d’OpenAI.
- Aucun benchmark indépendant, date de sortie, API, tarification ou poids n’existe pour Bel.
- Claude Fable 5.5 reste non annoncé ; le Claude haut de gamme actuel est Fable 5.1.
- Pour la production aujourd’hui, acheminez GPT-6 Astra / Sol / Luna et les modèles Claude via une seule clé sur CometAPI pour un coût inférieur et sans verrouillage fournisseur.
Qu’est-ce qu’OpenAI Bel ?
OpenAI Bel (parfois stylisé « BEL ») est le nom de code qui circule dans les discussions de la communauté IA pour un prétendu pré‑entraînement à grande échelle qu’OpenAI aurait achevé dans la seconde moitié d’août 2026. Selon le rapport d’origine, Bel est un modèle de base brut—pas un produit fini—avec plus de 10 000 milliards de paramètres totaux. Il est présenté comme le successeur d’un projet interne antérieur appelé Doug et comme la base destinée, après un renforcement d’apprentissage et un post‑entraînement supplémentaires, à alimenter des systèmes au‑delà de GPT-6 Astra, potentiellement en atteignant ce que certains initiés appelleraient un niveau de capacité « seuil d’AGI ».
Il est important de noter que Bel n’est pas GPT‑7, pas un modèle ChatGPT avec lequel les utilisateurs peuvent dialoguer, et pas quelque chose de disponible via l’API OpenAI. Il est décrit strictement comme un artefact de pré‑entraînement—l’énorme réseau neuronal entraîné sur du texte (et possiblement d’autres données) qui nécessite encore un important ajustement fin, alignement et travail de sécurité avant de devenir un produit livrable.
Bel est le nom de code rapporté d’un effort de modèle de base d’OpenAI. L’allégation est attribuée au post du 25 août 2026 de @synthwavedd sur une exécution de pré‑entraînement achevée. Le post reproduit allègue plus de 10 000 milliards de paramètres totaux et une relation de succession à Doug. Ces détails restent des affirmations à source unique : la capture d’écran enregistre une allégation, pas un résultat d’entraînement d’OpenAI authentifié.
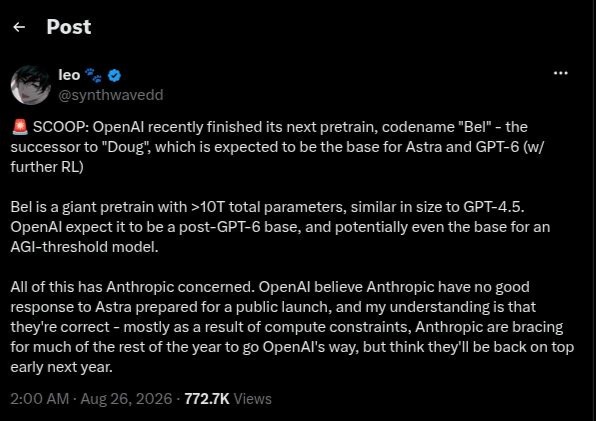
La capture d’écran est reproduite à partir de la capture de Mukhtada du post attribué sur X. Elle affiche le 26 août à 2:00 dans le contexte horaire de Jakarta, correspondant au 25 août à 19:00 UTC. Il s’agit d’une capture tierce, pas d’une confirmation indépendante du nombre de paramètres, du statut d’entraînement ou d’allégations privées concurrentielles.
Chronologie des éléments de preuve Doug–Bel
Le contexte Doug est distinct : la publication du 7 août de SemiAnalysis reproduit une note du 9 juillet mentionnant un modèle OpenAI plus grand appelé Doug. Cela précède le post sur Bel, mais n’authentifie pas Doug → Bel ni ne relie l’un ou l’autre nom de code à un produit lancé.
- 9 juillet 2026 : Une note de recherche mentionnant un modèle OpenAI plus grand appelé Doug a été reproduite plus tard dans l’article de SemiAnalysis publié le 7 août. La date de la note et la date de publication sont des jalons différents ; c’est un contexte sur Doug, pas une confirmation de Bel.
- 7 août 2026 : SemiAnalysis a publié l’article reproduisant la référence à Doug. Il précède l’allégation concernant Bel mais n’établit pas une lignée Doug‑vers‑Bel ni un nom de produit public.
- 25 août 2026 : Le post attribué de @synthwavedd alléguait l’achèvement du pré‑entraînement de Bel et plus de 10 000 milliards de paramètres. Une capture tierce reproduit l’allégation ; ce n’est pas une vérification indépendante.
- 1er septembre 2026 : Le rapport Path to Astra cité dans cet article fournit un contexte sur un programme de développement de modèles distinct. Il n’établit pas l’identité de Bel, son nombre de paramètres, ni un lien avec GPT‑7 ou un éventuel nom GPT‑6 Bel.
- 23 septembre 2026 : Un récit circulant attribue une attente de plusieurs mois à un post de suivi du même compte. Le texte original n’étant pas directement accessible lors de la revue, cela reste un repère temporel non vérifié et ne fournit aucun engagement de lancement.
- 12 octobre 2026 — point de revue de l’article : Le post attribué à Bel, le reportage sur Doug et le rapport officiel distinct cités ici n’établissent pas d’identité commerciale pour Bel. Ni GPT‑7 ni GPT‑6 Bel ne sont confirmés par cette chaîne de preuves ; cette date enregistre la revue de l’article, pas l’annonce d’un modèle.
À la même période, OpenAI a évoqué publiquement un modèle interne non nommé « considérablement plus capable que GPT‑6 Astra » en lien avec des travaux mathématiques (y compris des résultats relatifs aux équations de Navier‑Stokes).
Deux hypothèses de nommage : GPT‑7 ou GPT‑6 Bel ?
Le pré‑entraînement et la mise sur le marché sont des jalons différents. Un checkpoint de fondation peut encore nécessiter un ajustement par instructions, du renforcement d’apprentissage, une évaluation de sécurité, une formation à l’utilisation d’outils et une optimisation de la mise en service. Plusieurs produits peuvent dériver d’une même fondation, et un numéro de version public n’identifie pas une exécution d’entraînement. Le rapport Path to Astra d’OpenAI fournit un contexte officiel sur le renforcement d’apprentissage, sans établir l’identité de Bel.
Hypothèse 1 — GPT‑7 : Si Bel représente une fondation matériellement nouvelle au‑delà de la génération GPT‑6, OpenAI pourrait commercialiser un modèle qui en dérive sous l’appellation GPT‑7. Cette interprétation dépend d’une nouvelle génération de capacités et d’une décision de nommage publique ; ni le nombre de paramètres allégué ni l’achèvement rapporté du pré‑entraînement ne suffisent à établir cet aboutissement.
Hypothèse 2 — GPT‑6 Bel : OpenAI pourrait au contraire conserver un produit dérivé de Bel au sein de la famille GPT‑6, en utilisant potentiellement un label comme GPT‑6 Bel pour une offre améliorée ou spécialisée. Il s’agit d’un scénario de nommage éditorial à titre de comparaison, pas d’un produit annoncé ni d’une fuite sourcée séparément. Un nom de code interne n’apparaît pas nécessairement dans le nom commercial.
Ce qui reste non résolu : Le même effort d’entraînement pourrait alimenter plusieurs produits, un autre nom, ou aucune sortie publique. La chronologie fournit un contexte pour les deux interprétations mais ne permet pas de trancher entre elles. Une confirmation nécessiterait une documentation reliant l’effort d’entraînement Bel à un modèle public réel et à son nom.
OpenAI Bel comparé à la génération précédente : quelles améliorations ?
Faute de détails techniques concrets pour Bel, toute discussion des améliorations doit s’appuyer sur (1) les allégations de haut niveau de la fuite, (2) la trajectoire connue GPT‑4o → GPT‑5.x → GPT‑6 Astra et (3) les capacités démontrées par le modèle interne non nommé utilisé pour des travaux scientifiques de l’échelle Navier‑Stokes. Chaque domaine d’amélioration potentiel est traité séparément ci‑dessous.
Échelle et calcul de pré‑entraînement
L’allégation centrale est un saut au‑delà des exécutions internes précédentes, dans le régime >10 T de paramètres. Si elle est exacte, cela représenterait une poursuite de l’adhésion aux lois d’échelle sur les données, les paramètres et le calcul. Confirmé : OpenAI a poursuivi de grands entraînements et a publiquement fait référence à des modèles plus capables qu’Astra. Non confirmé : tout nombre spécifique de paramètres, FLOPs d’entraînement, mélange de données ou changements d’architecture (dense vs. mixture‑of‑experts, attention nouvelle, etc.). Attente réaliste fondée sur l’historique : meilleure efficacité échantillonnale et couverture de connaissances plus large, mais rendements décroissants sans avancées correspondantes en post‑entraînement et en qualité des données.
Post‑entraînement et alignement pour une agentivité à long horizon
GPT‑6 Astra a déjà nettement progressé sur les workflows multi‑étapes, l’utilisation d’ordinateur et le respect des limites de tâche. Une base plus puissante plus un RL supplémentaire pourraient pousser un fonctionnement d’agent fiable de quelques heures vers des horizons de plusieurs jours ou semaines avec moins de pilotage humain. L’expérience multi‑agents Navier‑Stokes (des milliers d’agents coordonnés) montre qu’OpenAI opère déjà à l’échelle d’essaims d’agents sur des problèmes difficiles. Direction capacitaire confirmée : oui. Contribution spécifique de Bel : non confirmée.
Raisonnement scientifique et mathématique
Astra lui‑même a contribué à des progrès mathématiques ; le modèle interne plus puissant a produit un résultat formalisé sur un problème du Prix du millénaire. Une base plus grande et mieux entraînée pourrait encore réduire le temps et le coût d’exploration d’espaces de recherche STEM difficiles. Confirmé : OpenAI investit fortement ici. Spécifique à Bel : non confirmé.
Utilisation d’ordinateur, utilisation d’outils et fiabilité multimodale
Astra a établi de nouveaux records sur les benchmarks d’utilisation de l’ordinateur et du navigateur. On s’attendrait de futures bases à réduire les taux d’erreur sur de longues trajectoires, améliorer l’ancrage visuel et gérer des environnements logiciels plus complexes. Spéculatif mais cohérent avec la feuille de route produit.
Efficacité, vitesse d’inférence et coût
Même si la base est plus grande, la distillation, de meilleures architectures et du silicium personnalisé (OpenAI a évoqué ses propres ASIC) pourraient malgré tout offrir un bon rapport coût/performances. Aucune revendication spécifique d’efficacité n’existe pour Bel.
Quand OpenAI Bel ou GPT‑7 pourraient‑ils être lancés ?
Aucune date de lancement officielle pour Bel ou un GPT‑7 dérivé de Bel n’est établie par les sources examinées. Un récit circulant du suivi du 23 septembre de @synthwavedd décrivant une attente de plusieurs mois est attribué à la même source non officielle que la fuite initiale. Son texte complet n’était pas directement accessible durant cette revue, il ne doit donc pas servir à prévoir une fenêtre de lancement. Un pré‑entraînement achevé, si c’est vrai, pourrait encore être suivi de post‑entraînement, d’évaluations, de travaux de mise en service et d’un déploiement par étapes.
| Scénario | Ce qui se passerait | Ce que cela implique |
|---|---|---|
| Achèvement plus rapide | Les évaluations restantes et le déploiement réussissent relativement vite | Un successeur pourrait arriver plus tôt |
| Développement prolongé | Plus d’entraînement, de mitigations et de travaux de mise en service sont requis | Le calendrier se décale davantage |
| Déploiement alternatif | La fondation alimente des systèmes spécialisés ou différemment brandés | Aucun produit nécessairement nommé Bel |
Le supposé Fable 5.5 n’a pas de calendrier vérifié dans les sources examinées ; une prédiction d’ordre de sortie n’est donc pas étayée.
Bel pourrait‑il modifier l’équilibre entre OpenAI et Anthropic ?
Trois issues crédibles restent ouvertes. Premièrement, Bel pourrait introduire un large saut de pré‑entraînement et améliorer les systèmes de codage et de raisonnement ultérieurs. Deuxièmement, l’avantage pourrait être limité, d’autres fournisseurs conservant des points forts en fiabilité des agents, latence ou coût. Troisièmement, l’énorme échelle rapportée pourrait ne pas se traduire par des gains pratiques proportionnels. Tant qu’aucune preuve reproductible n’existe, le cadrage correct est celui d’une possible réponse concurrentielle plutôt que d’un vainqueur déclaré.
Recommandations pratiques pour les développeurs et les équipes (CometAPI)
Alors que le secteur attend une confirmation officielle de Bel ou du prochain grand modèle de base d’OpenAI, les systèmes de production ont besoin d’un accès fiable aux modèles réellement disponibles aujourd’hui. CometAPI fournit un point de terminaison unique compatible OpenAI (https://api.cometapi.com/v1) et une seule clé API qui donne accès à plus de 500 modèles, y compris l’ensemble de la famille GPT‑6 actuelle (Astra, Sol, Luna et mises à jour) et la gamme Claude d’Anthropic (Fable 5.1, Opus 5.5, Sonnet 5.5, etc.).
Conclusion
La frontière de l’IA continue d’avancer rapidement. Bel pourrait s’avérer être un jalon interne important, un nom de code mal rapporté, ou quelque chose entre les deux. Tant qu’OpenAI ne publie pas d’informations concrètes, la position responsable est de considérer ces allégations comme non vérifiées tout en tirant un maximum de valeur des modèles déjà disponibles—et de garder une infrastructure suffisamment flexible pour intégrer la prochaine génération dès qu’elle deviendra réelle. Pour de nombreuses équipes, cette flexibilité s’obtient aujourd’hui le plus facilement via une plateforme unifiée comme CometAPI.