
TL;DR
OpenAI Decisions API et TypeSafe Jev renvoient tous deux des décisions bornées et assorties de probabilités, plutôt qu’un simple texte généré. OpenAI utilise GPT-6 Luna via un point de terminaison dédié ; Jev est un modèle System One spécialisé. Jev est moins cher selon les tarifs publiés au million de jetons d’entrée (0,042 $ contre 0,10 $), tandis qu’OpenAI gère nativement les images. Les chiffres des fournisseurs examinés ici n’établissent pas de vainqueur clair en précision ou en vitesse.
Points clés
- Tarification : Jev est 58 % moins cher par jeton d’entrée aux tarifs de base publiés.
- Architecture : OpenAI Decisions API utilise GPT-6 Luna ; Jev est conçu spécifiquement pour le traitement décisionnel.
- Modalité : OpenAI prend en charge le texte et les images ; Jev se concentre sur le texte et les entrées structurées.
- Benchmarks : Les déclarations de vitesse des fournisseurs s’appuient sur des bases différentes ; comparez sur le même jeu de données annoté.
- Sélection : Priorisez la prise en charge multimodale et l’intégration OpenAI, ou le débit texte seul et le coût, selon votre application.
En un coup d’œil : OpenAI Decisions API vs Jev
La synthèse ci-dessous compare les points de terminaison décisionnels documentés et les tarifs de base publiés, vérifiés le 12 octobre 2026. L’accès au modèle, les limites et les conditions de service doivent être vérifiés pour le compte de déploiement.
| Fonctionnalité | OpenAI Decisions API | TypeSafe Jev |
|---|---|---|
| Fournisseur | OpenAI | TypeSafe AI |
| Moteur | GPT-6 Luna | Jev System One |
| Point de terminaison | POST /v1/decisions | POST /v1/systemone |
| Identifiant du modèle | gpt-6-luna | jev-1.13.0 / jev-latest |
| Entrées | Texte + images | Texte / texte structuré |
| Types de question | Predicate (probabilité de condition), choice (catégorie), score (rubrique) | Noul (probabilité de condition), choice (catégorie), score (niveaux) |
| Questions de la requête | Tableau avec des noms | Objet indexé par ID |
| Limite de contexte | Non spécifiée dans le guide Decisions lié | 64K au total ; état + question la plus longue ≤32K |
| Coût d’entrée de base / 1M | 0,10 USD | 0,042 USD |
| Coût des jetons de sortie | Aucun frais | Aucun frais |
| Déclaration de vitesse du fournisseur | Environ 10× plus rapide que Responses API | 70–500 ms de bout en bout |
| Disponibilité | Bêta publique | Accès anticipé lors de l’annonce ; vérifier l’accès actuel au compte |
| Avantage distinctif | Décisions basées sur l’image | Coût d’entrée publié plus faible |
| Raisonnement/programmation génératif | Pas le contrat de sortie de ce point de terminaison | Pas le contrat de sortie de ce point de terminaison |
De nombreux flux IA ont besoin d’une catégorie, d’une probabilité ou d’un score — pas d’un paragraphe. Un ticket d’assistance doit être routé ; un agent doit sélectionner une action approuvée ; une file de revue doit identifier les entrées incertaines. Les deux produits font de ces décisions des sorties d’API de première classe.
OpenAI a publié la Decisions API en bêta le 6 octobre 2026 (https://developers.openai.com/api/docs/changelog). Son point de terminaison GPT-6 Luna accepte le texte et les images. Jev est le modèle System One spécialisé de TypeSafe AI pour l’évaluation non générative, avec une approche d’entraînement décrite comme Reinforcement Learning for Calibrated Decisions (RLCD) (https://docs.typesafe.ai/introduction/machine-learning-primer).
Les types de question du tableau couvrent trois tâches communes. Le predicate d’OpenAI et le noul de Jev (https://docs.typesafe.ai/api) estiment si une condition est vraie, comme l’intention de remboursement ou l’éligibilité. Choice sélectionne parmi des catégories prédéfinies, telles que Billing, Technical et Shipping, pour le routage. Score évalue une entrée selon une rubrique ou des niveaux, tels que l’urgence ou la priorité. Ces descriptions consolident les deux présentations produit ; les schémas de requête et la sémantique des probabilités exigent encore un traitement spécifique à chaque fournisseur.
Qu’est-ce qu’OpenAI Decisions API et Jev ?
OpenAI Decisions API et TypeSafe Jev sont des services IA axés sur la décision, conçus pour transformer des données d’entrée en sorties structurées et bornées plutôt qu’en texte ouvert. À la différence des modèles de langage traditionnels qui génèrent des explications ou des réponses conversationnelles, ces API évaluent des questions prédéfinies et renvoient des décisions, des probabilités ou des scores. Elles sont particulièrement utiles pour des flux automatisés tels que le routage des demandes clients, la classification de contenu, l’évaluation des risques et la sélection d’outils par des agents IA, où des sorties prévisibles et un traitement efficace sont essentiels.
OpenAI Decisions API (https://developers.openai.com/api/docs/guides/decisions) est propulsée par GPT-6 Luna et fonctionne via le point de terminaison /v1/decisions. Elle prend en charge les entrées texte et image, avec trois types de décision : predicate, choice et score. Son principal avantage est de combiner la compréhension contextuelle d’un modèle généraliste avec une interface décisionnelle dédiée, ce qui la rend adaptée à la classification multimodale et aux applications déjà intégrées à l’écosystème OpenAI.
TypeSafe Jev (https://docs.typesafe.ai/api), en revanche, est un modèle décisionnel spécialisé accessible via le point de terminaison /v1/systemone. Il se concentre sur l’évaluation textuelle avec trois types de question : noul, choice et score. Jev met l’accent sur une inférence efficace, des prédictions structurées et une calibration des probabilités, ce qui en fait une option intéressante pour la classification à grand volume et les pipelines décisionnels automatisés. Bien que les deux services répondent à des problématiques similaires, leurs différences d’architecture, de capacités d’entrée, de tarification et de conception d’API peuvent fortement influencer le choix le mieux adapté à une application donnée.
Approche des modèles, limites d’entrée et portée
La comparaison porte sur le comportement d’API documenté et le positionnement produit. OpenAI expose GPT-6 Luna via un point de terminaison décisionnel, tandis que TypeSafe positionne Jev comme un modèle System One spécialisé. Ces descriptions à elles seules n’établissent aucun avantage de précision ni ne révèlent tous les détails d’implémentation.
Jev autorise 64K jetons pour la requête complète, avec une limite distincte de 32K pour l’état plus la question la plus longue (https://docs.typesafe.ai/models). Comptez les instructions de question et les critères ainsi que l’entrée partagée. Le guide Decisions d’OpenAI lié ne mentionne pas de limite de contexte numérique distincte pour ce point de terminaison ; vérifiez les limites applicables au lieu de supposer que la fenêtre de contexte du modèle général s’applique inchangée.
Les benchmarks de raisonnement génératif et de génération de code sont hors du périmètre de ces points de terminaison décisionnels bornés. Pour générer des explications ou du code, évaluez un point de terminaison génératif approprié séparément. Les résultats du modèle généraliste sous-jacent n’établissent pas les performances du point de terminaison Decisions.
Précision et latence
Les sources fournisseurs citées ne fournissent pas de test apparié établissant un vainqueur en précision ou en latence. La déclaration d’OpenAI d’environ 10× plus rapide (https://developers.openai.com/api/docs/guides/decisions) compare Decisions à son Responses API. TypeSafe annonce 70–500 ms de latence de bout en bout (https://typesafe.ai/blog/introducing-system-one-models-and-jev) et précise que ses évaluations publiées ont généralement été exécutées depuis un ordinateur portable dans l’ouest des États-Unis.
| Métrique | OpenAI Decisions API | Jev | Évaluation |
|---|---|---|---|
| Précision appariée | Aucun test apparié dans les sources citées | Aucun test apparié dans les sources citées | Aucun vainqueur |
| Vitesse | Déclaration relative du fournisseur | Plage absolue du fournisseur | Pas directement comparable |
| Calibration | Probabilités ; confiance séparée pour choice/score | Probabilités ; confiance dérivée pour choice/score | Tester la calibration observée |
| Catégorisation texte | Pris en charge | Pris en charge | Deux options viables |
| Catégorisation visuelle | Images natives | Pas d’images natives | Avantage OpenAI |
Calibration des probabilités et seuils de revue
Un modèle peut être précis mais mal calibré. Parmi les prédictions auxquelles une probabilité de 0,90 est attribuée pour la classe sélectionnée, environ 90 % devraient être correctes si cette probabilité est calibrée sur la distribution d’évaluation. Ne substituez pas un champ d’API nommé confidence à cette probabilité sans en vérifier la définition. Jev dérive sa confidence pour Choice à partir de la distribution de probabilité (https://docs.typesafe.ai/confidence) : confidence = (p_max − 1/n) / (1 − 1/n), où n est le nombre de choix. Son résultat Noul n’a pas de champ confidence séparé. Mesurez l’ECE et le score de Brier à partir des probabilités appropriées, en parallèle de la précision, du rappel et du F1 macro ; choisissez les seuils de revue à partir d’exemples annotés.
Tarification et coût par décision acceptée
OpenAI indique 0,10 $ par million de jetons d’entrée pour /v1/decisions (https://developers.openai.com/api/docs/guides/decisions) ; Jev indique 0,042 $ par million de jetons d’entrée (https://docs.typesafe.ai/models). Les deux annoncent l’absence de frais pour les jetons de sortie pour ces services décisionnels. Sur ces tarifs de base, Jev est 58 % moins cher par jeton d’entrée. Des majorations régionales et multiplicateurs de long contexte peuvent s’appliquer chez OpenAI ; les réessais, le prétraitement et la revue peuvent ajouter des coûts au flux.
Supposons que chaque requête utilise 500 jetons d’entrée facturables sur les deux services. Ce sont des calculs illustratifs, pas des factures fournisseurs.
| Décisions mensuelles | Jetons d’entrée | Coût OpenAI | Coût Jev | Différence |
|---|---|---|---|---|
| 10,000 | 5M | 0,50 $ | 0,21 $ | 0,29 $ |
| 100,000 | 50M | 5,00 $ | 2,10 $ | 2,90 $ |
| 1,000,000 | 500M | 50 $ | 21 $ | 29 $ |
| 10,000,000 | 5B | 500 $ | 210 $ | 290 $ |
| 100,000,000 | 50B | 5,000 $ | 2,100 $ | 2,900 $ |
Coût par décision correcte acceptée = (dépenses API + dépenses de réessai + dépenses de revue humaine) / nombre de décisions correctes acceptées. Un faible tarif par jeton peut être compensé par un taux plus élevé de mauvais routages ou d’escalades.
Pour un flux GPT-6 Luna conventionnel, le tableau de tarification des modèles CometAPI (https://www.cometapi.com/models/openai/gpt-6-luna/#pricing) liste les tarifs USD par million de jetons, vérifiés le 12 octobre 2026. Ce sont des tarifs de modèle/point de terminaison ; la page liée montre un exemple pour Responses API et n’établit pas la prise en charge native de /v1/decisions ni sa tarification.
| Palier publié | Entrée / 1M jetons | Sortie / 1M jetons |
|---|---|---|
| Contexte court (condition de page : ≤272,000 jetons) | 0,08 $ | 0,40 $ |
| Long contexte (tel que listé sur la page) | 0,16 $ | 0,60 $ |
Les jetons de sortie GPT-6 Luna ordinaires de CometAPI sont facturés. Gardez cette estimation distincte des deux services décisionnels ci-dessus, dont le coût publié en jetons de sortie est nul. Par exemple, 500 jetons d’entrée plus 20 jetons de sortie coûtent 0,000048 $ par requête à contexte court, soit 48 $ par million de requêtes, avant autres frais. Confirmez le palier applicable et le tarif de compte dans le catalogue de modèles en ligne (https://www.cometapi.com/models/openai/gpt-6-luna/) avant d’établir un budget.
Flux d’agents et arbitrages de modalité
Les deux peuvent router un appel d’outil, évaluer si une condition de garde est satisfaite ou noter une action. Aucun ne remplace l’autorisation, la validation d’entrée ou des permissions d’outil explicites. Pour l’automatisation visuelle, la prise en charge native des images par OpenAI simplifie le pipeline ; pour le routage purement textuel, le coût de base inférieur de Jev peut être attrayant.
La gestion de la sortie diffère à la frontière de la réponse. OpenAI renvoie un tableau answers (https://developers.openai.com/api/docs/guides/decisions), avec des names identifiant les questions ; Jev renvoie un objet answers indexé par ID de question. Normalisez ces structures avant d’appliquer des règles métier communes. Jev dérive confidence de sa distribution de probabilité (https://docs.typesafe.ai/confidence) ; ne supposez pas que des champs de même nom ont des significations équivalentes chez les fournisseurs. Validez les libellés et calibrez les seuils de revue sur les données de l’application.
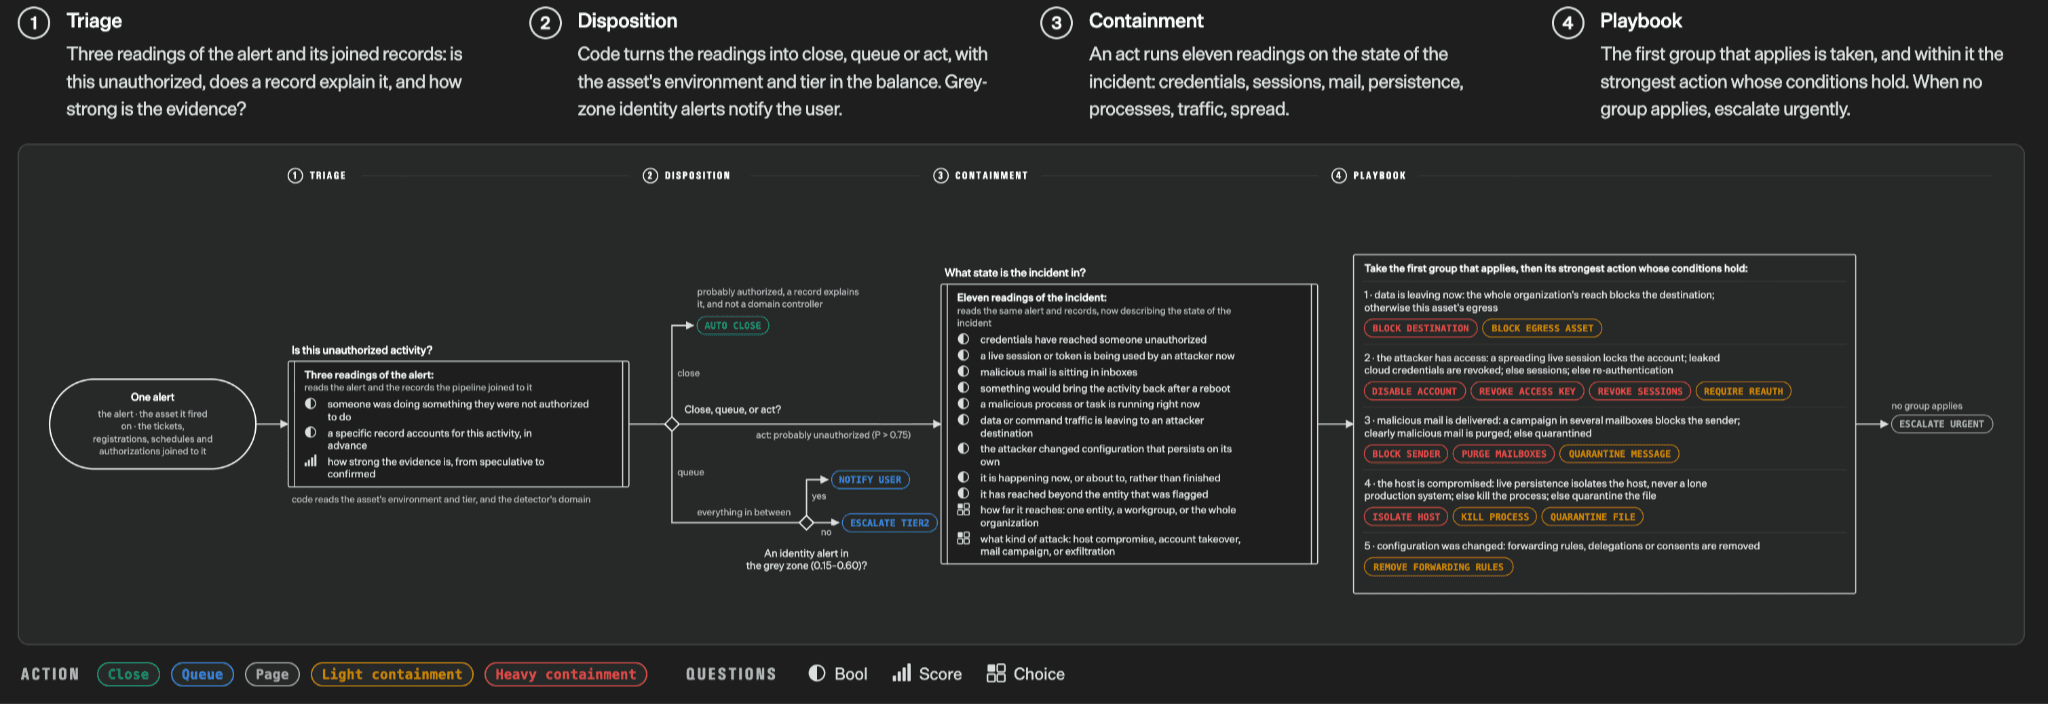
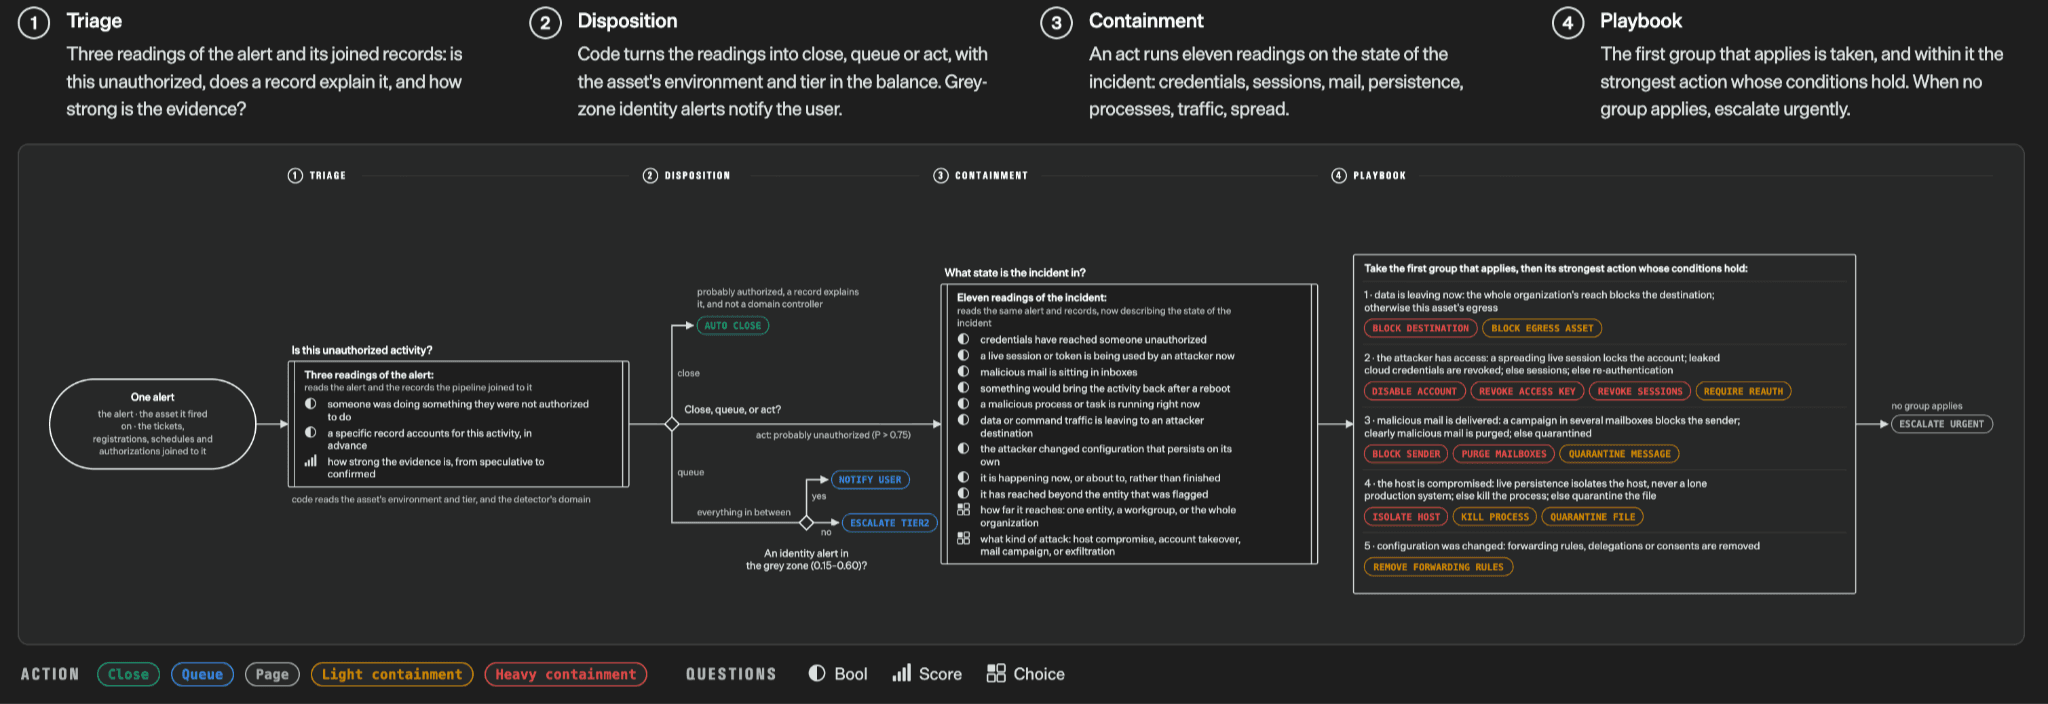
Source : Introducing System One Models & Jev (https://typesafe.ai/blog/introducing-system-one-models-and-jev) ; image d’origine (https://framerusercontent.com/images/ih1bFwZGYJxlnijbTuXx3f9NeM.png). Ceci illustre la composition de flux, pas un benchmark apparié contre OpenAI Decisions API.
En quoi l’usage des API diffère : OpenAI Decisions API vs Jev
L’accès doit être configuré séparément pour chaque fournisseur : chaque exemple ci-dessous utilise son propre hôte et sa propre clé API. OpenAI documente Decisions comme un point de terminaison en bêta publique (https://developers.openai.com/api/docs/guides/decisions). Pour Jev, confirmez l’accès et les identifiants actuels auprès de TypeSafe avant le déploiement. Pour chaque service, vérifiez les permissions de compte, la disponibilité régionale, les quotas et les conditions de service ; un exemple de requête ne garantit pas l’accès en production. Un accès tiers à un modèle génératif ne confirme pas en soi la prise en charge de son point de terminaison décisionnel natif.
Comment utiliser OpenAI Decisions API
Les concepts se recoupent, mais les schémas de requête diffèrent. OpenAI envoie une entrée et un tableau de questions nommées ; Jev utilise un état et un objet questions indexé par ID (https://docs.typesafe.ai/api). Implémentez un adaptateur spécifique au fournisseur avant d’appliquer une politique décisionnelle commune.
Router un ticket d’assistance avec OpenAI Decisions API.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "J’ai été facturé deux fois pour ma commande.",
    "questions": [{
      "type": "choice", "name": "department",
      "instructions": "Quelle équipe doit traiter cette demande ?",
      "choices": [
        {"value":"billing","description":"Facturations et remboursements"},
        {"value":"technical","description":"Erreurs produit"},
        {"value":"other","description":"Autres demandes"}
      ]
    }]
  }'
Comment utiliser l’API Jev
La requête cURL suivante utilise le point de terminaison System One de Jev (https://docs.typesafe.ai/api) pour classer un ticket d’assistance. Définissez TYPESAFE_API_KEY dans votre environnement, placez le ticket dans state et définissez department dans l’objet questions. Sa carte criteria liste les libellés de routage autorisés et leurs descriptions. Après la réussite de la requête, lisez l’entrée department dans answers et validez le libellé sélectionné avant de router le ticket. Confirmez que l’identifiant du modèle est disponible pour votre compte.
Router un ticket d’assistance avec TypeSafe Jev.
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "J’ai été facturé deux fois pour ma commande.",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Quelle équipe doit traiter cette demande ?",
        "criteria": {
          "billing":"Facturations et remboursements",
          "technical":"Erreurs produit",
          "other":"Autres demandes"
        }
      }
    }
  }'
| Élément d’intégration | OpenAI | Jev |
|---|---|---|
| Entrée | input | state |
| Questions | Tableau | Objet indexé par clé |
| ID de la question | name | Clé d’objet |
| Question binaire | predicate | noul |
| Choix | choices | criteria |
| Forme de la réponse | answers array | answers object |
Politique de revue partagée pour les probabilités de classe sélectionnée
Appliquez un seuil explicitement calibré à une probabilité de classe sélectionnée.
from dataclasses import dataclass
from math import isfinite

@dataclass
class NormalizedDecision:
    label: str | None
    selected_probability: float | None
    provider: str
    needs_review: bool

def apply_review_policy(label, selected_probability, provider, threshold):
    if not isfinite(threshold) or not 0.0 <= threshold <= 1.0:
        raise ValueError("le seuil doit être compris entre 0 et 1")
    valid_probability = (
        selected_probability is not None
        and isfinite(selected_probability)
        and 0.0 <= selected_probability <= 1.0
    )
    return NormalizedDecision(
        label=label,
        selected_probability=selected_probability,
        provider=provider,
        needs_review=(
            not label
            or not valid_probability
            or selected_probability < threshold
        ),
    )
Cet exemple Python 3.10+ est une couche de politique d’application, pas un parseur de réponse d’API. Chaque adaptateur fournisseur doit valider la réponse et extraire la probabilité de la classe sélectionnée. Ne passez pas le champ confidence brut de Jev comme selected_probability. Fournissez un seuil calibré pour ce fournisseur, cette question et ce jeu d’évaluation ; gérez les refus et erreurs de transport avant d’appeler la politique.
OpenAI Decisions API vs Jev : comment choisir
Procédez en deux étapes. D’abord, filtrez selon les exigences de déploiement : entrée image, accès au compte, limites d’entrée et effort d’intégration. Ensuite, évaluez les services éligibles sur la même charge annotée. Pour le routage texte seul, testez si le prix d’entrée publié plus bas de Jev se traduit par un coût total inférieur ; pour les décisions dépendant d’images, évaluez la voie image native d’OpenAI. Comparez les mauvais routages, la calibration, la latence en queue, les réessais et la revue humaine à un objectif de qualité convenu. Le tableau ci-dessous est une liste restreinte de départ, pas la preuve d’un vainqueur global en performance.
| Cas d’usage | OpenAI Decisions API | Jev | Recommandation pratique |
|---|---|---|---|
| Routage d’assistance | Pris en charge | Pris en charge | Évaluer d’abord Jev pour le coût |
| Catégorisation texte | Pris en charge | Pris en charge | Comparer la calibration |
| Inspection de captures d’écran | Natif | Prétraitement vision requis | OpenAI |
| Sélection d’outil d’agent | Pris en charge | Pris en charge | Mesurer les résultats de bout en bout |
| Modération multimodale | Texte et images | Texte uniquement | OpenAI |
| Écosystème OpenAI existant | Natif | Nouvelle intégration | OpenAI |
Pour l’automatisation métier à grand volume, comme le routage d’assistance et la classification texte, Jev mérite d’être priorisé lorsque le coût d’entrée et le débit sont des préoccupations clés. Pour les applications multimodales, incluant l’inspection de captures d’écran, la modération visuelle et les décisions basées sur l’image, OpenAI Decisions API est l’option la plus pratique grâce à sa prise en charge native des images. Pour les agents IA et les flux d’entreprise, le choix dépend de l’infrastructure existante, de la complexité d’intégration et des conséquences des décisions incorrectes. OpenAI peut offrir une voie plus fluide pour les équipes déjà dans son écosystème, tandis que Jev mérite considération pour les charges massives et textuelles. Dans tous les cas, la décision finale doit se baser sur la précision mesurée, la calibration des probabilités, la latence et le coût opérationnel total plutôt que sur les seuls tarifs affichés.
Comment devez-vous évaluer OpenAI Decisions API face à Jev ?
Exécutez les deux services sur les mêmes entrées réelles annotées, avec des définitions de question appariées et des régions clientes identiques. Suivez la précision, le F1 macro, l’ECE, le score de Brier, la latence p50/p95/p99, les délais, les refus, le taux de revue et le coût en dollars par décision correcte acceptée.
| Dimension | Mesures recommandées | Pourquoi c’est important |
|---|---|---|
| Classification | Précision, rappel, précision, F1 macro | Qualité des libellés |
| Calibration | ECE, score de Brier | Fiabilité des probabilités |
| Latence | p50 / p95 / p99 | Réactivité opérationnelle |
| Fiabilité | Taux 429 / délais / refus | Comportement en production |
| Économie | Coût par décision correcte acceptée | Dépense opérationnelle réelle |
Procédure suggérée : constituez un ensemble représentatif annoté ; incluez des cas ambigus et hors distribution ; envoyez des tâches sémantiquement identiques ; répétez suffisamment les requêtes pour mesurer la variance ; calibrez indépendamment les seuils de chaque système ; comparez le coût de bout en bout incluant escalade et réessais.
Conclusion
Choisissez OpenAI Decisions API lorsque la décision dépend de preuves visuelles ou lorsqu’une intégration OpenAI existante réduit l’effort de déploiement. Évaluez Jev pour des charges décisionnelles texte uniquement, où son tarif publié par jeton d’entrée plus bas peut réduire la dépense d’inférence. Mesurez la qualité des libellés, la calibration, la latence en queue et la charge de revue sur les mêmes données d’application avant de trancher.
Jev affiche le tarif d’entrée de base publié le plus bas ; OpenAI Decisions API gère nativement l’entrée image. Les chiffres des fournisseurs cités n’établissent pas de vainqueur global en précision ou en vitesse. Le meilleur choix dépend du coût et de la qualité des décisions acceptées dans le flux complet.
Les développeurs peuvent utiliser la GPT-6 Luna API dans CometAPI (https://www.cometapi.com/models/openai/gpt-6-luna/) pour prototyper une classification légère au sein d’un flux multi-modèles plus large. La page du modèle liée fournit un exemple Responses API. L’accès à ce point de terminaison génératif n’établit pas la prise en charge du point de terminaison dédié /v1/decisions. Il s’agit d’un prototype de génération de texte conventionnel. Il ne renvoie pas le schéma de réponses natif de Decisions ni une distribution de probabilité de classe calibrée. Validez le libellé renvoyé par rapport aux catégories autorisées et traitez les erreurs d’API avant de le connecter à des actions en aval. Confirmez séparément la prise en charge native de /v1/decisions si ce point de terminaison est requis.