Choisissez votre plan
Blog Qwen3
Comment déployer Qwen 3.8 Max en local : guide du matériel, de vLLM, de SGLang et de la quantification
Objectif Déployer localement Qwen 3.8 Max (poids ouverts Qwen3.8-2.4T-A95B) avec prise en charge GPU, quantification FP8/FP4, moteurs vLLM et SGLang, contexte 1M, et bonnes pratiques de production. 1) Prérequis matériels et logiciels - OS et runtime - Linux x86_64 (Ubuntu 20.04/22.04 recommandé) - Python 3.10+ (virtualenv/conda conseillé) - CUDA 12.x et cuDNN compatibles, pilote NVIDIA récent (>= 535) - NCCL et UCX récents pour parallélisme multi-GPU/multi-nœuds - GPU - Cartes recommandées: NVIDIA A100 80GB, H100 80GB/94GB, ou L40S 48GB (selon quantification) - Interconnexions rapides: NVLink/NVSwitch pour intra-nœud, InfiniBand (EFA/IB) pour inter-nœuds - Mémoire modèle (ordre de grandeur pour un ~95B) - FP16/BF16 poids: ≈ 2 octets/paramètre → ~190 Go pour les poids seuls - FP8 poids: ≈ 1 octet/paramètre → ~95 Go - 4 bits (AWQ/GPTQ): ≈ 0,5 octet/paramètre → ~47,5 Go - Remarque KV cache: la mémoire du cache KV domine avec de très longues séquences; à 1M de tokens, même en FP8 KV, l’empreinte dépasse très largement un seul GPU. Prévoyez du sharding multi-GPU, éventuellement multi-nœuds, et du offloading CPU/host. 2) Téléchargement des poids - Via Hugging Face (adapter le repo exact aux poids ouverts Qwen3.8-2.4T-A95B) - huggingface-cli download Qwen/Qwen3.8-2.4T-A95B --local-dir /models/qwen38max - Vérifiez la présence des fichiers de config (config.json, tokenizer, safetensors) et, si vous ciblez 4 bits, un repo quantifié AWQ/GPTQ distinct ou quantifiez en local. 3) Choix du moteur de service - vLLM - Points forts: forte efficacité batch/paged attention, scheduler performant, intégration OpenAI compatible, KV cache quantifiable. - Parallélisme: support du tensor parallel (TP) intra-nœud; pipeline parallel limité. - SGLang - Points forts: pipeline orienté très long contexte et pré-remplissage, intégration FlashAttention/FlashInfer, KV quantisation, scheduling favorisant le streaming de contextes longs. 4) Quantification et précisions - Poids FP8 - Requiert des checkpoints FP8 ou une conversion prise en charge. On ne peut pas « activer » FP8 poids sans un checkpoint/format compatible. Vérifiez la disponibilité des poids FP8 du modèle. - Poids 4 bits (FP4/INT4) - Option standard: AWQ ou GPTQ. Pré-quantifier avec AutoAWQ ou utiliser un repo déjà quantifié. - AWQ réduit fortement l’empreinte VRAM des poids et facilite un déploiement sur 1×80GB ou 2×48GB (hors KV). - KV cache - vLLM et SGLang supportent des dtypes KV compressés (ex.: fp8). FP4/int4 KV peut être disponible selon le moteur et la build (FlashInfer), sinon rester en fp8/bf16. - Le KV cache croît avec la longueur de séquence; à 1M, utilisez kv-quantization et pagination. 5) Déploiement avec vLLM (exemples) - Installation - pip install -U vllm transformers accelerate bitsandbytes autoawq flash-attn - Assurez la compatibilité CUDA/FlashAttention. - Service en poids d’origine (BF16/FP16) avec KV en FP8, 1M contexte, 4×GPU - vllm serve /models/qwen38max --host 0.0.0.0 --port 8000 --tensor-parallel-size 4 --max-model-len 1048576 --kv-cache-dtype fp8 --gpu-memory-utilization 0.90 --swap-space 64 - Ajustez --tensor-parallel-size selon le nombre de GPUs. --swap-space en Go pour le paged attention hors GPU. - Service avec poids AWQ 4 bits (répertoire quantifié) - vllm serve /models/qwen38max-awq --quantization awq --host 0.0.0.0 --port 8000 --tensor-parallel-size 2 --max-model-len 1048576 --kv-cache-dtype fp8 --gpu-memory-utilization 0.95 --swap-space 96 - Paramètres utiles vLLM - --max-num-seqs: limiter/conduire la concurrence - --block-size: taille de bloc du paged attention (ex.: 16/128) pour réduire la fragmentation - --enable-chunked-prefill: pipeline de pré-remplissage plus stable pour contextes longs - --distributed-executor-backend nccl: communication GPU - --revision pour épingler une version HF - Appel client (OpenAI-compatible) - export OPENAI_BASE_URL=http://localhost:8000/v1 - Utilisez une bibliothèque OpenAI-compatible et définissez le modèle via son chemin. 6) Déploiement avec SGLang (exemples) - Installation - pip install -U sglang flash-attn autoawq - Service en poids d’origine avec KV en FP8, 1M contexte, 4×GPU - python -m sglang.launcher --model-path /models/qwen38max --tp 4 --max-seq-len 1048576 --kv-quantization fp8 --host 0.0.0.0 --port 30000 - Service avec poids AWQ 4 bits - python -m sglang.launcher --model-path /models/qwen38max-awq --tp 2 --max-seq-len 1048576 --kv-quantization fp8 --host 0.0.0.0 --port 30000 --quantization awq - Paramètres utiles SGLang - --enable-chunked-prefill ou options analogues pour le streaming - --max-num-batched-tokens pour contrôler la latence vs débit - --pipeline configs pour long context et scheduling 7) 1M de contexte: considérations critiques - Prérequis - Utiliser une variante/poids explicitement entraînés ou calibrés pour long contexte (1M). Sinon, appliquer un RoPE scaling correct (rope_base, rope_scale) et vérifier la compatibilité. - Mémoire KV - Mémoire KV ≈ L × N_layers × 2 × hidden_size × bytes_per_element × facteur (K+V). À L=1 000 000 tokens, c’est extrêmement volumineux. Même en fp8 KV, planifiez multi-GPU et offloading. - Techniques pour rendre cela praticable - KV cache quantisé (fp8) et paged attention avec block size optimisée - Chunked prefill, streaming, et limitation du window d’attention effectif si l’architecture le permet (ex.: attention glissante/sparse si disponible) - Prompt caching/re-use; éviter de reconstruire le KV pour les prompts récurrents - RAG et indexation: pousser les documents vers un système de recherche et n’injecter que les passages pertinents - Si possible, modèles à MQA/GQA réduisant l’empreinte KV 8) Exigences GPU typiques par configuration (ordre de grandeur) - FP16/BF16 poids, sans KV massif - 190 Go pour les poids → 3×80GB minimum (peu de marge), 4×80GB conseillé; avec KV, 8×80GB ou plus selon débit et longueur - FP8 poids - ~95 Go → 2×80GB minimum pour les poids; ajoutez de la marge pour KV; souvent 4×80GB - 4 bits (AWQ) - ~47,5 Go → 1×80GB possible pour les poids, mais KV pour 1M dépasse un seul GPU; vous devrez shard/offload - Multi-nœuds - Prévoir NCCL/IB, topologie homogène, et partitionnement TP cohérent 9) Optimisations de production - Scheduling et QoS - Définir des SLA par file/queue, séparer les workloads (long context vs court) pour éviter l’inversion de priorité - Limiter max_tokens_output et max_input_tokens par route - Paramétrage moteur - vLLM: tuner --block-size, --max-num-seqs, --gpu-memory-utilization; activer chunked prefill - SGLang: ajuster max-seq-len, batch tokens, policies de scheduling - Kernels et libs - FlashAttention 2/Flash-Decoding à jour; builds correspondantes à votre CUDA - Activer FP8 KV si stable sur votre stack; sinon BF16 KV pour fiabilité - Mémoire et offloading - Pinned memory pour swap CPU; SSD NVMe rapide; surveiller la fragmentation du paged attention - Sur multi-nœuds, minimiser les allers-retours host via NVLink/IB - Observabilité - Export métriques (latence préfill/decoding, taux de fragmentation KV, OOM, throughput tok/s) - Traces par requêtes, journaux d’erreurs CUDA - Robustesse - Warmup, chargement lazy des poids, redémarrage sans interruption (systemd, supervisor) - Health checks, timeouts, retries, backpressure - Sécurité et gouvernance - Contrôles d’accès, limitation de débit, chiffrement en transit, isolation des environnements 10) Validation et tests - Tests unitaires sur des prompts courts, puis scaling vers 128k, 256k, etc., avant 1M - Mesure mémoire: VRAM par GPU, mémoire host, taille KV par requête - Test de charge: throughput, latence P50/P95/P99, stabilité sur longue durée - Fallbacks: switch automatique vers un moteur plus petit pour requests hors budget Notes importantes - FP8 poids requiert un checkpoint FP8; sans cela, préférez 4 bits AWQ pour réduire l’empreinte. - 1M de contexte sur un modèle ~95B n’est réaliste que via sharding massif, KV quantisé, paged attention et stratégies d’injection de contexte (RAG, streaming). Ne pas tenter un 1M full-KV purement GPU sur un seul nœud. - Choisissez vLLM si vous ciblez un débit élevé multi-clients; SGLang est très efficace pour du très long contexte avec pré-remplissage streamé. Dans beaucoup de déploiements, on teste les deux et on retient celui qui tient le mieux vos SLA. Checklist rapide - Pilote/CUDA/FA2 cohérents et testés - Poids disponibles (BF16/FP8/AWQ) et tokenizer vérifié - KV cache en fp8 et paged attention activés - TP configuré selon vos GPUs; NCCL opérationnel - --max-model-len à 1048576 et tests progressifs avant production - Observabilité et limites de ressources en place
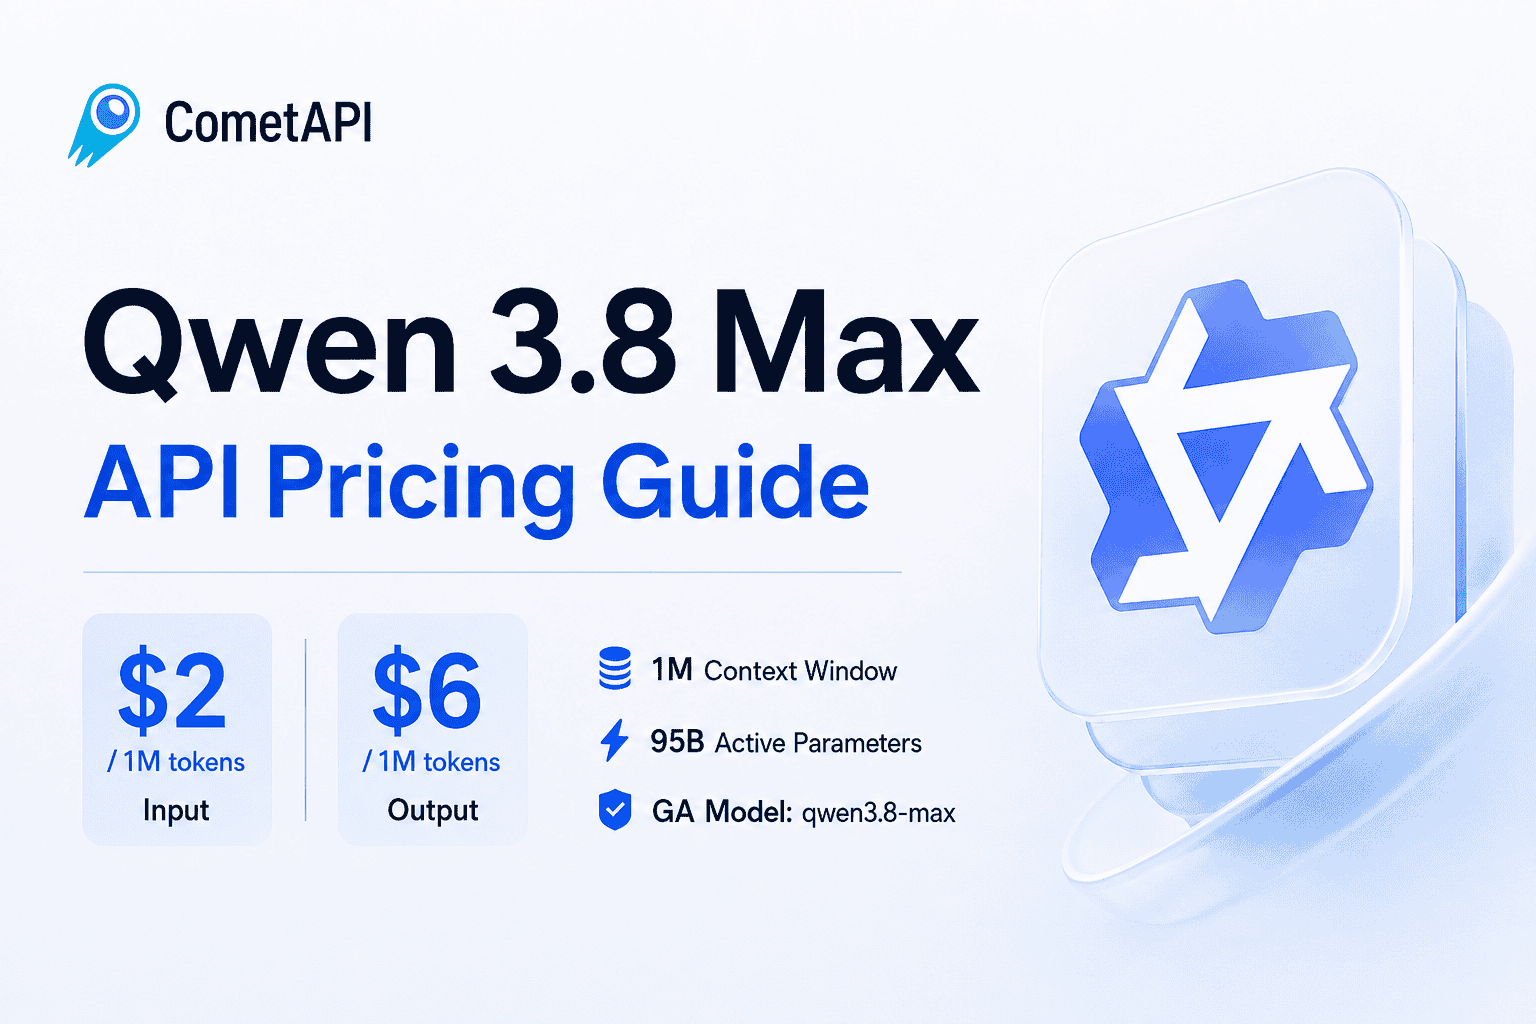
Tarification de l'API Qwen 3.8 Max : $2 en entrée, $6 en sortie, contexte de 1M
Qwen 3.8 Max coûte 2 $/M en entrée et 6 $/M en sortie. Comparez les frais de cache, les coûts des outils, des exemples concrets, les limites, ainsi que les conseils de migration depuis Qwen 3.7.
Comment utiliser l'API Qwen 3.5
À la veille du Nouvel An lunaire (16–17 février 2026), Alibaba Group a publié son modèle de nouvelle génération, Qwen 3.5 — un modèle multimodal, doté de capacités d’agent, positionné pour ce que l’entreprise appelle une ère d’« IA agentique ». La couverture sectorielle a mis en avant des affirmations de forts gains d’efficacité et de réduction des coûts, ainsi qu’un soutien rapide de la part des fournisseurs de matériel et de cloud. CometAPI est une option pour les développeurs qui souhaitent un accès à une API hébergée ou une intégration compatible avec OpenAI, tandis qu’AMD a annoncé une prise en charge GPU Day‑0 pour le modèle sur sa gamme Instinct. ByteDance fait partie des principaux concurrents nationaux qui ont publié des mises à jour autour de la même période de fêtes. OpenAI demeure un point de référence pour les comparaisons en matière de benchmarks et de style d’intégration.
Qwen-3.5 pour le Nouvel An lunaire — surpasse-t-il l’élite des modèles à code source fermé en 2026 ?
Qwen3.5 d’Alibaba représente une avancée majeure — il réduit l’écart avec certains modèles propriétaires de pointe et, sur certaines charges de travail agentiques/multimodales, revendique une parité, voire un avantage, sur un certain nombre de benchmarks publics et de tests internes. Cependant, “surclasser” dépend de la charge de travail : sur l’utilisation d’outils par des agents, la compréhension multimodale de documents/vidéos et le coût par inférence, Qwen3.5 serait extrêmement compétitif (et, dans certains graphiques de fournisseurs, en tête). Conclusion pratique : Qwen3.5 apparaît comme un véritable concurrent de pointe début 2026 — pour de nombreux cas d’usage d’entreprise agentiques et multimodaux, il est désormais viable comme option principale.
Comment utiliser Qwen3-max thinking ?
Qwen3-Max-Thinking d’Alibaba — la variante « thinking » de la vaste famille Qwen3 — est devenue l’un des sujets phares de l’IA cette année : un modèle phare à plus d’un billion de paramètres, optimisé pour le raisonnement profond, la compréhension de longs contextes et des flux de travail pilotés par des agents. En bref, c’est l’initiative du fournisseur pour offrir aux applications un mode de pensée « System-2 » plus lent et plus traçable : le modèle ne se contente pas de répondre ; il peut montrer (et utiliser) des étapes, des outils et des vérifications intermédiaires de manière contrôlée.

Alibaba AI dévoile Qwen3-Max : un modèle Qwen à mille milliards de paramètres, compatible avec CometAPI
L'équipe Qwen d'Alibaba a publié Qwen3-Max-Preview (Instruct) — le plus grand modèle de l'entreprise à ce jour, avec plus de 1 XNUMX milliards de paramètres — et l'a rendu
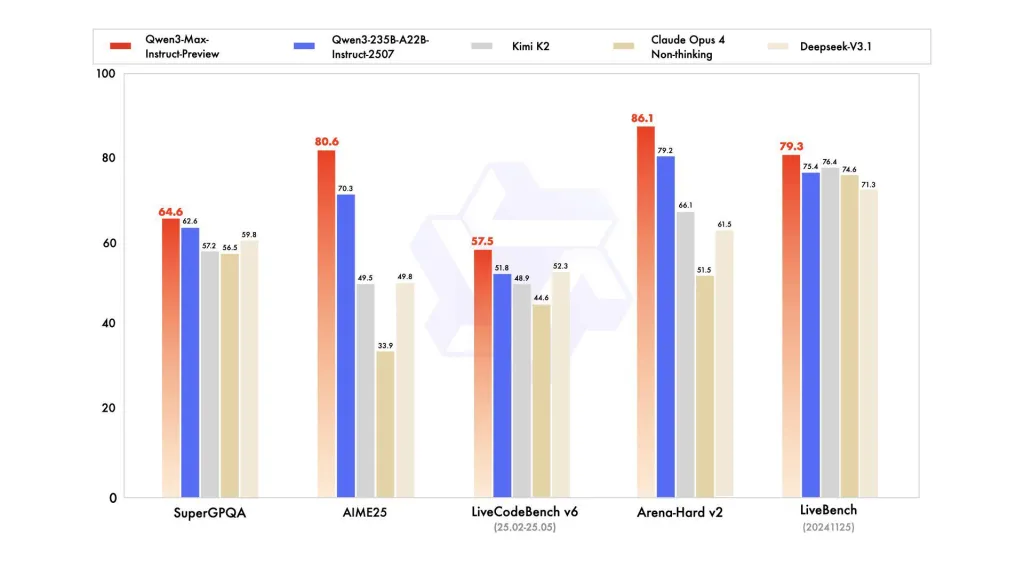
API Qwen3-Max-Preview
Qwen3-Max-Preview est le dernier modèle phare d'Alibaba au sein de la famille Qwen3. Il s'agit d'un modèle de type « Mixture-of-Experts » (MoE) à plus d'un billion de paramètres, avec une fenêtre contextuelle ultra-longue de 262 XNUMX jetons, disponible en préversion pour une utilisation en entreprise et dans le cloud. Il cible le raisonnement approfondi, la compréhension de documents longs, le codage et les workflows agentiques.

Qwen3-Coder : performances, architecture et accès
La dernière avancée d'Alibaba en matière d'intelligence artificielle, Qwen3-Coder, marque une étape importante dans le paysage en évolution rapide des logiciels basés sur l'IA.