
TL;DR
Claude Haiku 5.5 e GPT-6 Luna sono modelli di ragionamento a basso costo per carichi API ad alto volume. Entrambi partono da $0.10 per milione di token di input e $0.50 per milione di token di output. Haiku ottiene punteggi più alti nelle sei comparazioni pubblicate nei materiali di lancio di Anthropic. Luna mantiene le tariffe base dei token per prompt fino a 272K token di input, rispetto alla soglia di 100K di Haiku. Per gli sviluppatori, le metriche chiave sono tasso di accettazione, latenza end-to-end, compatibilità API e costo per risultato accettato—il costo totale di tutti i tentativi diviso per il numero di output che superano i controlli predefiniti.
Key Takeaways
- Haiku 5.5 guida il confronto OSWorld 2.1 sull’uso del computer citato, 72,4% contro il 48,9% di Luna.
- Su Terminal-Bench 4.0, i risultati citati sono 39,2% per Haiku e 16,4% per Luna.
- Entrambi partono con prezzi identici per contesto breve, ma il livello di prezzo più alto di Haiku inizia oltre 100K token di prompt, rispetto alla soglia di 272K di Luna.
- Le pagine dei modelli max-effort di Artificial Analysis, verificate il 9 ottobre 2026, mostrano velocità di output di 240,6 token/s per Haiku e 123,0 token/s per Luna; la velocità esclude il tempo di attesa del primo token.
- Iniziate con Haiku per i compiti di uso del computer e terminale riflessi nei benchmark condivisi; considerate Luna per prompt di grandi dimensioni. Mantenete il modello attuale finché un pilot rappresentativo non dimostri un miglioramento utile.
What Are Claude Haiku 5.5 and GPT-6 Luna?
Claude Haiku 5.5: Overview
Claude Haiku 5.5 è stato lanciato il 7 ottobre 2026. Combina inferenza a basso prezzo con ragionamento regolabile, uso di strumenti, contesto lungo e input di testo e immagini. Le applicazioni tipiche includono estrazione di documenti, query su database, assistenza clienti e sub-agent leggeri.
GPT-6 Luna: Overview
GPT-6 Luna è stato lanciato il 22 settembre 2026. È posizionato per compiti mirati su larga scala, tra cui classificazione, estrazione di informazioni, output strutturato, assistenza alla programmazione ed elaborazione di documenti lunghi. Le sue impostazioni di ragionamento flessibili includono una configurazione senza ragionamento per lavori più semplici.
Specifications
| Specification | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Developer | Anthropic | OpenAI |
| Release | October 7, 2026 | September 22, 2026 |
| Model ID | claude-haiku-5-5 | gpt-6-luna |
| Context window | 1,000,000 tokens | 1,050,000 tokens |
| Maximum output (standard API) | 128,000 tokens | 128,000 tokens |
| Input | Text and image | Text and image |
| Output | Text | Text |
| Reasoning | Adjustable, Low to Max | None to Max |
| Default effort | Medium | Medium |
| Knowledge cutoff | June 2026 | May 18, 2026 |
| Tool use | Yes | Yes |
| Structured output | Yes | Yes |
| Open weights | No | No |
| Architecture and parameter count | Not specified in the cited official materials | Not specified in the cited official materials |
Le specifiche utilizzano la documentazione standard dei modelli API dei vendor, verificate il 9 ottobre 2026: specifiche API standard di Haiku e specifiche API standard di Luna. Architettura e numero di parametri non sono specificati perché queste fonti non li stabiliscono.
Claude Haiku 5.5 vs GPT-6 Luna: Benchmark Results
| Benchmark | Haiku 5.5 | GPT-6 Luna | Leader |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1,620 | 1,437 | Haiku +183 |
| AA-Briefcase v1.1 (Elo) | 1,578 | 1,336 | Haiku +242 |
| OSWorld 2.1, offline partial score | 72.4% | 48.9% | Haiku +23.5 pp |
| Terminal-Bench 4.0 | 39.2% | 16.4% | Haiku +22.8 pp |
| FrontierCode 1.1 Main | 46.4% | 42.4% | Haiku +4.0 pp |
| Chartography, no tools | 46.4% | 29.1% | Haiku +17.3 pp |
Le sei righe sopra riproducono i risultati di confronto pubblicati da Anthropic al lancio, verificati il 9 ottobre 2026. Sono comparazioni pubblicate da Anthropic, inclusi risultati indipendenti lì riprodotti, piuttosto che nuovi test eseguiti per questo articolo. GDPval-AA e AA-Briefcase sono punteggi Elo; i divari percentuali sono punti percentuali. Queste famiglie di benchmark misurano compiti differenti e non dovrebbero essere mediate in un vincitore universale.
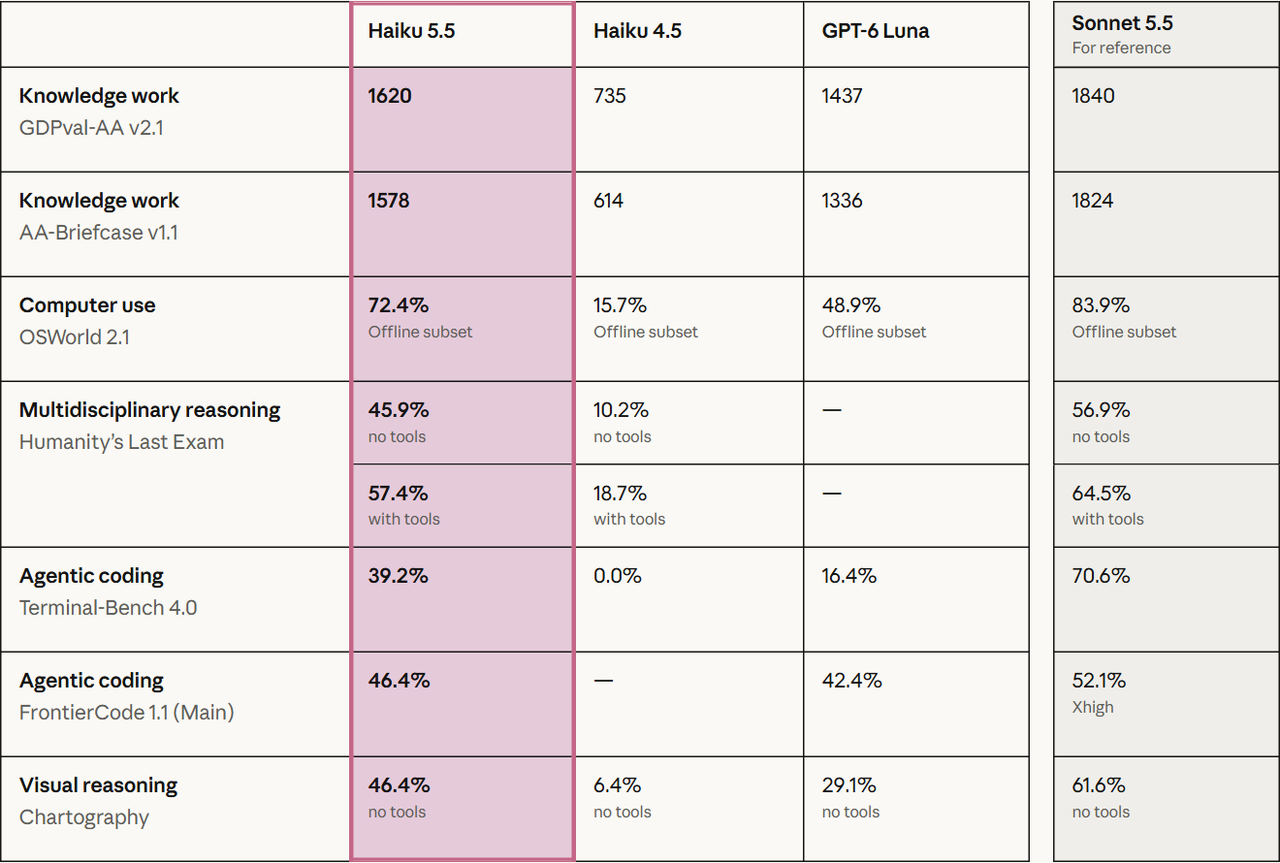
I risultati relativi più forti di Haiku in questa tabella di lancio appaiono nell’interazione visiva col computer e nei compiti basati su terminale. Il suo vantaggio più ridotto in FrontierCode invita a non estrapolare un divario di 20 punti a ogni situazione di coding. Usate questi risultati per selezionare i candidati al pilot, poi convalidate i vostri prompt e lo stack di strumenti.
Reasoning Effort and Evaluation Limits
L’impegno di ragionamento modifica il compromesso accuratezza–costo. Confrontate le impostazioni disponibili usando lo stesso carico di lavoro e lo stesso harness; nomi di impostazioni uguali tra vendor non garantiscono budget di token di ragionamento uguali. La tabella di lancio riporta il sottoinsieme offline di OSWorld e Chartography senza strumenti. Harness, selezione dei compiti, retry e accesso agli strumenti possono cambiare gli esiti. La system card di Anthropic documenta le condizioni specifiche del benchmark. Leggete i metodi dei benchmark nella system card di Anthropic.
- OSWorld utilizza il sottoinsieme offline di 82 compiti, una macchina virtuale Ubuntu, screenshot 1080p, un limite di 500 azioni, sforzo massimo e cinque tentativi per compito. Il confronto 72,4%/48,9% è un punteggio a credito parziale, non la percentuale di compiti completati perfettamente; il tasso di superamento con criterio rigoroso di Haiku è 37,1%. Anthropic ha eseguito Luna sullo stesso sottoinsieme tramite l’API di OpenAI.
- Terminal-Bench utilizza 66 compiti containerizzati; Haiku è stato eseguito al massimo sforzo in Claude Code bare mode, senza uscita verso Internet né modello di fallback, con una media di dieci tentativi per compito.
- FrontierCode Main contiene 100 compiti con cinque esecuzioni per compito; i modelli Claude hanno usato Claude Code e i modelli GPT hanno usato Codex.
- GDPval-AA e AA-Briefcase sono stati valutati indipendentemente da Artificial Analysis e riprodotti nei materiali di lancio. Si tratta di pipeline di valutazione separate, non di un unico harness di produzione condiviso.
Claude Haiku 5.5 vs GPT-6 Luna: Feature Comparison
Computer Use and Agentic Coding
Il vantaggio più forte di Haiku è nei compiti condivisi al lancio che richiedono interazione con un computer grafico o lavoro in un terminale. Il divario di punteggio parziale in OSWorld è di 23,5 punti percentuali, mentre Terminal-Bench differisce di 22,8 punti. La differenza minore di 4,0 punti in FrontierCode mostra perché la categoria più ampia del coding non dovrebbe essere trattata come un singolo carico di lavoro.
Per l’automazione del browser, testate navigazione delle pagine, compilazione di moduli, recupero da errori degli strumenti e completamento end-to-end. Per il coding, verificate se una patch supera i controlli funzionali del vostro repository e rimane entro lo scope. Tali controlli di accettazione sono più utili della scelta di un modello basata sul divario di titolo più grande.
Long Context and Document Processing
La differenza del 5% nella capacità nominale del contesto è meno significativa dell’affidabilità e del prezzo nel processare prompt sostanziali. Nessun modello è intrinsecamente superiore nel recupero di informazioni solo perché la sua finestra di contesto è più grande.
La differenza chiave è quando si applicano tariffe più alte: un prompt da 150K token supera la soglia di Haiku, rimanendo invece nel livello base di Luna. Luna è quindi il punto di partenza a costo inferiore per quel carico di token. Se sia il miglior analista di documenti dipende comunque dall’accuratezza di estrazione, dalle citazioni e dai retry necessari per ottenere una risposta accettabile.
Reasoning Controls
Entrambi i modelli espongono un impegno di ragionamento regolabile, con impostazione predefinita su medium nella documentazione citata. Luna espone anche l’impostazione none. Usate questi controlli in base al compito: estrazione e instradamento possono richiedere meno ragionamento di un workflow incerto a più passaggi con strumenti. La stessa etichetta di sforzo non implica lo stesso budget di calcolo tra vendor.
Multimodal Input and Structured Workflows
Entrambi accettano testo e immagini e producono testo. Ciò li rende candidati per screenshot, estrazione da immagini di documenti e workflow a valle strutturati. Il solo supporto di input non stabilisce un’accuratezza uguale su testo piccolo, grafici o interfacce visive; misurate quei casi separatamente.
Speed and Task Economics
| Independent metric (max effort) | Haiku 5.5 — Artificial Analysis | GPT-6 Luna — Artificial Analysis |
|---|---|---|
| Intelligence Index v4.3.2 | 43 | 38 |
| Output speed | 240.6 tokens/s | 123.0 tokens/s |
| Weighted cost per Intelligence Index task | $0.21 | $0.07 |
Artificial Analysis è l’editore di test indipendenti. La tabella è un’istantanea delle sue pagine dei modelli max-effort verificata il 9 ottobre 2026, anziché prestazioni ufficiali dei vendor. La velocità di output misura i token ricevuti dopo l’inizio della generazione; è distinta dal tempo al primo token e dalla latenza completa del compito. Il costo per task è una metrica ponderata dell’Intelligence Index, non un preventivo per il vostro compito di produzione o un costo per esito riuscito.
La velocità di output istantanea di Haiku è circa 1,96 volte quella di Luna, mentre il costo ponderato per task di valutazione di Luna è più basso. Questo non stabilisce un vantaggio di 1,96 volte nel tempo di completamento del compito. Nei test di produzione registrate separatamente tempo al primo token, tempo di completamento, lunghezza dell’output, consumo di ragionamento e tempo di esecuzione degli strumenti.
Claude Haiku 5.5 vs GPT-6 Luna: Pricing and API Access
Official Standard Rates
| USD per 1M tokens | Haiku ≤100K | Haiku >100K | Luna ≤272K | Luna >272K |
|---|---|---|---|---|
| Input | $0.10 | $0.50 | $0.10 | $0.20 |
| Cached read | $0.01 | $0.05 | $0.01 | $0.02 |
| Cache write (Haiku: 5-minute TTL) | $0.125 | $0.625 | $0.125 | $0.25 |
| Output | $0.50 | $2.50 | $0.50 | $0.75 |
USD per milione di token a tariffe standard di elaborazione, verificate il 9 ottobre 2026. La tabella utilizza le tariffe standard e di scrittura cache a 5 minuti di Haiku e le tariffe di Luna per contesto breve e lungo. Sono esclusi costi per strumenti, tasse, maggiorazioni regionali e regolazioni opzionali del livello di elaborazione. Superata la soglia di input, si applicano al request le tariffe più alte relative, non solo ai token in eccesso.
La distinzione centrale è la soglia di fatturazione. Haiku passa a tariffe più alte oltre i 100K token di prompt, mentre Luna mantiene il livello basso fino a 272K. Anche sopra tale soglia, i prezzi citati di Luna per input e output in contesto lungo sono inferiori.
Haiku offre anche scritture di cache a 1 ora a $0.20/$1.00 per milione di token per prompt brevi/lunghi. Persistenza della cache e meccanismi di prezzo differiscono tra i vendor, quindi confrontate i pattern di riutilizzo invece di trattare entrambe le righe di scrittura cache come prodotti identici. Il limite di output di 128K di Haiku è il limite dell’API standard; la sua Message Batches API può supportare 300K di output con un’intestazione beta.
Illustrative Costs at Fixed Token Budgets
| Workload | Input / Output | Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Ticket classification | 2K / 200 | $0.0003 | $0.0003 |
| Short report | 40K / 4K | $0.006 | $0.006 |
| Repository analysis | 150K / 5K | $0.0875 | $0.0175 |
| Large document review | 300K / 10K | $0.175 | $0.0675 |
| Massive context analysis | 800K / 20K | $0.45 | $0.175 |
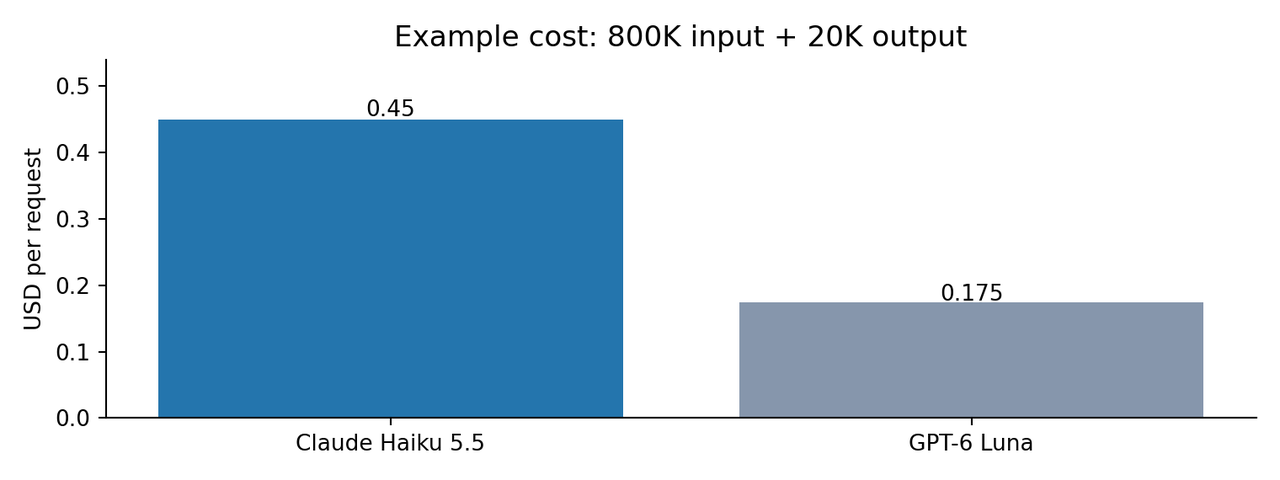
Stima a tariffa standard non in cache calcolata dall’autore: costo = token di input × tariffa di input / 1,000,000 + token di output fatturati × tariffa di output / 1,000,000. “Output” significa output totale fatturato per questa stima, inclusi i token di ragionamento quando addebitati come output; non è necessariamente la lunghezza della risposta visibile. Per entrambi i modelli si usano gli stessi conteggi di token riportati, sebbene i tokenizzatori possano differire.
Un token economico non equivale necessariamente a un esito riuscito economico. I team dovrebbero considerare tentativi ripetuti, chiamate di strumenti fallite, consumo di token di ragionamento e comportamento di tokenizzazione diverso.
CometAPI Access and Integration Constraints
CometAPI fornisce opzioni di accesso per entrambi i modelli. Prima di confrontarli o distribuirli tramite il gateway, verificate gli ID dei modelli, gli endpoint supportati, i parametri della richiesta, il comportamento degli strumenti e le regole di fatturazione per ciascun instradamento. Questi link del provider documentano le opzioni di accesso; non sostituiscono le fonti tecniche o di prezzo standard dei vendor.
Per integrazioni OpenAI dirette, Luna supporta strumenti integrati tramite la Responses API; il function calling di Chat Completions richiede il livello di ragionamento none. Haiku utilizza la Messages API di Anthropic e adaptive thinking. Un gateway non rende intercambiabili gli schemi sottostanti: convalidate definizioni degli strumenti, comportamento dell’output strutturato, eventi di streaming e contabilizzazione con l’esatto instradamento che intendete usare.
How Can Developers Compare Claude Haiku 5.5 and GPT-6 Luna With the Same Prompt?
Long-Document Extraction Example
Un confronto pratico può usare un pacchetto di contratti con fornitori contenente date di efficacia, termini di rinnovo, periodi di preavviso ed eccezioni. Mantenete identici il pacchetto di documenti, le istruzioni di estrazione, i campi attesi e le regole di validazione. Quanto segue è un design di valutazione, non un nuovo risultato misurato sui modelli.
Esempio di prompt: Estrai per ciascun contratto il nome del fornitore, la data di efficacia, la data di rinnovo, il periodo di preavviso di risoluzione e le eccezioni di prezzo. Per ogni valore estratto, cita il titolo del documento e l’esatto passaggio di supporto. Return null quando un campo è assente; non inferire date mancanti. Evidenzia clausole in conflitto e mantieni la risposta finale entro 1.000 parole.
| Check | Acceptance criterion | What to record |
|---|---|---|
| Extraction accuracy | Required fields match an independently checked answer key | Correct, incorrect, and missing values |
| Grounding | Every non-null field has a valid supporting passage | Unsupported claims and wrong document citations |
| Instruction following | No invented dates; absent fields return null | Schema failures and constraint violations |
| Economics | Calculate spend per accepted extraction | Billed input, output, reasoning, retries, and fallback cost |
| Latency | Compare full job completion under the same tool policy | First-token time and end-to-end time |
Eseguite più di un pacchetto rappresentativo e ripetete i casi in cui i risultati variano. Iniziate con lo stesso livello di sforzo disponibile, poi testate una configurazione a costo inferiore per ciascun modello. Riportate dimensione del campione, impostazioni, route, data e numero di fallimenti prima di presentare un vincitore.
Haiku 5.5 or GPT-6 Luna: Which to Choose?
| Dimension | Better-supported starting point | Decision boundary |
|---|---|---|
| GUI interaction | Claude Haiku 5.5 | Shared OSWorld partial scores favor Haiku; verify full task completion |
| Terminal coding | Claude Haiku 5.5 | Shared Terminal-Bench scores favor Haiku; validate repository changes |
| Short prompts and base prices | Test both | Identical base rates; compare billed usage and retries |
| Prompts above 100K tokens | GPT-6 Luna on standard rates | Luna retains the base tier longer; accuracy may alter total cost |
| Streamed token throughput | Claude Haiku 5.5 in the dated snapshot | Throughput differs from full completion latency |
| Simple repeated extraction | Test Luna with low or no reasoning | Select by valid accepted output, rather than price alone |
Choose Claude Haiku 5.5 for Benchmark-Relevant Interactive Tasks
Iniziate con Haiku quando la vostra applicazione assomiglia ai compiti con computer grafico, coding da terminale o lavoro professionale pubblicati, e un tasso di completamento più alto compenserebbe ulteriore spesa di ragionamento o contesto lungo. Confermate tale vantaggio sul vostro stack di strumenti prima di instradare traffico di produzione.
Choose GPT-6 Luna for Large-Prompt Cost Control
Iniziate con Luna quando i prompt superano spesso i 100K token e i costi standard dei token incidono in modo significativo sul budget. È anche un candidato per estrazione ripetuta o instradamento che può riuscire con ragionamento basso o nullo. Mantenete la raccomandazione condizionata ai tassi di risultato accettato e all’uso effettivamente fatturato.
Use Both When Workloads Have Different Needs
Un pilot potrebbe instradare l’estrazione da documenti lunghi a Luna e i compiti GUI o da terminale a Haiku, quindi validare ciascuna scelta rispetto ai controlli di accettazione. Attivate un fallback quando un output non supera la validazione dello schema, manca di evidenze richieste o non soddisfa un controllo specifico del compito, e includete costi e latenza del fallback nel confronto.
Validate Before Switching
Includete il vostro modello attuale come baseline. Passate solo quando il candidato raggiunge un obiettivo di correttezza predefinito e migliora il costo per risultato accettato o la latenza end-to-end abbastanza da coprire migrazione e manutenzione. Sospendete il rollout se aumentano errori critici degli strumenti. La raccomandazione cambia se il vostro pilot mostra che la tariffa inferiore di Luna è annullata dai retry, o che i punteggi di benchmark più alti di Haiku non migliorano il successo del vostro compito.
- Usate un campione di carico di lavoro rappresentativo e conteggiate risultati corretti, errati e incompleti.
- Misurate latenza al primo token, tempo end-to-end del compito e affidabilità degli strumenti.
- Tracciate separatamente i conteggi di token di input, cache, output e ragionamento.
- Calcolate il costo per risultato riuscito, includendo retry e fallback.
- Confrontate sforzo di ragionamento medium e high prima di abilitare per default le impostazioni massime.
Conclusion
Claude Haiku 5.5 mostra evidenze head-to-head più forti al lancio nei benchmark qui confrontati su lavoro professionale, uso del computer e coding agentico. Ha anche una velocità di output più alta nello snapshot indipendente. GPT-6 Luna ha un chiaro vantaggio a tariffa standard per prompt oltre la soglia di 100K di Haiku e un costo ponderato per task di valutazione inferiore. Nessuna di queste osservazioni, da sola, determina l’affidabilità in produzione o il costo per risultato riuscito.
Il vincitore pratico è il modello che fornisce un risultato accettabile al costo operativo pienamente misurato più basso. Eseguite entrambi sui vostri prompt, strumenti e regole di retry invece di trattare un singolo benchmark come risposta.
FAQ
Why can task costs differ when both models have the same base token prices?
Lo stesso prezzo base non significa la stessa bolletta totale. I modelli possono usare quantità diverse di token di input, output e ragionamento, e possono richiedere numeri diversi di retry o chiamate agli strumenti per produrre un risultato accettabile. Anche le tariffe per contesto lungo e l’uso della cache incidono sul totale. Confrontate il costo totale di tutti i tentativi diviso per il numero di risultati accettati, non solo i prezzi dei token.
Do higher long-context rates apply only to tokens above the threshold?
No. Secondo la tariffazione standard descritta in questo articolo, superare la soglia di input applica le tariffe più alte al request, non solo ai token in eccesso. Ad esempio, una richiesta da 150K token di input supera la soglia di 100K di Haiku ma rimane nel livello base di 272K di Luna. Usate le tariffe di input e output applicabili per l’intera richiesta quando stimate il costo.
Can Claude Haiku 5.5 and GPT-6 Luna share a prompt cache?
Non presumete che le voci di cache siano trasferibili tra modelli o provider. Progettate strategie di riuso separate, poi misurate i tassi di hit e l’uso fatturato su ciascun instradamento. Supporto del gateway, regole di conservazione e struttura della richiesta possono influire sull’idoneità al caching di input ripetuti; verificate questi aspetti prima di prevedere risparmi.
What should a Haiku-to-Luna migration test cover?
Testate input rappresentativi di testo e immagini, campi strutturati richiesti, argomenti degli strumenti, risposte in streaming e recupero dagli errori. Stabilite il tasso di accettazione del vostro sistema attuale prima della migrazione, poi confrontate entrambi i candidati con le stesse politiche di retry e strumenti. Prezzi dei token simili o categorie di modelli simili non stabiliscono compatibilità.
Should benchmark scores drive a Haiku or Luna fallback?
Usate i punteggi per scegliere i candidati, poi attivate i fallback su fallimenti osservati come argomenti di strumenti non validi, campi richiesti mancanti o controlli di compito non soddisfatti. Tracciate la frequenza dei fallback e il costo totale fatturato. Un secondo modello può aggiungere latenza e spesa, quindi verificate che migliori i risultati accettati invece di produrre semplicemente una seconda risposta.
Can sensitive data be routed through both APIs?
Esaminate gli esatti vendor e il gateway coinvolti, le loro impostazioni di conservazione correnti, i luoghi di elaborazione, i termini contrattuali e la policy dati della vostra organizzazione prima di instradare input sensibili. Capacità del modello e tabelle di prezzo non stabiliscono l’idoneità di un percorso per dati regolamentati o riservati. Usate il percorso approvato quando tali requisiti sono decisivi.