
TL;DR
DeepSeek V4 Pro e V4.1 Flash sono offerte API attive separate, con prezzi differenti. La tabella ufficiale Modelli e Prezzi identifica deepseek-v4-pro come DeepSeek-V4-Pro-0813 e deepseek-flash come DeepSeek-V4.1-Flash. L’aggiornamento del 10 settembre afferma che il servizio API V4 Pro continuerà dopo il 14 settembre con metodo di fatturazione invariato. L’affermazione precedente secondo cui le richieste V4 Pro sono instradate verso Flash e fatturate alle tariffe di Flash non è più supportata dalla documentazione ufficiale attuale.
Punti chiave
- V4.1 Flash costa $0.003/M per input in cache, $0.15/M per input senza cache e $0.60/M per output in fascia fuori picco.
- V4 Pro costa $0.022/M per input in cache, $0.66/M per input senza cache e $1.98/M per output in fascia fuori picco.
- Le tariffe in fascia di picco sono il doppio per entrambi i modelli. Le festività pubbliche cinesi sono fuori picco per l’intera giornata secondo il calendario ufficiale.
- Usa deepseek-flash per V4.1 Flash e deepseek-v4-pro per V4 Pro. Solo i nomi dei modelli V4 Flash ritirati sono descritti come instradamenti di compatibilità verso V4.1 Flash.
Quali sono gli attuali prezzi delle API DeepSeek?
La tabella prezzi attuale di DeepSeek elenca separatamente input in cache, input senza cache e output per ciascun modello e fascia oraria. La tabella seguente riproduce tali tariffe del provider diretto; non descrive i prezzi di terze parti.
| Modello | Fascia oraria | Input in cache | Input senza cache | Output |
|---|---|---|---|---|
| V4.1 Flash | Fuori picco | $0.003/M | $0.15/M | $0.60/M |
| V4.1 Flash | Picco | $0.006/M | $0.30/M | $1.20/M |
| V4 Pro | Fuori picco | $0.022/M | $0.66/M | $1.98/M |
| V4 Pro | Picco | $0.044/M | $1.32/M | $3.96/M |
Le ore di picco sono 01:00–04:00 UTC e 06:00–10:00 UTC, dal lunedì al venerdì, escluse le festività pubbliche cinesi. In ora di Pechino, le finestre feriali sono 09:00–12:00 e 14:00–18:00. I weekend e le festività pubbliche cinesi sono fuori picco per tutta la giornata. Controlla la tabella ufficiale prima di definire il budget, poiché i prezzi possono cambiare.
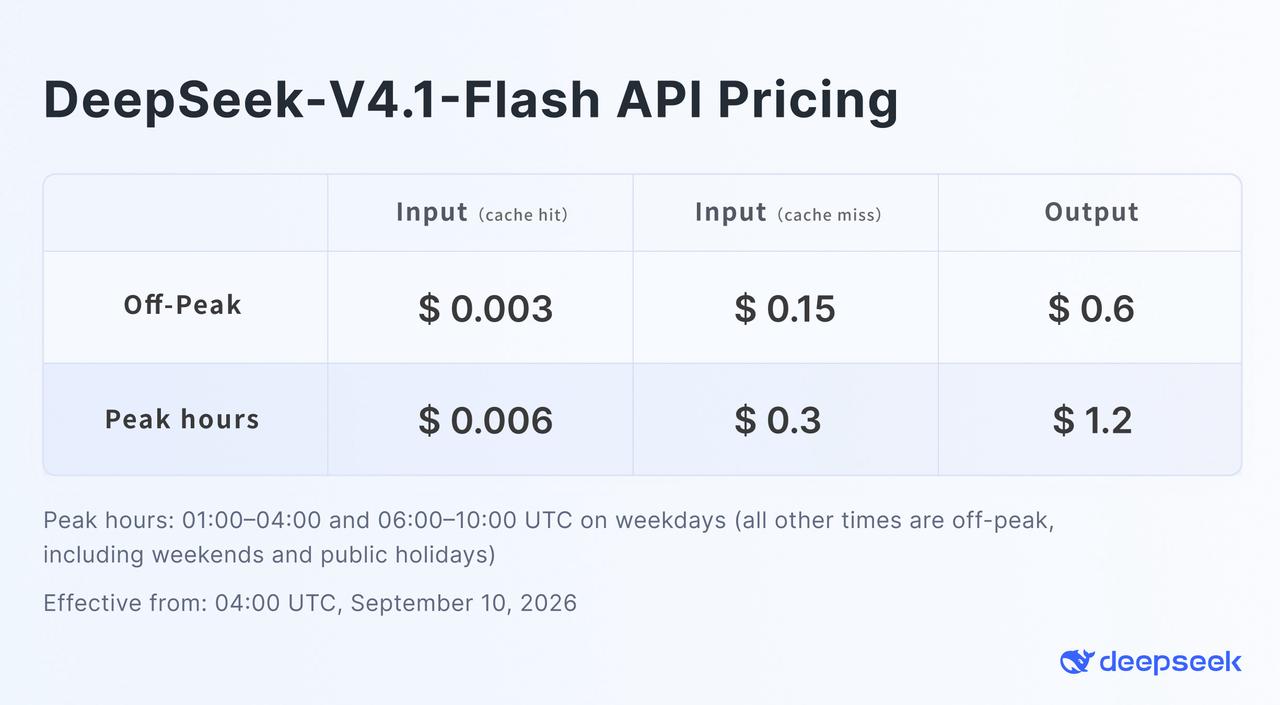
Prezzi ufficiali dell’API DeepSeek V4.1 Flash. Fonte: comunicato di rilascio di DeepSeek.
Quanto costa oggi DeepSeek V4 Pro?
L’aggiornamento di rilascio di DeepSeek afferma esplicitamente che il servizio API V4 Pro continuerà dopo il 14 settembre 2026, con metodo di fatturazione invariato. L’attuale tabella dei modelli elenca deepseek-v4-pro come DeepSeek-V4-Pro-0813, insieme a deepseek-flash come DeepSeek-V4.1-Flash. Pertanto, i due nomi non devono essere trattati come due etichette di prezzo per lo stesso modello servito.
| Nome modello API | Modello elencato da DeepSeek | Fatturazione |
|---|---|---|
| deepseek-flash | DeepSeek-V4.1-Flash | Tariffe V4.1 Flash |
| deepseek-v4-pro | DeepSeek-V4-Pro-0813 | Tariffe V4 Pro |
| deepseek-v4-flash | V4.1 Flash via instradamento compat. | Tariffe V4.1 Flash |
La nota di compatibilità si applica ai nomi ritirati deepseek-v4-flash e deepseek-v4-flash-vision-exp. La nota ufficiale non include deepseek-v4-pro in quel gruppo di instradamento.
Prezzi: DeepSeek V4 Pro vs. V4.1 Flash
| Stato prezzo | Input in cache | Input senza cache | Output |
|---|---|---|---|
| V4 Pro (ex) fuori picco | $0.022/M | $0.66/M | $1.98/M |
| V4.1 Flash fuori picco | $0.003/M | $0.15/M | $0.60/M |
| Instradamento V4 Pro attuale FP | $0.003/M | $0.15/M | $0.60/M |
Per l’input senza cache, l’attuale tariffa fuori picco di V4 Pro a $0.66/M è 4,4 volte quella di Flash a $0.15/M. Per l’output, $1.98/M è 3,3 volte $0.60/M. Flash è circa il 77,3% più economico sull’input senza cache e il 69,7% più economico sull’output in questo confronto diretto con il provider. Queste percentuali confrontano due modelli elencati contemporaneamente; non rappresentano risparmi dovuti a una rotta V4 Pro che passa a Flash.
La tariffa $0.022/M per input in cache di V4 Pro è anch’essa attuale, non solo storica. La tariffa $0.003/M di Flash per input in cache è circa l’86,4% più bassa. La tabella ufficiale mostra anche prezzi separati per i picchi: V4 Pro è a $1.32/M per input senza cache e $3.96/M per output, mentre Flash è a $0.30/M e $1.20/M.
Cosa significano questi prezzi per un carico reale?
Supponiamo che un carico utilizzi 10 milioni di token di input non in cache e 2 milioni di token di output. Alle tariffe attuali del provider diretto:
| Modello | Costo fuori picco | Costo di picco |
|---|---|---|
| deepseek-flash | $2.70 | $5.40 |
| deepseek-v4-pro | $10.56 | $21.12 |
I calcoli fuori picco sono 10 × $0.15 + 2 × $0.60 = $2.70 per Flash, e 10 × $0.66 + 2 × $1.98 = $10.56 per V4 Pro. I totali in fascia di picco raddoppiano secondo le tariffe correnti.
La cache può ridurre ulteriormente il conto attuale. Se l’80% dei 10 milioni di token di input va in cache, il calcolo fuori picco diventa $0.024 per input in cache, $0.30 per input senza cache e $1.20 per output, per un totale di $1.524 su V4.1 Flash. Per la stessa combinazione di token su V4 Pro, il totale è $0.176 + $1.32 + $3.96 = $5.456.
Come è cambiata la disponibilità delle API DeepSeek?
V4.1 Flash è disponibile tramite l’API ufficiale di DeepSeek con il nome modello deepseek-flash. I precedenti modelli V4 Flash e V4 Flash Vision Exp sono stati ritirati, sebbene i loro ID legacy siano temporaneamente accettati e instradati verso V4.1 Flash.
V4 Pro rimane disponibile come deepseek-v4-pro. DeepSeek afferma che il suo metodo di fatturazione rimane invariato e fornirà ulteriore comunicazione in caso di cambiamenti. Non dedurre un ritiro di V4 Pro o una migrazione a Flash dal ritiro dei vecchi nomi V4 Flash.
Il changelog di CometAPI elenca DeepSeek Flash e V4.1 Flash. La sua pagina del modello V4.1 Flash mostra attualmente un prezzo iniziale di $0.12/M token di input, con adeguamenti separati al momento della richiesta. Questo è il prezzo di CometAPI, non la tariffa dell’API diretta di DeepSeek; verifica i termini live del checkout per un carico specifico.
Quanto potrebbe costare DeepSeek V4.1 Pro?
DeepSeek ha confermato un futuro rilascio di V4.1 Pro, ma non ha pubblicato alcun prezzo ufficiale. Qualsiasi cifra precisa presentata oggi sarebbe speculativa. Un metodo di pianificazione più sicuro è modellare diversi premi rispetto al prezzo live di V4.1 Flash.
| Scenario di pianificazione | Input senza cache (fuori picco) | Output (fuori picco) | 10M input + 2M output |
|---|---|---|---|
| 2× Flash | $0.30/M | $1.20/M | $5.40 |
| 3× Flash | $0.45/M | $1.80/M | $8.10 |
| 4× Flash | $0.60/M | $2.40/M | $10.80 |
Questi sono scenari di budgeting, non prezzi trapelati o ufficiali di V4.1 Pro. Presuppongono che DeepSeek mantenga l’attuale struttura picco/fuori picco e applichi un premio 2×–4× rispetto a Flash. L’azienda può scegliere un rapporto diverso, una tariffa di cache diversa, una promozione di lancio o un modello di fatturazione differente.
Il prezzo storico di V4 Pro fornisce un utile riferimento massimo: i suoi $0.66/M per input senza cache e $1.98/M per output erano rispettivamente circa 4,4× e 3,3× sopra le nuove tariffe fuori picco di V4.1 Flash. Ciò rende ragionevole una banda di scenari 2×–4× per il budgeting interno, ma non predice la decisione finale di DeepSeek.
Come dovrebbero i team controllare il costo delle API DeepSeek?
- Scegli il modello previsto. Usa deepseek-flash per V4.1 Flash o deepseek-v4-pro per il modello V4 Pro elencato separatamente.
- Pianifica il lavoro flessibile fuori picco. Le tariffe token in fascia di picco sono il doppio di quelle fuori picco; considera l’eccezione delle festività pubbliche cinesi.
- Conserva i prefissi di prompt riutilizzabili. L’input in cache costa 50× meno dell’input senza cache alle attuali tariffe di Flash.
- Tieni sotto controllo la lunghezza dell’output. L’output rimane la componente più ampia in molti carichi di agenti.
- Verifica la tabella prezzi live. Ricontrolla entrambe le colonne dei modelli e i termini di terze parti prima di confermare un budget di produzione.
FAQ
Quanto costa DeepSeek V4.1 Flash?
Il prezzo ufficiale fuori picco è $0.003/M per input in cache, $0.15/M per input senza cache e $0.60/M per output. Le tariffe di picco sono $0.006/M, $0.30/M e $1.20/M.
V4 Pro è ancora disponibile con il suo prezzo?
Sì. DeepSeek afferma che continuerà il servizio API V4 Pro con fatturazione invariata. La sua tabella prezzi elenca $0.022/M per input in cache, $0.66/M per input senza cache e $1.98/M per output fuori picco; le tariffe di picco sono $0.044/M, $1.32/M e $3.96/M.
V4 Pro e V4.1 Flash hanno attualmente lo stesso prezzo?
No. La tabella ufficiale li elenca come modelli distinti con tariffe API dirette distinte. I vecchi nomi di compatibilità Flash sono instradati verso V4.1 Flash; V4 Pro non è incluso in quella nota.
DeepSeek ha pubblicato un prezzo per V4.1 Pro?
Nessun prezzo per V4.1 Pro appare nell’attuale tabella ufficiale di modelli e prezzi. Non sostituire il prezzo di V4 Pro per un modello futuro non elencato.
Posso usare DeepSeek V4.1 Flash tramite CometAPI?
Sì. CometAPI supporta deepseek-flash e deepseek-v4.1-flash tramite il suo formato Chat API. Il prezzo mostrato e gli adeguamenti temporali sono separati dalla fatturazione dell’API diretta di DeepSeek.
Conclusione
Il confronto centrale è tra due modelli API attivi di DeepSeek. V4.1 Flash parte da $0.15/M per input senza cache e $0.60/M per output fuori picco. V4 Pro rimane elencato a $0.66/M e $1.98/M rispettivamente. Le rotte non condividono un prezzo ufficiale: scegli il modello per le sue capacità, quindi calcola i costi usando le tariffe di cache e di fascia oraria di quel modello.
Prima di pubblicare o pianificare il budget, verifica la tabella prezzi live di DeepSeek e gli aggiornamenti di rilascio. Le offerte di terze parti devono essere verificate sulle loro pagine di pricing.
Metadati SEO
Meta title: Prezzi delle API DeepSeek: V4 Pro vs V4.1 Flash
Meta description: Confronta le tariffe attuali delle API DeepSeek V4 Pro e V4.1 Flash, gli ID modello, i prezzi in picco e fuori picco, i risparmi da cache e i costi per carichi reali.
Keywords: prezzo API DeepSeek, prezzo DeepSeek V4 Pro, prezzo DeepSeek V4.1 Flash, pricing API DeepSeek, V4 Pro vs V4.1 Flash, prezzo DeepSeek V4.1 Pro
URL slug: deepseek-api-price-v4-pro-vs-v4-1-flash