
TL;DR
Google ha annunciato Gemini 4 Argon il 30 settembre 2026 come modello di frontiera per flussi di lavoro complessi e di lunga durata. I risultati pubblicati mostrano un chiaro schema: prestazioni forti nel lavoro professionale basato sulla conoscenza, nei compiti a lungo contesto e in alcune valutazioni di ingegneria del software, con risultati più deboli su alcuni benchmark di terminale e uso del computer. Google sta introducendo il modello con un rollout a fasi. Separatamente, CometAPI riporta la disponibilità a catalogo dal 1 ottobre; prima della distribuzione, è opportuno verificare l’idoneità dell’account e un test di richiesta andato a buon fine. La storia di performance più utile è dove compaiono i guadagni.
Argon ottiene il 68.9% su Vals Index, 65.4% su Vals Finance Agent v2, 77.9% su DeepSWE v1.1, 91.7% su LVBench e 84.2% su GraphWalks a 256K–1M di contesto. Allo stesso tempo, è indietro rispetto ai modelli di frontiera concorrenti su FrontierSWE v2, Terminal-Bench 4.0, Terminal-Bench Science e OSWorld-2.0.
I risultati favoriscono una visione di Argon specifica per carichi di lavoro. I suoi punteggi più forti si concentrano su lavoro professionale basato sulla conoscenza, compiti a contesto molto lungo e selezionate valutazioni multimodali e di ingegneria del software. Altri modelli mantengono vantaggi su diversi test di terminale e uso del computer.
Punti chiave
- Gemini 4 Argon è più forte nel lavoro conoscitivo enterprise, nel ragionamento a lungo contesto, nella comprensione multimodale e in diverse valutazioni di coding a lungo orizzonte.
- Il suo limite massimo di output di 1 milione di token offre più margine di generazione per traiettorie di ragionamento lunghe; non stabilisce una specifica pubblica per il contesto di input.
- Argon guida diversi risultati pubblicati su lavoro conoscitivo e contesti lunghi, ma GPT-6 Astra e Claude Opus 5.5 restano avanti su selezionate valutazioni di coding e uso del computer.
- I punteggi di benchmark descrivono particolari configurazioni di modello e agente. Metriche, condizioni di input e impostazioni di valutazione contano quanto le percentuali di copertina.
- Il rollout di Google e l’accesso tramite CometAPI sono dichiarazioni di disponibilità separate. Verificare route attiva, identificatore del modello e idoneità dell’account prima di migrare traffico.
Che cos’è Gemini 4 Argon?
Gemini 4 Argon è il nuovo modello Gemini di frontiera di Google DeepMind, progettato per flussi di lavoro difficili che richiedono ragionamento su molti passaggi invece di rispondere a un unico prompt breve.
Il posizionamento ufficiale di Google enfatizza l’ingegneria del software nel mondo reale, il lavoro conoscitivo enterprise come legale e finanza, la cybersecurity difensiva, la comprensione multimodale e i compiti agentici di lunga durata.
Questa è una distinzione importante rispetto alle recenti release Flash. Gemini 3.8 Flash API in CometAPI è progettata come cavallo di battaglia a costo inferiore per carichi di lavoro basati su agenti su larga scala. Argon rappresenta invece l’estremo di frontiera dello stack di Google, dando priorità alla profondità e all’esecuzione sostenuta.
Specifiche del modello
| Specifica | Gemini 4 Argon |
|---|---|
| Sviluppatore | Google DeepMind |
| Annunciato | 30 settembre 2026 |
| Famiglia di modelli | Gemini 4 |
| Posizionamento | Modello di ragionamento di frontiera e a lungo orizzonte |
| Output massimo | 1,000,000 token |
| Valutazione long-context | Testato fino a 256K–1M su GraphWalks |
| Limite contesto input pub. | Non formalmente specificato in una tabella di specifiche API pubblica al lancio |
| Comprensione multimodale | Sì; include valutazione su grafici, documenti e video lunghi |
| Coding agentico | Sì |
| Uso del computer | Valutato |
| Cybersecurity | Capacità difensive specializzate |
| ID modello API pubblica Google | Non annunciato nella documentazione pubblica iniziale di Google; CometAPI usa gemini-4-argon come identificatore a catalogo. |
Budget di output e compromessi
Google annuncia un limite massimo di output di 1 milione di token per Argon, in aumento rispetto al precedente limite di 64K citato nel suo annuncio di lancio. Questo fornisce margine per traiettorie di ragionamento più lunghe. Non va interpretato come un budget totale garantito per un’intera sessione agentica multi-chiamata, né come prova che ogni attività migliorerà.
Il massimo output non è sinonimo di intelligenza. Dare a un modello più token di output non lo rende automaticamente più capace; elimina un potenziale collo di bottiglia. Il modello deve comunque usare quel budget in modo produttivo.
Esiste anche un compromesso di costo e latenza. Un modello che effettivamente consuma centinaia di migliaia di token generati può essere costoso e lento anche quando il prezzo nominale per token appare interessante.

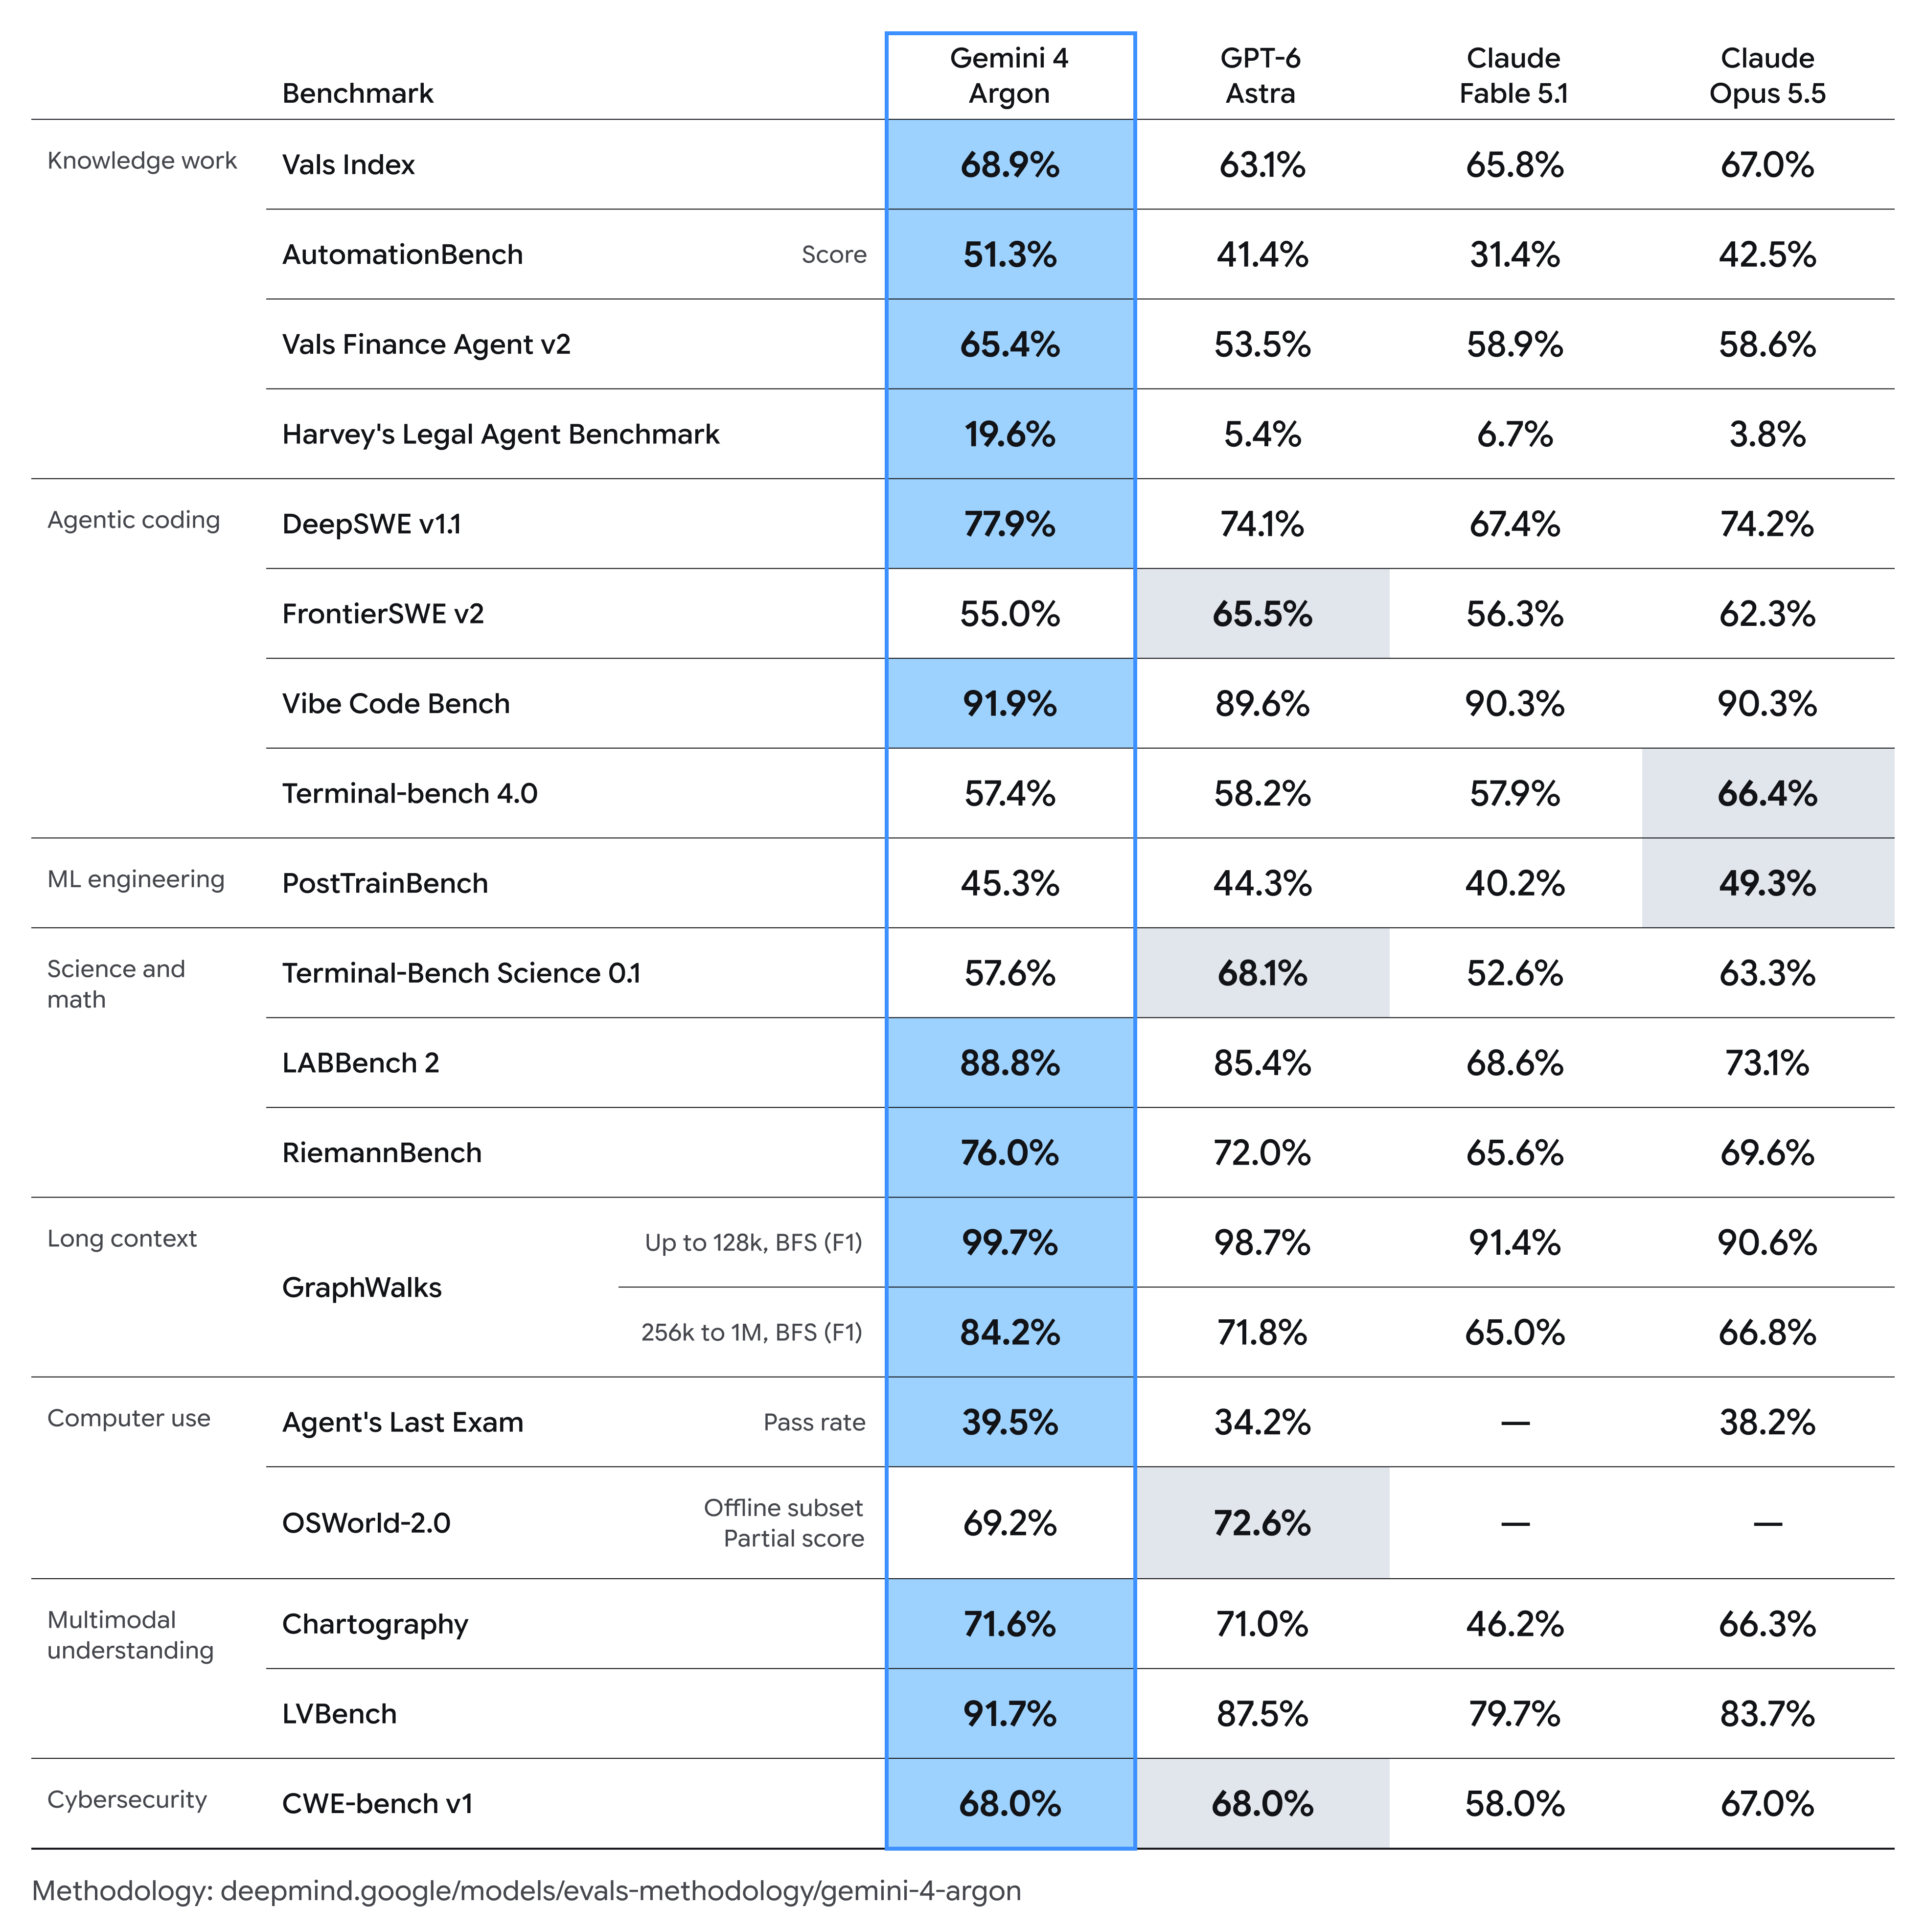
Risultati selezionati di benchmark riprodotti dall’articolo. Confrontare i modelli all’interno di ogni riga; metriche e condizioni di valutazione differiscono. Questo grafico sostituisce l’opera grafica decorativa a gradiente e non rappresenta test indipendenti.
Un limite massimo di output e una finestra di contesto di input descrivono capacità diverse. L’intervallo di valutazione di GraphWalks è una evidenza sugli input testati, non un sostituto di una specifica pubblica dell’API.
Come si comporta Gemini 4 Argon sui benchmark?
La tabella delle prestazioni di Google DeepMind copre flussi di lavoro agentici, lavoro professionale basato sulla conoscenza e compiti multimodali. I valori sottostanti riproducono quel confronto pubblicato. Misurano la performance di task, non la velocità di throughput dei token o la latenza di risposta; “—” indica un risultato non riportato in questo confronto.
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Condizioni di valutazione |
|---|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% | Vals AI |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% | Set privato; classifica Zapier |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% | Vals AI |
| Harvey's Legal Agent | 19.6% | 5.4% | 6.7% | 3.8% | Vals AI |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% | harness mini-swe; fonti miste |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% | Classifica Proximal |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% | Classifica Vals AI |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% | Auto-test / classifica |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% | v1.1; OpenCode; 10h; una H100 |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% | Timeout del verificatore ×6 |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% | Strumenti Linux; internet |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% | Classifica Surge |
| GraphWalks up to 128K | 99.7% | 98.7% | 91.4% | 90.6% | BFS F1; 650 elementi |
| GraphWalks 256K–1M | 84.2% | 71.8% | 65.0% | 66.8% | BFS F1; 200 elementi |
| Agent's Last Exam | 39.5% | 34.2% | — | 38.2% | Passaggio binario; ALE-Claw; 5h |
| OSWorld-2.0 | 69.2% | 72.6% | — | — | Punteggio parziale offline; migliore su 3 esecuzioni |
| Chartography | 71.6% | 71.0% | 46.2% | 66.3% | Nessun tool; classifica Surge |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% | Nessun tool; campionamento dei frame specifico per modello |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% | pass@1; pass@4 risolve i pareggi |
Confronto ufficiale dei benchmark di Gemini 4 Argon di Google
Salvo diversa indicazione, i risultati di Argon usano un singolo tentativo e l’impostazione di pensiero più alta. I risultati degli altri modelli provengono generalmente da report dei provider, con eccezioni specifiche per benchmark. LVBench usa 1 FPS per Gemini, 800 fotogrammi per GPT-6 Astra, 300 per Fable 5.1 e 600 per Opus 5.5. Questi input non sono identici, quindi confrontare le configurazioni riportate invece di trattare ogni riga come un rerun controllato.
Condizioni di valutazione e limitazioni
La tabella è utile, ma non va interpretata come una classifica universale indipendente.
- La selezione dei benchmark è quella di Google.
- Le impostazioni di valutazione specifiche per benchmark differiscono tra le righe, inclusi framework agentici, budget di tempo, strumenti e campionamento degli input.
- La metodologia ufficiale identifica come predefiniti i risultati dei concorrenti riportati dai provider, con eccezioni specifiche per leaderboard e calcoli propri.
- L’impostazione di benchmark più alta può non riflettere una configurazione di inferenza predefinita in produzione.
- Un punteggio di benchmark da solo non rivela uso di token, chiamate a tool, retry, tempo trascorso o intervento umano.
Per i sistemi di produzione, una metrica migliore è spesso il costo per task completato con successo piuttosto che il prezzo per token o una percentuale di benchmark.
Per quali carichi di lavoro è più adatto Gemini 4 Argon?
Performance nel lavoro conoscitivo
Lo schema più chiaro nei risultati di Argon emerge nel lavoro professionale multi-step basato sulla conoscenza.
Su Vals Index, Argon raggiunge il 68.9%, rispetto al 67.0% di Claude Opus 5.5. Il divario numerico è modesto, ma lo schema diventa più evidente in flussi specializzati.
- Vals Finance Agent v2: 65.4%, 6.5 punti sopra il miglior concorrente mostrato nella tabella di Google.
- AutomationBench: 51.3%, 8.8 punti sopra Claude Opus 5.5.
- Harvey's Legal Agent Benchmark: 19.6%, rispetto al 6.7% del modello successivo più alto riportato.
Il profilo di performance suggerisce che Argon beneficia maggiormente quando il modello deve raccogliere informazioni, preservare lo stato, ragionare attraverso più fasi e produrre un artefatto professionale invece di rispondere semplicemente a una domanda chiusa.
È importante anche il basso punteggio assoluto del legal-agent. Un 19.6% da solo non rivela quante criteri o interi flussi siano falliti. La conclusione utile è che Argon mostra un grande miglioramento relativo in questa valutazione, mentre il risultato non stabilisce un’automazione affidabile del lavoro legale.
Ragionamento su contesti lunghi
Il vantaggio più sorprendente di Argon può essere la versione 256K–1M di GraphWalks.
- Gemini 4 Argon: 84.2%
- GPT-6 Astra: 71.8%
- Claude Opus 5.5: 66.8%
- Claude Fable 5.1: 65.0%
Si tratta di un vantaggio di 12.4 punti rispetto al modello più vicino nel confronto pubblicato.
Il divario è molto più piccolo a lunghezze di contesto più brevi: su GraphWalks fino a 128K, Argon ottiene 99.7% e GPT-6 Astra 98.7%. Questo suggerisce che Argon degrada meno bruscamente rispetto ai modelli confrontati in questa particolare valutazione a contesto molto lungo.
Ciò che Google non ha divulgato è un’informazione architetturale sufficiente per attribuire questa differenza a uno specifico meccanismo di attenzione, sistema di retrieval, ricetta di training o strategia in inferenza. Affermazioni come “Gemini 4 introduce una nuova architettura di attenzione” andrebbero quindi oltre le evidenze pubbliche.
Performance nel coding
La tabella ufficiale dei benchmark non supporta un semplice sì.
Argon va estremamente bene in alcune forme di coding e perde chiaramente in altre. Su DeepSWE v1.1 raggiunge 77.9%, contro 74.2% di Claude Opus 5.5 e 74.1% di GPT-6 Astra. Anche il suo punteggio su Vibe Code Bench è forte, 91.9%.
- FrontierSWE v2: 55.0% Argon vs. 65.5% GPT-6 Astra.
- Terminal-Bench 4.0: 57.4% Argon vs. 66.4% Claude Opus 5.5.
- Terminal-Bench Science 0.1: 57.6% Argon vs. 68.1% GPT-6 Astra.
Questa divisione è importante per gli sviluppatori. Argon sembra particolarmente forte quando il coding diventa un flusso di ingegneria lungo, con contesto e pianificazione sostanziali, mentre l’esecuzione fortemente orientata al terminale resta più competitiva. Un benchmark di migrazione di repository e un benchmark di terminale interattivo non vanno trattati come misure intercambiabili di “capacità di coding”.
Cybersecurity difensiva
La cybersecurity è un’area di distribuzione centrale. Il posizionamento sulla cybersecurity difensiva di Google include scoperta autonoma di vulnerabilità, validazione e patching. Si tratta di un claim di capacità del provider; il risultato su CWE-bench riportato di seguito misura la remediation delle vulnerabilità sulla propria valutazione.
Su CWE-bench v1, Argon ottiene 68%, a pari merito con GPT-6 Astra e leggermente davanti a Claude Opus 5.5 con 67%.
Google evidenzia anche salvaguardie più forti contro uso improprio, prompt injection indiretta, comportamenti rischiosi degli agenti e compromissione dell’ambiente di esecuzione. Questo rende Argon tanto un rilascio di sicurezza per agenti quanto un aggiornamento di modello convenzionale.
Comprensione multimodale
Argon ottiene 71.6% su Chartography e 91.7% su LVBench per la comprensione di video lunghi. Il risultato LVBench è 4.2 punti percentuali sopra GPT-6 Astra nella tabella di Google. Poiché i modelli ricevono configurazioni di campionamento dei frame differenti, questo è un confronto degli assetti riportati più che un vantaggio puramente del modello.
Questo è rilevante perché molti flussi professionali non sono solo testuali. Un agente di ricerca finanziaria può dover ispezionare un grafico; un assistente enterprise può combinare report, PDF e screenshot; un sistema di analisi video può dover preservare eventi lungo una sequenza lunga invece di elaborare frame individuali indipendentemente.
La combinazione di percezione multimodale e ragionamento sostenuto di Argon è quindi più rilevante del solo supporto multimodale.
Performance in scienza e matematica
I risultati sono misti ma generalmente forti. Argon raggiunge 88.8% su LABBench 2 e 76.0% su RiemannBench, davanti ai modelli confrontati nella tabella di Google. Tuttavia, su Terminal-Bench Science 0.1, GPT-6 Astra raggiunge 68.1% rispetto al 57.6% di Argon.
Questa differenza indica un pattern più ampio: Argon appare più forte nel ragionamento su informazione scientifica che in ogni forma di esecuzione scientifica guidata da strumenti.
Performance di uso del computer
Su Agent's Last Exam, Argon segna un tasso di superamento binario del 39.5%, avanti a GPT-6 Astra con 34.2% e Claude Opus 5.5 con 38.2%. Sulla sottosezione offline di OSWorld-2.0, il suo punteggio parziale è 69.2%, sotto il 72.6% di GPT-6 Astra. Il valore OSWorld non è un tasso di successo a task completo, e voci mancanti per Claude non implicano capacità zero.
Quindi i dati attuali non mostrano un vantaggio trasversale nell’uso del computer. Per la produzione, i punteggi di benchmark andrebbero integrati con test a livello di task su accuratezza di navigazione, click falliti, frequenza di retry, azioni indesiderate, tempo al completamento e tasso di correzione umana.
Gemini 4 Argon vs GPT-6 Astra e Claude
| Dimensione | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|
| Lavoro conoscitivo | Molto forte | Forte | Molto forte | Forte |
| Benchmark a lungo contesto | Risultato pubblicato più forte | Forte | Da moderato a forte | Moderato |
| Coding a lungo orizzonte | Molto forte | Molto forte | Molto forte | Forte |
| Coding da terminale | Competitivo | Forte | Più forte in test selezionati | Competitivo |
| Agenti scientifici da terminale | Competitivo | Più forte in test selezionati | Forte | Competitivo |
| Comprensione multimodale | Molto forte | Molto forte | Forte | Competitivo |
| Uso del computer | Competitivo | Forte | Misto / confronto limitato | Confronto limitato |
| Cybersecurity | A pari merito al top su CWE-bench v1 | A pari merito al top | Molto vicino | Inferiore |
Argon spicca in questo confronto per lavoro agentico con contesto lungo, ricco di documenti, e lavoro professionale. Gli sviluppatori possono confrontarlo con GPT-6 Astra, Claude Opus 5.5 e Claude Fable 5.1 tramite CometAPI.
Selezione basata sulle performance
Le etichette qualitative sopra riassumono la tabella di benchmark selezionata, non una classifica universale. Favorire Argon per un pilota quando il lavoro somiglia alle sue valutazioni di punta; testare Astra e Opus sui carichi fortemente orientati al terminale prima di scegliere un predefinito.
Specifiche e vincoli di distribuzione
Questo confronto di performance non stabilisce un vantaggio di architettura o un vincitore generale prezzo-prestazioni. La numerosità di parametri e l’architettura di Argon non sono specificate nei materiali di lancio di Google rivisti. Il suo limite pubblico di contesto di input richiede documentazione API ufficiale. CometAPI riporta una route gemini-4-argon; confermare i parametri supportati e l’accesso dell’account indipendentemente dal rollout più ampio di Google. Confrontare i limiti di ciascuna route e i costi reali dei task prima della distribuzione.
Come possono gli sviluppatori accedere a Gemini 4 Argon tramite CometAPI?
CometAPI riporta il modello come disponibile con identificatore gemini-4-argon. Usare la dashboard dell’account per creare una chiave API, selezionare tale identificatore nel playground ed eseguire una richiesta di test prima dell’integrazione. Il suo esempio compatibile con OpenAI usa la base URL https://api.cometapi.com/v1. Confermare endpoint e parametri supportati nella documentazione dell’account; un badge a catalogo da solo non verifica una chiamata riuscita.
- Crea un account CometAPI e genera una chiave API nella dashboard.
- Scegli gemini-4-argon e valida una richiesta rappresentativa nel playground.
- Configura il client compatibile con la base URL di CometAPI, la tua chiave e l’identificatore del modello; conferma lo schema di richiesta supportato e la fatturazione prima della distribuzione.
CometAPI e prezzi ufficiali
Google ha annunciato prezzi introduttivi di $2 per milione di token in input e $10 per milione di token in output, con input in cache scontati del 95% rispetto alla tariffa di input. Dopo il periodo introduttivo, le tariffe annunciate sono $4 per input e $20 per output per milione di token. Queste sono tariffe annunciate da Google, non i prezzi di CometAPI né conferma di accesso API generale immediato.
| Base di fatturazione | Gemini 4 Argon API in CometAPI | Annuncio ufficiale Google | Confronto |
|---|---|---|---|
| Input / 1M token | $3.20 | $4.00 dopo periodo introduttivo | 20% in meno rispetto alla tariffa post-introduttiva annunciata |
| Output / 1M token | $16.00 | $20.00 dopo periodo introduttivo | 20% in meno rispetto alla tariffa post-introduttiva annunciata |
Conclusione
Il profilo di benchmark di Gemini 4 Argon è più interessante di una semplice pretesa da classifica.
I risultati più forti in questo confronto si concentrano su lavoro professionale basato sulla conoscenza, contesto lungo ed esecuzione agentica sostenuta. Questo schema è utile per la selezione dei carichi di lavoro, ma non identifica l’architettura sottostante né prova quale meccanismo abbia causato i guadagni.
I risultati riportati in finanza, legale, video lunghi e ingegneria del software supportano un pilota mirato per quei carichi. Se lo stesso vantaggio persista in produzione dipende dal mix di input, dal framework agentico, dalle impostazioni di inferenza e dai requisiti di verifica.
Allo stesso tempo, i risultati mostrano che la performance dei modelli di frontiera sta diventando sempre più specializzata. Argon può guidare DeepSWE rimanendo dietro su FrontierSWE; guidare Agent's Last Exam rimanendo dietro su OSWorld; e guidare LABBench rimanendo dietro su Terminal-Bench Science. Questi benchmark sollecitano parti diverse di un sistema di agenti.
Per gli sviluppatori, la lezione più importante è che la selezione del modello deve avvenire sempre più a livello di carico di lavoro piuttosto che per brand o famiglia.
FAQ
Come dovrebbero gli sviluppatori validare Gemini 4 Argon sui propri carichi di lavoro?
Costruire un set di task rappresentativo con criteri di accettazione espliciti. Mantenere comparabili tra i modelli strumenti, limiti di tempo, preparazione degli input e politiche di retry. Registrare task completati, token totali, tempo trascorso e correzione umana. Iniziare con un piccolo pilota ed esaminare i casi di fallimento prima di instradare traffico di produzione.
Le percentuali di benchmark di Gemini 4 Argon possono essere mediate in un unico punteggio?
No. La tabella combina metriche diverse, inclusi F1, tassi di superamento e punteggi parziali. Usare criteri specifici per task invece di mediare tutte le percentuali.
Un agente Gemini 4 Argon dovrebbe sempre usare il suo budget di output completo?
No. Scegliere il budget più piccolo testato che soddisfi i requisiti di qualità e affidabilità. Il limite massimo di output è un tetto, non un obiettivo.
Come dovrebbero i team valutare l’accesso a Gemini 4 Argon tramite CometAPI?
Iniziare con un controllo della disponibilità a livello di account e una piccola richiesta usando la route CometAPI documentata. Misurare qualità della risposta, latenza, limiti e token fatturati, quindi applicare gli stessi test di accettazione usati per modelli alternativi. Trattare la dichiarazione di accesso di CometAPI separatamente dal rollout più ampio di Google e mantenere l’instradamento configurabile finché la route non soddisfa i requisiti.