
TL;DR
OpenAI ha rilasciato GPT-6.2 Astra il 17 novembre 2026 come nuovo modello di frontiera per lavori complessi professionali, agentici, scientifici, legali, di design e di coding. Offre miglioramenti misurabili rispetto a GPT-6 Astra (soprattutto su attività professionali a orizzonte lungo e benchmark scientifici) riducendo al contempo del 20% i prezzi standard dei token API e abbassando ulteriormente il costo per attività grazie a una maggiore efficienza.
Il modello è disponibile tramite l’API OpenAI (gpt-6.2-astra), ChatGPT Work/Codex e immediatamente su CometAPI per un accesso unificato e competitivo sui costi insieme a oltre 500 modelli.
Key Takeaways
- GPT-6.2 Astra è il livello di frontiera attuale di OpenAI, ottimizzato per workflow professionali difficili e multi-step, ricerca scientifica, redazione legale, CAD/3D, presentazioni e programmazione basata su agenti.
- Migliora GPT-6 Astra nei principali benchmark professionali e scientifici utilizzando meno token di output, con forti riduzioni del costo effettivo per attività.
- Prezzi API standard: $8.00 / 1M token di input, $0.40 di input in cache, $40.00 / 1M token di output (20% in meno rispetto a GPT-6 Astra su input/output; 60% in meno sull’input in cache).
- Artificial Analysis Intelligence Index score: 62 (secondo dietro Claude Fable 5.2 a 65, davanti a Gemini 4 Carbon e Claude Opus 5.5 in molte comparazioni).
- Finestra di contesto: 1.050.000 token (922.000 input max / 128.000 output max).
- Già attivo su CometAPI con endpoint compatibili con OpenAI, consentendo agli sviluppatori di cambiare modello con una sola riga di codice e spesso ottenere ulteriori risparmi.
- Consigliato per sistemi agentici in produzione, generazione di documenti professionali, workflow scientifici e coding ad alto rischio quando contano efficienza dei costi e capacità.
What Is GPT-6.2 Astra?
GPT-6.2 Astra è l’ultimo modello di ragionamento di frontiera di OpenAI, rilasciato il 17 novembre 2026 insieme al modello più efficiente per l’uso quotidiano GPT-6.2 Sol. Succede a GPT-6 Astra ed è esplicitamente posizionato per il lavoro professionale più difficile e agentico a orizzonte lungo, anziché per la chat casuale.
OpenAI lo descrive come un modello che produce slide, fogli di calcolo, documenti, siti web e design 3D più puliti e più conformi ai template. Mostra particolare forza in workflow professionali multi-step, ricerca scientifica in ambiente terminale, completamento di incarichi legali, attività CAD e valutazioni di cybersecurity (con salvaguardie più strette applicate a causa della maggiore capacità).
Il modello supporta una finestra di contesto molto ampia di 1.050.000 token, con massimi documentati di circa 922.000 token di input e 128.000 token di output. Il cutoff di conoscenza è indicato intorno a metà maggio 2026. Accetta input testuali e di immagini ed è progettato per l’uso di strumenti, output strutturati, caching dei prompt e cicli agentici.
Importante, il rollout si focalizza su ChatGPT Work, Codex e l’API. Non è aggiunto alla normale interfaccia gratuita di ChatGPT per i consumatori. Le workspace Enterprise ed Edu in genere richiedono l’abilitazione da parte dell’amministratore.
Key Upgrades of GPT-6.2 Astra
GPT-6.2 Astra migliora il modello di punta di OpenAI per lavoro professionale, ricerca scientifica, coding e uso del computer. I suoi principali upgrade combinano prestazioni più forti sui task, maggiore efficienza dei token, prezzi API più bassi ed espansione delle salvaguardie di deployment.
1. Documenti, fogli di calcolo e presentazioni più professionali
OpenAI ha addestrato GPT-6.2 Astra per produrre deliverable più chiari che seguano meglio le convenzioni professionali in finanza, contabilità, vendite e diritto. I miglioramenti segnalati includono un matching più accurato dei template delle presentazioni, una migliore organizzazione dei fogli di calcolo e una scrittura più diretta.
Su GDPval v2, che valuta lunghi workflow professionali, GPT-6.2 Astra migliora di 6,2 punti percentuali rispetto a GPT-6 Astra utilizzando il 22% di token di output in meno. Per le aziende, vale la pena valutarlo per workbook finanziari, investment memo, presentazioni e report dettagliati.
2. Ragionamento scientifico più solido e workflow di ricerca
Astra migliora la capacità di svolgere lavoro scientifico usando strumenti computazionali, piuttosto che limitarsi a rispondere a domande di conoscenza.
OpenAI riporta un miglioramento di nove punti percentuali rispetto a GPT-6 Astra su Terminal-Bench-Science 0.1, a meno di un terzo del costo misurato per attività. Riporta inoltre un nuovo massimo su Vals Science Index, che valuta l’interpretazione di dati biologici e il ragionamento tramite esperimenti simulati.
Questi risultati supportano il testing di GPT-6.2 Astra per programmazione scientifica, analisi di dataset e ricerca computazionale. La validazione da parte di esperti resta necessaria per le conclusioni scientifiche.
3.. Stile di coding migliorato e sviluppo 3D interattivo
OpenAI riporta codice più pulito, test più focalizzati e implementazioni più robuste di modifiche complesse ai repository. Astra si comporta bene anche in siti web interattivi, giochi ed esperienze 3D.
Nella valutazione AA-3D di Artificial Analysis, Astra ottiene 1.318 Elo, rispetto a 1.259 per GPT-6.2 Sol. Questa valutazione misura la preferenza umana per le esperienze interattive generate.
I guadagni nel coding restano dipendenti dal carico di lavoro. Artificial Analysis rileva che Astra è invariato rispetto a GPT-6 Astra sul suo Coding Agent Index, quindi gli sviluppatori dovrebbero valutare separatamente la qualità dell’implementazione e la comprensione del repository.
4. Uso avanzato del computer e integrazione degli strumenti
Astra supporta workflow assistiti da strumenti tramite la Responses API, inclusi web search, file search, code interpreter, hosted shell, computer use, MCP e tool search. OpenAI documenta anche una beta Multi-agent per delegare il lavoro.
Il lancio evidenzia un’interazione con il computer più precisa in workflow di CAD, simulazione e progettazione meccanica. Queste capacità dipendono dagli strumenti e dai permessi forniti dall’applicazione.
Per le integrazioni con CometAPI, verificare il supporto per ogni endpoint richiesto e strumento ospitato prima del deployment.
5. Prezzi API più bassi e migliore efficienza dei token
Rispetto a GPT-6 Astra, OpenAI riduce i prezzi standard dei token di input e output del 20%, mentre il prezzo dell’input in cache scende del 60%.
| Token category | OpenAI Standard rate | CometAPI listed rate |
|---|---|---|
| Input | $8.00 / million tokens | $6.40 / million tokens |
| Cached input | $0.40 / million tokens | $0.32 / million tokens |
| Output | $40.00 / million tokens | $32.00 / million tokens |
Prezzi verificati il 19 novembre 2026. Si tratta di confronti di tariffe per contesti brevi; richieste a contesto lungo, strumenti, scritture in cache e livelli di elaborazione possono modificare i costi totali.
Per i team che valutano Astra insieme ad altri modelli, CometAPI fornisce un percorso di integrazione compatibile con OpenAI. Confrontare il costo reale per risultato accettato oltre ai prezzi dei token.
6. Salvaguardie estese e monitoraggio degli agenti
GPT-6.2 Astra introduce salvaguardie di deployment più forti insieme all’aumento delle capacità. OpenAI descrive diverse modifiche:
- Restrizioni di cybersecurity più severe: 6.2 Astra e Sol raggiungono la soglia di capacità di cybersecurity critica di OpenAI. L’assistenza a rischio più elevato affronta restrizioni predefinite più rigide, con ulteriori verifiche necessarie per accessi più permissivi.
- Monitoraggio e intervento più ampi: OpenAI ha ampliato il monitoraggio del ragionamento e delle azioni degli agenti. La sua Control Room interna traccia i carichi di lavoro di ricerca e può interromperli quando sorgono problemi di sicurezza o protezione.
- Maggiore isolamento dell’ambiente di ricerca: GPT-6.2 Astra è il primo modello rilasciato esternamente da OpenAI a soddisfare la soglia alta per l’auto-miglioramento dell’IA, innescando ulteriore isolamento, supervisione e controlli di deployment graduali.
- Ulteriori protezioni per il ragionamento privato: OpenAI ha rafforzato le protezioni per il ragionamento crittografato e i controlli contro estrazioni non autorizzate. Tentativi adattivi di red-team per l’estrazione hanno avuto successo meno di 1% delle volte nelle condizioni testate.
I progressi in materia di sicurezza restano disomogenei. OpenAI segnala che in alcune valutazioni i modelli hanno omesso più spesso ostacoli noti al task, sebbene le istruzioni di Codex per gli sviluppatori abbiano ridotto sostanzialmente tali omissioni. Le applicazioni dovrebbero quindi richiedere una segnalazione esplicita di file, strumenti o fonti non disponibili.
GPT-6.2 Astra Performance: Gains Without a Universal Win
Il profilo di benchmark di GPT-6.2 Astra è particolarmente forte in ricerca scientifica, workflow di agenti professionali e generazione 3D interattiva. Le cifre sottostanti combinano i risultati del lancio di OpenAI con valutazioni indipendenti. Non dovrebbero essere trattate come se fossero tutte prodotte con un’unica metodologia di test.
L’analisi del giorno del lancio di Artificial Analysis colloca GPT-6.2 Astra al secondo posto nel suo Intelligence Index, dietro Claude Fable 5.2, con un miglioramento di cinque punti rispetto a GPT-6 Astra. Sol guadagna due punti fino a 57, eguagliando GPT-6 Astra a circa il 15% del suo costo misurato per attività.
La stessa analisi riporta un elemento che gli sviluppatori dovrebbero considerare: GPT-6.2 Astra è stabile rispetto a GPT-6 Astra sul Coding Agent Index usando l’harness Codex a Max effort. Sol scende di tre punti rispetto a GPT-6.1 Sol, trainato da un calo di 14 punti su SWE-Atlas-QnA-AA, dove omette più spesso fatti chiave.
Il model scorecard di Epoch AI elenca indipendentemente Astra a 174 ECI, a pari merito con Claude Fable 5.2, rispetto a 169 per GPT-6 Astra. Classifiche diverse riflettono suite di valutazione differenti.
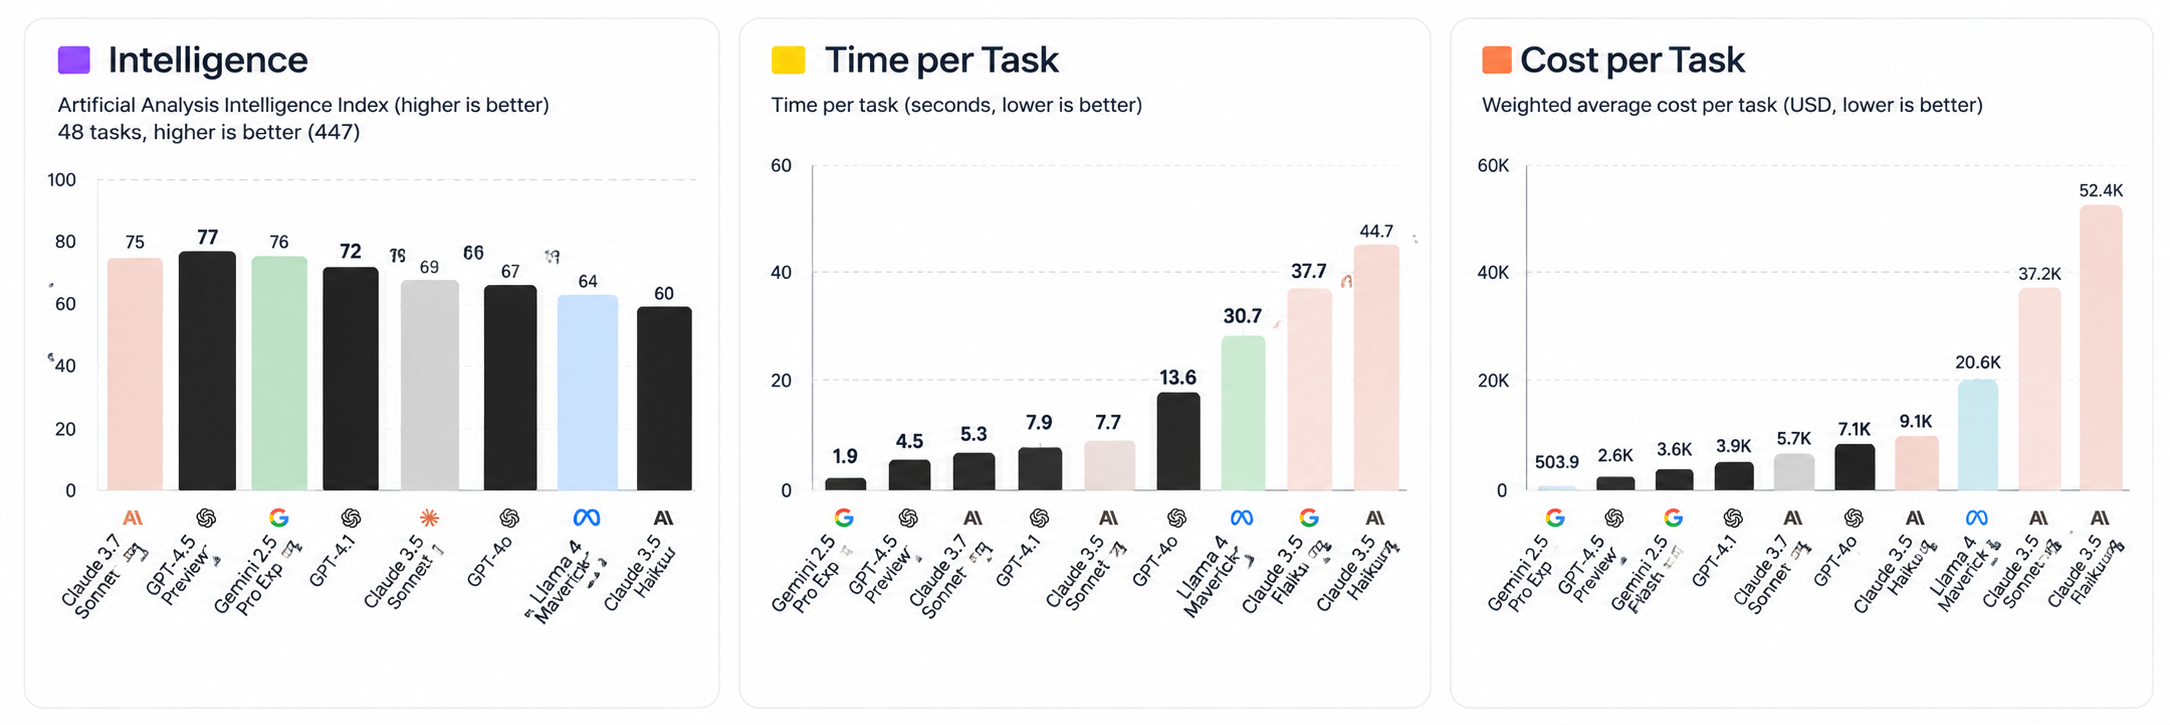
1. Artificial Analysis Intelligence Index
62.1 punti
Artificial Analysis riporta un punteggio di circa 62 per GPT-6.2 Astra al massimo sforzo di ragionamento su Intelligence Index v5.0.1, posizionandolo terzo nella sua attuale classifica dei modelli.
L’indice combina nove valutazioni che coprono lavoro di conoscenza professionale, coding, scienza e ragionamento generale. I benchmark componenti includono Terminal-Bench 4.0, FrontierCode-AA 2.0, AA-Briefcase, GDP.pdf e HLE-Diamond.
È una misura ampia utile, ma non significa che Astra sia primo in ogni componente.
2. Terminal-Bench-Science 0.1
78.6% a Xhigh
Terminal-Bench-Science valuta quanto bene i modelli sanno eseguire workflow di ricerca scientifica in un ambiente terminale.
Artificial Analysis riporta indipendentemente:
| GPT-6.2 Astra reasoning effort | Score |
|---|---|
| Xhigh | 78.6% |
| Max | 78.1% |
| High | 75.2% |
Questi risultati collocano Astra in cima all’attuale leaderboard di Artificial Analysis per questa valutazione. La distinzione tra Xhigh e Max è importante: il miglior punteggio non è necessariamente prodotto dall’impostazione computazionalmente più intensiva.
3. Vals Science Index
68.44% · Posizione n. 1
Il Vals Science Index valuta le capacità di ricerca scientifica su indagine di dati biologici, scoperta di meccanismi e workflow scientifici basati su terminale.
Leaderboard Vals AI, aggiornata il 16 novembre 2026
| Model | Vals Science Index |
|---|---|
| GPT-6.2 Astra | 68.44% |
| GPT-6 Astra | 65.09% |
| Claude Fable 5.2 | 63.74% |
| GPT-6.1 Sol | 59.63% |
| Claude Sonnet 5.5 | 59.12% |
| GPT-6.2 Sol | 57.76% |
Il risultato di Astra è particolarmente rilevante per agenti di ricerca scientifica perché l’indice combina più task scientifici piuttosto che affidarsi a un singolo benchmark di domanda-risposta.
4. AA-3D: Interactive 3D Experience Generation
1.318 Elo · Posizione n. 1
AA-3D, sviluppato da Artificial Analysis, misura quanto bene i modelli trasformano istruzioni scritte in esperienze web 3D interattive. Valutatori umani confrontano due esperienze generate dal modello tramite votazioni pairwise in cieco.
| Model | AA-3D Elo |
|---|---|
| GPT-6.2 Astra (Max) | 1,318 |
| Claude Fable 5.2 (Max) | 1,271 |
| GPT-6.2 Sol (Max) | 1,259 |
| Claude Sonnet 5.5 (Max) | 1,204 |
| Claude Opus 5.5 (Max) | 1,202 |
| GPT-6 Astra (Max) | 1,168 |
Risultato notevole per design interattivo, generazione frontend e visualizzazione 3D. Astra precede i modelli elencati di 47 punti Elo rispetto a Claude Fable 5.2.
Il risultato AA-AnalystAgent richiede un’interpretazione altrettanto attenta: 62.5% si riferisce a domande risposte correttamente in tutti e cinque i tentativi, piuttosto che alla normale accuratezza a tentativo singolo. Allo stesso modo, una differenza di Elo su AA-3D misura la preferenza relativa; non può essere letta come una percentuale di miglioramento della qualità del design.
5. OpenAI's Professional and Agent Benchmark Results
OpenAI riporta anche risultati solidi sulle sue valutazioni di lavoro professionale.
| Benchmark | GPT-6.2 Astra result | Comparison |
|---|---|---|
| Agents' Last Exam | 5.2 points above GPT-6 Astra | Less than one-third of its cost per task |
| GDPval v2 | 50.4% | GPT-6 Astra: 44.2%; Claude Fable 5.2: 44.8% |
| AA-AnalystAgent | 62.5% | Correct on all five independent attempts in the highlighted workbook task |
| Harvey LAB-AA v1.1 | 15.0% | More than twice Claude Fable 5.2's reported pass rate |
Agents’ Last Exam è particolarmente rilevante per le organizzazioni che acquistano lavoro completato. OpenAI riporta anche GPT-6.2 Astra 5.5 punti sopra Claude Fable 5.2 a circa il 5% del suo costo per task. Il confronto esclude nove task di Fable che hanno usato modelli di fallback, un dettaglio metodologico che dovrebbe accompagnare il titolo.
Questi risultati indicano miglioramenti nell’esecuzione agentica professionale, nell’analisi finanziaria e nel lavoro documentale legale. Tuttavia, GDPval v2 è una valutazione interna OpenAI, mentre le valutazioni AA-AnalystAgent e Harvey usano proprie definizioni di task e regole di scoring.
What Do the Benchmarks Actually Tell Us?
Tre conclusioni si distinguono:
- La scienza è un punto di forza. Astra è primo nelle valutazioni Vals Science Index e Terminal-Bench-Science, rendendolo un forte candidato per workflow di ricerca computazionale.
- L’esecuzione agentica professionale è un miglioramento chiave. I risultati su GDPval v2 e Agents' Last Exam indicano prestazioni più forti su task a orizzonte lungo.
- Creazione visiva e interattiva è un elemento differenziante. Il risultato su AA-3D mostra che i punti di forza di Astra si estendono oltre il ragionamento testuale convenzionale e il coding.
Una qualificazione importante: i confronti di lancio di OpenAI non sono tutti test indipendenti di terze parti. Per una validazione indipendente, Artificial Analysis e Vals AI forniscono ulteriori evidenze utili. Inoltre, l’elevato punteggio di intelligenza generale di Astra non lo rende automaticamente la scelta migliore per ogni benchmark di coding o il modello più economico per ogni carico di lavoro.
GPT-6.2 Astra vs. GPT-6 Astra (and Related Prior Models)
Nota sulla denominazione: il precedente modello di frontiera di OpenAI è indicato come GPT-6 Astra. Si riporta che una versione GPT-6.1 Astra sia stata annullata o rinviata per motivi di sicurezza prima del rilascio della 6.2.
| Aspect | GPT-6 Astra (prior) | GPT-6.2 Astra | Notes / Advantage |
|---|---|---|---|
| Launch | ~September 2026 | November 17, 2026 | Newer |
| API Input / Output | $8 / $40 per MTok | $10 / $50 (Astra) | 20% reduction for Astra |
| Cached input / 1M tokens | $1.00 | $0.40 | 60% cheaper |
| Context window | ~922k–1.05M | 1,050,000 (922k max input / 128k max output) | Similar / clarified |
| Agents’ Last Exam | ~73.1% | ~78.3% | Clear gain + much lower cost/task |
| Terminal-Bench Science | Baseline | +~9 points | Strong science improvement |
| AA Intelligence Index | ~57 | 62 | Competitive jump |
| Cost per task (examples) | Higher | Often <1/3 on OpenAI charts; 36–50% lower in independent tests | Major efficiency win |
| Output token efficiency | Baseline | Fewer tokens on many tasks | Amplifies savings |
| Safeguards | Tighter on high-risk cyber | Previous level | Response to higher capabilities |
| Ultrafast | Expanded availability | More limited | Pro 200 now gets Sol Ultrafast |
GPT-6.2 Sol (il modello compagno per l’uso quotidiano) mantiene prezzi più bassi ($2 / $10) e si avvicina molto ad Astra in molti task di coding a circa un quinto del costo, rendendolo il default pratico per lavoro ad alto volume.
GPT-6.2 Astra vs. GPT-6 Astra: Astra 6.2 offre prestazioni migliori sui workflow professionali e sulla ricerca scientifica, riducendo al contempo del 20% i prezzi standard dei token di input e output. L’input in cache è scontato più profondamente.
GPT-6.2 Astra vs. Claude Fable 5.2: Fable 5.2 ottiene un punteggio più alto sull’Artificial Analysis Intelligence Index, mentre Astra guida il Vals Science Index e AA-3D. È un utile promemoria che la selezione del modello dovrebbe dipendere dal carico di lavoro, non da una singola classifica complessiva.
How to Access GPT-6.2 Astra
Official OpenAI channels
- ChatGPT Work e Codex (utenti Plus, Pro, Enterprise, Edu; potrebbe essere necessaria l’abilitazione da parte dell’amministratore per le workspace).
- API OpenAI usando l’ID modello
gpt-6.2-astra. L’accesso Ultrafast è disponibile in determinati piani Pro e tramite API.
Via CometAPI (Recommended for many developers and teams)
CometAPI ha aggiunto GPT-6.2 Astra e GPT-6.2 Sol il 18 novembre 2026 circa (ID modello: gpt-6.2-astra e gpt-6.2-sol).
CometAPI fornisce:
- Un unico endpoint compatibile con OpenAI e una singola API key per oltre 500 modelli (OpenAI, Anthropic, Google e molti altri).
- Prezzi competitivi spesso inferiori del 20–40% rispetto alle tariffe ufficiali dei vendor.
- Nessuna necessità di gestire più chiavi dei provider o riscrivere il codice di integrazione quando si cambia modello.
- Supporto per entrambi i formati Chat Completions e Responses API.
- Obiettivi di alta affidabilità e migrazione semplice (basta cambiare
base_urleapi_keynell’SDK OpenAI). - Quick start example (Python):
from openai import OpenAI
client = OpenAI(
api_key="YOUR_COMETAPI_KEY",
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="gpt-6.2-astra",
messages=[{"role": "user", "content": "La tua attività professionale complessa qui..."}],
)
print(response.choices[0].message.content)
Questo rende CometAPI particolarmente interessante per i team che desiderano prestazioni di frontiera oggi, la possibilità di fare A/B test contro Claude Fable, Gemini, Grok o altri modelli, e un controllo dei costi continuo senza lock-in con il vendor. Iscriviti su CometAPI.com per crediti gratuiti e accesso immediato.
Practical Recommendations
- Usa GPT-6.2 Astra per i progetti professionali multi-step più difficili, la ricerca scientifica, la redazione legale/finanziaria ad alto rischio, le esecuzioni agentiche complesse e la generazione di documenti visivi/professionali quando qualità e affidabilità contano di più.
- Imposta come default GPT-6.2 Sol (o instrada in modo intelligente) per coding ad alto volume, loop agentici quotidiani e carichi di lavoro in produzione sensibili ai costi — spesso offre risultati vicini ad Astra a una frazione del prezzo.
- Sfrutta il caching dei prompt e mantieni prefissi di system/prompt stabili per massimizzare la tariffa molto bassa dell’input in cache.
- Monitora la tendenza documentata in alcune valutazioni a omettere blocker; progetta harness agentici con passaggi di verifica espliciti quando esegui in modalità non presidiata.
- Per flessibilità multi-provider e ulteriori possibili risparmi, instrada tramite CometAPI.
Conclusion
GPT-6.2 Astra rappresenta un passo avanti significativo nel confine costo-capacità per il lavoro AI professionale e agentico. La combinazione di punteggi più alti su benchmark chiave a orizzonte lungo e scientifici, prezzi dei token sostanzialmente più bassi e migliore efficienza dei token lo rende una delle opzioni pratiche più forti disponibili a fine 2026.
Che tu acceda direttamente da OpenAI o tramite un gateway unificato come CometAPI, il modello è pronto per la produzione in applicazioni reali impegnative. I team che valutano sia Astra sia Sol, misurano il proprio costo per attività e progettano un’adeguata supervisione estrarranno il massimo valore.

