
In breve
DeepSeek-V4.1-Flash è a pesi aperti e può essere auto-ospitato, ma “locale” non significa “su un PC da gaming”. DeepSeek lo descrive come un backbone Mixture-of-Experts da 552B parametri che usa un’architettura Encoder-Decoder Causale, con solo 8B parametri attivi durante l’elaborazione del prompt e 16B durante la generazione. Il modello completo rimane un target di deployment a livello frontier.
L’attuale ricetta di deployment vLLM colloca il checkpoint a circa 511 GB su disco e circa 614 GB di VRAM minima, rendendo molto più realistico un server di classe 8×H200 o un sistema a memoria elevata, rispetto a una workstation consumer.
Per i team che hanno bisogno solo dell’accesso e non del controllo a livello di pesi, l’API DeepSeek V4.1 Flash in CometAPI è sostanzialmente più semplice rispetto alla manutenzione di un server di inferenza multi-GPU.
Punti chiave
- DeepSeek-V4.1-Flash usa un backbone MoE da 552B con 8B di parametri attivi durante il prefill e 16B durante la decodifica; i parametri attivi non rappresentano il requisito di memoria residente.
- Il suo contesto da 1,048,576 token e la cache KV globale da 890 byte per token riducono la pressione sulla cache, ma i pesi del modello continuano a dominare la pianificazione della capacità.
- Il checkpoint ufficiale è di circa 511 GB su disco. La ricetta vLLM stima all’incirca 614 GB di VRAM aggregata utilizzabile come budget minimo per caricare il modello e la sua overhead runtime; è una stima di base, non una garanzia per ogni dimensione di batch, lunghezza del contesto o configurazione multimodale.
- vLLM è il percorso più chiaro per il serving in produzione, mentre SGLang punta a un’inferenza distribuita avanzata; l’attuale percorso di Ollama è ospitato in cloud e non una vera inferenza completamente locale.
- L’auto-ospitare ha più senso per privacy, operazioni air‑gapped, ricerca a livello di pesi o utilizzo sostenuto del cluster; la maggior parte degli sviluppatori troverà più semplice un’API ospitata.
Che cos’è DeepSeek-V4.1-Flash? Architettura, parametri e dimensione del modello
DeepSeek ha rilasciato ufficialmente V4.1-Flash il 10 settembre 2026 come il modello più piccolo della sua nuova famiglia architetturale, con comprensione visiva nativa. Nonostante il nome “Flash”, non è un modello denso di piccole dimensioni.
Il suo cambiamento architetturale chiave è il design Encoder-Decoder Causale (CED). Il modello divide il calcolo in modo asimmetrico tra ingestione del prompt e generazione di token, riducendo il compute attivo pur mantenendo un pool di esperti molto ampio.
| Specifica | DeepSeek-V4.1-Flash |
|---|---|
| Architettura | MoE multimodale con Encoder-Decoder Causale |
| Parametri del backbone | 552B |
| Parametri attivi, input | 8B |
| Parametri attivi, output | 16B |
| Livelli Transformer | 40: 20 encoder + 20 decoder |
| Finestra di contesto | 1,048,576 token |
| Cache KV globale | 890 byte/token |
| Modalità | Input testo + immagine, output testo |
| Licenza dei pesi | MIT |
| Campionamento consigliato | Temperature 1.0; top_p 0.95 o 1.0 |
| Pesi ufficiali | Hugging Face |
| Opzioni principali di serving locale | vLLM, SGLang, DeepSeek reference inference |
La distinzione tra parametri attivi e parametri residenti è essenziale. Il routing MoE riduce la quantità di calcolo utilizzata per un singolo token, ma il server deve comunque avere accesso ai pesi degli esperti che potrebbero essere selezionati. Ecco perché un modello con “8B attivi” può comunque richiedere centinaia di gigabyte di storage e memoria sull’acceleratore.
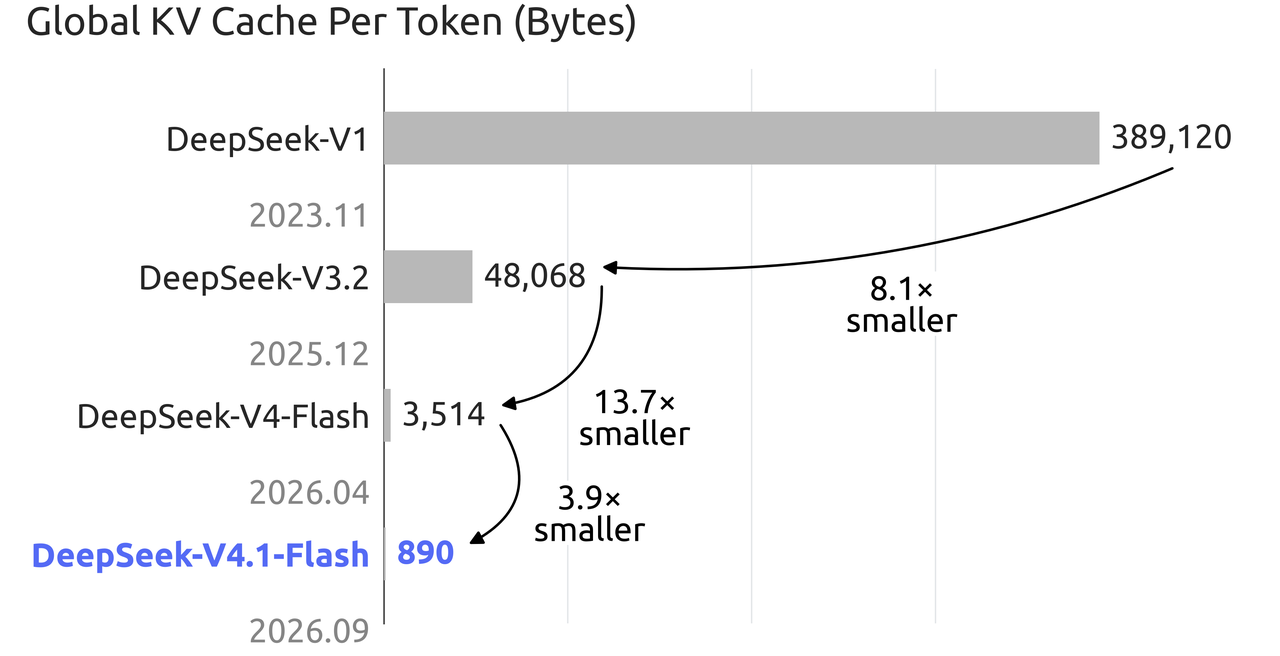
Il grafico ufficiale della cache KV di DeepSeek mostra la cache globale che scende da 3,514 byte per token in V4 Flash a 890 byte per token in V4.1 Flash, una riduzione di circa 3,9×. Questo è importante per l’inferenza a un milione di token, ma non elimina il requisito di memoria ben più grande creato dai pesi del modello.
Quanto è valido DeepSeek-V4.1-Flash prima di distribuirlo?
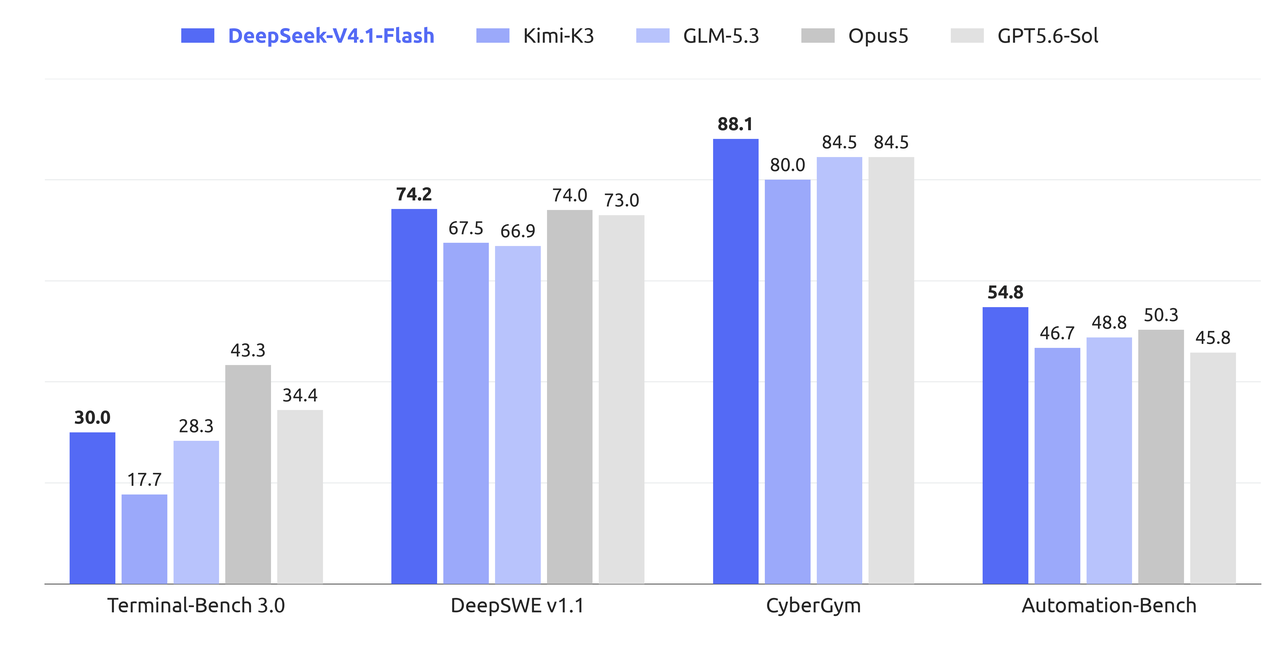
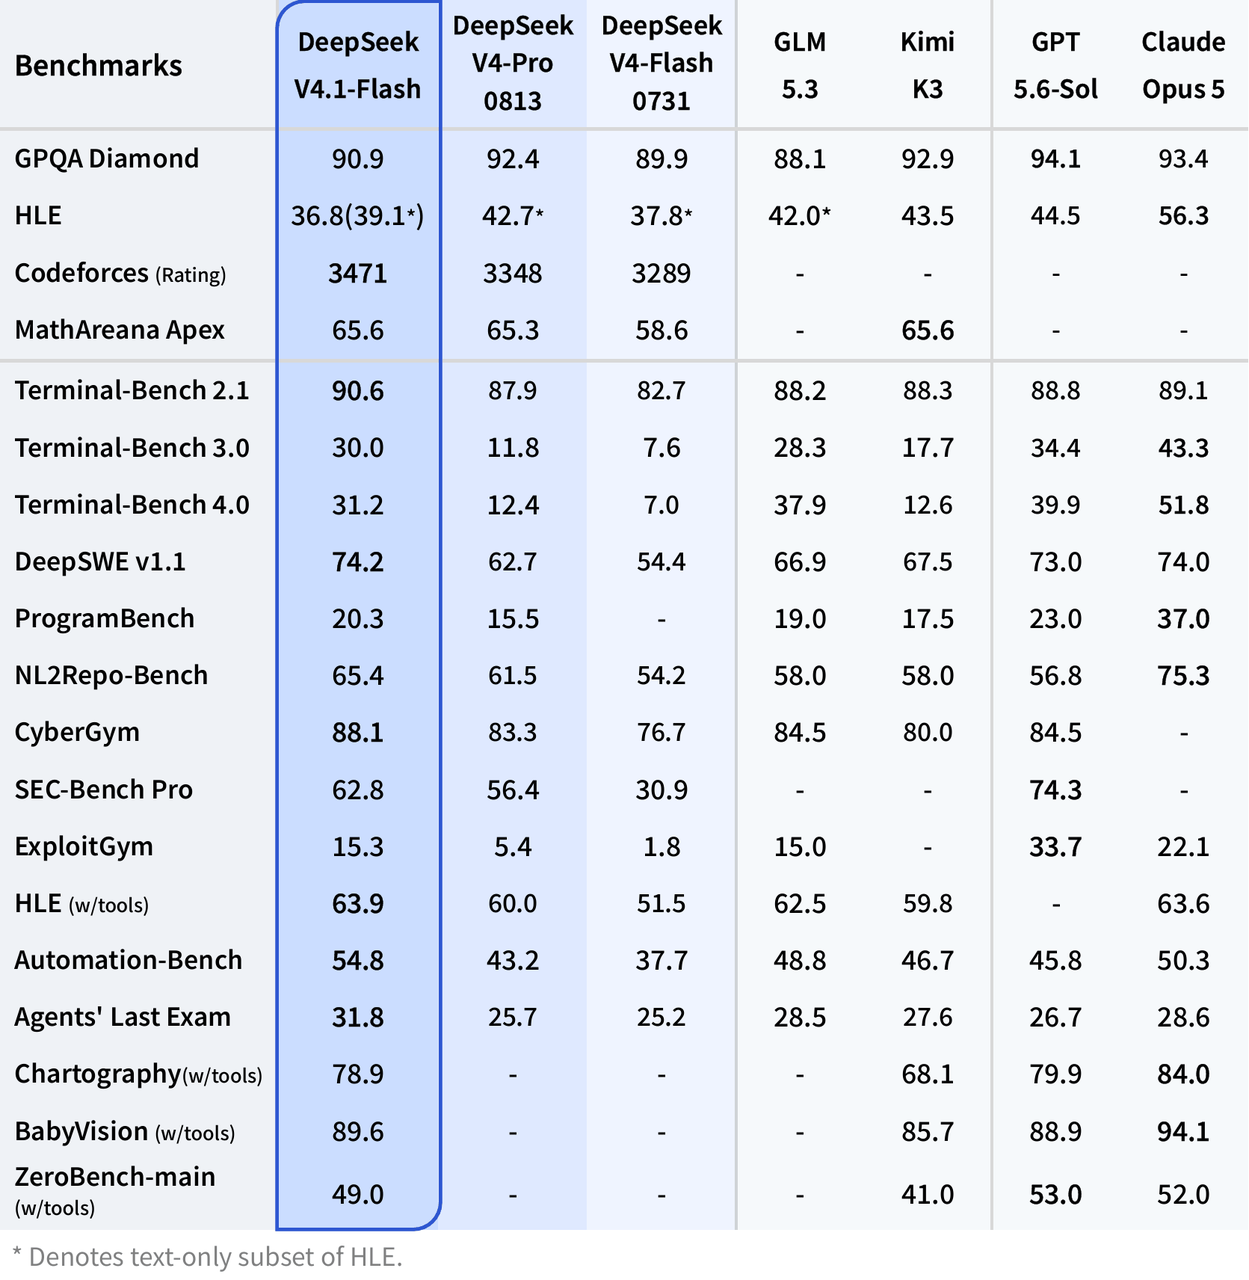
La tabella dei benchmark pubblicata da DeepSeek presenta V4.1-Flash principalmente come un grande upgrade in coding agentico, operazioni su terminale, automazione e carichi di lavoro di ingegneria del software. Si tratta di risultati di benchmark dichiarati dal vendor, quindi vanno trattati come misurazioni di riferimento e non come prestazioni garantite in applicazioni reali.
Per la riproducibilità, la model card ufficiale raccomanda temperature 1.0 e top_p 0.95, mentre lo sforzo di ragionamento e i budget di token variano in base alla valutazione. Le cifre seguenti sono risultati di riferimento eseguiti dal vendor, non garanzie di prestazioni hardware‑neutrali; i dettagli degli harness specifici dei benchmark vanno consultati prima di riprodurli.
| Benchmark | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 | DeepSeek V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Codeforces Rating | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | 7.6 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | 7.0 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
Lo schema è più importante di qualsiasi singolo punteggio. V4.1-Flash non guida ogni benchmark, ma il salto rispetto a V4 Flash 0731 è particolarmente grande su Terminal-Bench, DeepSWE, automazione e cybersecurity. Questo rende il deployment locale particolarmente rilevante per agenti di coding privati, analisi su scala repository, automazione interna e infrastrutture di agenti in ambienti air‑gapped.
Si può davvero eseguire DeepSeek-V4.1-Flash in locale?
Sì, ma il termine “in locale” richiede una precisazione. L’ultima ricetta vLLM per DeepSeek-V4.1-Flash scompone il checkpoint in circa mezzo terabyte e raccomanda un budget di VRAM molto più ampio una volta inclusa l’overhead runtime.
| Componente | Dimensione approssimativa su disco |
|---|---|
| Esperti instradati + DSpark | 259.5 GiB |
| Tabelle Engram | 183.1 GiB |
| Attenzione, proiezioni dense e router | 6.9 GiB |
| Embeddings, testa LM e normalizzazioni | 3.9 GiB |
| Scale dei blocchi UE8M0 | 21.9 GiB |
| Checkpoint completo | ~476 GiB / ~511 GB |
| Budget minimo di VRAM consigliato da vLLM | ~614 GB |
La sorpresa chiave è che V4.1-Flash è già pesantemente compresso internamente. I pesi degli esperti instradati usano formati a bassa precisione, quindi il checkpoint ufficiale non è semplicemente un enorme modello BF16 in attesa di una facile conversione a 4 bit.
Requisiti hardware di DeepSeek-V4.1-Flash
| Configurazione hardware | Stato pratico | Commenti |
|---|---|---|
| 1× RTX 4090 / 5090 | No | Ben al di sotto dell’impronta di memoria del modello |
| 2–4 GPU consumer | No per il checkpoint completo | La VRAM aggregata rimane insufficiente |
| Workstation da 128 GB | No | I parametri attivi non determinano la memoria dei pesi residenti |
| Workstation da 256 GB | No per il percorso ufficiale | Ancora ben al di sotto dell’impronta del checkpoint ufficiale |
| 512 GB di RAM + offload su GPU | Sperimentale | Territorio community/offload, non equivalente a un serving di produzione |
| 4× GPU datacenter ad alta memoria | Dipende dall’hardware | Possibile con acceleratori moderni sufficientemente capienti; verificare la ricetta runtime |
| 8× H200 | Sì, classe documentata | Circa 1,128 GB di HBM aggregata |
| Sistema classe GB200 NVL4 | Sì | vLLM indica che un tray da 768 GB può ospitare il modello |
Importante: 8B parametri attivi non significa 8 GB di VRAM. “Attivi” descrive quanta parte della rete MoE partecipa al calcolo di un token. L’intero set di esperti deve comunque essere archiviato da qualche parte e accessibile al motore di inferenza.
Quale runtime usare per DeepSeek-V4.1-Flash?
| Runtime | Stato attuale su V4.1-Flash | Uso migliore |
|---|---|---|
| vLLM | Ricetta di deployment aggiornata disponibile; serve un’immagine recente | Serving di produzione compatibile OpenAI |
| SGLang | Supportato nelle build attuali di deployment DeepSeek-V4.1 | Inferenza distribuita ad alte prestazioni |
| DeepSeek reference inference | Implementazione TP8 di riferimento ufficiale | Ricerca architetturale e validazione |
| Transformers | Integrazione del modello esposta su Hugging Face | Sviluppo ed esperimenti; serve comunque l’hardware |
| Ollama | Il percorso ufficiale attuale usa :cloud | Invocazione cloud comoda, non equivalente a auto-ospitare |
Per l’auto-ospitare in produzione, vLLM è attualmente il punto di partenza più chiaro. Le indicazioni di deployment SGLang offrono un altro percorso supportato per un’inferenza distribuita avanzata.
Come eseguire DeepSeek-V4.1-Flash in locale con vLLM
Questo è il percorso pratico per un server Linux multi-GPU.
Tutti gli esempi di comandi qui sotto sono riformattati come blocchi di codice specifici per lingua con descrizioni concise in inglese.
Passo 1: Verifica dell’ambiente
- Linux.
- Docker.
- NVIDIA Container Toolkit.
- Diverse centinaia di gigabyte di spazio SSD libero.
- Una configurazione multi-GPU supportata.
- Circa 614 GB di memoria dell’acceleratore aggregata utilizzabile per il profilo di serving con pesi ufficiali attuale.
- Una rete veloce se il modello non è già in cache in locale.
Passo 2: Scaricare i pesi di DeepSeek-V4.1-Flash
I pesi ufficiali sono ospitati nel repository Hugging Face di DeepSeek-V4.1-Flash sotto licenza MIT.
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
Assicurati che il filesystem che ospita ~/.cache/huggingface abbia molto più di 511 GB liberi. File temporanei e ulteriori artefatti dell’engine possono aumentare il picco di uso del disco.
Passo 3: Avviare DeepSeek-V4.1-Flash con vLLM
Secondo l’attuale ricetta vLLM, il supporto a DeepSeek-V4.1 richiede un’immagine vLLM sufficientemente recente. Una configurazione iniziale solo‑testo con otto GPU può assomigliare a questa:
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  vllm/vllm-openai:nightly \
  deepseek-ai/DeepSeek-V4.1-Flash \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 8 \
  --language-model-only \
  --tokenizer-mode deepseek_v41 \
  --tool-call-parser deepseek_v41 \
  --reasoning-parser deepseek_v41 \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.90 \
  --max-model-len 131072
Qui ci sono due scelte deliberate. Primo, --language-model-only disabilita l’encoder di visione per carichi di lavoro solo testo. Secondo, partire da 131,072 token è più prudente che abilitare subito il contesto completo da un milione di token. Una volta che il server è stabile, puoi aumentarlo:
--max-model-len 1048576
L’impostazione appropriata di tensor parallel dipende dalla topologia degli acceleratori, quindi non copiare ciecamente --tensor-parallel-size 8 su ogni server.
Passo 4: Testare l’endpoint locale di DeepSeek-V4.1-Flash
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "Quanto fa 17 * 19? Restituisci solo l'intero."
      }
    ]
  }'
323
Passo 5: Chiamare il server locale DeepSeek-V4.1-Flash con Python
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Spiega la differenza tra TCP e UDP in tre punti."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
Come abilitare in locale la modalità di “thinking” di DeepSeek-V4.1-Flash?
V4.1-Flash supporta controlli espliciti di ragionamento attraverso il suo chat template. Un esempio è:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Trova l'algoritmo più efficiente per questo problema di scheduling."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
Se il modello sembra restituire poco o nessun contenuto finale con un valore piccolo di max_tokens, verifica se la modalità thinking sta consumando il budget di generazione prima di supporre che il deployment sia rotto.
Come eseguire DeepSeek-V4.1-Flash con il codice di riferimento?
DeepSeek include anche un’implementazione minima di inferenza TP8 all’interno del repository del modello. È pensata principalmente come codice di riferimento leggibile piuttosto che come server di produzione ad alto throughput.
cd inference
python -m pip install -r requirements.txt
export HF_CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-HF
export SAVE_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

python convert.py \
  --hf-ckpt-path "${HF_CKPT_PATH}" \
  --save-path "${SAVE_PATH}" \
  --model-parallel "${MP}" \
  --expert-dtype fp4 \
  --tokenizer-path "${HF_CKPT_PATH}"
export CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

torchrun --nproc-per-node "${MP}" generate.py \
  --ckpt-path "${CKPT_PATH}" \
  --config config.json \
  --interactive \
  --temperature 0.6
Questo percorso è utile per ispezionare CED, routing MoE, memoria Engram, decodifica speculativa e relativi dettagli di implementazione. Per il serving normale in produzione, vLLM o SGLang sono più facili da operare.
Si può eseguire DeepSeek-V4.1-Flash in locale con Ollama?
Non nello stesso senso dell’esecuzione di un normale modello 7B o 32B in Ollama. Ollama attualmente espone V4.1-Flash tramite:
ollama run deepseek-v4.1-flash:cloud
La parte importante è :cloud. L’attuale voce della libreria di Ollama usa un percorso cloud, quindi questo comando non equivale a scaricare il modello completo ed eseguire l’inferenza interamente sulla tua macchina.
Deployment locale di DeepSeek-V4.1-Flash vs API: quale ha più senso?
| Dimensione | DeepSeek-V4.1-Flash locale | API ospitata |
|---|---|---|
| Hardware iniziale | Molto elevato | Nessuno |
| Memoria dell’acceleratore | ~614 GB target ufficiale pratico | Gestita dal provider |
| Controllo del modello | Completo | Limitato |
| Dati restano on‑prem | Sì | No |
| Modifica dei pesi | Sì | No |
| Manutenzione | A tuo carico | Gestita dal provider |
| Complessità di setup | Alta | Bassa |
| Scalabilità | Richiede infrastruttura | Basata su API |
| Ideale per | Air‑gapped, privacy, ricerca, cluster ad alto utilizzo | La maggior parte degli sviluppatori e app in produzione |
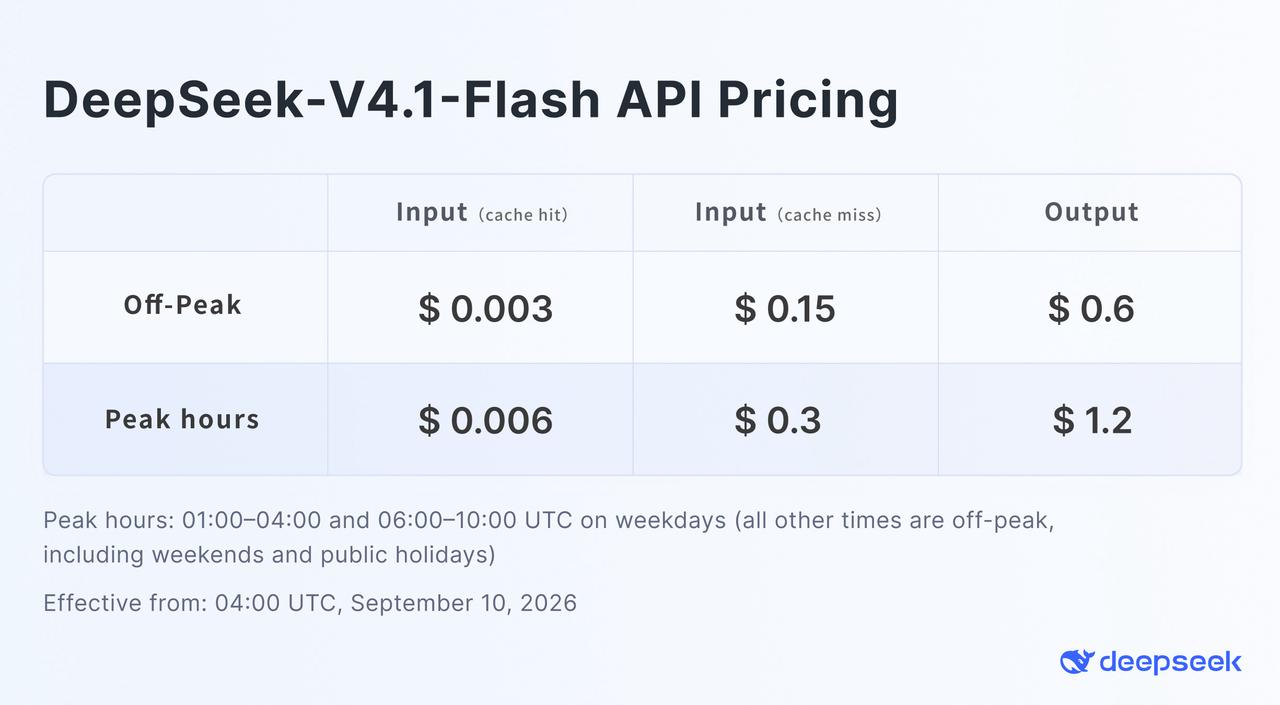
Il pricing ufficiale off‑peak di DeepSeek è mostrato nel grafico di pricing di V4.1-Flash. Per gli sviluppatori che non hanno bisogno del possesso fisico dei pesi, l’API DeepSeek V4.1 Flash in CometAPI fornisce un’alternativa compatibile OpenAI.
L’esempio seguente usa l’identificatore del modello di CometAPI. Non è l’identificatore usato dall’API ufficiale di DeepSeek.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Analizza questa funzione Python e individua possibili condizioni di race."
        }
    ]
)

print(response.choices[0].message.content)
La decisione pratica è semplice: il deployment locale diventa convincente quando privacy, operazioni air‑gapped, sperimentazione a livello di pesi, utilizzo prevedibilmente elevato o requisiti normativi superano il costo infrastrutturale. Per lo sviluppo applicativo ordinario, un endpoint ospitato evita centinaia di gigabyte di gestione del modello e l’orchestrazione multi‑GPU.
Quali problemi puoi incontrare eseguendo DeepSeek-V4.1-Flash in locale?
Il server esaurisce la memoria prima che inizi la generazione
Il checkpoint completo, non il numero 8B/16B di parametri attivi, determina la maggior parte del requisito di memoria. Verifica tensor parallelism, utilizzo della memoria GPU, caricamento della visione e HBM disponibile.
DeepSeek-V4.1-Flash impiega molto ad avviarsi
Un checkpoint da mezzo terabyte richiede tempo per essere scaricato, mappato, inizializzato e shardato. Lunghi timeout di prontezza dell’engine sono normali per questa classe di modello.
La risposta è vuota o termina con finish_reason=length
La modalità thinking potrebbe star consumando il budget di generazione. Aumenta max_tokens, riduci lo sforzo di ragionamento o disabilita il thinking per richieste semplici.
Le chiamate agli strumenti non vengono parse correttamente
Assicurati che il server stia usando il tokenizer DeepSeek V4.1, il parser delle tool‑call, il parser di reasoning e i flag di auto‑tool‑choice.
L’input visivo non funziona
Se hai lanciato con --language-model-only, hai intenzionalmente disabilitato l’encoder visivo. Riavvia con il supporto multimodale abilitato prima di testare le immagini.
Dovresti eseguire DeepSeek-V4.1-Flash in locale?
DeepSeek-V4.1-Flash è particolarmente interessante dal punto di vista dell’auto‑ospitare perché la sua architettura riduce in modo sostanziale il compute per token e il costo della cache KV, ma non trasforma un modello open‑weight di classe frontier in un modello da desktop.
Per un laboratorio di ricerca, una piattaforma AI enterprise, uno stack di coding agent privato o un ambiente air‑gapped, vLLM e SGLang rendono tecnicamente realistico l’auto‑serving. Per uno sviluppatore con una o due GPU, non è un target pratico per il deployment del modello completo. In tal caso, usare DeepSeek V4.1 Flash tramite CometAPI offre accesso al modello senza trasformare il serving in un grande progetto infrastrutturale.
FAQ
DeepSeek-V4.1-Flash è open source?
I pesi del modello e il repository sono rilasciati sotto licenza MIT, che consente ampio uso, modifica e redistribuzione soggetti ai termini della licenza.
Posso eseguire DeepSeek-V4.1-Flash su una RTX 4090 o RTX 5090?
Non il modello completo ufficiale. Una singola GPU consumer ha solo una frazione della memoria richiesta dal checkpoint completo.
8B di parametri attivi significa che DeepSeek-V4.1-Flash richiede solo 8 GB di VRAM?
No. La cifra 8B descrive i parametri che partecipano durante l’elaborazione del prompt. L’intera rete di esperti e lo stato di supporto devono comunque essere memorizzati e accessibili.
Quanta VRAM serve a DeepSeek-V4.1-Flash?
L’attuale ricetta vLLM usa circa 614 GB come cifra di pianificazione per il checkpoint ufficiale più l’overhead runtime. Le necessità reali variano con hardware, dimensione di batch, contesto, supporto visivo e configurazione di serving.
Quanto è grande DeepSeek-V4.1-Flash su disco?
L’attuale scomposizione vLLM colloca il checkpoint a circa 476 GiB, ovvero circa 511 GB.
DeepSeek-V4.1-Flash può eseguire un contesto da 1M di token in locale?
L’architettura supporta fino a 1,048,576 token, ma l’uso pratico di memoria dipende anche da dimensione del batch, buffer runtime, stato della visione e altra overhead.
Posso eseguire DeepSeek-V4.1-Flash in locale con Ollama?
L’attuale voce di Ollama usa un percorso :cloud, che non è la stessa cosa che eseguire i pesi completi interamente sulla tua macchina.
È meglio vLLM o SGLang per DeepSeek-V4.1-Flash?
Entrambi puntano al serving ad alte prestazioni. vLLM ha attualmente una ricetta particolarmente dettagliata specifica per V4.1, mentre SGLang è adatto anche a deployment distribuiti avanzati.
Qual è il modo più semplice per usare DeepSeek-V4.1-Flash senza hardware locale?
Usare un’API ospitata. DeepSeek fornisce la propria API, mentre CometAPI offre un endpoint DeepSeek‑V4.1‑Flash compatibile OpenAI accanto ad altri modelli AI.