Crea con CometAPITi serve una sola API per più modelli?Testa il flusso di lavoro in Playground, poi crea una chiave API quando modello e costo sono adatti al tuo caso d'uso.
Hy4 vs GPT-6.1 Terra: benchmark, prezzi delle API e quale modello scegliere
Confronta Hy4 e GPT-6.1 Terra in termini di programmazione, ricerca, specifiche API ufficiali e prezzi di CometAPI. Trova il modello giusto per il tuo carico di lavoro.
Deon GoodwinTeam di ricerca su modelli AI e API
Aggiornato Nov 14, 2026 11 min di lettura
Risposta subito
Confronta Hy4 e GPT-6.1 Terra in termini di programmazione, ricerca, specifiche API ufficiali e prezzi di CometAPI. Trova il modello giusto per il tuo carico di lavoro.
Usa questo riepilogo per una risposta rapida, poi leggi la guida per contesto, esempi e dettagli di implementazione.
Hy4 è un ottimo punto di partenza per la ricerca finanziaria e la generazione di testo ad alto volume; GPT-6.1 Terra è un ottimo punto di partenza per la programmazione da terminale e il debugging. Entrambi accettano testo e immagini e supportano l’uso di strumenti. Le differenze più evidenti riguardano prestazioni sui compiti, capacità di output e prezzo: Terra guida il test di programmazione da terminale qui sotto, mentre Hy4 è in vantaggio nei test di finanza e ricerca e costa meno alle tariffe CometAPI indicate.
Key Takeaways
Scegli in base al carico di lavoro: Hy4 per ricerca e applicazioni con output elevato; Terra per programmazione da terminale e debugging.
Entrambi offrono finestre di contesto di circa un milione di token. Terra fornisce un budget di output massimo più ampio.
Revisionato per chiarezza, attribuzione delle fonti e terminologia API aggiornata.
Terra guida Terminal-Bench 4.0 di 10.10 punti percentuali; il modello di Tencent guida Finance Agent v2.1 di 8.74 punti nei risultati di Vals AI.
Nell’esempio CometAPI con 10M token di input e 2M di output il costo è $10.672 contro $16.00 alle tariffe base visualizzate.
Abbina endpoint, comportamento degli strumenti e impostazioni di ragionamento alla tua applicazione prima di cambiare provider.
Specifiche, istantanee dei benchmark e prezzi verificati il 6 novembre 2026.
Hy4 vs GPT-6.1 Terra: Specifiche e capacità
Hy4 combina comprensione di testo e immagini con ragionamento e uso di strumenti, inclusi flussi di lavoro tra riga di comando e interfacce grafiche. GPT-6.1 Terra supporta ragionamento visivo, uso del computer e scrittura, con controlli espliciti dello sforzo di ragionamento e un budget di output più ampio. La tabella seguente confronta le specifiche fornite da Tencent e OpenAI.
Specifiche API ufficiali
Entrambi i modelli possono lavorare con grandi raccolte di documenti e codebase. Per prompt lunghi, considera anche spazio per la risposta: Tencent indica un input massimo di 960K per Hy4. La piccola differenza nella capacità di contesto pubblicizzata è meno utile per la scelta rispetto a quanto accuratamente ciascun modello utilizza il tuo materiale.
Terra offre più spazio per una risposta lunga, con fino a 128,000 token di output rispetto al limite pubblicato di 64K di Hy4. Questo aiuta quando un report o un deliverable di codice deve rientrare in un’unica risposta. I token di ragionamento consumano anch’essi il budget di output di Terra.
Controlli del ragionamento
Terra offre sei impostazioni di sforzo di ragionamento: none, low, medium, high, xhigh e max, con medium come predefinita. Questo fornisce alle applicazioni un modo esplicito per regolare lo sforzo di inferenza in base al compito. Una richiesta di classificazione e un compito di debugging difficile non devono necessariamente usare lo stesso budget.
Il lancio di Tencent descrive il ragionamento combinato con percezione visiva e uso di strumenti, ma non definisce un controllo equivalente a sei livelli in quell’annuncio. Considera i parametri di ragionamento come specifici dell’endpoint: non copiare l’impostazione di sforzo di un provider in un’altra richiesta assumendo che abbia lo stesso significato.
Hy4 vs GPT-6.1 Terra: Prestazioni
Vals AI fornisce risultati diretti per entrambi i modelli su attività di coding, finanza, ricerca legale e fiscale. Questi punteggi mostrano dove ciascun modello è un candidato utile per il tuo carico di lavoro.
Risultati indipendenti dei benchmark e condizioni di test
I seguenti risultati Vals Index v2.2 sono stati verificati il 10 novembre 2026. Punteggi più alti sono migliori.
Vals AI indica temperature 0.9, top_p 1.0 e un limite di output di 65,536 token per Hy4; Terra usa lo sforzo di ragionamento massimo e un limite di output di 128,000 token. Queste impostazioni differiscono, quindi leggi i risultati come confronti delle configurazioni testate piuttosto che come esecuzioni a budget uguale.
Il vantaggio di Terra è maggiore sui compiti da terminale rispetto alla generazione di codice: 10.10 punti percentuali su Terminal-Bench 4.0 contro 2.99 punti su Vibe Code Bench. Questo rende il debugging e lo sviluppo da riga di comando i campi più chiari da cui iniziare a valutare Terra.
Hy4 è in vantaggio su Finance Agent, Legal Research Bench e Tax Agent Bench di 8.74, 15.39 e 17.32 punti percentuali. I flussi di lavoro di ricerca che raccolgono prove e applicano regole di dominio sono quindi punti di partenza promettenti per Hy4.
Il divario complessivo è di 1.19 punti percentuali e gli intervalli di incertezza pubblicati si sovrappongono.
Benchmark del lancio di Hy4 di Tencent
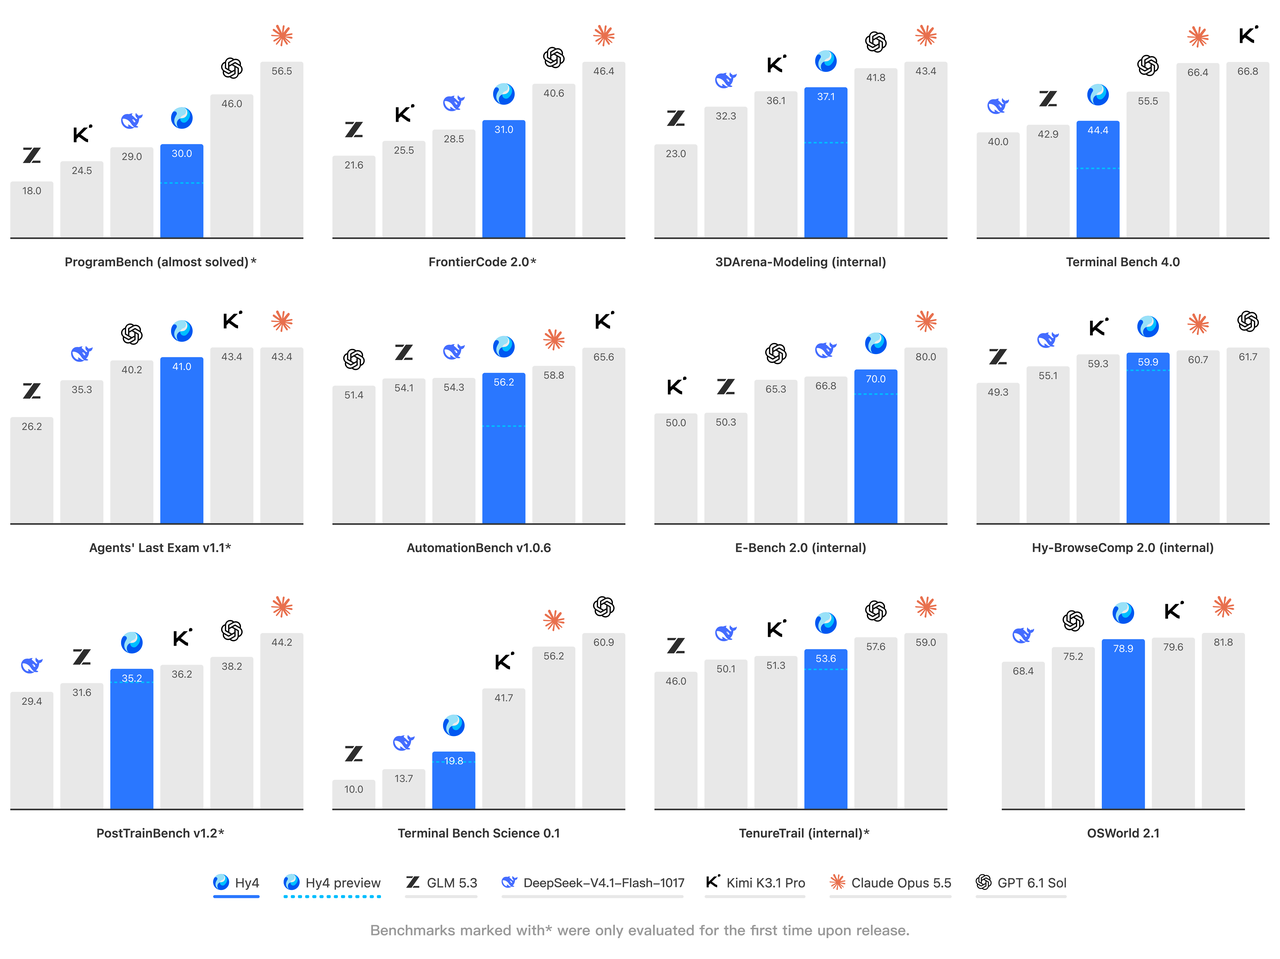
Il grafico di lancio di Tencent aggiunge risultati per coding e uso del computer. Confronta Hy4 con GPT-6.1 Sol; utilizza la tabella Vals AI sopra per il confronto diretto con GPT-6.1 Terra.
Risultati dei benchmark di Hy4 riportati da Tencent, novembre 2026. Il modello OpenAI mostrato è GPT-6.1 Sol.
Nel grafico di lancio di Tencent, Hy4 ottiene 44.4 su Terminal Bench 4.0 e 78.9 su OSWorld 2.1. Queste cifre descrivono l’impostazione di valutazione di Tencent e sono separate dai punteggi Vals AI sopra.
Flussi di lavoro di visione e uso del computer
Tencent introduce la comprensione delle immagini nel rilascio ufficiale e descrive l’addestramento per flussi di lavoro che spaziano tra strumenti da riga di comando, interfacce grafiche, Blender e CAD. Questo rende l’analisi di grafici e i compiti software visivi elementi centrali del posizionamento.
OpenAI posiziona il suo modello per flussi di lavoro basati su schermo, scrittura concisa e correzioni di codice con ambito definito. Per un’applicazione di catalogo, testa il matching delle foto di prodotto; per lavoro tecnico, usa disegni con etichette e misure piccole; per l’automazione desktop, verifica i file salvati e lo stato dell’applicazione.
Un buon set di test visivi dovrebbe separare la lettura dall’azione. Misura prima se il modello estrae i valori corretti o identifica l’elemento d’interfaccia giusto. Poi misura se il flusso di lavoro completo raggiunge il risultato richiesto senza clic errati, file mancanti o interventi umani non necessari.
Velocità e latenza end-to-end
Per la chat, le misure di velocità rilevanti sono quanto presto inizia la risposta e quanto tempo impiega a terminare. Per gli agenti, misura il compito completo, inclusa l’esecuzione degli strumenti e le eventuali correzioni.
Confronta entrambi i modelli su compiti tipici e impegnativi alla concorrenza attesa. Traccia latenza mediana e in coda insieme al completamento riuscito: una risposta veloce è utile solo se porta a termine il lavoro.
Hy4 vs GPT-6.1 Terra: Costo
Confronta prima le tariffe per token, poi considera il lavoro richiesto per ottenere un risultato utilizzabile. I prezzi sotto sono tariffe base CometAPI in dollari statunitensi per milione di token; sono separati dalle cifre di costo per test riportate da Vals AI.
Prezzi di input e output su CometAPI
Voce di costo
API Hy4 in CometAPI
API GPT-6.1 Terra in CometAPI
Input per milione di token
$0.6672
$0.80
Output per milione di token
$2.00
$4.00
La tabella sotto utilizza le tariffe base elencate da CometAPI in dollari statunitensi per milione di token. Confronta separatamente input e output, poi calcola il costo della tua richiesta tipica.
Costo di esempio per 10,000 richieste
Considera 10,000 richieste, ciascuna con 1,000 token di input non in cache e 200 token di output fatturabili. In totale, sono 10 milioni di token di input e 2 milioni di token di output. Utilizzando i prezzi base di CometAPI sopra:
Hy4 costa circa il 33.3% in meno in questo esempio. Questa stima copre input non in cache e output fatturabile; aggiungi costi di cache, strumenti e retry quando definisci il budget di un flusso di lavoro completo.
Fatturazione diretta del provider e richieste con contesto lungo
Per documenti lunghi sull’API diretta di OpenAI, prompt oltre 272K token di input attivano tariffe 2× per input e cache e 1.5× per l’output per l’intera richiesta. Applica le regole di fatturazione del servizio che utilizzi; l’esempio CometAPI sopra usa le tariffe base di CometAPI. Dettagli sui prezzi di OpenAI.
Costo per attività accettata
Un’attività accettata è quella che soddisfa i controlli di qualità e completamento della tua applicazione. Conta tutti i tentativi, l’uso degli strumenti e il lavoro di revisione necessari per arrivare a quel risultato, includendo la spesa per i tentativi che falliscono.
Costo per attività accettata = costi totali di modello, retry, strumenti e revisione umana ÷ attività che superano i controlli di accettazione.
Una chiamata più costosa può comunque essere economica se elimina diversi tentativi di riparazione. Al contrario, quando un modello a costo inferiore soddisfa la soglia di qualità, pagare una tariffa più alta per ogni attività può aggiungere poco valore.
Quale modello dovresti scegliere: Hy4 o GPT-6.1 Terra?
Inizia con il modello i cui punti di forza corrispondono al tuo carico di lavoro principale. Usa le scelte seguenti per costruire una shortlist, poi confronta qualità e costo dei compiti completati.
Quando scegliere Hy4
Scegli Hy4 per primo per la ricerca finanziaria, l’analisi di documenti legali o fiscali e applicazioni che generano molto testo. I suoi vantaggi sui tre benchmark di dominio lo rendono un candidato utile per ricerche ricche di evidenze. Alle tariffe CometAPI indicate, il suo prezzo di output è la metà di quello di Terra, il che può fare una differenza significativa per la redazione e la reportistica ad alto volume.
Per il lavoro di ricerca, valuta la risposta finale in base all’accuratezza delle fonti, ai calcoli e alla copertura della domanda. Hy4 è la scelta migliore quando soddisfa tali requisiti a un costo totale inferiore, inclusi revisione e retry.
Quando scegliere GPT-6.1 Terra
Scegli GPT-6.1 Terra per primo per programmazione da terminale, debugging e correzioni di codice. Il suo vantaggio di 10.10 punti su Terminal-Bench è il segnale più forte lato coding in questo confronto. Il budget di output più ampio lo rende anche degno di test per report lunghi e risposte di codice sostanziali.
Valuta Terra in base al fatto che le sue patch superino i test e i suoi deliverable siano completi. Per lavoro visivo o desktop, confronta entrambi i modelli sui tuoi schermi, grafici e file reali, verificando il risultato finale salvato.
Instradare ricerca e codice a modelli diversi
Un carico di lavoro misto può trarre vantaggio dall’uso di entrambi i modelli. Un assistente di analisi finanziaria potrebbe usare Hy4 per ricerca e redazione del report, poi chiamare Terra quando uno script di analisi necessita di debugging:
Invia la raccolta di evidenze e la redazione del report a Hy4.
Verifica citazioni, valori di fonte e calcoli prima di accettare il report.
Instrada uno script di analisi che fallisce a Terra con il codice, l’output di errore e il comportamento atteso.
Esegui lo script corretto e applica gli stessi controlli sulle evidenze prima di restituire il risultato finale.
Usa un secondo modello quando migliora il risultato finale a sufficienza da coprire il costo extra e il lavoro di integrazione.
Dove è possibile accedere a Hy4 e GPT-6.1 Terra?
Accesso tramite provider ufficiali
Accedi a Hy4 tramite Tencent Cloud TokenHub e a GPT-6.1 Terra tramite API di OpenAI. Usa la documentazione del provider per autenticazione, ID modello e fatturazione.
Accesso tramite CometAPI e compatibilità degli strumenti
CometAPI offre entrambi i modelli con gli ID hy4 e gpt-6.1-terra. Le sue pagine modello elencano esempi di richieste e prezzi per ciascun instradamento: Hy4 e GPT-6.1 Terra.
Per applicazioni con strumenti abilitati, verifica il supporto dell’instradamento selezionato per function call e output strutturati. Sull’API diretta di OpenAI, la chiamata di strumenti di Terra richiede la Responses API.
Come testare e distribuire la tua scelta
Prima di modificare il traffico in produzione, confronta i modelli su compiti rappresentativi utilizzando gli stessi input, strumenti e criteri di superamento. Registra completamenti riusciti, costo totale e tempo trascorso, poi distribuisci gradualmente l’instradamento più forte.
Includi richieste di routine e casi difficili importanti per i tuoi utenti.
Controlla argomenti degli strumenti, output strutturati, errori e stato di completamento.
Imposta limiti di retry e trigger di rollback prima di inviare traffico live.
Conclusione
Scegli Hy4 quando la qualità della ricerca e i costi inferiori di generazione del testo sono le tue priorità. Scegli GPT-6.1 Terra quando programmazione da terminale, debugging e un budget di output più ampio contano di più.
Per un’applicazione mista, inizia con un modello per ogni carico di lavoro principale e aggiungi un secondo instradamento dove migliora i risultati. La scelta migliore è quella che completa i tuoi compiti con accuratezza a un costo sostenibile.
Specifica
Hy4 · specifiche ufficiali Tencent Cloud
GPT-6.1 Terra · specifiche ufficiali OpenAI
Sviluppatore
Tencent
OpenAI
ID modello API
hy4
gpt-6.1-terra
Input / output
Testo e immagini / testo
Testo e immagini / testo
Finestra di contesto
1024K token (notazione Tencent)
1,050,000 token
Output massimo
64K token (notazione Tencent)
128,000 token
Chiamata di strumenti
Supportato (Function Calling)
Supportato; richiede la Responses API
Output strutturati
Supportati
Supportati
Applicazioni principali
Ingegneria del software, analisi finanziaria e attività di agenti di lunga durata
Ragionamento visivo, uso del computer, scrittura e attività di codice con ambito definito
Benchmark o metrica
Hy4: risultati Vals AI
GPT-6.1 Terra: risultati Vals AI
Interpretazione
Vals Index
59.35% ± 1.08
60.54% ± 0.99
Terra +1.19 punti percentuali
Terminal-Bench 4.0
39.39%
49.49%
Terra +10.10 punti
Vibe Code Bench v1.1
81.01%
84.00%
Terra +2.99 punti
Finance Agent v2.1
64.70%
55.96%
Modello Tencent +8.74 punti
Legal Research Bench
41.35%
25.96%
Modello Tencent +15.39 punti
Tax Agent Bench
34.40%
17.08%
Modello Tencent +17.32 punti
Hy4 vs GPT-6.1 Terra: benchmark, prezzi delle API e quale modello scegliere - CometAPI