

TL;DR
Muse Wonder, Claude Opus 5.5 e GPT-6 Sol sono modelli ad alta capacità pensati per coding e workflow di agenti. Il nuovo Muse Wonder di Meta enfatizza memoria persistente ed esecuzione prolungata; Opus 5.5 guida l’indice aggregato di intelligenza citato; GPT-6 Sol ha le tariffe standard più basse per input e output a breve contesto in questo confronto, mentre il suo livello a lungo contesto è prezzato separatamente. Scegli in base a qualità del task rappresentativo, affidabilità e costo totale, non a un singolo punteggio in classifica.
Key Takeaways
- Intelligenza complessiva: Claude Opus 5.5 segna 58 contro 52 di Muse Wonder sull’Intelligence Index v4.3 riportato.
- Coding a lungo orizzonte: Muse Wonder ottiene 78.8 su DeepSWE 1.1 e 53.1 su SWE-Marathon; Opus 5.5 registra 74.2 e 46.3 nella tabella di Meta.
- Ragionamento a basso costo: GPT-6 Sol parte da $2 input / $10 output per milione di token tramite l’API standard a breve contesto di OpenAI.
- Agenti focalizzati sulla memoria: Muse Wonder introduce Active Memory e Active Focus.
- La disponibilità conta: Muse Wonder Full è un prodotto separato e più limitato rispetto al Muse Wonder standard accessibile agli sviluppatori.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol at a Glance
Scegli Muse Wonder per agenti persistenti e ingegneria di lunga durata, Claude Opus 5.5 per coding ampio e lavoro fortemente incentrato sul terminale, e GPT-6 Sol per costi token più bassi nel breve contesto standard.
| Decision factor | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Start testing with | Agenti persistenti e ingegneria estesa | Coding incentrato sul terminale e workflow pro | Coding e automazione sensibili al budget |
| Context window | 1,048,576 tokens | 1M tokens | 1,050,000 tokens |
| Published strength | DeepSWE 78.8; SWE-Marathon 53.1 | Intelligence Index 58; ProgramBench 70.5 | Standard input/output $2/$10 per 1M tokens |
| Standard input / output per 1M tokens | $4 / $20 | $4 / $20 | $2 / $10; livello a breve contesto |
| Provider access | Meta Model API; Full è un prodotto in abbonamento separato | Anthropic API | OpenAI API |
| Selection metric | Qualità dei task accettati e costo totale | Qualità dei task accettati e costo totale | Qualità dei task accettati e costo totale |
| Developer | Meta | Anthropic | OpenAI |
| Release | 12 ottobre 2026 | 22 settembre 2026 | 16 settembre 2026 |
| Input modalities | Testo, immagine, audio, video; input PDF documentati | Testo, immagine | Testo, immagine |
| Output | Testo | Testo | Testo |
| Distinctive capability | Active Memory e Active Focus | Workflow con strumenti e sotto-agenti | Sforzo di ragionamento configurabile e strumenti API |
Questa panoramica riassume specifiche datate e risultati pubblicati esaminati sotto. Le righe dei benchmark usano metodi di valutazione diversi, e tariffe token basse non determinano un costo inferiore per task riuscito. Muse Wonder standard e Muse Wonder Full sono opzioni di accesso distinte.
Le specifiche sono state verificate il 13 ottobre 2026. Le modalità e le funzionalità supportate dipendono dall’endpoint selezionato e dalla superficie di rilascio, inclusa la disponibilità audio. Le capacità a livello di modello non garantiscono supporto su ogni percorso del gateway.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Overview and Specifications
Muse Wonder: Persistent Agent Workflows
Meta ha introdotto Muse Wonder e Muse Wonder Full il 12 ottobre 2026. Muse Wonder standard enfatizza task professionali di lunga durata, memoria persistente degli agenti e recupero dagli ostacoli. Active Memory è pensato per recuperare contesto utile precedente, mentre Active Focus è progettato per sostenere il progresso su lavori multi-step. Meta indica coding, ricerca, analisi finanziaria e assistenza personale come scenari chiave.
Claude Opus 5.5: Professional Coding and Tool Use
Claude Opus 5.5 è mirato a coding, ragionamento e workflow professionali multi-strumento. Anthropic lo ha rilasciato il 22 settembre 2026. La sua finestra di contesto è di un milione di token, mentre i risultati di coding riportati sotto mostrano punti di forza che variano per benchmark.
GPT-6 Sol: Cost-Conscious Reasoning
GPT-6 Sol mira a combinare ragionamento forte e uso di strumenti con inferenza relativamente conveniente. Supporta workflow programmabili tramite l’ecosistema API di OpenAI. Le sue tariffe standard a breve contesto sono inferiori alle tariffe elencate per Claude Opus 5.5, sebbene l’economia end-to-end dipenda anche da retry e uso di token di ragionamento.
OpenAI descrive GPT-6 Sol come un modello per coding complesso e workflow agentici; il suo annuncio di rilascio fornisce i risultati di valutazione usati sotto. Questo articolo confronta le versioni di modello specificate, non ogni modello più recente nell’offerta di ciascun vendor.
Architecture and Reasoning Controls
Le fonti citate qui non forniscono un conteggio dei parametri e una scomposizione architetturale comparabile per tutti e tre i modelli. Non è quindi giustificata una classifica denso vs mixture-of-experts. Active Memory e Active Focus descrivono capacità degli agenti di Meta; non sostituiscono un’architettura neurale divulgata. GPT-6 Sol espone uno sforzo di ragionamento configurabile, mentre i punteggi riportati per Meta e Claude dipendono anche dallo sforzo e dall’impostazione di valutazione. Considera tali settaggi come parte della configurazione confrontata, non come misure intercambiabili di compute.
Risultato del confronto: Tutti e tre offrono ampie finestre di contesto e API per sviluppatori. Muse Wonder documenta modalità di input a livello di modello più ampie; Opus 5.5 e GPT-6 Sol enfatizzano workflow su testo e immagine. Capacità di contesto e disponibilità delle feature vanno comunque verificate sull’endpoint selezionato.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Performance
Published Benchmarks and Source Boundaries
La model card ufficiale di Meta offre confronti diretti Muse Wonder vs Claude Opus 5.5. OpenAI pubblica risultati di GPT-6 Sol separatamente, quindi i tre modelli non possono essere inseriti in una classifica pienamente controllata senza armonizzare harness di valutazione, versioni e impostazioni.
| Benchmark | Muse Wonder | Claude Opus 5.5 | Higher score |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.3 | 52 | 58 | Opus |
| Personal Superintelligence Index | 54.3 | 55.2 | Opus |
| Harvey LAB-AA | 10.0 | 4.2 | Muse |
| Vals Finance Agent V2 | 56.6 | 58.6 | Opus |
| AutomationBench-AA | 39.1 | 41.2 | Opus |
| JobBench | 70.5 | 75.4 | Opus |
| MemoryBench | 85.6 | 81.5 | Muse |
| Terminal-Bench 4.0-AA | 52.0 | 59.6 | Opus |
| DeepSWE 1.1 | 78.8 | 74.2 | Muse |
| SWE-Marathon | 53.1 | 46.3 | Muse |
| ProgramBench | 50.0 | 70.5 | Opus |
| HealthBench Pro | 60.5 | 65.6 | Opus |
La metodologia della model card ufficiale distingue test interni, valutazioni di terze parti e punteggi dei concorrenti riportati dai provider. La tabella riproduce i valori riportati; non stabilisce una prova uniforme e indipendentemente controllata su tutte le righe.
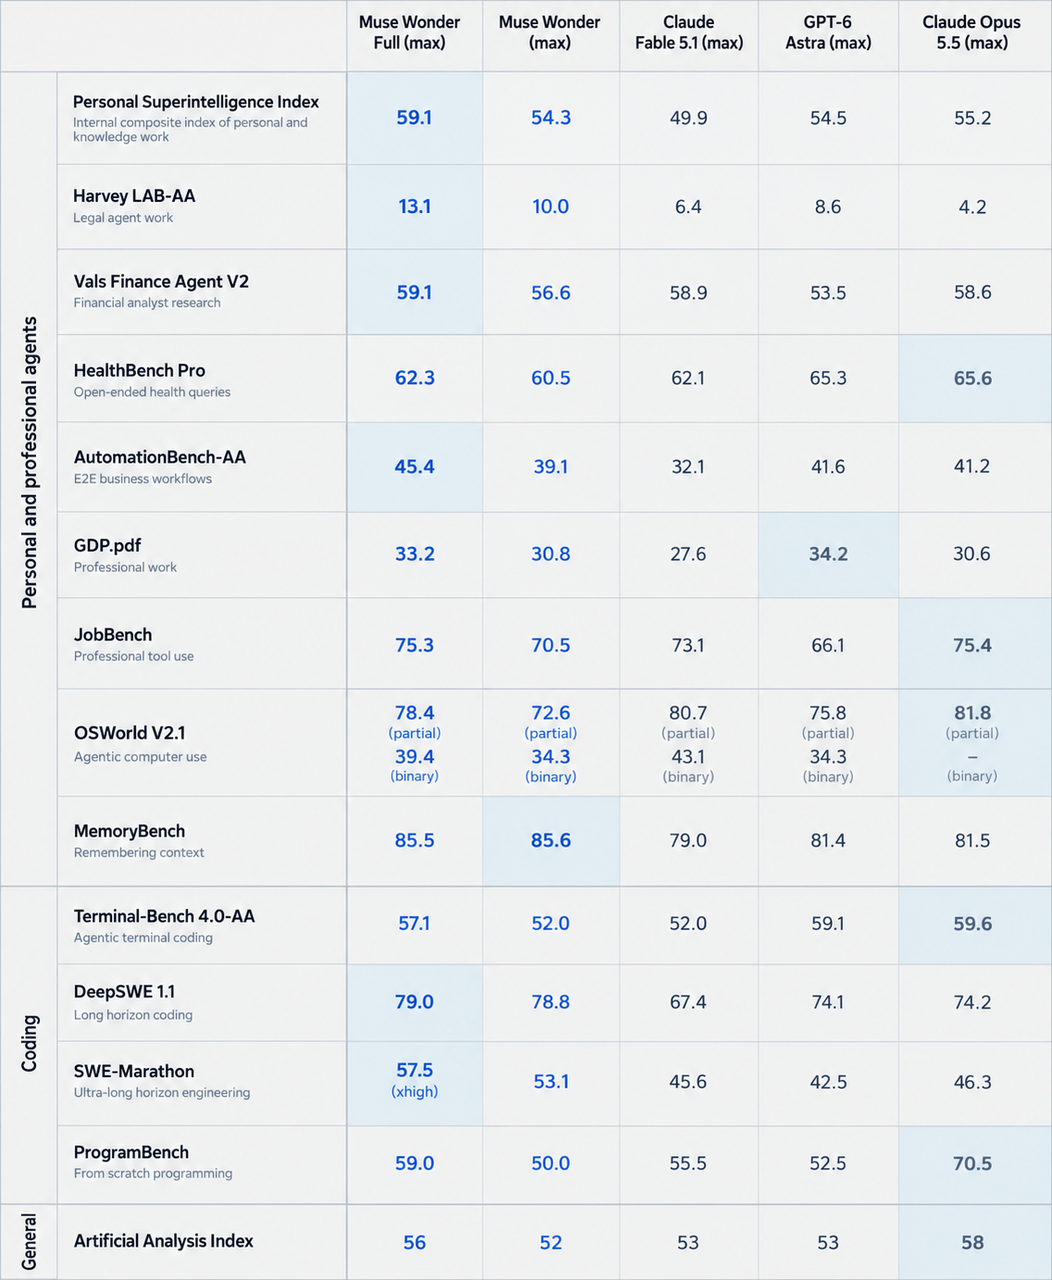
Scheda punteggi dei benchmark originale dalla model card di Meta per Muse Wonder, riprodotta senza ridisegno. Il modello OpenAI aggiuntivo mostrato in questa immagine ufficiale è GPT-6 Astra, non GPT-6 Sol. Le tabelle circostanti identificano i modelli rilevanti per questo articolo.
Evaluation Conditions
DeepSWE v1.1 copre 113 task su 91 repository e cinque linguaggi, valutati con test funzionali e di regressione usando pass@1; la scorecard di Meta usa risultati Datacurve per Muse Wonder e Opus 5.5. SWE-Marathon usa test di progetto e riporta pass@1 da Abundant AI; gli harness degli agenti variano e il punteggio di Wonder Full è marcato xhigh. ProgramBench usa mini-swe-agent e misura rollout che passano almeno il 95% dei test nascosti, con internet disabilitata dopo il setup. MemoryBench è un test interno di Meta su conversazioni da 64K–100K token valutato da un giudice LLM. Questi ambienti e metriche non vanno compressi in un unico punteggio di accuratezza generale.
Coding and Software Engineering
Muse Wonder guida su DeepSWE 1.1 e SWE-Marathon riportati. Claude Opus 5.5 guida su Terminal-Bench 4.0-AA e ProgramBench. Questa divisione suggerisce che ingegneria a lungo orizzonte, uso di strumenti da riga di comando e ricostruzione di programmi stressano abilità diverse.
GPT-6 Sol Results and Cross-Source Comparability
| Published OpenAI evaluation | GPT-6 Sol | Reported setting |
|---|---|---|
| DeepSWE 1.1 | 68.8% | Ragionamento massimo |
| AutomationBench 1.0.6 | 33.2% | ragionamento xhigh |
| Agents' Last Exam V1 | 56.4% | Ragionamento massimo |
| OSWorld 2.0 offline | 60.5% | ragionamento xhigh |
I risultati di valutazione pubblicati da OpenAI riportano i punteggi sopra. Il risultato su OSWorld è una ricompensa parziale sul set offline v2026.08.08, piuttosto che un tasso rigoroso di completamento dei task. OpenAI osserva che le valutazioni hanno usato il suo ambiente di ricerca o l’API; le configurazioni di produzione possono differire.
I punteggi DeepSWE riportati implicano un divario di 10.0 punti percentuali tra Muse Wonder e GPT-6 Sol, e un divario di 5.4 punti tra Opus 5.5 e GPT-6 Sol. Si tratta di differenze aritmetiche tra pubblicazioni, non stime controllate di un vantaggio dovuto solo al modello. Configurazioni di agenti diverse, prompt, livelli di sforzo e budget per gli strumenti possono influenzare il risultato.
Memory and Long-Running Agents
Muse Wonder è mirato ad agenti che devono ricordare decisioni precedenti, recuperare contesto e proseguire lavori interrotti. Active Memory può aiutare un assistente di ricerca a ricordare fatti specifici di progetto, mentre Active Focus supporta l’azione iterativa quando un piano precedente non ha successo. Queste capacità di prodotto non sostituiscono verifica dello stato, permessi, audit trail o conferma umana obbligatoria per azioni sensibili.
Muse Wonder Full Performance
Muse Wonder Full è una scelta di prodotto separata. Meta offre Muse Wonder standard tramite la sua API, mentre Full è limitato agli abbonamenti Power Usage e Maximum Usage in Muse Code. Un punteggio più alto non fa di Full un sostituto dell’API per il modello standard.
I risultati riportati da Meta per Wonder Full sono 56 su Intelligence Index, 59.1 su Personal Superintelligence, 13.1 su Harvey LAB-AA e 45.4 su AutomationBench-AA. Segna anche 79.0 su DeepSWE 1.1, 57.5 su SWE-Marathon, 85.5 su MemoryBench e 75.3 su JobBench. Questi risultati pubblicati descrivono il prodotto Full ad accesso separato; non sono nuove misurazioni da un confronto con harness comune.
Rispetto ai punteggi di Muse Wonder standard sopra, Full migliora in sette di queste otto misure riportate; MemoryBench è leggermente più basso a 85.5 contro 85.6. Opus 5.5 guida ancora l’Intelligence Index riportato a 58.
Latency and Reliability
Le evidenze citate non forniscono un confronto di latenza a tre modelli con corrispondenza. Misura il tempo al primo output utile, la durata end-to-end mediana e al 95° percentile, la frequenza di timeout e il completamento senza intervento. Mantieni fissi input dei task, permessi degli strumenti, concorrenza e criteri di accettazione; registra le impostazioni di sforzo e i budget di retry. Una generazione di token più veloce da sola non stabilisce un completamento più rapido di un task multi-step.
Risultato del confronto: Muse Wonder guida i test citati di ingegneria sostenuta, mentre Opus 5.5 guida i test citati di terminale e ricostruzione di programmi. GPT-6 Sol resta un candidato con prezzo token più basso, ma le pubblicazioni disponibili non provano una classifica di qualità o velocità in ambienti uguali per tutti e tre.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Cost
Official API Token Prices
| Price per 1M tokens | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Standard input | $4 | $4 | $2 |
| Standard output | $20 | $20 | $10 |
| Cached input | $0.20 | $0.20 | $0.20 |
| Long-context input | $4 | $4 | $4 |
| Long-context output | $20 | $20 | $15 |
| Long-context cached input | $0.20 | $0.20 | $0.40 |
Meta pubblica $4 input, $20 output e $0.20 input in cache per milione di token. Anthropic indica Opus 5.5 a $4 input, $20 output e $0.20 cache hit per milione di token. La tabella prezzi di OpenAI elenca GPT-6 Sol a $2/$10 per input/output a breve contesto e $4/$15 per lungo contesto; le tariffe per input in cache variano anche per livello. Applica il livello di contesto per richiesta rilevante, la modalità di elaborazione e le condizioni dell’endpoint prima di stimare un carico di lavoro.
Per GPT-6 Sol, richieste contenenti più di 272,000 token di input sono fatturate a tariffe più alte:
- Token di input: 2× la tariffa standard, da $2 a $4 per milione di token.
- Token di input in cache: 2× la tariffa standard, da $0.20 a $0.40 per milione di token.
- Token di output: 1.5× la tariffa standard, da $10 a $15 per milione di token.
Queste tariffe più alte si applicano all’intera richiesta, non solo ai token che superano 272,000. Una richiesta con 272,001 token di input entra quindi nel livello di prezzo a lungo contesto per tutti i suoi token di input, input in cache e output.
Per confronto, Muse Wonder e Claude Opus 5.5 non impongono un sovrapprezzo equivalente per il lungo contesto nelle loro tariffe API standard.
Questa distinzione è particolarmente importante per analisi di documenti di grandi dimensioni, coding a livello di repository e agenti IA di lunga durata, dove il vantaggio di prezzo a breve contesto di GPT-6 Sol può ridursi man mano che le richieste diventano più grandi.
CometAPI Pricing and Billing Conditions
Al momento della revisione, CometAPI elencava Opus 5.5 a $3.20 input / $16 output e GPT-6 Sol a $1.60 input / $8 output per milione di token. Queste sono tariffe indipendenti di CometAPI e non vanno confuse con i prezzi ufficiali dei provider sopra. Conferma percorso applicato, livello di contesto e condizioni di fatturazione dell’account prima di stimare il costo; prezzi e condizioni possono cambiare.
Cost per Accepted Task
Calcola il costo per task accettato come spesa totale addebitata per modello e strumenti, inclusi retry fatturati e fallback, divisa per il numero di output che soddisfano criteri di accettazione predefiniti. Registra separatamente il tempo di revisione umana o converti usando una tariffa oraria esplicita. Traccia richieste fallite e addebiti effettivi in modo indipendente: il solo fallimento non stabilisce se una richiesta sia stata fatturata.
Risultato del confronto: GPT-6 Sol ha le tariffe standard più basse elencate per input e output a breve contesto, mentre Muse Wonder e Opus 5.5 condividono le stesse tariffe base elencate. Il costo effettivo per task accettato dipende dal percorso di fatturazione selezionato, uso della cache, livelli di contesto, costi degli strumenti, retry e sforzo di revisione.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Comparison and Selection
Capability and Workload-Based Selection
- Per coding ampio e workflow da terminale, inizia con Claude Opus 5.5 perché guida gli Intelligence Index, Terminal-Bench e ProgramBench citati. Validalo su refactoring, esecuzione di strumenti e coerenza a livello di programma.
- Per progetti di ingegneria estesa, inizia con Muse Wonder perché i suoi risultati riportati su DeepSWE e SWE-Marathon sono più forti di quelli di Opus 5.5. Misura completamento dei task, recupero dagli ostacoli e costo totale del task.
- Per agenti personali persistenti, inizia con Muse Wonder perché offre Active Memory e Active Focus e ha un punteggio MemoryBench riportato più alto di Opus 5.5. Testa richiamo, correzioni, continuità e isolamento dei progetti.
- Per workflow multi-step con strumenti, valuta tutti e tre i modelli. Muse offre Active Focus, Opus enfatizza l’orchestrazione degli strumenti e GPT-6 Sol supporta gli strumenti della Responses API. Confronta l’intero stack dell’agente, inclusi permessi degli strumenti, retry e gestione dello stato.
- Per documenti professionali e analisi, valuta Muse Wonder o Claude Opus 5.5. Muse ha punti di forza specializzati, mentre Opus ha l’indice aggregato citato più forte. Usa documenti rappresentativi e criteri di accettazione specifici per il task.
- Per automazione ad alto volume e sensibile ai costi, inizia con GPT-6 Sol perché ha le tariffe standard più basse elencate per input e output a breve contesto. Verifica costo per task accettato, livelli di contesto, latenza e retry.
- Per l’opzione di fascia più alta di Meta, valuta Muse Wonder Full se è accessibile. Ha punteggi riportati più alti su diversi task specializzati, ma è separato dal modello API standard. Conferma accesso all’abbonamento e idoneità prima dei test.
Professional Coding
Claude Opus 5.5 è una buona scelta predefinita per team che richiedono un assistente di ingegneria ampio, in particolare dove contano esecuzione di strumenti, refactoring e coerenza a livello di programma. I suoi vantaggi riportati su Terminal-Bench e ProgramBench rafforzano il caso, sebbene i team debbano validare l’intero stack dell’agente e non solo il modello.
High-Volume Automation
GPT-6 Sol è interessante quando le richieste sono numerose e la sensibilità ai costi è alta. Anche un lieve deficit di qualità può essere accettabile per task a basso rischio e facilmente verificabili come stesura di documentazione, estrazione di campi strutturati o spiegazione del codice. Per esecuzioni autonome lunghe, traccia qualità, token, latenza e retry insieme.
Production Evaluation Checklist
La valutazione in produzione dovrebbe tracciare sei metriche: correttezza, misurata da risposte accettate o test superati; affidabilità, misurata da task completati senza intervento umano; latenza, misurata dalla durata end-to-end del task; uso dei token, misurato da input e output fatturati totali; efficienza dell’agente, misurata da invocazioni di strumenti e retry correttivi; e costo effettivo, calcolato come spesa totale divisa per task accettati.
Risultato del confronto: Metti in shortlist Muse Wonder per comportamento di agente persistente e attività ingegneristiche estese, Opus 5.5 per workflow di coding ampi con forti esigenze da terminale, e GPT-6 Sol quando il costo dei token è un vincolo principale. Promuovi un candidato solo dopo che raggiunge soglie di qualità e affidabilità specifiche del task.
Where Can You Access Muse Wonder, Claude Opus 5.5, and GPT-6 Sol?
Official Provider Access
Usa Meta Model API per Muse Wonder standard, Anthropic API per Opus 5.5 o OpenAI API per GPT-6 Sol. Muse Wonder Full è disponibile tramite i piani di abbonamento Muse Code specificati, non come sostituto plug-in del modello API standard. Verifica accesso all’account, limiti d’uso e feature di richiesta supportate per il percorso selezionato.
CometAPI Access
Un gateway unificato può semplificare autenticazione, fatturazione e instradamento. Usa un modello a prestazioni più alte per revisione architetturale complessa e un modello più economico per bozze ripetitive a basso rischio. L’identificatore del modello e il formato di richiesta supportato devono sempre essere verificati rispetto all’endpoint API di destinazione.
Gli sviluppatori possono accedere alla Claude Opus 5.5 API in CometAPI e alla GPT-6 Sol API in CometAPI per valutare carichi di lavoro rappresentativi. Conferma la superficie API supportata per ciascun modello invece di assumere che un gateway condiviso renda tutti i formati di richiesta intercambiabili.
I percorsi CometAPI citati in questo articolo coprono Opus 5.5 e GPT-6 Sol. Questo articolo non stabilisce un percorso CometAPI per Muse Wonder o Wonder Full; usa il percorso del provider confermato quando valuti quei prodotti.
Conclusion
Nessun singolo modello vince su ogni carico di lavoro. Muse Wonder è il candidato più forte da testare per comportamento di agente persistente e task ingegneristici di lunga durata. Claude Opus 5.5 è un forte candidato per coding ampio, workflow pesanti da terminale e knowledge work, e guida il valore dell’Artificial Analysis Intelligence Index riportato da Meta. GPT-6 Sol offre i prezzi token standard più bassi a breve contesto ed è attraente per automazione sensibile ai costi. I team di produzione dovrebbero effettuare la scelta finale usando qualità dei task accettati, affidabilità, latenza, retry, uso degli strumenti e costo totale su carichi di lavoro rappresentativi.
FAQ
How can teams fairly test Muse Wonder, Opus 5.5, and GPT-6 Sol?
Usa un set tenuto da parte di task reali con criteri di accettazione fissi, artefatti di input identici e permessi degli strumenti documentati. Registra ogni versione del modello, impostazione di sforzo, harness dell’agente, timeout e budget di token. Esegui prove ripetute dove gli output variano, riporta fallimenti oltre ai successi e separa un confronto con harness comune da un confronto di sistema al meglio della configurazione. Questo produce evidenze applicabili al tuo workflow piuttosto che al setup di benchmark di un altro team.
Can an API gateway preserve agent state when switching models?
Un indirizzo di gateway condiviso non garantisce di per sé stato di conversazione portabile, identificatori di chiamata agli strumenti o riferimenti a risposte archiviate. Mantieni un registro canonico lato applicazione di messaggi, output degli strumenti e stato del task validato. Testa stato e semantica degli strumenti di ciascun percorso prima di instradare un job in corso verso un altro modello; altrimenti un fallback più economico può perdere informazioni necessarie a terminare correttamente.
How should teams budget for retries and human review?
Definisci un risultato accettato prima del test, poi dividi la spesa totale addebitata per modello e strumenti per i risultati accettati. Riporta la manodopera di revisione separatamente o includila usando una tariffa oraria dichiarata. Conta i tentativi falliti, le chiamate correttive e i modelli di fallback, e confronta sia i task tipici sia quelli a costo elevato. Questo evita di trattare un prezzo token più basso come una riduzione garantita del costo del lavoro utile.
What should a memory-sensitive agent evaluation include?
Verifica se l’agente ricorda fatti rilevanti, incorpora correzioni, ignora istruzioni obsolete e mantiene progetti separati isolati. Includi follow-up ritardati e aggiornamenti contraddittori invece di solo un singolo prompt lungo. Controlla il comportamento della memoria a livello di applicazione oltre che a livello di modello, perché persistenza, recupero ed eliminazione dipendono dal sistema distribuito.