
TLDR OpenAI Bel è un’esecuzione interna di pretraining non confermata (nome in codice) riportata per la prima volta su X il 25 agosto 2026 da @synthwavedd. L’affermazione descrive un modello base completato con più di 10 trilioni di parametri totali—successore di una precedente esecuzione chiamata Doug—inteso come fondazione per sistemi post-GPT-6 e potenzialmente un modello “a soglia AGI” dopo ulteriore reinforcement learning.
Al 13 ottobre 2026, OpenAI non ha mai usato il nome Bel (o Doug nei materiali pubblici di prodotto), non ha pubblicato alcun conteggio di parametri, data di rilascio, benchmark o system card, e Bel non è disponibile via API o ChatGPT.
Punti chiave
- Bel ha origine da un singolo post su X di @synthwavedd del 25 agosto 2026; OpenAI non lo ha mai confermato.
- Scala dichiarata: >10T parametri totali, in una classe di dimensioni simile a GPT-4.5 secondo il post originale.
- Posizionato, nella voce di corridoio, come successore di “Doug” e base per sistemi post-GPT-6 / Astra dopo RL.
- GPT-6 Astra è disponibile pubblicamente dall’inizio di settembre 2026 ed è l’attuale punta di diamante di OpenAI.
- Non esistono benchmark indipendenti, data di rilascio, API, prezzi o pesi per Bel.
- Claude Fable 5.5 resta non annunciato; l’attuale modello di fascia alta Claude è Fable 5.1.
- Per l’uso in produzione oggi, instradare GPT-6 Astra / Sol / Luna e i modelli Claude tramite un’unica chiave su CometAPI per costi inferiori e zero vendor lock-in.
Che cos’è OpenAI Bel?
OpenAI Bel (talvolta stilizzato “BEL”) è il nome in codice che circola nelle discussioni della community AI per un presunto pretraining su larga scala che OpenAI avrebbe completato nella seconda metà di agosto 2026. Secondo il report originale, Bel è un modello di base grezzo—non un prodotto finito—con più di 10 trilioni di parametri totali. È inquadrato come successore di un progetto interno precedente chiamato Doug e come base che, dopo ulteriore apprendimento per rinforzo e post-training, potrebbe alimentare sistemi oltre GPT-6 Astra, raggiungendo potenzialmente un livello di capacità che alcuni addetti ai lavori avrebbero definito “a soglia AGI”.
È importante sottolineare che Bel non è GPT-7, non è un modello ChatGPT con cui gli utenti possono interagire e non è qualcosa disponibile tramite l’API di OpenAI. È descritto strettamente come un artefatto di pretraining—l’enorme rete neurale addestrata su testo (e possibilmente altri dati) che necessita ancora di ampio fine-tuning, allineamento e lavoro sulla sicurezza prima di diventare un prodotto distribuibile.
Bel è il nome in codice riportato per uno sforzo di modello foundation di OpenAI. L’affermazione è attribuita al post del 25 agosto 2026 di @synthwavedd su un pretraining completato. Il post riprodotto asserisce più di 10 trilioni di parametri totali e una relazione di successione rispetto a Doug. Questi dettagli restano affermazioni da singola fonte: lo screenshot documenta un’asserzione, non un risultato di training autenticato da OpenAI.
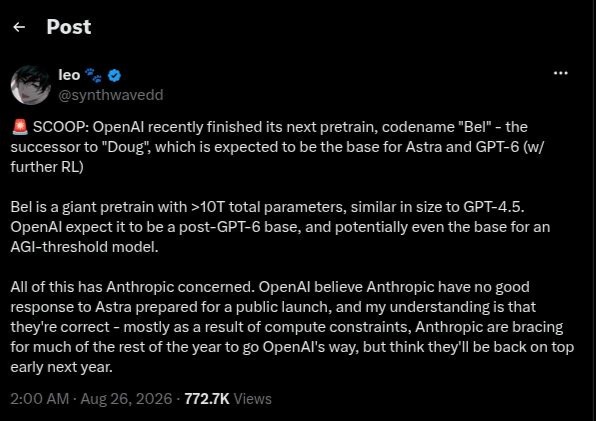
Lo screenshot è riprodotto dalla cattura di Mukhtada del post attribuito su X. Mostra il 26 agosto alle 2:00 nel contesto dell’ora di Giacarta della fonte, corrispondente al 25 agosto alle 19:00 UTC. È una cattura di terze parti, non una conferma indipendente del conteggio dei parametri, dello stato di training o di affermazioni competitive private.
Cronologia delle evidenze su Doug–Bel
Il contesto di Doug è separato: la pubblicazione di SemiAnalysis del 7 agosto riproduce una nota del 9 luglio che menziona un modello OpenAI più grande chiamato Doug. Questo precede il post su Bel, ma non autentica Doug → Bel né collega uno dei due nomi in codice a un prodotto rilasciato.
- 9 luglio 2026: Una nota di ricerca che menziona un modello OpenAI più grande chiamato Doug è stata poi riprodotta nell’articolo di SemiAnalysis pubblicato il 7 agosto. La data della nota e la data di pubblicazione sono traguardi diversi; questo è il contesto su Doug, non una conferma di Bel.
- 7 agosto 2026: SemiAnalysis ha pubblicato l’articolo che riproduce il riferimento a Doug. Precede l’asserzione su Bel ma non stabilisce un lignaggio Doug→Bel né un nome di prodotto pubblico.
- 25 agosto 2026: Il post attribuito di @synthwavedd ha asserito il completamento del pretraining di Bel e più di 10 trilioni di parametri totali. Una cattura di terze parti riproduce l’affermazione; non è una verifica indipendente.
- 1 settembre 2026: Il report Path to Astra citato in questo articolo fornisce il contesto su un programma separato di sviluppo di modelli. Non stabilisce l’identità di Bel, il suo conteggio di parametri o un collegamento a GPT-7 o a un possibile nome GPT-6 Bel.
- 23 settembre 2026: Una ricostruzione circolante attribuisce un’attesa di mesi a un post di follow-up dello stesso account. Poiché il testo originale non era direttamente accessibile nella revisione della fonte, questo resta un’indicazione temporale non verificata e non fornisce impegni di lancio.
- 12 ottobre 2026 — checkpoint di revisione dell’articolo: Il post attribuito su Bel, le segnalazioni su Doug e il report ufficiale separato citati qui non stabiliscono un’identità commerciale per Bel. Né GPT-7 né GPT-6 Bel sono confermati da questa catena di evidenze; questa data registra la revisione dell’articolo, non l’annuncio di un modello.
Nello stesso periodo, OpenAI ha discusso pubblicamente un modello interno senza nome “significativamente più capace di GPT-6 Astra” in relazione a lavori matematici (inclusi risultati legati alle equazioni di Navier-Stokes).
Due ipotesi di naming: GPT-7 o GPT-6 Bel?
Pretraining e rilascio di prodotto sono traguardi diversi. Un checkpoint foundation può richiedere ancora instruction tuning, reinforcement learning, valutazioni di sicurezza, training per l’uso di strumenti e ottimizzazione del serving. Da una fondazione possono derivare più prodotti, e una versione pubblica non identifica un’esecuzione di training. Il report Path to Astra di OpenAI fornisce il background ufficiale sul reinforcement learning, senza stabilire l’identità di Bel.
Ipotesi 1 — GPT-7: Se Bel rappresenta una fondazione materialmente nuova oltre la generazione GPT-6, OpenAI potrebbe commercializzare un modello derivato come GPT-7. Questa interpretazione dipende da una nuova generazione di capacità e da una decisione di naming pubblico; né il conteggio di parametri asserito né il presunto completamento del pretraining stabiliscono tale esito.
Ipotesi 2 — GPT-6 Bel: OpenAI potrebbe invece mantenere un prodotto derivato da Bel all’interno della famiglia GPT-6, potenzialmente usando un’etichetta come GPT-6 Bel per un’offerta aggiornata o specializzata. Questo è uno scenario editoriale di naming a fini comparativi, non un prodotto annunciato o una fuga di notizie separatamente verificata. Un nome in codice interno non compare necessariamente nel nome commerciale.
Cosa resta irrisolto: Lo stesso sforzo di training potrebbe supportare prodotti multipli, un altro nome o nessun rilascio pubblico. La timeline fornisce contesto per entrambe le interpretazioni ma non può scegliere tra esse. La conferma richiederebbe documentazione che colleghi lo sforzo di training Bel a un modello pubblico reale e al suo nome.
Confronto tra OpenAI Bel e la generazione precedente: cosa migliora?
Poiché mancano dettagli tecnici concreti su Bel, qualsiasi discussione sui miglioramenti deve basarsi su (1) le affermazioni di alto livello della fuga di notizie, (2) la traiettoria nota GPT-4o → GPT-5.x → GPT-6 Astra e (3) le capacità dimostrate dal modello interno senza nome usato per lavori scientifici a scala Navier-Stokes. Ogni area potenziale di miglioramento è trattata separatamente di seguito.
Scala e compute di pretraining
L’affermazione centrale è un salto oltre le esecuzioni interne precedenti nel regime >10T parametri. Se accurata, rappresenterebbe una continua aderenza alle scaling law su dati, parametri e compute. Confermato: OpenAI ha proseguito esecuzioni di training di grandi dimensioni e ha fatto riferimento pubblico a modelli più capaci di Astra. Non confermato: qualsiasi conteggio specifico di parametri, FLOP di training, composizione dei dati o cambi architetturali (denso vs. mixture-of-experts, attenzione innovativa, ecc.). Aspettativa realistica basata sulla storia: migliore efficienza di campionamento e copertura conoscitiva più ampia, ma rendimenti decrescenti senza progressi corrispondenti nel post-training e nella qualità dei dati.
Post-training e allineamento per agency a lungo orizzonte
GPT-6 Astra ha già migliorato sostanzialmente i flussi di lavoro multi-step, l’uso del computer e il rispetto dei confini del compito. Una base più forte più ulteriore RL potrebbe spingere un’operatività agentica affidabile da ore verso orizzonti di più giorni o settimane con meno guida umana. L’esperimento multi-agente su Navier-Stokes (migliaia di agenti coordinati) dimostra che OpenAI opera già a scala di sciami di agenti su problemi difficili. Direzione di capacità confermata: sì. Contributo specifico di Bel: non confermato.
Ragionamento scientifico e matematico
Astra stesso ha contribuito a progressi matematici; il modello interno più forte ha prodotto un risultato formalizzato su un problema del Millennium Prize. Una base più grande e meglio addestrata potrebbe comprimere ulteriormente il tempo e il costo di esplorare spazi di ricerca STEM complessi. Confermato: OpenAI sta investendo massicciamente qui. Specifico di Bel: non confermato.
Uso del computer, uso di strumenti e affidabilità multimodale
Astra ha stabilito nuovi livelli nell’uso del computer e del browser. Si prevederebbe che future basi riducano i tassi di errore su traiettorie lunghe, migliorino l’ancoraggio visivo e gestiscano ambienti software più complessi. Speculativo ma coerente con la roadmap di prodotto.
Efficienza, velocità di inferenza e costo
Anche se la base è più grande, distillazione, migliori architetture e silicon custom (OpenAI ha discusso i propri ASIC) potrebbero ancora fornire un buon rapporto costo/prestazioni. Non esistono affermazioni specifiche di efficienza per Bel.
Quando potrebbero essere rilasciati OpenAI Bel o GPT-7?
Nessuna data ufficiale di lancio per Bel o per un GPT-7 derivato da Bel è stabilita dalle fonti esaminate. Una ricostruzione circolante del follow-up del 23 settembre di @synthwavedd che descrive un’attesa di mesi è attribuita alla stessa fonte non ufficiale della fuga iniziale. Il suo testo completo non era direttamente accessibile durante questa revisione, quindi non dovrebbe essere usato per prevedere una finestra di lancio. Il pretraining completato, se vero, potrebbe essere seguito da post-training, valutazioni, lavoro di serving e distribuzione graduale.
| Scenario | Cosa accadrebbe | Cosa implica |
|---|---|---|
| Completamento rapido | Valutazioni residue e distribuzione hanno successo abbastanza presto | Un successore potrebbe arrivare prima |
| Sviluppo esteso | Sono richiesti più training, mitigazioni e lavoro di serving | La tempistica si sposta più avanti |
| Distribuzione alternativa | La fondazione alimenta sistemi specializzati o con brand diverso | Nessun prodotto necessariamente chiamato Bel |
Il presunto Fable 5.5 non ha alcuna pianificazione verificata nelle fonti esaminate, quindi una previsione sull’ordine di rilascio non è supportata.
Bel potrebbe spostare l’equilibrio tra OpenAI e Anthropic?
Restano aperti tre esiti credibili. Primo, Bel potrebbe introdurre un ampio salto di pretraining e migliorare i successivi sistemi di coding e ragionamento. Secondo, il vantaggio potrebbe essere ristretto, con altri provider che mantengono vittorie in affidabilità agentica, latenza o costo. Terzo, l’enorme scala riportata potrebbe non tradursi in guadagni pratici proporzionali. Fino a quando non esisteranno evidenze riproducibili, l’inquadramento corretto è una possibile risposta competitiva piuttosto che un vincitore dichiarato.
Raccomandazioni pratiche per sviluppatori e team (CometAPI)
Mentre il settore attende eventuali conferme ufficiali su Bel o sul prossimo grande modello base di OpenAI, i sistemi di produzione hanno bisogno di accesso affidabile ai modelli effettivamente esistenti oggi. CometAPI fornisce un unico endpoint compatibile con OpenAI (https://api.cometapi.com/v1) e una sola API key che raggiunge oltre 500 modelli, inclusa l’intera famiglia GPT-6 attuale (Astra, Sol, Luna e aggiornamenti) e la lineup Claude di Anthropic (Fable 5.1, Opus 5.5, Sonnet 5.5, ecc.).
Conclusione
Il fronte dell’AI continua a muoversi rapidamente. Bel potrebbe alla fine rivelarsi una pietra miliare interna importante, un nome in codice riportato in modo impreciso o qualcosa di intermedio. Fino a quando OpenAI non pubblicherà informazioni concrete, l’atteggiamento responsabile è trattare le affermazioni come non verificate estraendo al contempo il massimo valore dai modelli già disponibili—e mantenendo un’infrastruttura abbastanza flessibile da incorporare la prossima generazione nel momento in cui diventerà reale. Per molti team, tale flessibilità è oggi più facilmente ottenibile tramite una piattaforma unificata come CometAPI.