
TL;DR
Le API Decisions di OpenAI e TypeSafe Jev restituiscono decisioni limitate e supportate da probabilità, invece della normale prosa generata. OpenAI usa GPT-6 Luna tramite un endpoint dedicato; TypeSafe Jev è un modello specializzato System One. Jev costa meno secondo le tariffe pubblicate per token di input (0,042 USD contro 0,10 USD per milione), mentre OpenAI ha supporto nativo per le immagini. Le cifre dei fornitori qui esaminate non stabiliscono un vincitore in termini di accuratezza o velocità in un confronto diretto.
Key Takeaways
- Prezzi: Jev costa il 58% in meno per token di input alle tariffe base pubblicate.
- Architettura: le API Decisions di OpenAI usano GPT-6 Luna; Jev è progettato appositamente per l’elaborazione di decisioni.
- Modalità: OpenAI supporta testo e immagini; Jev si concentra su testo e input strutturati.
- Benchmark: le affermazioni di velocità dei fornitori usano baseline diverse; confrontare sullo stesso dataset etichettato.
- Selezione: dare priorità al supporto multimodale e all’integrazione OpenAI, oppure alla capacità di throughput solo testo e ai costi, a seconda dell’applicazione.
At Glance: OpenAI Decisions API vs Jev
La panoramica seguente confronta gli endpoint di decisione documentati e le tariffe base pubblicate, verificate il 12 ottobre 2026. Accesso al modello, limiti e termini di servizio devono essere verificati per l’account di deployment.
| Feature | OpenAI Decisions API | TypeSafe Jev |
|---|---|---|
| Provider | OpenAI | TypeSafe AI |
| Engine | GPT-6 Luna | Jev System One |
| Endpoint | POST /v1/decisions | POST /v1/systemone |
| Model identifier | gpt-6-luna | jev-1.13.0 / jev-latest |
| Inputs | Text + images | Text / structured text |
| Question types | Predicate (condition probability), choice (category), score (rubric) | Noul (condition probability), choice (category), score (levels) |
| Request questions | Array with names | Object keyed by ID |
| Context limit | Not specified in the linked Decisions guide | 64K total; state + longest question ≤32K |
| Base input cost / 1M | USD 0.10 | USD 0.042 |
| Output token cost | No charge | No charge |
| Vendor speed statement | About 10× faster than Responses API | 70–500 ms end to end |
| Availability | Public beta | Early access in the launch announcement; verify current account access |
| Distinct advantage | Image-based decisions | Lower published input cost |
| Generative reasoning / coding | Not the output contract of this endpoint | Not the output contract of this endpoint |
Molti flussi di lavoro di IA richiedono una categoria, una probabilità o un punteggio — non un paragrafo. Un ticket di supporto ha bisogno di instradamento; un agente deve selezionare un’azione approvata; una coda di revisione deve identificare input incerti. Entrambi i prodotti rendono tali decisioni output di API di prima classe.
OpenAI ha rilasciato le API Decisions in beta il 6 ottobre 2026. Il suo endpoint GPT-6 Luna accetta testo e immagini. Jev è il modello System One specializzato di TypeSafe AI per la valutazione non generativa, con un approccio di training descritto come Reinforcement Learning for Calibrated Decisions (RLCD).
I tipi di domanda nella tabella coprono tre attività condivise. Il predicate di OpenAI e il noul di Jev stimano se una condizione è vera, ad esempio l’intento di rimborso o l’idoneità. Choice seleziona tra categorie predefinite, come Billing, Technical e Shipping, per l’instradamento. Score valuta un input rispetto a una griglia o livelli, come urgenza o priorità. Queste descrizioni consolidano le due panoramiche di prodotto; gli schemi di richiesta e le semantiche di probabilità richiedono comunque una gestione specifica per fornitore.
What is OpenAI Decisions API and Jev?
Le OpenAI Decisions API e TypeSafe Jev sono servizi di IA focalizzati sulle decisioni, progettati per trasformare i dati di input in output strutturati e limitati invece che in testo aperto. A differenza dei tradizionali large language model che generano spiegazioni o risposte conversazionali, queste API valutano domande predefinite e restituiscono decisioni, probabilità o punteggi. Questo le rende particolarmente utili per flussi di lavoro automatizzati come instradamento di richieste clienti, classificazione dei contenuti, valutazione del rischio e selezione di strumenti da parte di agenti IA, in cui sono essenziali output prevedibili ed elaborazione efficiente.
OpenAI Decisions API è alimentata da GPT-6 Luna e opera tramite l’endpoint /v1/decisions. Supporta sia input testuali sia di immagini, con tre tipi di decisione: predicate, choice e score. Il suo principale vantaggio è combinare la comprensione contestuale di un modello AI generalista con un’interfaccia dedicata alle decisioni, rendendola adatta alla classificazione multimodale e alle applicazioni già integrate nell’ecosistema OpenAI.
TypeSafe Jev, in contrasto, è un modello di decisione specializzato accessibile tramite l’endpoint /v1/systemone. Si concentra sulla valutazione basata su testo utilizzando tre tipi di domanda: noul, choice e score. Jev enfatizza inferenza efficiente, predizioni strutturate e calibrazione delle probabilità, rendendolo un’opzione interessante per la classificazione ad alto volume e per pipeline di decisione automatizzate. Sebbene entrambi i servizi affrontino problemi simili, le loro differenze in architettura, capacità di input, prezzi e design API possono influenzare significativamente quale sia più adatto a una specifica applicazione.
Model Approach, Input Limits, and Scope
Il confronto riguarda il comportamento API documentato e il posizionamento del prodotto. OpenAI espone GPT-6 Luna tramite un endpoint di decisione, mentre TypeSafe posiziona Jev come un modello System One specializzato. Queste descrizioni da sole non stabiliscono un vantaggio in termini di accuratezza né rivelano tutti i dettagli di implementazione.
Jev consente 64K token per l’intera richiesta, con un limite separato di 32K per lo stato più la domanda più lunga. Contare istruzioni e criteri della domanda oltre all’input condiviso. La guida Decisions collegata di OpenAI non indica un limite di contesto numerico separato per questo endpoint; verificare i limiti applicabili invece di assumere che la finestra di contesto di un modello generale si applichi invariata.
I benchmark di ragionamento generativo e di coding sono al di fuori dell’ambito di questi endpoint di decisione limitata. Per generazione di spiegazioni o di codice, valutare separatamente un endpoint generativo adeguato. I risultati per il modello generalista sottostante non stabiliscono le prestazioni per l’endpoint Decisions.
Accuracy and Latency
I materiali citati dei fornitori non forniscono un test abbinato head-to-head che stabilisca un vincitore per accuratezza o latenza. L’affermazione di velocità di circa 10× di OpenAI confronta Decisions con le sue Responses API. TypeSafe riporta 70–500 ms di latenza end-to-end e afferma che le sue valutazioni pubblicate sono generalmente state eseguite da un laptop nella parte occidentale degli Stati Uniti.
| Metric | OpenAI Decisions API | Jev | Assessment |
|---|---|---|---|
| Head-to-head accuracy | Nessun test abbinato nelle fonti citate | Nessun test abbinato nelle fonti citate | Nessun vincitore |
| Speed | Affermazione relativa del fornitore | Intervallo assoluto del fornitore | Non direttamente comparabili |
| Calibration | Probabilità; confidence separata per choice/score | Probabilità; confidence derivata per choice/score | Testare la calibrazione osservata |
| Text categorization | Supportata | Supportata | Entrambe valide |
| Visual categorization | Immagini native | Nessuna immagine nativa | Vantaggio OpenAI |
Probability Calibration and Review Thresholds
Un modello può essere accurato ma mal calibrato. Tra le previsioni a cui è assegnata una probabilità di 0,90 per la classe selezionata, circa il 90% dovrebbe essere corretto se tale probabilità è calibrata sulla distribuzione di valutazione. Non sostituire un campo API denominato confidence a questa probabilità senza verificarne la definizione. Jev deriva la sua confidence per Choice dalla distribuzione di probabilità: confidence = (p_max − 1/n) / (1 − 1/n), dove n è il numero di scelte. Il risultato Noul non ha un campo di confidence separato. Misurare ECE e Brier score dalle probabilità appropriate, insieme a precision, recall e macro F1; scegliere le soglie di revisione a partire da esempi etichettati.
Pricing and Cost per Accepted Decision
OpenAI elenca 0,10 USD per milione di token di input per /v1/decisions; Jev elenca 0,042 USD per milione di token di input. Entrambi indicano nessun addebito per i token di output per questi servizi di decisione. A tali tariffe base, Jev costa il 58% in meno per token di input. Possono applicarsi maggiorazioni per elaborazione regionale e moltiplicatori per contesti lunghi di OpenAI; i retry, il pre-processing e la revisione possono aggiungere costi al flusso di lavoro.
Si supponga che ogni richiesta utilizzi 500 token di input fatturabili su entrambi i servizi. Questi sono calcoli illustrativi, non fatture dei fornitori.
| Monthly decisions | Input tokens | OpenAI cost | Jev cost | Difference |
|---|---|---|---|---|
| 10,000 | 5M | $0.50 | $0.21 | $0.29 |
| 100,000 | 50M | $5.00 | $2.10 | $2.90 |
| 1,000,000 | 500M | $50 | $21 | $29 |
| 10,000,000 | 5B | $500 | $210 | $290 |
| 100,000,000 | 50B | $5,000 | $2,100 | $2,900 |
Costo per decisione corretta accettata = (spesa API + spesa per retry + spesa per revisione umana) / numero di decisioni corrette accettate. Una tariffa per token bassa può essere compensata da un tasso più alto di instradamenti errati o escalation.
Per un flusso di lavoro GPT-6 Luna convenzionale, la tabella prezzi del modello CometAPI elenca le seguenti tariffe in USD per milione di token, verificate il 12 ottobre 2026. Queste sono tariffe per endpoint del modello; la pagina collegata mostra un esempio di Responses API e non stabilisce supporto nativo per /v1/decisions né la sua tariffazione.
| Published tier | Input / 1M tokens | Output / 1M tokens |
|---|---|---|
| Short context (page condition: ≤272,000 tokens) | $0.08 | $0.40 |
| Long context (as listed on the page) | $0.16 | $0.60 |
I token di output ordinari di GPT-6 Luna su CometAPI sono fatturati. Tenere questa stima separata dai due servizi di decisione sopra, i cui addebiti per token di output pubblicati sono pari a zero. Ad esempio, 500 token di input più 20 token di output costano 0,000048 USD per richiesta a breve contesto, ovvero 48 USD per milione di richieste, prima di altri addebiti. Confermare il tier applicabile e la tariffa dell’account nel catalogo dei modelli live prima di pianificare il budget.
Agent Workflows and Modality Tradeoffs
Entrambi possono instradare una chiamata a uno strumento, valutare se una condizione di guardia è soddisfatta o assegnare un punteggio a un’azione. Nessuno sostituisce autorizzazione, validazione dell’input o permessi espliciti degli strumenti. Per l’automazione visiva, il supporto nativo alle immagini di OpenAI semplifica la pipeline; per l’instradamento solo testo, il minor costo base di Jev può essere attraente.
La gestione dell’output differisce al confine della risposta. OpenAI restituisce un array answers, con i nomi che identificano le domande; Jev restituisce un oggetto answers indicizzato dall’ID della domanda. Normalizzare queste strutture prima di applicare regole aziendali condivise. Jev deriva la confidence dalla sua distribuzione di probabilità; non assumere che campi con lo stesso nome abbiano significati equivalenti tra i fornitori. Validare le etichette e calibrare le soglie di revisione sui dati dell’applicazione.
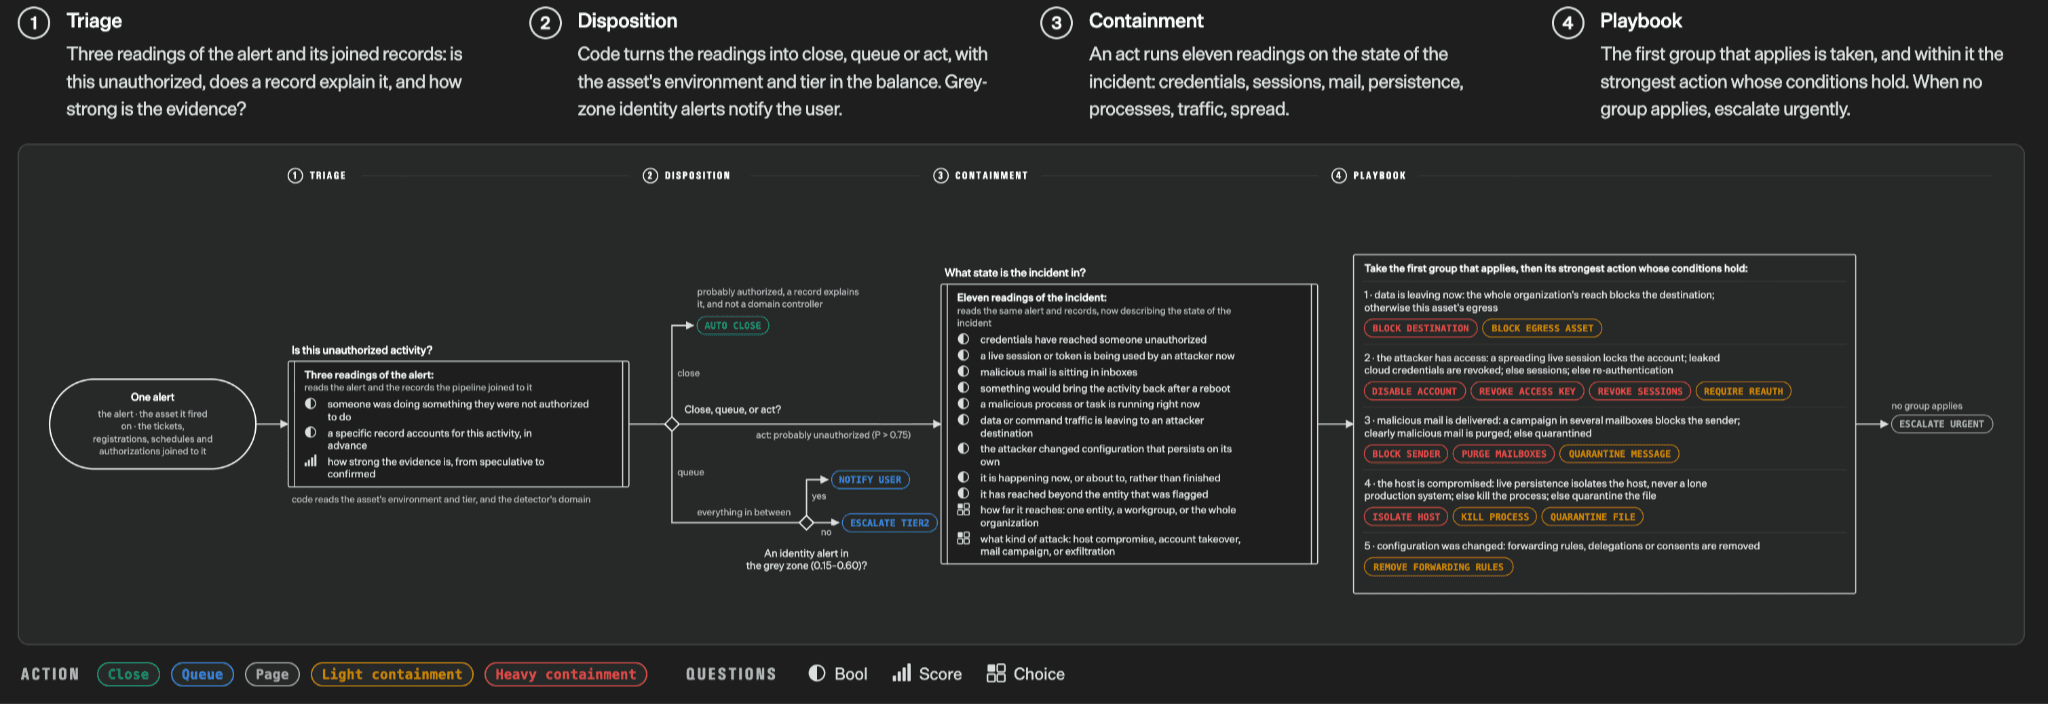
Fonte: Introducing System One Models & Jev; immagine originale. Questo illustra la composizione del workflow, non un benchmark abbinato contro le OpenAI Decisions API.
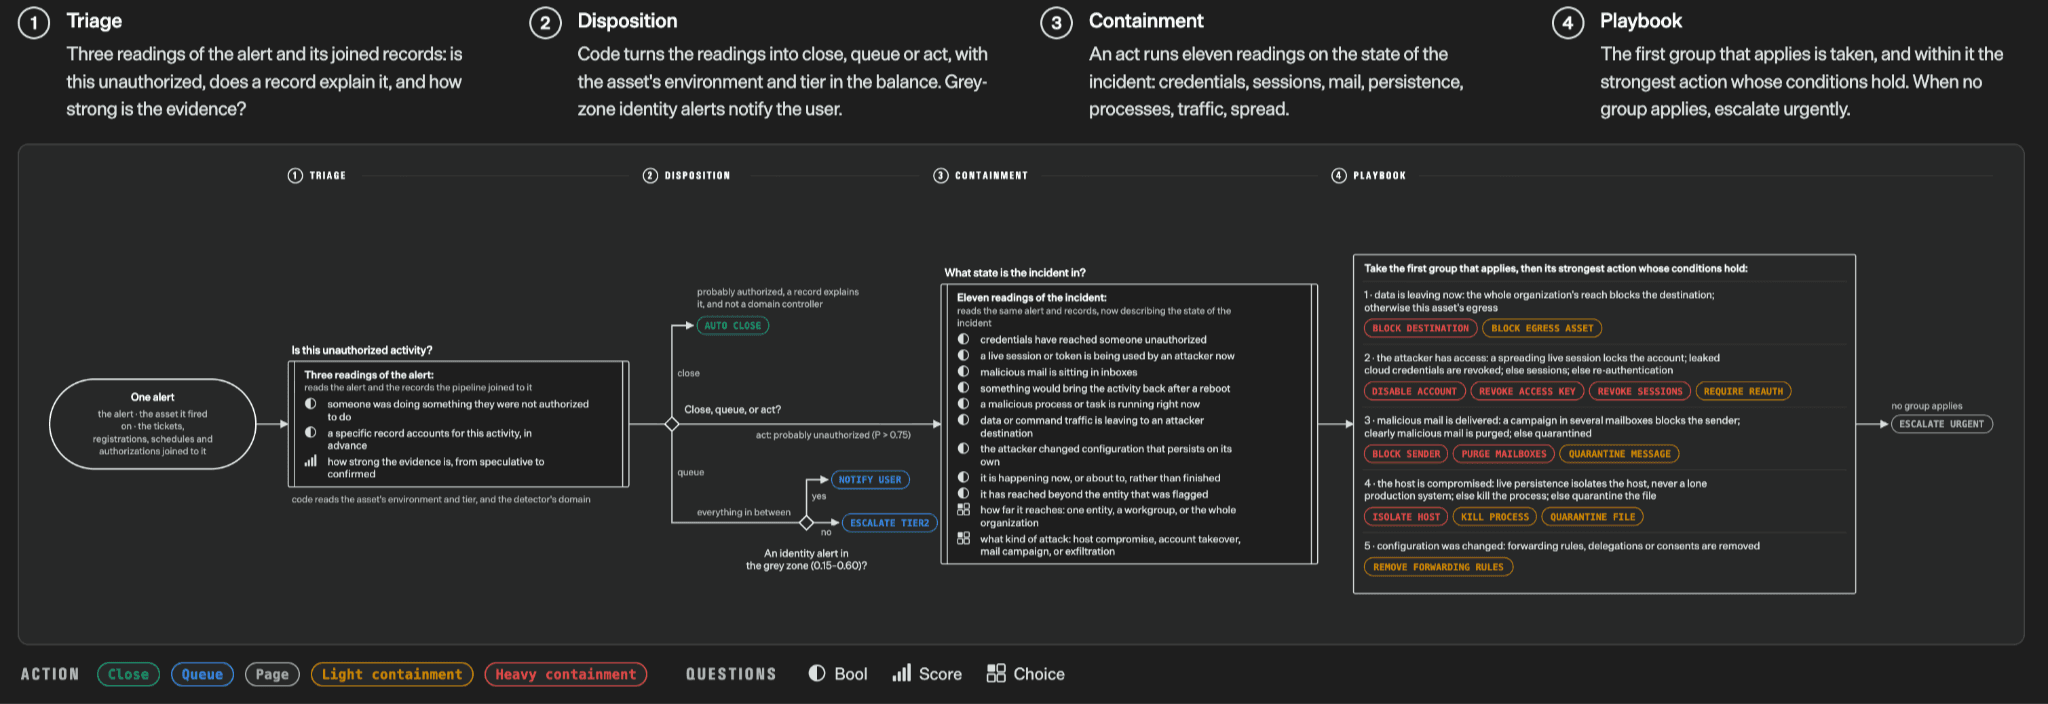
How API Usage Differs: OpenAI Decisions API vs Jev
L’accesso deve essere configurato separatamente per ciascun fornitore: ogni esempio seguente utilizza il proprio host e la propria API key. OpenAI documenta Decisions come un endpoint in beta pubblica. Per Jev, confermare l’accesso e le credenziali correnti con TypeSafe prima del deployment. Per entrambi i servizi, verificare permessi dell’account, disponibilità regionale, quote e termini di servizio; un esempio di richiesta non garantisce l’accesso in produzione. L’accesso di terze parti a un modello generativo non conferma di per sé il supporto per il suo endpoint nativo di decisione.
How to use OpenAI Decisions API
I concetti si sovrappongono, ma gli schemi di richiesta differiscono. OpenAI invia input e un array di domande con nome; Jev utilizza state e un oggetto questions indicizzato per ID. Implementare un adattatore specifico per fornitore prima di applicare una policy di decisione condivisa.
Instradare un ticket di supporto con OpenAI Decisions API.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Mi hanno addebitato due volte il mio ordine.",
    "questions": [{
      "type": "choice", "name": "department",
      "instructions": "Quale team dovrebbe gestire questo?",
      "choices": [
        {"value":"billing","description":"Addebiti e rimborsi"},
        {"value":"technical","description":"Errori del prodotto"},
        {"value":"other","description":"Altre richieste"}
      ]
    }]
  }'
How to use Jev API
La seguente richiesta cURL utilizza l’endpoint System One di Jev per classificare un ticket di supporto. Impostare TYPESAFE_API_KEY nel proprio ambiente, inserire il ticket in state e definire department all’interno dell’oggetto questions. La sua mappa criteria elenca le etichette di instradamento consentite e le loro descrizioni. Dopo che la richiesta è riuscita, leggere la voce department in answers e validare l’etichetta selezionata prima di instradare il ticket. Confermare che l’identificatore del modello sia disponibile per il proprio account.
Instradare un ticket di supporto con TypeSafe Jev.
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "Mi hanno addebitato due volte il mio ordine.",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Quale team dovrebbe gestire questo?",
        "criteria": {
          "billing":"Addebiti e rimborsi",
          "technical":"Errori del prodotto",
          "other":"Altre richieste"
        }
      }
    }
  }'
| Integration element | OpenAI | Jev |
|---|---|---|
| Input | input | state |
| Questions | Array | Keyed object |
| Question ID | name | Object key |
| Binary question | predicate | noul |
| Choices | choices | criteria |
| Answer shape | answers array | answers object |
Shared Review Policy for Selected-Class Probabilities
Applicare una soglia esplicitamente calibrata alla probabilità della classe selezionata.
from dataclasses import dataclass
from math import isfinite

@dataclass
class NormalizedDecision:
    label: str | None
    selected_probability: float | None
    provider: str
    needs_review: bool

def apply_review_policy(label, selected_probability, provider, threshold):
    if not isfinite(threshold) or not 0.0 <= threshold <= 1.0:
        raise ValueError("threshold deve essere compreso tra 0 e 1")
    valid_probability = (
        selected_probability is not None
        and isfinite(selected_probability)
        and 0.0 <= selected_probability <= 1.0
    )
    return NormalizedDecision(
        label=label,
        selected_probability=selected_probability,
        provider=provider,
        needs_review=(
            not label
            or not valid_probability
            or selected_probability < threshold
        ),
    )
Questo esempio per Python 3.10+ è un livello di policy applicativa, non un parser di risposte API. Ogni adattatore del fornitore deve validare la risposta ed estrarre la probabilità della classe selezionata. Non passare il campo confidence grezzo di Jev come selected_probability. Fornire una soglia calibrata per quel fornitore, domanda e dataset di valutazione; gestire rifiuti ed errori di trasporto prima di chiamare la policy.
OpenAI Decisions API vs Jev: How to choose
Scegliere in due fasi. Primo, filtrare per requisiti di deployment: input di immagini, accesso all’account, limiti di input e sforzo di integrazione. Poi eseguire benchmark dei servizi idonei sullo stesso carico di lavoro etichettato. Per l’instradamento solo testo, verificare se il minor prezzo di input pubblicato di Jev si traduce in un costo totale inferiore; per decisioni che dipendono da immagini, valutare il percorso nativo di OpenAI. Confrontare instradamenti errati, calibrazione, latenza di coda, retry e revisione umana a un obiettivo di qualità concordato. La tabella seguente è un elenco iniziale, non prova di un vincitore prestazionale complessivo.
| Use case | OpenAI Decisions API | Jev | Practical recommendation |
|---|---|---|---|
| Support routing | Supportato | Supportato | Benchmarkare prima Jev per il costo |
| Text categorization | Supportata | Supportata | Confrontare la calibrazione |
| Screenshot inspection | Nativo | Richiede pre-processing di vision | OpenAI |
| Agent tool selection | Supportata | Supportata | Misurare risultati end-to-end |
| Multimodal moderation | Testo e immagini | Solo testo | OpenAI |
| Existing OpenAI stack | Nativo | Nuova integrazione | OpenAI |
Per l’automazione aziendale ad alto volume, come instradamento del supporto e classificazione testuale, Jev merita priorità quando costo di input e throughput sono aspetti chiave. Per applicazioni multimodali, inclusa ispezione di screenshot, moderazione visiva e decisioni basate su immagini, le API Decisions di OpenAI sono l’opzione più pratica grazie al supporto nativo per le immagini. Per agenti IA e workflow aziendali, la scelta dipende dall’infrastruttura esistente, dalla complessità di integrazione e dalle conseguenze delle decisioni errate. OpenAI può offrire un percorso più fluido per team che già utilizzano il suo ecosistema, mentre Jev merita considerazione per carichi di lavoro su larga scala e fortemente testuali. In tutti gli scenari, la decisione finale dovrebbe basarsi su accuratezza misurata, calibrazione delle probabilità, latenza e costo operativo totale piuttosto che sui soli prezzi di copertina.
How Should You Benchmark OpenAI Decisions API Against Jev?
Eseguire entrambi i servizi sugli stessi input reali etichettati, con definizioni di domanda abbinate e regioni client corrispondenti. Tracciare accuratezza, macro F1, ECE, Brier score, latenza p50/p95/p99, timeout, rifiuti, tasso di revisione e costo in dollari per decisione corretta accettata.
| Dimension | Recommended metrics | Why it matters |
|---|---|---|
| Classification | Accuracy, precision, recall, macro F1 | Qualità delle etichette |
| Calibration | ECE, Brier score | Affidabilità delle probabilità |
| Latency | p50 / p95 / p99 | Reattività operativa |
| Reliability | Tasso 429 / timeout / rifiuto | Comportamento in produzione |
| Economics | Costo per decisione corretta accettata | Spesa operativa reale |
Procedura suggerita: costruire un set rappresentativo etichettato; includere casi ambigui e fuori distribuzione; inviare compiti semanticamente identici; ripetere le richieste a sufficienza per misurare la varianza; calibrare separatamente le soglie di ciascun sistema; e confrontare il costo end-to-end includendo escalation e retry.
Conclusion
Scegliere le OpenAI Decisions API quando la decisione dipende da evidenza visiva o quando un’integrazione OpenAI esistente riduce il lavoro di deployment. Valutare Jev per carichi di lavoro di decisione solo testo in cui la sua tariffa pubblicata inferiore per token di input può ridurre la spesa di inferenza. Misurare qualità delle etichette, calibrazione, latenza di coda e carico di revisione sugli stessi dati applicativi prima di scegliere.
Jev ha il prezzo base pubblicato per token di input più basso; le OpenAI Decisions API hanno input di immagini nativo. Le cifre citate dei fornitori non stabiliscono un vincitore complessivo per accuratezza o velocità. La scelta migliore dipende dal costo e dalla qualità delle decisioni accettate nell’intero workflow.
Gli sviluppatori possono utilizzare la GPT-6 Luna API in CometAPI per prototipare classificazioni leggere in un workflow multi-modello più ampio. La pagina del modello collegata fornisce un esempio di Responses API. L’accesso a tale endpoint generativo non stabilisce il supporto per l’endpoint dedicato /v1/decisions. Questo è un prototipo di generazione di testo convenzionale. Non restituisce lo schema di risposta nativo di Decisions né una distribuzione di probabilità della classe calibrata. Validare l’etichetta restituita rispetto alle categorie consentite e gestire gli errori API prima di collegarla ad azioni a valle. Confermare separatamente il supporto nativo per /v1/decisions se tale endpoint è richiesto.