TL;DR: Alibaba ha rilasciato Qwen4-Max il 16 novembre 2026, come modello di punta della generazione Qwen4. Le valutazioni ufficiali riportano migliori prestazioni su task industriali e costi di esecuzione inferiori rispetto a Qwen3.8-Max, riflettendo miglioramenti nell’efficienza sui token e prezzi API ridotti.
Punti Chiave
- Dimensione del modello: Qwen4-Max ha 2.4 bilioni di parametri di backbone, con 71 miliardi attivati per token.
- Finestra di contesto: Qwen4-Max supporta una finestra di contesto da un milione di token.
- Supporto multimodale: Qwen4-Max accetta testo, immagini e video e genera testo.
- Funzionalità per sviluppatori: Qwen4-Max supporta function calling, output strutturati, context caching e web search.
- Opzioni di accesso: Gli utenti possono accedere a Qwen4-Max tramite le applicazioni Qwen supportate, l’API a consumo QwenCloud e gli abbonamenti Token Plan.
Che cos’è Qwen4-Max?
Nell’annuncio ufficiale, Qwen descrive Qwen4-Max come un compagno di lavoro AI per lavoro, creazione ed esplorazione. Le sue capacità si concentrano sulla comprensione degli obiettivi, sull’uso di strumenti, sulla risposta ai feedback di esecuzione e sulla consegna dei risultati attraverso più fasi.
Per questi flussi di lavoro, il modello fornisce ragionamento e coordinamento. Applicazioni collegate, strumenti e ambienti di esecuzione svolgono le operazioni.
Specifiche di Qwen4-Max
La pagina ufficiale del modello su QwenCloud elenca le seguenti specifiche:
| Specifica | Qwen4-Max |
|---|---|
| Model ID | qwen4-max |
| Parametri del backbone | 2.4 bilioni |
| Parametri attivati per token | 71 miliardi |
| Finestra di contesto | 1 milione di token |
| Input / output | Testo, immagini e video / Testo |
| Limiti in modalità standard | Input massimo: 991K; output massimo: 131K token |
| Limiti in modalità Thinking | Input massimo: 983K; output massimo: 262K token |
| Lunghezza massima di ragionamento | 262K token |
| Capacità per sviluppatori | Function calling, output strutturati, context caching e web search |
| Compatibilità API | Protocolli API OpenAI e Anthropic |
Dimensione del contesto, limiti di input e limiti di output rappresentano vincoli differenti. Le applicazioni devono rispettarli congiuntamente e riservare capacità sufficiente per le risposte generate e il ragionamento.
Quali sono le principali funzionalità di Qwen4-Max?
Le capacità di Qwen4-Max sono particolarmente rilevanti quando un task coinvolge più documenti, strumenti e passaggi di esecuzione. Il contesto lungo preserva lo sfondo operativo, la comprensione visiva amplia le evidenze disponibili e le capacità agentiche aiutano a portare il task a compimento.
Contesto da un milione di token e comprensione visiva nativa
La grande finestra di contesto consente di elaborare materiali correlati all’interno di un contesto di lavoro condiviso. Applicazioni pratiche includono il confronto di contratti, l’analisi di dipendenze tra file di codice e la revisione di report insieme ai documenti di supporto.
La comprensione visiva nativa estende ciò a screenshot, diagrammi, pagine scansionate e video. Un utente può fornire un disegno ingegneristico o uno screenshot di interfaccia e chiedere al modello di interpretarli insieme a requisiti scritti.
Per i task ricchi di documenti, preservare nomi file, date ed etichette di sezione aiuta a organizzare le evidenze e rende più semplice verificare l’analisi risultante.
Coding e uso professionale degli strumenti
Qwen4-Max supporta il function calling, consentendo agli sviluppatori di collegarlo a database, servizi di ricerca, operazioni sui file e sistemi aziendali. Gli output strutturati aiutano a passare i risultati del modello ai processi software successivi.
Le dimostrazioni ufficiali mostrano flussi di lavoro software più ampi. Nello sviluppo di giochi, il modello usa motori come Unity, Unreal Engine e Godot per costruire scene, implementare il gameplay e affinare i risultati tramite test. In Blender, coordina geometria, materiali, illuminazione e rendering.
La riproduzione di questi flussi di lavoro richiede il software rilevante, gli asset e i permessi di esecuzione. Le dimostrazioni mostrano ciò che il modello può realizzare all’interno di quegli ambienti.
Agenti a lungo orizzonte e Live Delivery
I task lunghi diventano difficili da gestire quando gli utenti non possono ispezionare i progressi fino al completamento. L’approccio Live Delivery di Qwen4-Max introduce un risultato iniziale utilizzabile seguito da aggiornamenti successivi.
Per un incarico di ricerca, un agente potrebbe prima fornire risultati preliminari e un elenco di fonti, quindi ampliare l’analisi e aggiungere grafici. Gli utenti possono rivedere ogni versione e reindirizzare il lavoro successivo.
Qwen ha anche rilasciato il Qwen-Live-Delivery-Plugin. Per flussi di lavoro di ore o più, la consegna a tappe crea checkpoint pratici per rivedere la qualità e correggere la direzione.
Architettura ed efficienza sui token
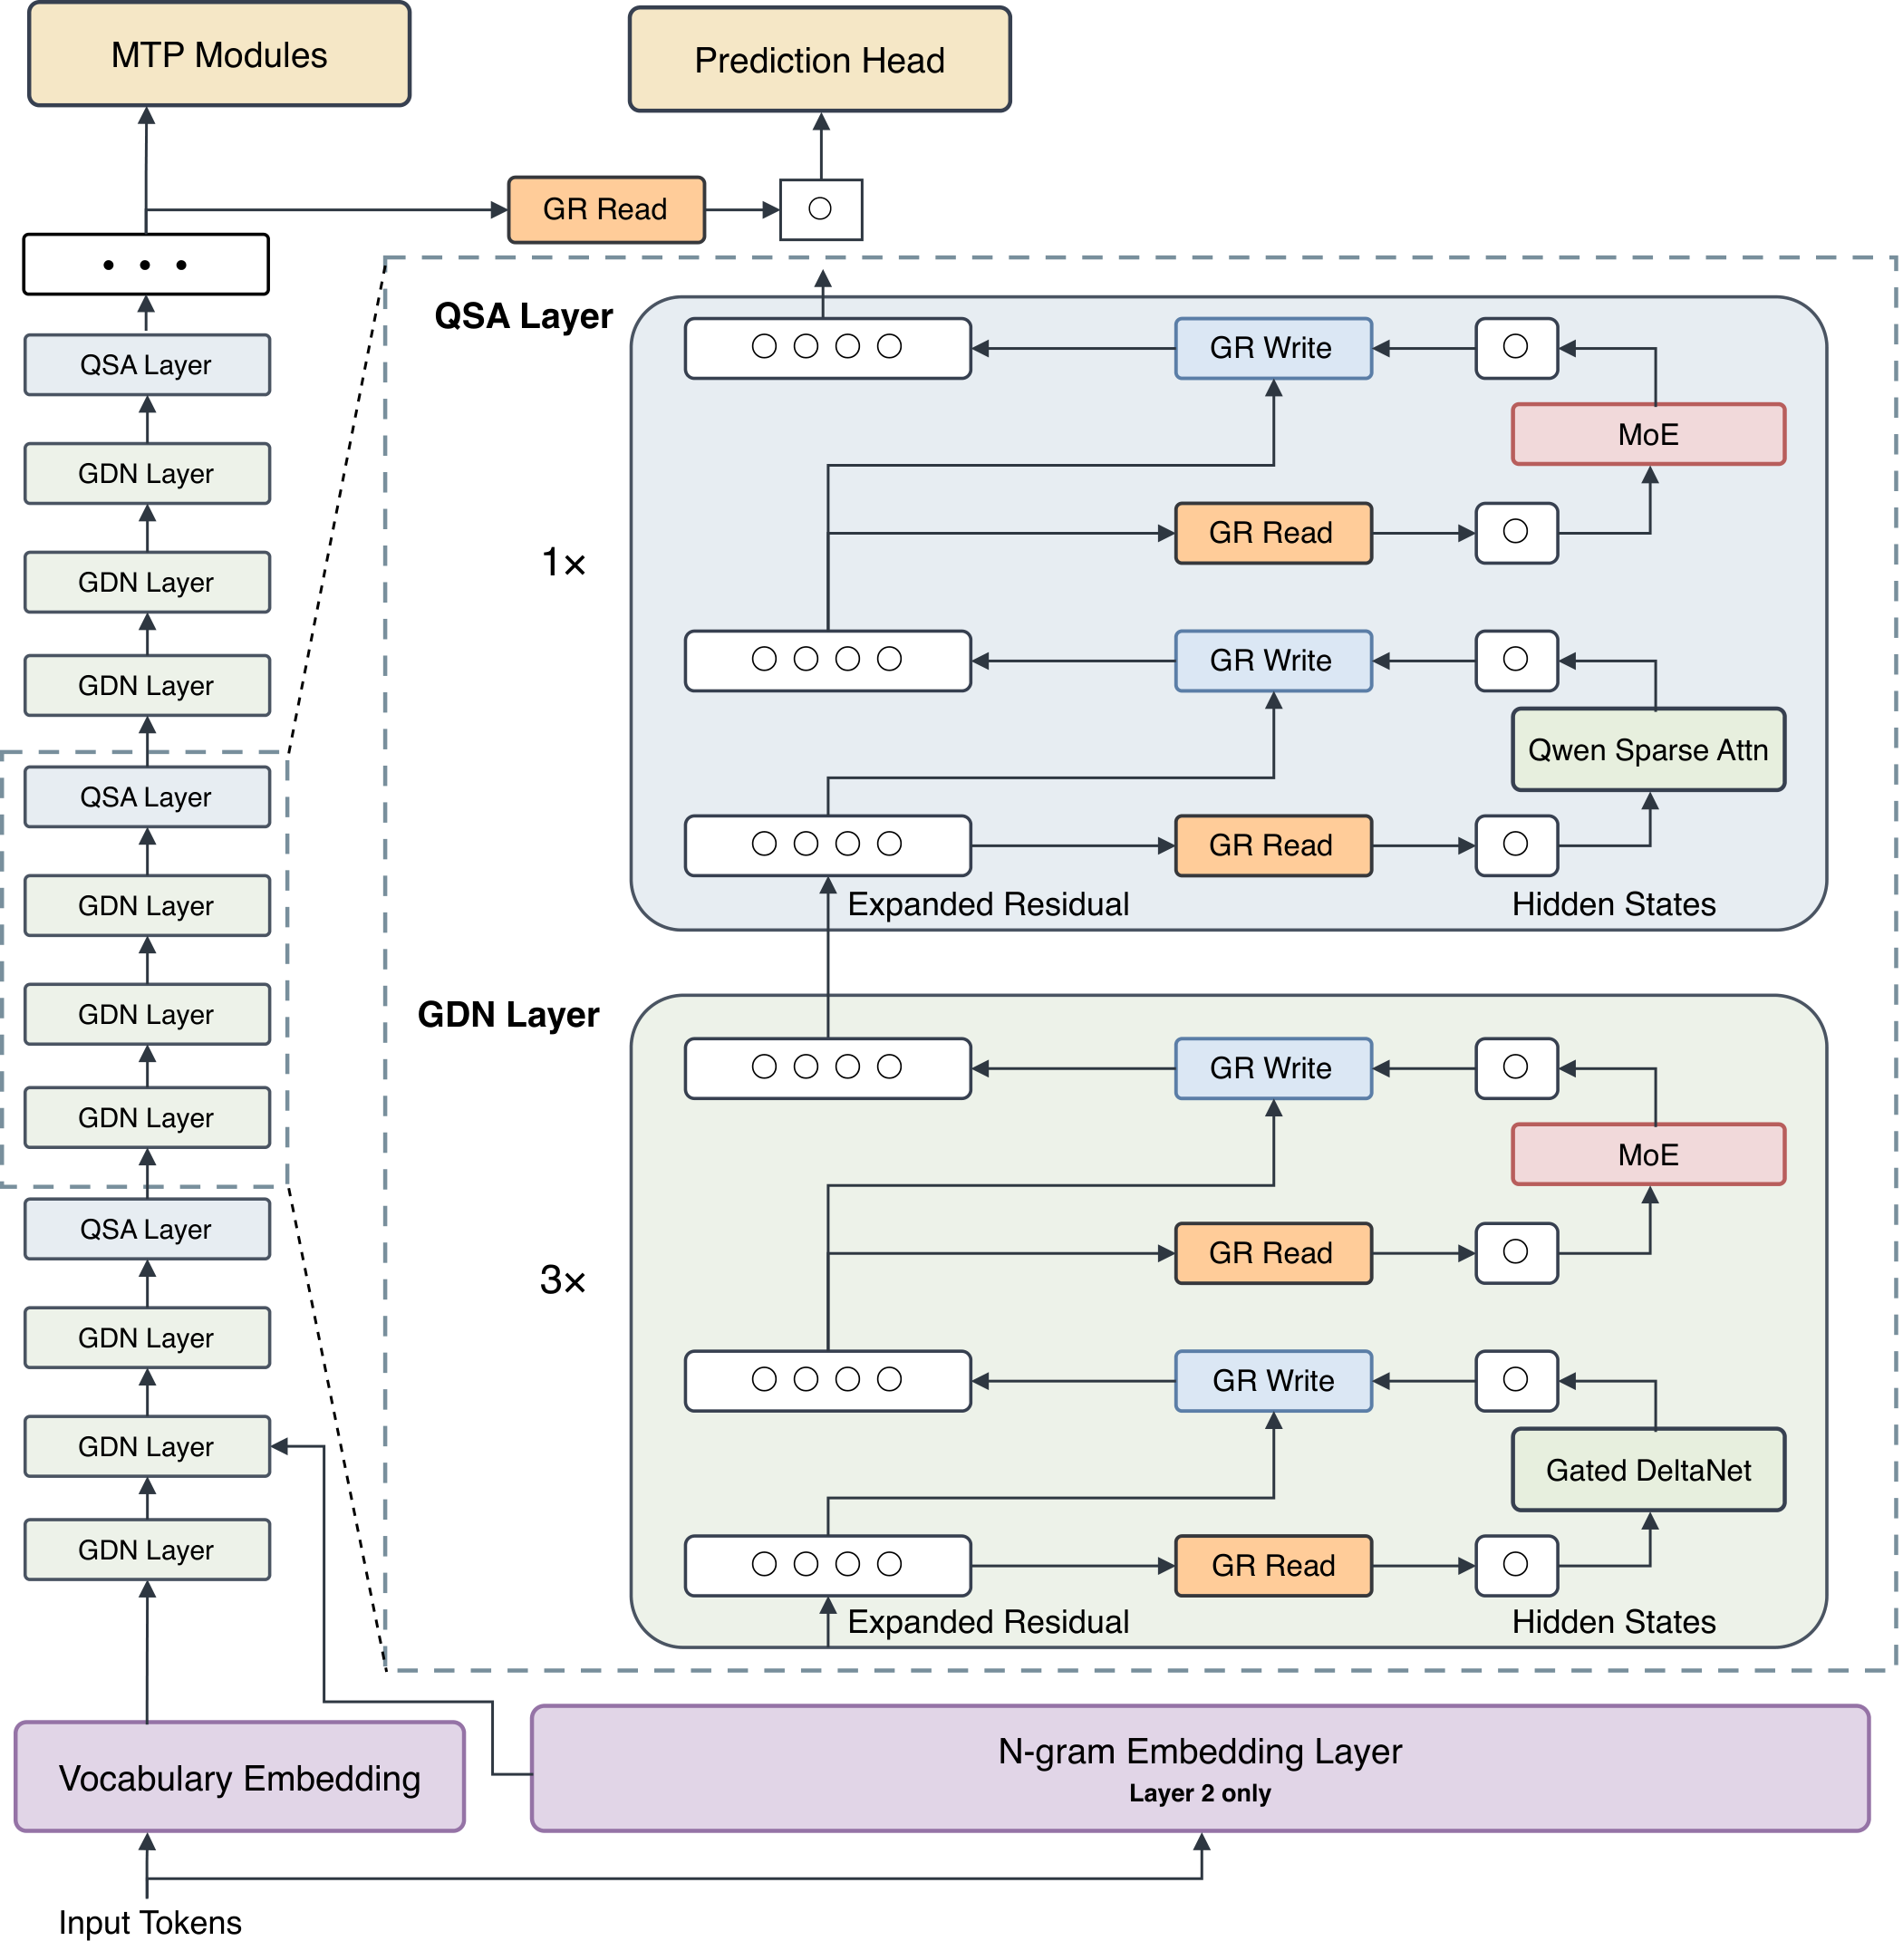
Qwen4-Max introduce diversi cambiamenti alla sua architettura sparse mixture-of-experts:
- Gated DeltaNet e Qwen Sparse Attention: combinano compressione delle informazioni storiche con attenzione selettiva al contesto rilevante, riducendo il calcolo su sequenze lunghe.
- Gated Residual: utilizza quattro rami residuali paralleli e gate dinamici per migliorare il trasferimento di informazioni e la stabilità dell’addestramento.
- N-gram Embedding: aggiunge 328 miliardi di parametri di embedding per rappresentare pattern locali di token tramite operazioni di lookup, ampliando la capacità con un costo computazionale aggiuntivo relativamente basso.
Per gli utenti, il test pratico è se questi cambiamenti riducano le risorse necessarie per ottenere un risultato accettabile. Le misurazioni pubblicate da Qwen sul consumo di token forniscono evidenza di miglioramenti sui task valutati.
Come si comporta Qwen4-Max? Benchmark ufficiali ed esempi
I benchmark pubblicati da Qwen misurano prestazioni sui task, consumo di token e costi di esecuzione, mentre le dimostrazioni illustrano flussi di lavoro pratici.
Risultati benchmark di Qwen4-Max
I seguenti risultati confrontano Qwen4-Max con Qwen3.8-Max:
| Metrica | Qwen4-Max vs. Qwen3.8-Max |
|---|---|
| Punteggio Work360 | Aumentato da 47.74 a 52.69 |
| Consumo di token su Work360 | Ridotto di circa il 24% a Xhigh e del 35% a High |
| Consumo di token su Terminal-Bench 4.0 | Ridotto di circa il 48% a Xhigh e del 49% a High |
| Costo medio per task Work360 | Scese da RMB 26.58 a RMB 11.16, circa il 58% in meno |
La riduzione dei costi riflette sia il minor consumo di token sia i prezzi API rivisti.
Per applicazioni che effettuano chiamate ripetute agli strumenti, il costo per task completato con successo è un confronto più utile rispetto ai soli prezzi per token. Una richiesta a prezzo inferiore offre risparmi limitati se il flusso richiede numerosi retry o correzioni manuali.
Esempi nella ricerca finanziaria e nella manifattura
Diversi esempi ufficiali forniscono deliverable concreti e risultati misurabili.
Nella ricerca finanziaria, il modello combina strumenti di market data e ricerca per produrre fogli di lavoro Excel e report PowerPoint modificabili. Link alle fonti e grafici allineati consentono ai revisori di ricondurre i risultati del report ai dati di supporto.
In un esempio manifatturiero, il modello combina modellazione parametrica, generazione del percorso utensile e feedback della simulazione. Lo sforzo di programmazione umano per un pezzo è sceso da circa 475 minuti a 24 minuti. Questo risultato descrive il pezzo e l’ambiente di utensili dimostrati e costituisce un punto di partenza utile per valutare processi simili.
Come interpretare i risultati
Il punteggio Work360 di Qwen4-Max è aumentato da 47.74 a 52.69, un guadagno di 4.95 punti. Ciò indica prestazioni più forti sui task industriali valutati, sebbene i risultati dei singoli task possano variare. Le riduzioni del consumo di token forniscono una misura separata dell’efficienza, con risparmi diversi alle impostazioni di ragionamento High e Xhigh.
La riduzione del 58% del costo medio per task Work360 combina minore consumo di token e prezzi API rivisti. Per gli sviluppatori, la domanda rilevante è se tali risparmi si traducano in un task completato con successo dopo retry e correzioni manuali.
Le dimostrazioni applicative aggiungono evidenza su flussi specifici e deliverable. Usale per identificare i task da testare, quindi confronta qualità di completamento, sforzo di revisione e costo totale a parità di condizioni degli strumenti.
Prezzi di Qwen4-Max: costi API e opzioni Token Plan
Qwen4-Max è disponibile tramite fatturazione API a consumo e abbonamenti Token Plan. L’opzione appropriata dipende dal fatto che tu stia creando un’applicazione o utilizzando uno strumento AI interattivo.
Prezzi ufficiali API a consumo
QwenCloud elenca i seguenti prezzi per la regione di Singapore:
| Voce di fatturazione | Prezzo per 1 milione di token |
|---|---|
| Input standard | $1.50 |
| Output | $4.50 |
| Input cache implicita | $0.075 |
| Lettura cache esplicita | $0.075 |
La creazione di cache esplicita costa $1.875 per milione di token per una cache di cinque minuti e $3.00 per una cache di un’ora.
Un task che utilizza 100,000 token di input non in cache e 10,000 token di output fatturabili costa $0.195 in fee per i token del modello, escludendo strumenti o servizi aggiuntivi a pagamento.
L’input in cache ha un prezzo inferiore del 95% rispetto all’input standard. Le applicazioni che inviano ripetutamente le stesse istruzioni, definizioni di strumenti o prefissi di documenti possono ridurre i costi di input migliorando l’uso della cache.
Come funziona Token Plan
Token Plan utilizza fatturazione in abbonamento e detrazioni in Crediti. Attualmente elenca qwen4-max tra i modelli supportati.
Al 17 novembre 2026, la pagina della regione di Singapore mostra i seguenti piani mensili individuali:
| Piano | Prezzo mensile | Crediti mensili |
|---|---|---|
| Lite | $6 | 20,000 |
| Essential | $10 | 45,000 |
| Standard | $18 | 80,000 |
| Pro | $43 | 200,000 |
La pagina pubblicizza anche una promozione per nuovi utenti a partire da $3. L’idoneità e l’importo finale sono mostrati al checkout.
I Crediti sono unità di fatturazione dell’abbonamento piuttosto che un plafond diretto di token. Il consumo dipende dalle regole applicabili del modello e degli strumenti.
Secondo la documentazione di Token Plan, il servizio è pensato per l’uso interattivo in strumenti AI compatibili ed è attualmente disponibile nella regione di Singapore.
Come accedere a Qwen4-Max
Ci sono tre vie pratiche: usare un prodotto Qwen, connettersi direttamente tramite QwenCloud o configurare uno strumento AI compatibile. Ognuna ha requisiti di setup diversi, in particolare per credenziali ed endpoint.
Usa le applicazioni Qwen
L’annuncio ufficiale elenca Qwen Studio, l’app Qwen, QwenWork e Qoder come canali di accesso.
Questi prodotti offrono un punto di partenza conveniente per testare analisi di documenti, assistenza al coding e flussi di lavoro d’ufficio. Gli sviluppatori che devono controllare richieste, strumenti e gestione dei risultati possono passare all’integrazione diretta via API.
Accedi all’API QwenCloud
Per accedere a Qwen4-Max, accedi a QwenCloud, ottieni una chiave API per la regione selezionata e configura il relativo endpoint con l’ID modello qwen4-max. QwenCloud fornisce accesso compatibile con OpenAI. Gli utenti in migrazione dalla preview dovrebbero anche rivedere i parametri di richiesta e la configurazione di fatturazione.
Configura strumenti di coding e agent
La documentazione di Token Plan fornisce indicazioni d’integrazione per strumenti tra cui Qwen Code, Cline, Cursor e OpenCode.
La configurazione richiede in genere una chiave API dedicata, la Base URL appropriata e il nome del modello. Token Plan utilizza il dominio endpoint separato token-plan.maas.qwencloudapi.com, e le sue chiavi non sono intercambiabili con le chiavi API a consumo.
Segui la guida per lo strumento scelto, quindi valida la configurazione con un task che includa lettura di materiale, esecuzione di un’operazione e verifica del risultato.
Chi dovrebbe usare Qwen4-Max?
Vale la pena valutare Qwen4-Max quando un flusso ricorrente richiede contesto esteso, più strumenti e un deliverable verificabile.
- Sviluppatori possono valutare Qwen4-Max per modifiche multi-file al codice, sviluppo frontend e agent che usano strumenti esterni.
- Team d’ufficio e di ricerca possono usarlo per analizzare documenti, organizzare dati e preparare report con fonti tracciabili.
- Team di design e contenuti possono testarlo per modellazione 3D, prototipi di gioco e flussi video collegati a software professionali.
- Team enterprise possono valutare processi ricorrenti con accesso ai dati definito, interfacce agli strumenti e criteri di accettazione.
Per flussi finanziari, legali e medici, usalo per l’elaborazione delle evidenze e il supporto analitico, con professionisti qualificati che rivedano le conclusioni rilevanti.
FAQ
Il limite di output di Qwen4-Max è di un milione di token?
No. La finestra di contesto e la lunghezza massima dell’output sono limiti separati. QwenCloud elenca output massimi di 131K token in modalità standard e 262K token in modalità Thinking. Le richieste devono anche rispettare i limiti di input e contesto applicabili.
Dovrei scegliere l’API Qwen4-Max o Token Plan?
Scegli l’API a consumo quando integri Qwen4-Max in un’applicazione o in un servizio backend. Token Plan è pensato per l’uso interattivo in strumenti AI compatibili e utilizza Crediti in abbonamento. Le due opzioni richiedono credenziali ed endpoint separati.
Posso usare Qwen4-Max gratuitamente?
L’accesso API ufficiale e Token Plan sono servizi a pagamento. L’accesso gratuito tramite applicazioni Qwen, quando offerto, segue le regole di account e utilizzo di ciascun prodotto; non costituisce un plafond API gratuito.
Posso scaricare Qwen4-Max per il deployment locale?
Al 17 novembre 2026, Qwen non ha fornito pesi aperti per Qwen4-Max, quindi la release ufficiale non offre un modello scaricabile per deployment locale. Qwen ha annunciato piani per rendere progressivamente open source modelli più piccoli della serie Qwen4.
Conclusione
Qwen4-Max è un forte candidato per analisi di documenti lunghi, coding complesso e flussi che coinvolgono più strumenti. Le valutazioni ufficiali mostrano punteggi più alti e costi per task inferiori rispetto a Qwen3.8-Max sui carichi riportati.
Inizia con un task rappresentativo che abbia già criteri di accettazione chiari. Confronta qualità dell’output, tempo di correzione manuale, tempo di esecuzione e costo totale. Miglioramenti su queste misure forniscono una base pratica per estendere Qwen4-Max a flussi di lavoro simili.