Crea con CometAPITi serve una sola API per più modelli?Testa il flusso di lavoro in Playground, poi crea una chiave API quando modello e costo sono adatti al tuo caso d'uso.
Che cos'è Gemini 4 Hydrogen? Tutto quello che devi sapere
Esplora le funzionalità di Gemini 4 Hydrogen, i benchmark, i prezzi dell'API e la configurazione. Scopri come si inserisce nella programmazione, nell'analisi dei documenti e nei flussi di lavoro degli agenti.
Gemini 4 Hydrogen è il modello di Google focalizzato sull’esecuzione per sviluppatori che costruiscono assistenti di coding, workflow documentali e agent. Combina un budget di contesto condiviso da un milione di token con quattro livelli di ragionamento, rendendo velocità, qualità del compito e costo regolabili all’interno di un unico modello. Il suo principale punto di forza è completare il lavoro pratico in modo efficiente; l’impostazione corretta dipende da quanta capacità di ragionamento serve davvero alla tua applicazione.
Punti chiave
Gemini 4 Hydrogen è mirato a codifica iterativa, debug ed esecuzione guidata da strumenti, da solo o insieme a un modello di pianificazione.
Il budget di contesto da 1,048,576 token è condiviso tra input, ragionamento, chiamate agli strumenti e risposta finale.
LOW, MEDIUM, HIGH e XHIGH offrono profili diversi di qualità, latenza e costo; HIGH è l’impostazione predefinita.
Testo, immagini, audio, video e documenti office supportati possono essere input; l’output generato è testo.
Revisionato per chiarezza, attribuzione delle fonti e terminologia API aggiornata.
Global Standard PayGo costa $1.50 per milione di token di input e $7.50 per milione di token di output, incluso il ragionamento.
Che cos’è Gemini 4 Hydrogen?
Google DeepMind ha presentato Gemini 4 Hydrogen il 12 novembre 2026 per coding, attività agentiche e lavoro di conoscenza quotidiano. Il modello è proprietario e disponibile tramite i prodotti per sviluppatori ed enterprise di Google.
La model card indica che Hydrogen è adattato da Gemini 4 Carbon. Ciò ne stabilisce la discendenza, ma non descrive di per sé ogni cambiamento architetturale o di training. Per gli sviluppatori, la distinzione utile è l’enfasi sull’esecuzione rapida attraverso modifiche ripetute, chiamate agli strumenti e verifica.
Quali sono le principali funzionalità di Gemini 4 Hydrogen?
Codifica, debug e lavoro su repository rapidi
Hydrogen è progettato per il lavoro su repository: individuare un bug, modificare i file rilevanti, eseguire i test e controllare il risultato. Google riporta che Gemini 4 Hydrogen completa i task di benchmark 2,5 volte più rapidamente di Gemini 3.8 Flash al livello di pensiero predefinito HIGH. Questo si riferisce alla performance di completamento dei task nelle valutazioni di Google, non a una riduzione universale di 2,5x della latenza di risposta dell’API. I risultati effettivi dipendono dalla lunghezza del prompt, dall’esecuzione degli strumenti, dalla complessità del compito e dal workflow dell’applicazione, insieme a un incremento su Terminal-Bench 4.1 dal 18.2% al 57.0%. Si tratta di risultati delle valutazioni di lancio, non di una garanzia per ogni codebase.
Letture di file e ricerche in parallelo possono aiutare un agent a ispezionare parti indipendenti di un repository prima di modificare. In pratica, il beneficio dipende dagli strumenti, dalle dipendenze tra i task e da quanto lavoro può essere eseguito in sicurezza in parallelo.
Quattro livelli di ragionamento regolabili
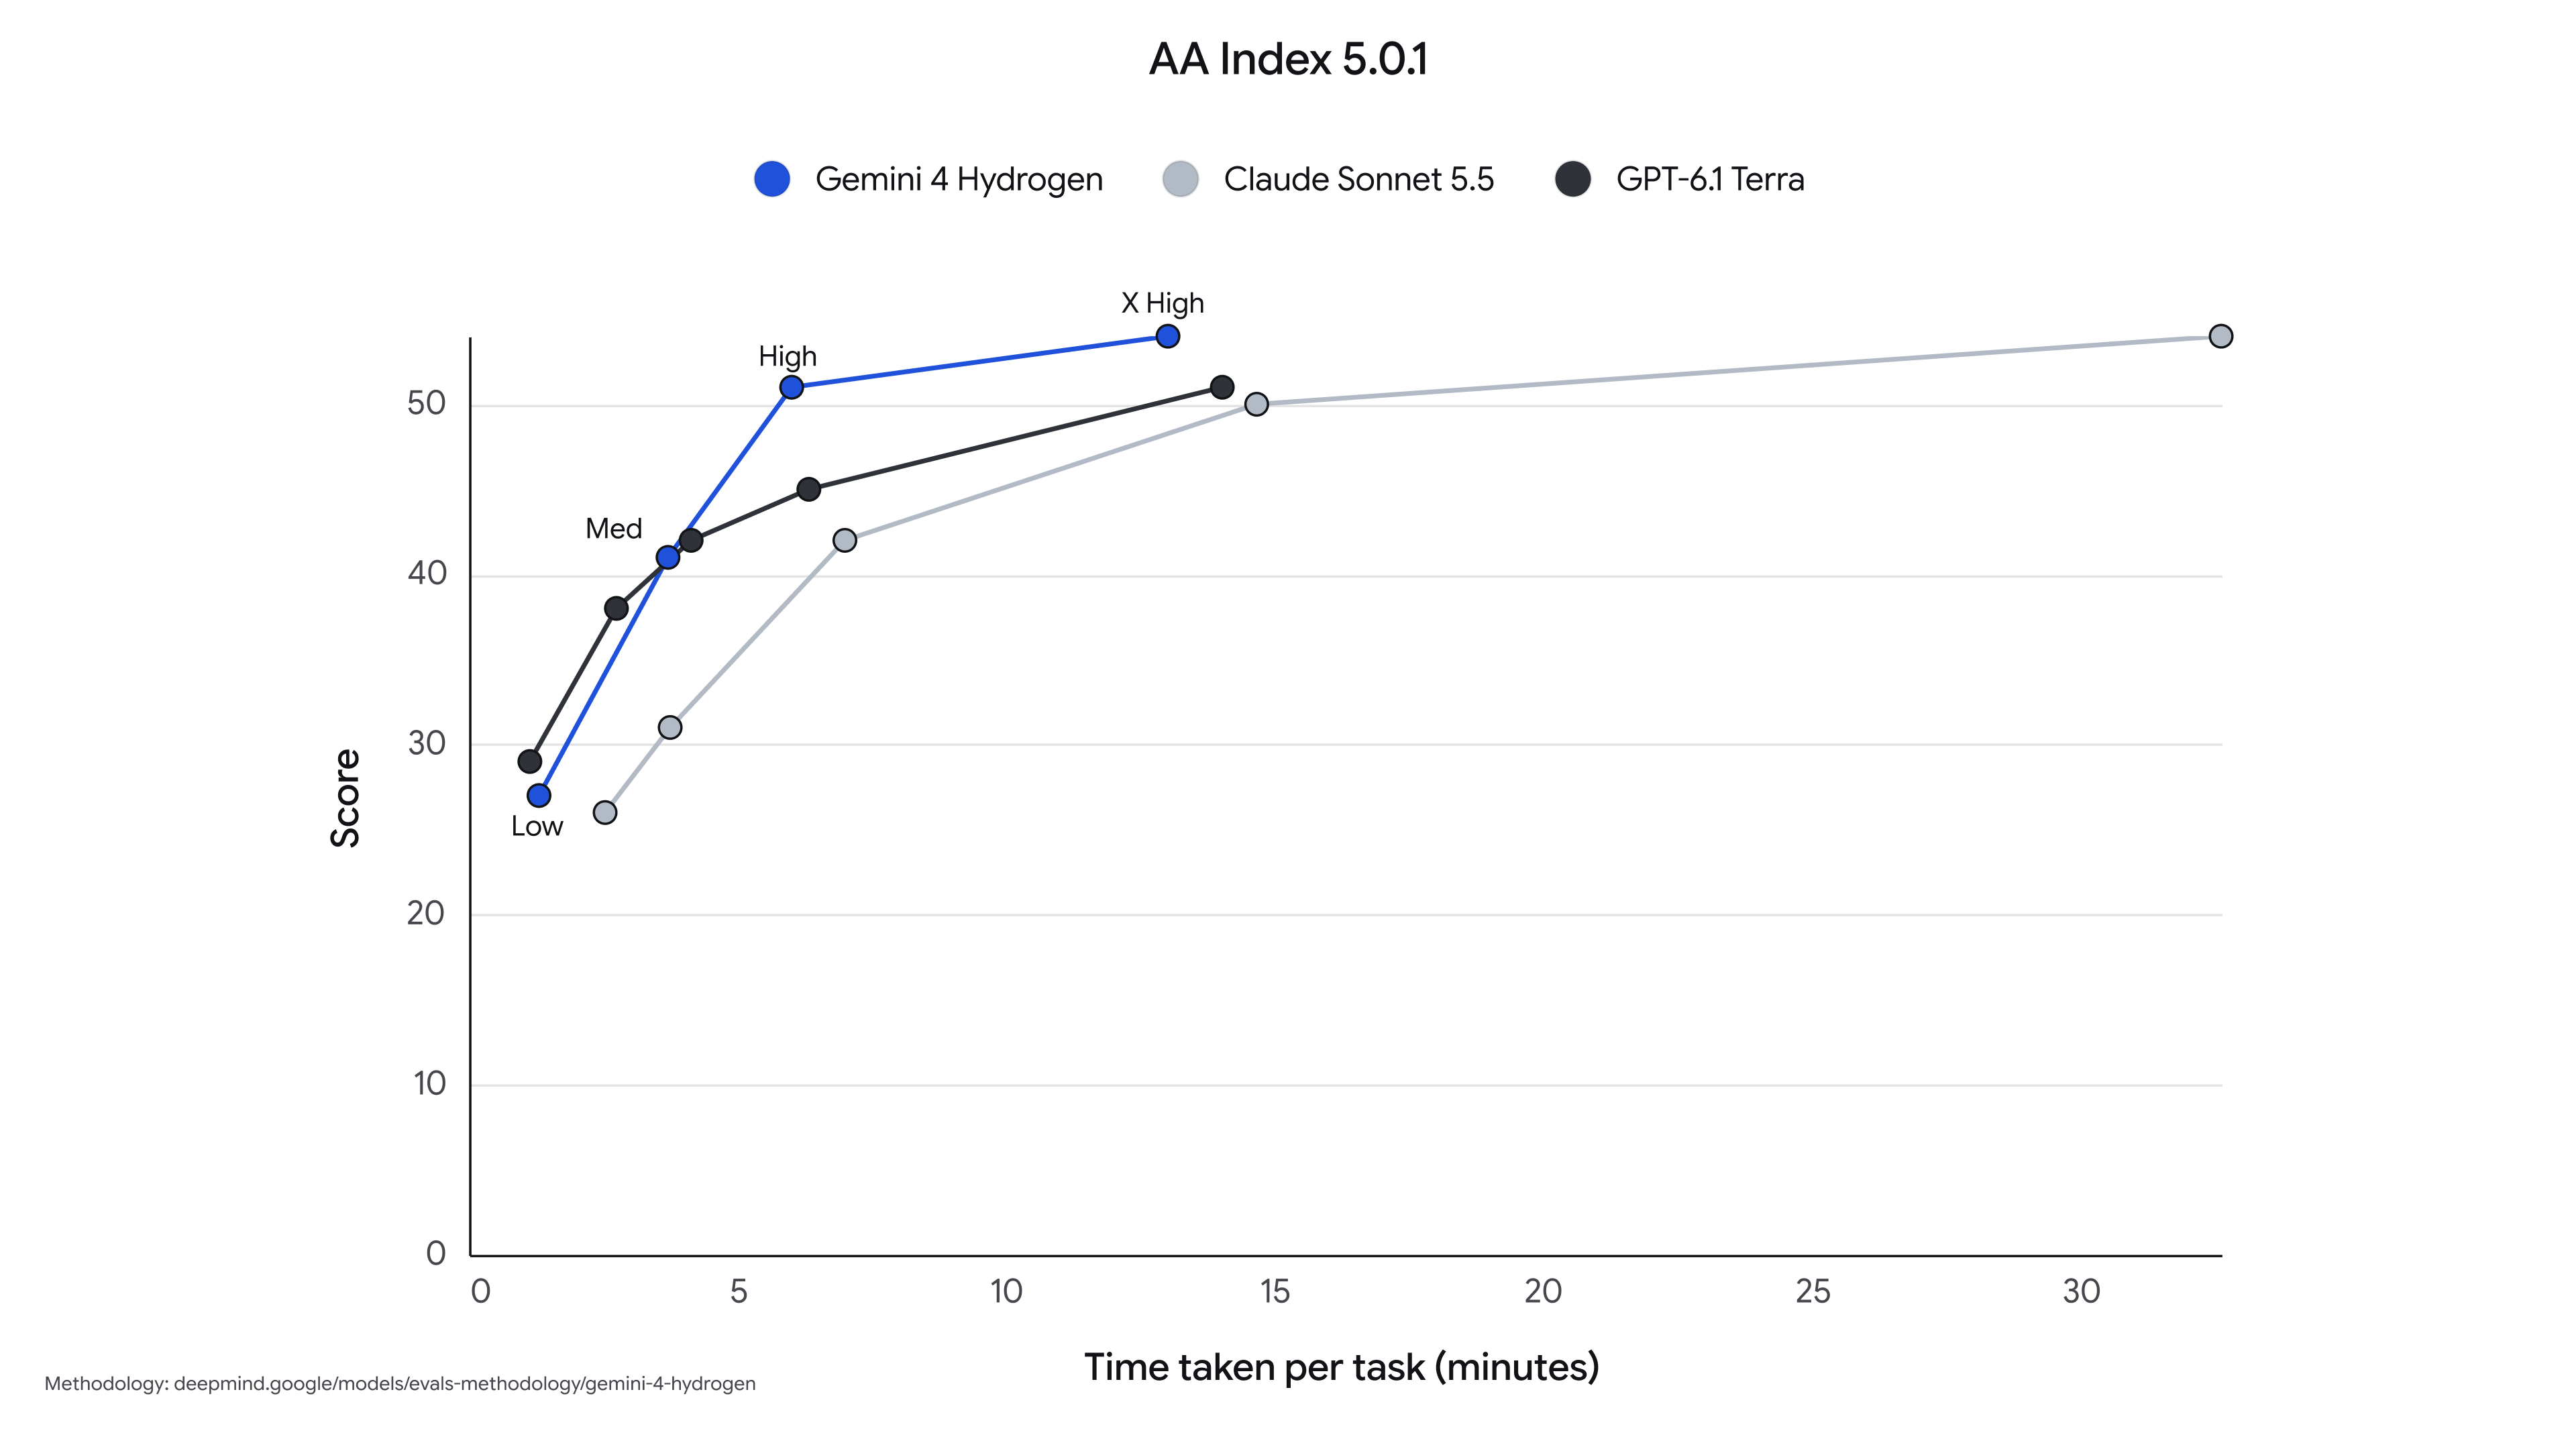
Hydrogen supporta quattro livelli di ragionamento: LOW, MEDIUM, HIGH e XHIGH. HIGH è il predefinito. L’impostazione controlla quanta parte di ragionamento il modello applica prima di produrre una risposta, influenzando quindi la qualità del risultato, il tempo di risposta e l’uso di token di output.
Thinking level
Artificial Analysis Index
Cost per index task
Time per index task
LOW
27
$0.29
1.3 min
MEDIUM
41
$0.80
3.7 min
HIGH (default)
51
$1.87
8.3 min
XHIGH
54
$3.16
about 13 min
Queste misurazioni dell’Artificial Analysis Intelligence Index sono una fotografia del 13 novembre 2026 di task di benchmark, non il costo o la latenza di una normale chiamata API. Punteggi dell’indice, mix di carichi e prestazioni del provider possono cambiare; usa la stessa versione del benchmark e lo stesso livello di ragionamento quando confronti i risultati.
La decisione pratica più frequente è spesso tra MEDIUM e HIGH, non tra HIGH e XHIGH. Passare da HIGH a XHIGH aggiunge solo tre punti di Artificial Analysis Intelligence Index aumentando però il costo misurato per task da $1.87 a $3.16. Per workload agent ad alto volume, lo sforzo di ragionamento aggiuntivo dovrebbe essere giustificato da un miglioramento misurabile nella qualità di completamento del compito.
Il pattern pratico è chiaro: LOW è adatto a compiti lineari in cui la velocità conta; MEDIUM è una buona impostazione interattiva; HIGH è un’ottima scelta predefinita per coding ed esecuzione agentica; XHIGH è meglio riservato a task in cui il ragionamento extra migliora materialmente il risultato.
Il grafico di lancio di Google traccia il punteggio AA Index 5.0.1 rispetto al tempo per task. È una fotografia fissa del lancio; i suoi valori temporali non devono essere trattati come un impegno di livello di servizio in tempo reale.
Lavoro multimodale di conoscenza e documenti Office
Google documenta input PDF, Microsoft Office e OpenDocument insieme a testo, immagini, audio e video. Un’applicazione può combinare un foglio di calcolo, un report, screenshot e una registrazione della riunione, quindi restituire un’analisi scritta o un risultato strutturato.
Hydrogen restituisce testo anziché immagini, audio o video generati. La comprensione video agentica è disponibile ma disattivata per impostazione predefinita; abilitala intenzionalmente quando il workflow richiede elaborazione video attiva.
Chiamata di strumenti, grounding e uso del computer
Function calling, esecuzione di codice, contesto URL, uso del computer e grounding collegano le risposte del modello a strumenti esterni e prove. Seleziona gli strumenti in base alla superficie API che stai usando: una capacità del modello da sola non configura credenziali, permessi degli strumenti o funzioni dell’applicazione.
Controlla la matrice delle funzionalità supportate di Google prima di riutilizzare un’integrazione esistente. Hydrogen non supporta RAG Engine o tuning del modello e il suo workflow di caching usa una cache implicita piuttosto che risorse esplicite di contenuti memorizzati in cache.
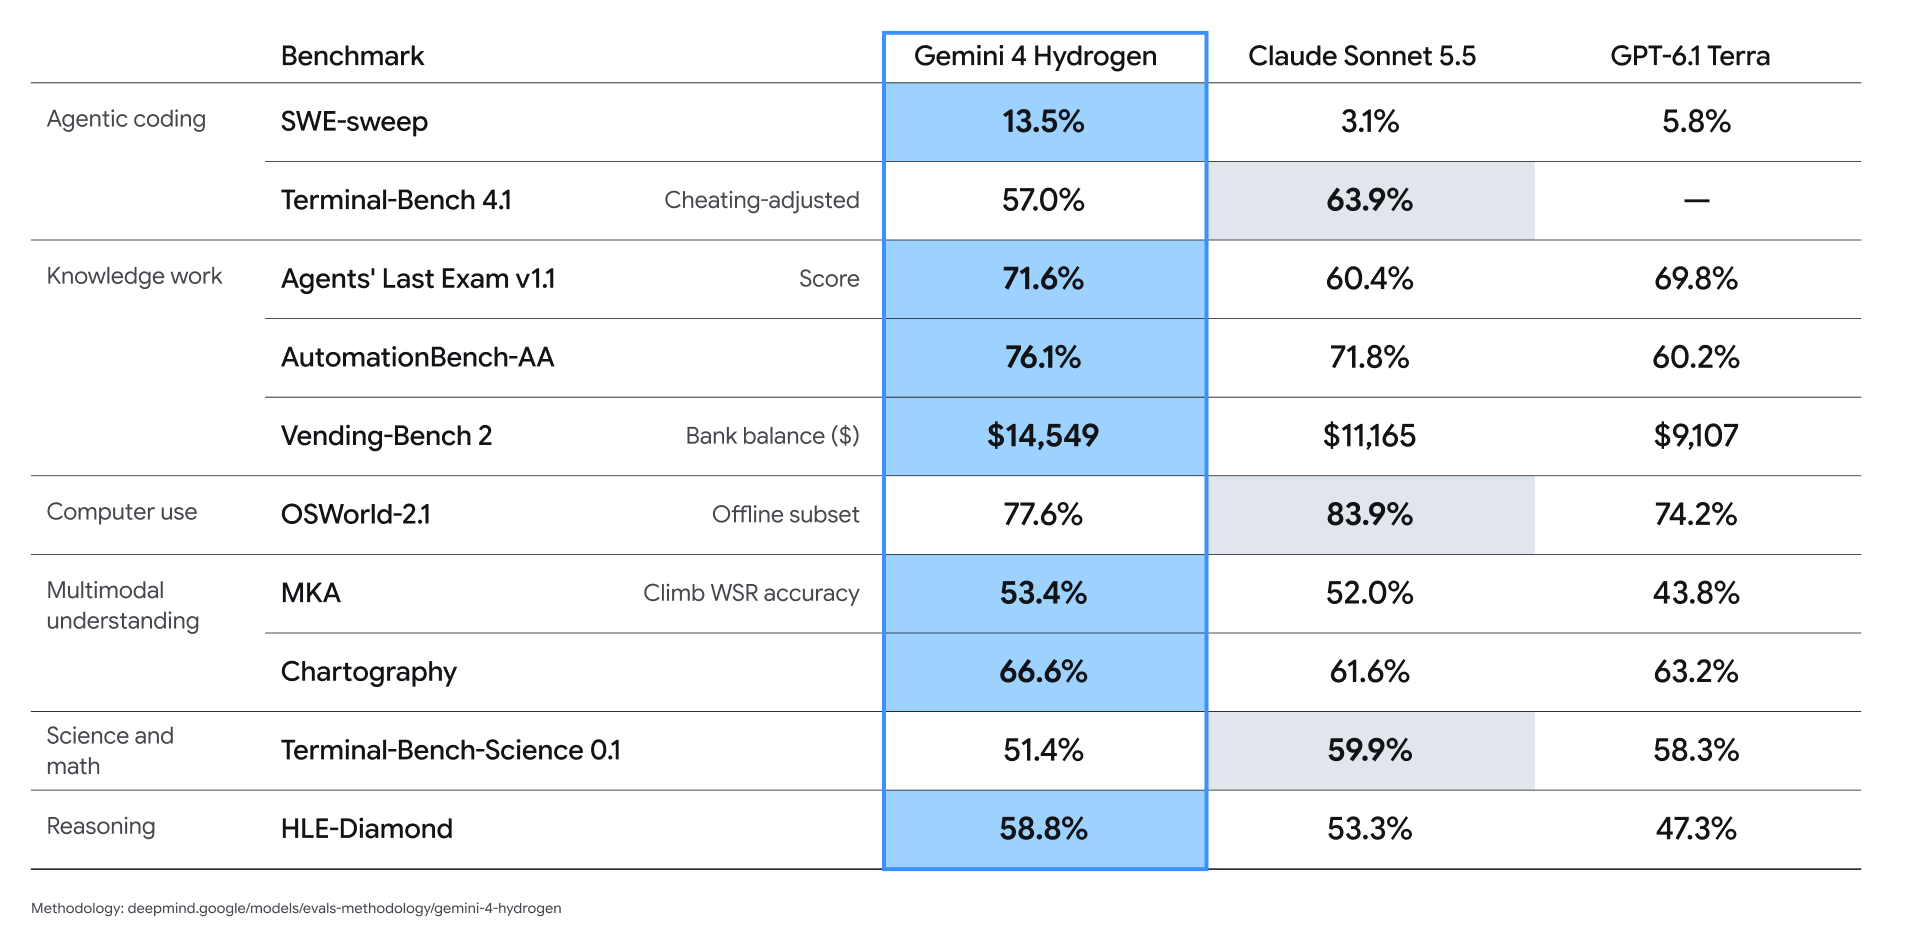
Leggi ogni riga nel relativo setting di valutazione indicato: Terminal-Bench 4.1 è compensato per i casi di cheating; OSWorld-2.1 usa il sottoinsieme offline; MKA riporta la Climb WSR accuracy; e Vending-Bench 2 riporta il saldo bancario simulato, non la percentuale di accuratezza. Un trattino indica che in questo confronto non è fornito alcun risultato. Il riepilogo della model card non specifica un harness completo per modello, budget degli strumenti o configurazione hardware, quindi questi risultati non stabiliscono latenza o costo dell’API in condizioni identiche.
Hydrogen ha il punteggio più alto mostrato in sette delle dieci righe, inclusa Chartography. Sonnet 5.5 è in testa su Terminal-Bench 4.1, OSWorld-2.1 e Terminal-Bench-Science 0.1. Queste differenze favoriscono la scelta di valutazioni simili al tuo workload invece di trattare un modello come vincitore universale.
Il confronto originale di lancio di Google preserva le etichette di benchmark e le note di valutazione. Le cifre sono risultati riportati dal vendor, non misurazioni indipendenti eseguite per questo articolo.
Gemini 4 Hydrogen vs Gemini 4 Carbon, Gemini 4 Argon e Gemini 3.8 Flash
Il confronto più utile non è semplicemente quale modello abbia il punteggio più alto. Gli sviluppatori dovrebbero considerare qualità del compito, latenza, costo per compito completato, requisiti di contesto e se il modello può usare gli strumenti necessari alla loro applicazione.
La tabella confronta ruoli operativi piuttosto che dettagli architetturali non documentati. Google identifica Hydrogen come adattato da Carbon; i nomi di famiglia del modello da soli non stabiliscono internals identici o comportamento API intercambiabile.
Carbon and Argon: $2 / $10 promotional effective rate through Nov. 30, 2026; $4 / $20 from Dec. 1, 2026
$0.75 / $3.75 promotional effective rate through Dec. 31, 2026; $1.50 / $7.50 from Jan. 1, 2027
Best selection rule
Choose when throughput and disciplined execution matter
Choose when the task needs the strongest reasoning
Keep for existing low-cost workflows until migration is justified
I termini di pricing promozionale di Google prevedono gli sconti indicati tramite crediti del 50% sulla spesa netta idonea. Le tariffe promozionali effettive sopra non devono essere interpretate come una riduzione incondizionata di ogni addebito fatturato. Le tariffe sono in USD per milione di token di input/output.
Per una migrazione da Gemini 3.8 Flash, il principale cambiamento di integrazione è il budget condiviso di input/output. Hydrogen modifica anche i predefiniti di ragionamento e il comportamento della cache, quindi la sola sostituzione dell’ID del modello non è una migrazione completa. Confronta i risultati di task accettati, i retry e l’uso totale di token prima di sostituire una distribuzione funzionante.
Carbon e Argon restano opzioni utili per la pianificazione di lavori difficili e ambigui. Una divisione pratica del lavoro è assegnare a Hydrogen un compito di implementazione delimitato ed effettuare escalation delle decisioni irrisolte. La valutazione Orchestrator su Terminal-Bench 4.0 di Google ha riportato un successo vicino a Carbon con il 24% di quota in meno e un completamento più rapido del 19%; questo è il risultato di un sistema multi-modello e non deve essere attribuito solo a Hydrogen.
Dove è possibile accedere a Gemini 4 Hydrogen?
Accesso ufficiale Google
Puoi provare Gemini 4 Hydrogen in Google AI Studio e creare applicazioni con la Gemini API. Per distribuzioni enterprise basate su progetto, usa Gemini Enterprise Agent Platform con l’autenticazione e la configurazione descritte nella guida per sviluppatori di Hydrogen di Google. L’ID del modello è gemini-4-hydrogen.
Per l’uso quotidiano, Hydrogen è disponibile anche tramite l’app Gemini e Google Search. Gli sviluppatori con abbonamenti Google AI a pagamento idonei possono usarlo in Google Antigravity. Scegli un percorso API quando devi integrare il modello nella tua applicazione e un’interfaccia Google quando vuoi lavorarci direttamente.
Accesso CometAPI
Puoi anche accedere alla Gemini 4 Hydrogen API in CometAPI. Questo offre agli sviluppatori un percorso di accesso CometAPI per aggiungere Hydrogen alle loro applicazioni insieme ad altri modelli supportati. Usa il tuo account e la tua chiave API CometAPI e segui le istruzioni di integrazione per il formato di richiesta supportato.
Quanto costa Gemini 4 Hydrogen?
La tabella confronta le tariffe dell’endpoint Google Cloud Global con la Gemini 4 Hydrogen API in CometAPI. I prezzi sono in USD per milione di token al 13 novembre 2026. Le tariffe standard di input e output di CometAPI sono inferiori del 20% rispetto alle Global Standard di Google; gli addebiti di output includono i token di ragionamento così come la risposta finale.
Provider / livello di servizio
Input / 1M token
Output / 1M token
Input in cache / 1M token
Risparmio CometAPI vs Google Standard / 1M token
Google Standard PayGo
$1.50
$7.50
$0.075
Riferimento
CometAPI
$1.20
$6.00
—
Input: $0.30; output: $1.50 (20% ciascuno)
Google Priority PayGo
$2.70
$13.50
$0.135
Livello di servizio diverso
Google Batch
$0.75
$3.75
$0.0375
Livello di servizio diverso
Lo sconto del 20% confronta solo l’uso standard di input e output. Le tariffe Priority, Batch e di input in cache di Google sono mostrate separatamente e non sono la base di quello sconto. Il trattino significa che qui non è indicata una tariffa di input in cache per CometAPI, non che le letture di cache siano gratuite.
Il pricing Standard non globale è $1.65 per milione di token di input e $8.25 per milione di token di output. Le tariffe di input in cache si riferiscono alle letture da cache. Il pricing per la scrittura in cache è programmato per entrare in vigore il 12 gennaio 2027 ed è escluso dall’esempio seguente.
Esempio di costo API di Gemini 4 Hydrogen
Questo esempio presume una richiesta con 100,000 token di input fatturabili e 20,000 token di output fatturabili, inclusi eventuali token di ragionamento, senza sconti di cache o strumenti fatturati separatamente.
Lo stesso workload costa $0.24 tramite CometAPI: $0.12 per l’input più $0.12 per l’output, con un risparmio di $0.06 (20%) rispetto a Google Global Standard. Google Batch costerebbe circa $0.15 e Priority $0.54 alle rispettive tariffe, prima di eventuali strumenti fatturati separatamente. La spesa effettiva dipende dalla lunghezza del prompt, dall’uso di token di ragionamento, dalle chiamate agli strumenti e dal livello di servizio.
Le tariffe di grounding includono 5,000 query di grounding Google Search al mese condivise tra Gemini 3 e Gemini 4, quindi $14 per 1,000 query. Google Maps ha la propria franchigia di 5,000 query e la stessa tariffa per le query eccedenti. Un prompt dell’utente può generare diverse query fatturabili.
Quali sono le limitazioni di Gemini 4 Hydrogen?
Può comunque allucinare o rifiutare richieste innocue
La model card di Google identifica le allucinazioni e riporta un aumento di 5.57 punti percentuali nei rifiuti ingiustificati rispetto a Gemini 3.8 Flash nella sua valutazione di sicurezza automatizzata. Tale cifra riguarda prompt innocui o borderline in un test specifico; non è il tasso di rifiuto per tutto il traffico in produzione. Usa prove aggiornate per compiti fattuali e valuta sia le risposte errate sia i rifiuti non necessari sui tuoi input.
Ciclo di vita GA a breve termine
Hydrogen è una release GA a breve termine con una politica di preavviso di ritiro minimo di 45 giorni. Mantieni il modello configurabile e pianifica come valutare una sostituzione. La politica di preavviso non è una promessa che un particolare endpoint rimarrà disponibile indefinitamente.
Conclusione
Inizia con un piccolo set di valutazione tratto dal tuo workload reale: una modifica al codice che deve superare i test, un’attività documentale con risposte verificabili e una sequenza di strumenti con criteri di successo chiari. Registra qualità di completamento, tempo trascorso, retry e token totali fatturati. Adotta Hydrogen dove migliora tali risultati e mantieni un fallback per i casi che non gestisce in modo affidabile. Questo trasforma un promettente confronto di lancio in una decisione di distribuzione difendibile.
FAQ
Come posso riprendere un long decode di Gemini 4 Hydrogen interrotto?
Con un SDK Python compatibile, una continuazione interrotta può esporre output parziale e un continuation token tramite ContinuationInterruptedError. Conserva quello stato e segui la procedura di recupero del long decode per la tua superficie API. Ritentare la richiesta originale da zero può ripetere lavoro e addebiti; i segmenti completati potrebbero essere già stati fatturati.
Come dovrei organizzare i prompt di Gemini 4 Hydrogen per il caching?
Mantieni istruzioni stabili e materiale di riferimento condiviso all’inizio, con l’input variabile dell’utente in seguito. La soglia documentata per la cache implicita è 4,096 token. Riutilizzare un prefisso può migliorare l’idoneità alla cache, ma i risparmi effettivi dipendono dagli hit di cache e dall’uso fatturato; non dare per scontato che ogni prompt ripetuto riceva il prezzo di input in cache.
Come posso rendere più facile verificare i risultati dell’agente di Gemini 4 Hydrogen?
Assegna a ogni strumento uno scopo ristretto e definisci una condizione osservabile di completamento prima che il modello inizi. Per una modifica a un repository, richiedi i test rilevanti e ispeziona il diff; per l’estrazione da documenti, valida l’output contro uno schema e conserva il passaggio di supporto. Valuta l’artefatto finale e le prove degli strumenti invece di accettare un messaggio di completamento sicuro come prova.