
TL;DR
I modelli video di AI stanno andando oltre la vecchia formula text-to-video verso sistemi in grado di comprendere un brief creativo completo—testo, immagini, filmati di riferimento, movimento, voci, musica ed effetti sonori—e trasformarlo in una scena audiovisiva coerente. MiniMax ha lanciato ufficialmente H3 il 31 luglio 2026 come modello di generazione omni-modale generico che comprende congiuntamente testo, immagini, video e audio e genera clip fino a 15 secondi con audio stereo nativo. La novità principale è un’architettura unificata che tratta text-to-video, image-to-video, generazione del primo/ultimo fotogramma, generazione basata su riferimenti, motion transfer, editing audiovisivo e creazione condizionata dall’audio come variazioni di un unico problema di generazione multimodale, anziché pipeline isolate. Il prodotto ospitato offre output 2K di default tramite un workflow in cui H3-Base genera inizialmente con lato corto a 768p e H3-Regenerate-2K ricostruisce poi la scena utilizzando il contesto originale. Questa combinazione di qualità audiovisiva competitiva, controllo multimodale flessibile, pesi H3-Base scaricabili e finalizzazione 2K consapevole del contesto rende H3 uno dei rilasci video tecnicamente più distintivi del 2026.
Key Takeaways
- New architecture: Contextual Omni Representation, H3-VAE, H3-Omni Transformer e In-Context Regeneration unificano comprensione e generazione tra modalità.
- Performance improvements: H3 genera clip da 4–15 secondi con video a 24 FPS, audio stereo a 32 kHz e output 2K ospitato ricostruito dal contesto multimodale originale.
- API and open-weight availability: MiniMax fornisce API H3-2K, H3-Context-IR e H3-Regenerate-2K ospitate, mentre H3-Base-FL2VA e H3-Base-Ref2VA sono disponibili come checkpoint scaricabili.
- Main use cases: Pubblicità, branding, e-commerce, product design, UI/UX, gaming, cinema, generazione guidata da riferimenti, motion transfer ed editing audiovisivo.
- Pricing and deployment boundary: Il prezzo ufficiale a consumo è $0.08/second a 768P e $0.13/second a 2K; solo H3-Base è scaricabile, mentre H3-Context-IR e H3-Regenerate-2K restano servizi ospitati.
What Is MiniMax H3?
MiniMax H3 è un sistema di generazione audio-video omni-modale generico sviluppato da MiniMax. Invece di accettare solo un prompt o una singola immagine di riferimento, H3 può ragionare su un contesto contenente testo, immagini, video e audio e poi generare video sincronizzato e suono stereo.
Il sistema H3 ospitato supporta output di 4–15 secondi, video a 24 FPS e audio stereo a 32 kHz. MiniMax commercializza il sistema ospitato come 2K di default. Tecnicamente, H3-Base crea un risultato con lato corto a 768p e H3-Regenerate-2K reimmette quel risultato e il contesto originale in H3 per la ricostruzione in 2K. MiniMax riporta anche generazione di dialoghi stabile in 11 lingue, tra cui inglese, cinese, giapponese, coreano, francese, tedesco, spagnolo, portoghese, italiano, russo e arabo.
Questa distinzione è rilevante. Molti workflow video precedenti sono di fatto pipeline:
prompt -> video muto -> parlato -> effetti sonori -> musica -> sincronizzazione
H3 invece modella audio e video come parti di un unico processo generativo. Il suo H3-Omni-Transformer predice congiuntamente i latenti video e audio, riducendo la necessità di assemblare in seguito fasi indipendenti per video, doppiaggio, musica e sincronizzazione.
MiniMax H3 Specifications at a Glance
| Specification | MiniMax H3 |
|---|---|
| Developer | MiniMax |
| Model category | Generative video omni-modale generico |
| Input modalities | Testo, immagine, video, audio |
| Output | Video più audio stereo nativo |
| Output duration | 4–15 secondi |
| Base resolution | Lato corto a 768p per H3-Base |
| Hosted resolution | Fino a 2K tramite H3-Regenerate-2K 2K offerto di default; prodotto tramite H3-Regenerate-2K dopo la generazione base a 768p |
| Frame rate | 24 FPS |
| Audio | Stereo a 32 kHz |
| Stable dialogue languages | 11 |
| Aspect ratios | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16 e dimensioni aggiuntive |
| Reference limits | Fino a 9 immagini, 3 video, 3 clip audio e 12 file misti |
| Core generative model | H3-Omni-Transformer denso da 33B |
| Position encoding | 3D Multimodal RoPE |
| Open-weight checkpoints | H3-Base-FL2VA e H3-Base-Ref2VA |
| Checkpoint precision | BF16 |
| License | MiniMax H3 Community License |
La cifra 33B si riferisce all’H3-Omni-Transformer piuttosto che a ogni componente utilizzato nell’intera pipeline ospitata.
What Makes MiniMax H3 Different?
One Model for Multiple Video Tasks
La maggior parte dei generatori video storicamente separa text-to-video, image-to-video, movimento di riferimento, video editing, generazione audio e funzionalità di riferimento del soggetto.
MiniMax adotta un approccio diverso. H3 è stato pre-addestrato sulle relazioni generalizzate tra contesto multimodale e output desiderato, consentendo di descrivere tali relazioni in linguaggio naturale.
Ad esempio, un creator può chiedere concettualmente a H3 di seguire il movimento di camera in un video, preservare il personaggio da un’immagine e usare un altro clip audio come riferimento vocale. Le demo di lancio di MiniMax utilizzano questo tipo di istruzioni cross-modali per illustrare il sistema di riferimenti generalizzato di H3.
Questo rende H3 meno simile a una collezione di modalità di generazione e più simile a un motore creativo multimodale.
Native Video and Stereo Audio Generation
La descrizione tecnica di MiniMax afferma che l’H3-Omni-Transformer predice i latenti video e audio congiuntamente. Il lato audio opera tramite H3-AudioVAE, che comprime audio a 32 kHz in una sequenza latente a 40 Hz prima di decodificare il risultato generato in suono stereo.
Questo conferisce a H3 un vantaggio pratico per scene contenenti dialoghi, audio ambientale, musica o effetti sonori: il suono è parte del contesto generativo invece di una fase di post-produzione completamente separata.
Omni-Reference Inputs
H3-Base-Ref2VA supporta fino a 9 immagini, 3 clip video e 3 clip audio, soggetto a un massimo di 12 file di input misti. I video di riferimento e le clip audio possono durare ciascuno 2–15 secondi, con restrizioni sulla durata totale per ogni modalità. L’audio non può fungere da unico input di riferimento in modalità Ref2VA.
La parte importante non è solo la quantità di riferimenti. H3 è progettato per inferire la relazione tra tali asset.
- preservare un personaggio da un’immagine;
- riprodurre il movimento da una clip di riferimento;
- trasferire uno stile visivo o cinematografico;
- preservare o sostituire l’audio;
- usare una voce come riferimento di timbro;
- modificare una scena audiovisiva esistente tramite istruzioni in linguaggio naturale.
In-Context 2K Regeneration
L’approccio di H3 all’alta risoluzione è particolarmente importante.
Invece di passare semplicemente l’output a 768p attraverso una normale rete di super-risoluzione, H3-Regenerate-2K reintroduce il contesto multimodale originale insieme al risultato base e chiede a H3 di rigenerare la scena alla risoluzione superiore.
Il vantaggio previsto è il recupero semantico. Un comune upscaler può interpolare pixel ma non può ricostruire in modo affidabile informazioni scomparse—piccole scritte, elementi di branding o dettagli fini degli oggetti. La fase di rigenerazione di H3 può consultare nuovamente il prompt e i riferimenti originali durante la costruzione del risultato 2K.
How Does the MiniMax H3 Architecture Work?
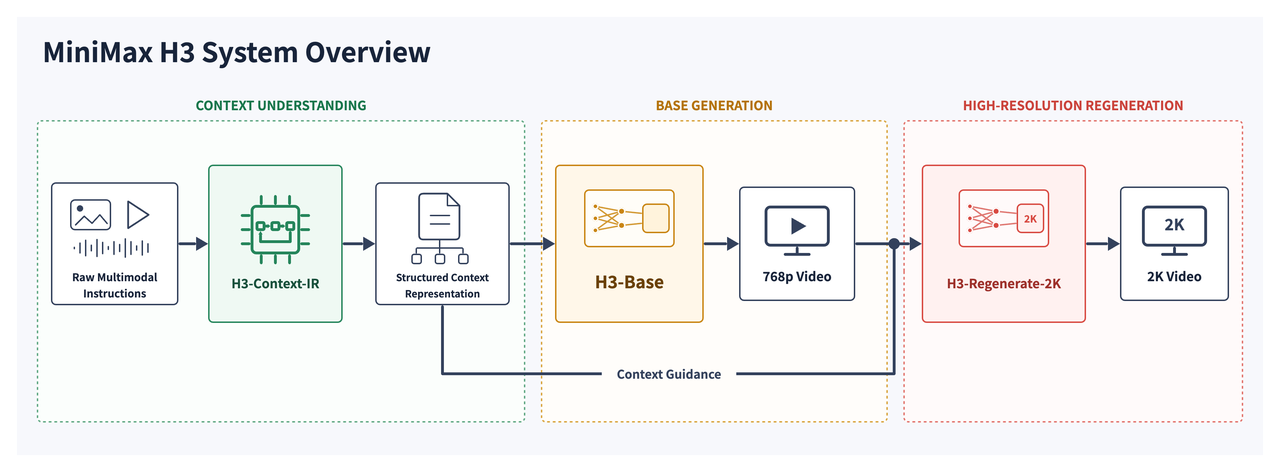
Il workflow completo di H3 ha tre fasi principali:
H3-Context-IR -> H3-Base -> H3-Regenerate-2K
H3-Context-IR interpreta un’istruzione potenzialmente complessa e multimodale e la converte in una Context Intermediate Representation strutturata. H3-Base consuma tale rappresentazione e genera video a 768p più audio. H3-Regenerate-2K combina quindi il risultato generato con il contesto originale per costruire una versione a risoluzione più alta.
H3-Contextual Omni Representation and H3-Context-IR
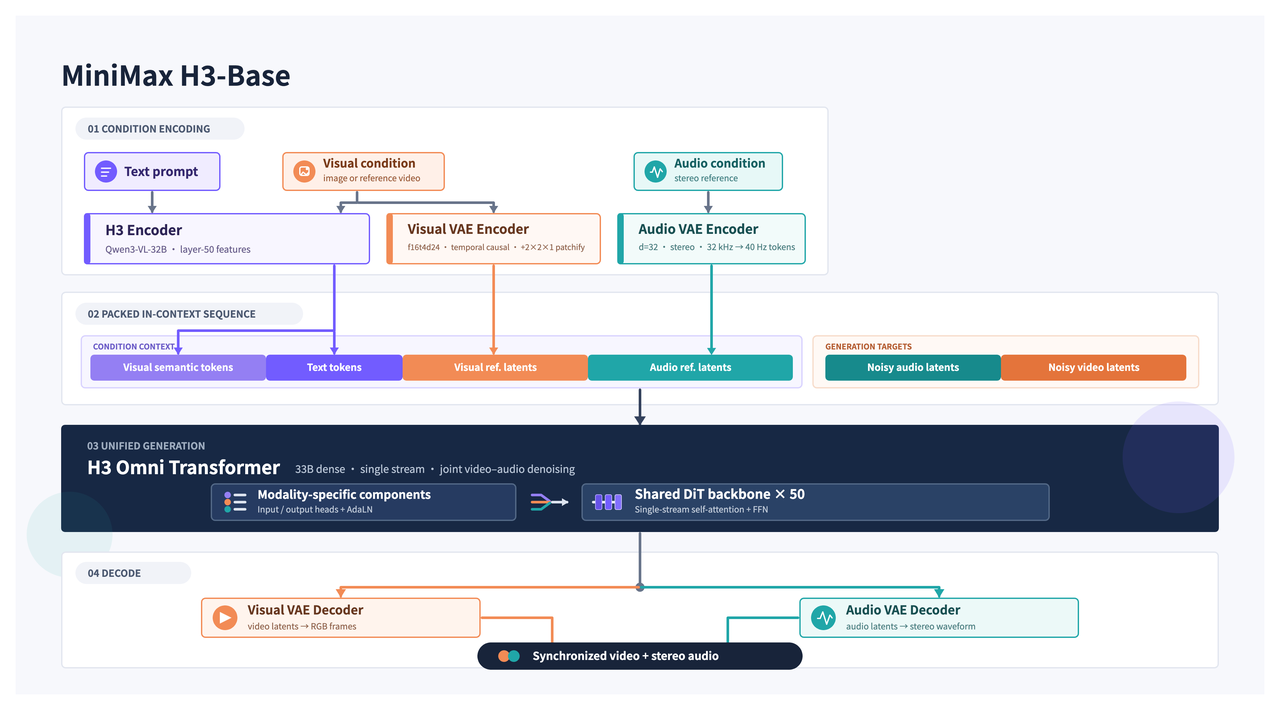
Contextual Omni Representation è il concetto progettuale più ampio di MiniMax: il linguaggio funge da ponte che descrive le relazioni tra contesto, obiettivo e molteplici modalità. Nella descrizione di sistema rilasciata, H3-Context-IR è il livello ospitato di pre-processing e orchestrazione che analizza le istruzioni, associa le modalità, ragiona sul tempo e serializza il risultato per H3-Base.
L’H3-Encoder rimane un componente specifico all’interno di H3-Base. Usa i pesi pre-addestrati di Qwen3-VL-32B e passa gli stati nascosti dal livello 50 all’H3-Omni-Transformer.
H3-VAE
La terminologia di lancio “H3-VAE” copre le rappresentazioni latenti visive e audio della famiglia di modelli. La documentazione dei pesi aperti distingue H3-VisualVAE da H3-AudioVAE. H3-VisualVAE utilizza codifica causale temporale con compressione spaziale 16×, compressione temporale 4× e 24 canali latenti, seguiti da patchification 1 × 2 × 2. H3-AudioVAE comprime audio stereo a 32 kHz in token latenti a una frequenza temporale di 40 Hz.
H3-Omni-Transformer
Il blog di lancio riporta il nome come “H3-Omni Transformer”; la documentazione tecnica dei pesi aperti usa “H3-Omni-Transformer”. Entrambi si riferiscono allo stesso componente generativo core. È un Transformer denso, single-stream, da 33B parametri. Circa 13B parametri risiedono nei rami legati ad AdaLN; i loro output di modulazione possono essere precomputati e memorizzati in cache, quindi non è necessario mantenerli caricati durante il deployment solo-inferenza.
I componenti specifici della modalità sono concentrati nei livelli di input/output e nei rami AdaLN, mentre il Transformer centrale opera su una sequenza unificata impacchettata. La Multimodal RoPE tridimensionale rappresenta posizioni temporali e spaziali su (t, h, w).
H3-In-Context Regeneration
Il blog di lancio di MiniMax chiama la tecnica H3-In-Context Regeneration; il modulo di produzione si chiama H3-Regenerate-2K. Esso reimmette il risultato a 768p e il contesto originale in H3 per ricostruire un output 2K, permettendo di rigenerare dettagli semantici invece di limitarci a interpolarli.
Is MiniMax H3 Really Open Source?
Spostato qui dalla sua precedente posizione dopo la sezione di confronto perché il confine dei pesi aperti è una distinzione architetturale centrale.
“Open-weight” è più preciso di “completamente open source”. MiniMax rende disponibili i checkpoint H3-Base-FL2VA e H3-Base-Ref2VA per l’uso locale, includendo processore, tokenizer, text encoder, Transformer, Visual VAE e Audio VAE richiesti.
Tuttavia, l’intera pipeline di produzione non è scaricabile end-to-end. H3-Context-IR rimane ospitato e H3-Regenerate-2K non è incluso nel rilascio iniziale dei pesi aperti. La generazione locale con H3-Base mira a una risoluzione con lato corto a 768p; la riproduzione del workflow ufficiale completo in 2K richiede servizi ospitati per l’elaborazione del contesto e la rigenerazione.
H3 utilizza inoltre la MiniMax H3 Community License invece di una licenza permissiva standard come Apache 2.0 o MIT. Le organizzazioni dovrebbero esaminare le condizioni territoriali, di attribuzione, sicurezza e uso commerciale della licenza prima del deployment.
MiniMax H3 Benchmark Performance
I materiali di lancio di MiniMax si concentrano principalmente su demo, architettura e casi d’uso piuttosto che pubblicare una classica matrice di benchmark in stile VBench. Per uno snapshot più neutrale, una fonte utile è la Video Arena di Artificial Analysis, dove gli utenti confrontano alla cieca generazioni a partire dagli stessi prompt.
| Artificial Analysis task | H3 rank | H3 Elo | Leader | Leader Elo |
|---|---|---|---|---|
| Text-to-Video with Audio | #4 | ≈1,228 | Wan 3.0 | 1,242 |
| Image-to-Video with Audio | #3 | 1,185 | H3 Max, post-addestrato da fal | 1,202 |
| Video Editing with Audio | #2 | 1,129 | Wan 3.0 | 1,190 |
Queste classifiche sono uno snapshot del 2 settembre 2026, non punteggi permanenti. H3 è competitivo con i sistemi proprietari leader ed è particolarmente notevole tra le voci con pesi aperti. La sua proposta di valore è la combinazione di qualità competitiva, generazione audiovisiva nativa, riferimenti multimodali e pesi base scaricabili—non semplicemente la pretesa del punteggio di benchmark più alto.
MiniMax H3 Pricing
I seguenti prezzi a consumo sono stati ricontrollati con la pagina di pricing ufficiale di MiniMax il 24 settembre 2026. I prezzi possono cambiare, quindi i team di produzione dovrebbero verificarli nuovamente prima di pianificare il budget.
| Usage | Official list price |
|---|---|
| H3 generation at 768P | $0.08/second |
| H3 generation at 2K | $0.13/second |
| 768P → 2K regeneration output | $0.05/second |
| Standard-generation reference audio | Free |
| Standard-generation reference images | First 5 free; then $0.04/image |
| Regeneration reference images | First 5 free; then $0.025/image |
| Regeneration reference video | $0.05/second of original 768P input |
| H3-Context-IR input | $0.90/M tokens |
| H3-Context-IR output | $3.60/M tokens |
Al prezzo di listino, una generazione diretta da 10 secondi costa circa $0.80 a 768P o $1.30 a 2K; una generazione da 15 secondi costa circa $1.20 o $1.95. Questi esempi escludono riferimenti fatturabili, token Context-IR e altri addebiti specifici del workflow.
MiniMax H3 è disponibile anche tramite CometAPI. La sua pagina modello pubblicizza una tariffa di partenza di $0.064/second sotto il model ID minimax-h3. I prezzi headline di terze parti possono dipendere da instradamento, risoluzione e regole di fatturazione, quindi non vanno considerati come tariffe unitarie universali.
MiniMax H3 vs Wan3.0 vs Seedance 2.5 vs Vidu Q3
I concorrenti più utili non sono necessariamente modelli identici sulla carta. MiniMax H3, Wan3.0, Seedance 2.5 e Vidu Q3 enfatizzano parti diverse del workflow video professionale.
| Dimension | MiniMax H3 | Wan3.0 | Seedance 2.5 | Vidu Q3 |
|---|---|---|---|---|
| Maximum single generation | 15s | 30s | 30s | 16s |
| Video resolution | 2K ospitato; base open-weight a 768p | Fino a 1080P | Dipende dalla route | Fino a 1080P |
| Native audio-video | Yes | Yes | Yes | Yes |
| Reference inputs | Testo, immagine, video, audio | Immagine, video, audio, documenti, pagine web | Immagini, video, audio | Flussi immagine/riferimento |
| Reference capacity | 12 file misti | Fino a 20 materiali | Fino a 50 materiali | Non indicato nella pagina principale |
| Major differentiator | H3-Base con pesi aperti più rigenerazione 2K | 30s più input ampi | Storytelling da 30s più ampio set di riferimenti | Breve narrativa e controllo dei dialoghi |
| Strongest fit | Pipeline creative personalizzabili | Produzione lunga all-in-one | Storytelling commerciale ricco di riferimenti | Brevi scene narrative e guidate dal dialogo |
| Strongest fit | Pipeline creative personalizzabili | Produzione lunga all-in-one | Storytelling commerciale ricco di riferimenti | Brevi scene narrative e guidate dal dialogo |
Which Model Is Better?
Non esiste un vincitore universale. Scegli MiniMax H3 quando pesi aperti, condizionamento multimodale, audio stereo nativo, editing audiovisivo e finalizzazione 2K contano più della durata massima della clip. Scegli Wan 3.0 quando contano di più output a 30 secondi, 1080P, ampi riferimenti a documenti/web e ottime prestazioni in arena. Scegli Seedance 2.5 per set di riferimenti molto grandi, struttura narrativa a 30 secondi, coerenza d’identità o editing mirato. Scegli Vidu Q3 per brevi scene narrative, dialoghi multi-personaggio, timing e controllo della camera in stile regia.
Una valutazione responsabile dovrebbe eseguire lo stesso set di prompt interni su tutte le API candidate. Le classifiche pubbliche non espongono sempre versioni direttamente comparabili e la sostituzione di una variante più vecchia o “turbo” può distorcere il risultato.
What Are MiniMax H3's Main Limitations?
- Duration: H3 si ferma a 15 secondi, mentre alcuni concorrenti supportano ora generazioni da 30 secondi.
- Open-weight scope: solo H3-Base è scaricabile; Context-IR e rigenerazione 2K restano ospitati.
- Hardware requirements: un modello video denso da 33B rimane costoso da distribuire in locale, anche con ottimizzazioni d’inferenza.
- Pricing complexity: generazione, rigenerazione, video e immagini di riferimento, e Context-IR possono generare addebiti separati.
- License conditions: la Community License richiede una revisione legale più attenta rispetto alle licenze permissive standard.
- Benchmark volatility: le classifiche in arena cambiano e non sostituiscono test specifici per il proprio carico di lavoro.
Who Should Use MiniMax H3?
H3 è un’ottima scelta per sviluppatori e team creativi che costruiscono workflow video multimodali che necessitano di coerenza dei soggetti, riferimenti di movimento o voce, audio stereo nativo, editing e finalizzazione ad alta risoluzione. È rilevante anche per team che vogliono personalizzare o auto-ospitare il modello base, usando fasi ospitate solo quando necessario.
I team che necessitano principalmente della generazione singola più lunga, del deployment locale più leggero o di uno stack end-to-end completamente permissivo potrebbero preferire un altro modello. MiniMax evidenzia pubblicità, branding, e-commerce, product design, UI/UX, gaming e cinema come scenari di creazione commerciale.
How Can Developers Access MiniMax H3?
Ci sono tre percorsi principali:
- Usare i prodotti ospitati di MiniMax, inclusi Hailuo e MiniMax Design.
- Usare la MiniMax Open Platform di prima parte per le API H3-2K, H3-Context-IR e H3-Regenerate-2K.
- Scaricare i checkpoint H3-Base per il deployment locale tramite il repository ufficiale e i framework di inferenza supportati.
Per i dettagli di implementazione, utilizzare la documentazione ufficiale di API e deployment collegata nell’elenco delle fonti qui sotto; questo articolo resta focalizzato sulla valutazione del prodotto.
Conclusion
MiniMax H3 è importante meno perché guida ogni singola metrica e più perché comprime una catena di produzione frammentata in un unico sistema multimodale programmabile. I pesi scaricabili di H3-Base consentono a sviluppatori di prototipare, personalizzare e iterare in locale, mentre le fasi ospitate H3-Context-IR e H3-Regenerate-2K forniscono l’elaborazione più ricca delle istruzioni e la finalizzazione ad alta risoluzione necessarie per il lavoro in produzione. Quel modello ibrido crea anche compromessi: il limite di 15 secondi, i requisiti di infrastruttura locale, la dipendenza da servizi ospitati, i costi a livello di workflow e le condizioni della Community License devono essere valutati rispetto ai prompt reali e ai vincoli di consegna del team. Per i team che danno priorità al controllo dei riferimenti multimodali, all’audio nativo sincronizzato, all’editing audiovisivo e ai master in 2K, H3 è una piattaforma convincente; i team che necessitano principalmente di clip più lunghe o di uno stack permissivo completamente autonomo dovrebbero confrontare benchmark alternativi prima di impegnarsi.
FAQ
How should a production team divide work between local H3-Base and MiniMax’s hosted services?
Un workflow ibrido pratico è usare H3-Base in locale per esplorazione rapida, iterazione dei prompt, test dei riferimenti e qualsiasi fase in cui contano il controllo dell’infrastruttura o la località dei dati. Gli output promettenti possono poi passare a H3-Context-IR ospitato per un’elaborazione delle istruzioni più ricca e a H3-Regenerate-2K per la consegna alla risoluzione finale. La ripartizione corretta dipende dalla capacità GPU, dai tempi di consegna, dai requisiti di governance e dal fatto che il guadagno qualitativo delle fasi ospitate giustifichi l’ulteriore trasferimento, latenza e fatturazione.
What should an internal evaluation set measure before a team adopts H3?
Non valutate H3 solo con prompt visivamente d’impatto. Usate un set ripetibile di brief di produzione reali e valutate aderenza alle istruzioni, coerenza di soggetti e brand, stabilità temporale, rendering del testo, accuratezza del movimento di camera, sincronizzazione audio-video, qualità dei dialoghi, fedeltà della rigenerazione, latenza, tasso di fallimento e costo totale per clip accettata. Eseguite gli stessi asset e criteri di accettazione sui modelli concorrenti in modo che le classifiche pubbliche non sostituiscano evidenze dal carico di lavoro reale del team.
How should multimodal reference assets be prepared to improve controllability?
Gli asset di riferimento dovrebbero avere ruoli chiari e non in conflitto: un’immagine può definire l’identità, una clip può definire il movimento e un campione audio può definire la voce o l’atmosfera. Rimuovete i riferimenti di bassa qualità o contraddittori, tagliate le clip all’azione rilevante e dichiarate esplicitamente l relazione tra ciascun asset e l’output target nell’istruzione. Partire dal più piccolo set di riferimenti sufficiente rende più facile diagnosticare quale asset migliora il risultato e quale introduce ambiguità.
Which production costs are easy to miss when comparing H3 with another API?
Il prezzo per secondo di generazione è solo la base visibile. Un modello di costo realistico dovrebbe includere video di riferimento fatturabili e immagini aggiuntive, token di Context-IR, rigenerazione 2K, retry, generazioni rifiutate, capacità GPU locale, archiviazione e trasferimento media, gestione della moderazione, integrazione ingegneristica e revisione umana. Il confronto utile è il costo per deliverable approvato alla risoluzione richiesta—non il costo per generazione grezza.
How should teams interpret “2K by default” when H3-Base itself generates at 768p?
Le frasi descrivono livelli diversi del prodotto. “2K by default” si riferisce all’esperienza commerciale ospitata, mentre 768p descrive il lato corto dell’output della fase H3-Base scaricabile; H3-Regenerate-2K ricostruisce poi l’output finale usando sia il risultato base sia il contesto originale. I test di qualità dovrebbero quindi confrontare l’output locale a 768p e l’output finale ospitato a 2K come fasi di workflow separate, prestando attenzione al fatto che la rigenerazione ripristini davvero testo, branding, volti e dettagli fini invece di limitarsi ad aumentare le dimensioni in pixel.
When is MiniMax H3 unlikely to be the best first choice?
H3 può essere inadatto quando un progetto richiede clip sensibilmente più lunghe in singolo passaggio, finalizzazione 2K completamente locale, una licenza permissiva standard, un investimento GPU minimo o un workflow text-to-video molto semplice che trae poco beneficio da riferimenti multimodali. In quei casi, il valore dell’architettura generalizzata di H3 potrebbe non compensare l’extra di complessità operativa. Una breve prova di concetto con prompt rappresentativi è il modo più sicuro per determinare se il suo controllo e l’integrazione audio-video migliorino materialmente il deliverable finale.