
TL;DR
Muse Ember è il più piccolo modello di ragionamento multimodale di Meta, progettato per attività agentiche ad alto volume come instradamento, estrazione, chiamata di strumenti e codifica mirata. Meta ha introdotto Muse Ember il 9 novembre 2026.
La sua finestra di contesto da 1,048,576 token accoglie un materiale sorgente sostanziale. Meta offre accesso tramite Model API e Muse Code; CometAPI elenca muse-ember, con lo stato di attivazione trattato sotto. Inizia con un task ripetuto di cui puoi verificare l’output, poi confronta il costo per risultato riuscito, includendo ragionamento, strumenti e retry.
Punti chiave
- Role: Muse Ember è costruito per l’esecuzione ripetuta da parte di agenti, inclusi classificazione, estrazione, chiamata di strumenti e task di codifica con ambito delimitato.
- Inputs and capacity: Muse Ember accetta testo, immagini, audio e video, con una finestra di contesto da 1M token e fino a 512K token di output.
- Performance: I risultati di Meta favoriscono Muse Ember su diversi benchmark agentici, mentre test di analytics indipendenti mostrano che prezzi token bassi non producono sempre il costo per task più basso.
- Pricing: Le richieste sopra i 200K token di input passano a una fascia di prezzo superiore; il costo totale del task dipende anche da ragionamento e uso degli strumenti.
- Access: Meta Model API e Muse Code sono disponibili; l’elenco di CometAPI attualmente indica il modello come Coming soon.
Per cosa è più adatto Muse Ember?
Muse Ember gestisce i passaggi di esecuzione in un workflow agentico mentre un modello più grande si occupa della pianificazione. Si adatta a task ad alto volume con input chiari, ambito limitato e un risultato che la tua applicazione può verificare. I suoi lavori principali sono:
- Classificazione e instradamento: Etichetta le richieste e inviale alla coda o al servizio corretto.
- Estrazione: Trasforma documenti e media in campi strutturati con evidenze della fonte.
- Chiamata di strumenti: Seleziona una funzione e fornisce gli argomenti che la tua applicazione esegue.
- Elaborazione in batch: Applica un’operazione ripetibile su file o record.
Instradamento dei ticket di supporto
Un workflow pratico di supporto può chiedere a Ember di estrarre un riferimento d’ordine, assegnare una categoria e segnalare informazioni mancanti. La tua applicazione può validare il riferimento rispetto ai propri registri prima di instradare il ticket. Mantieni rimborsi, modifiche dell’account e altre azioni consequenziali dietro i controlli di autorizzazione dell’applicazione.
Estrazione documentale con evidenze
Per la gestione di fatture o contratti, richiedi sia il valore estratto sia la pagina o il passaggio che lo supporta. Tratta campi assenti e illeggibili come esiti espliciti invece di invitare il modello a indovinare. Questo produce record che i revisori possono ispezionare senza rileggere ogni documento.
Lavoro di codifica focalizzato
Dai a un worker di codifica un perimetro di proprietà ridotto: i file che può modificare, il comportamento da preservare e i test che definiscono il completamento. L’esempio di migrazione del codice parallela di Meta illustra questa divisione del lavoro. L’agente circostante esegue i comandi e verifica i risultati; la sola risposta del modello non è una prova che una modifica abbia superato i test.
Il visual del lancio di Muse Ember accompagna la sua guida alla combinazione di un modello di esecuzione con un modello di pianificazione più grande.
Meta afferma che Muse Ember è il primo modello addestrato usando Muse Wonder Full, estendendo la sua strategia di usare modelli più grandi per sviluppare modelli specializzati.
Specifiche di Muse Ember
Le specifiche principali sono:
| Specifica | Muse Ember |
|---|---|
| Developer | Meta Superintelligence Labs |
| Data di annuncio | 9 novembre 2026 |
| Categoria del modello | Ragionamento multimodale ed esecuzione agentica |
| Finestra di contesto | 1,048,576 token |
| Output massimo | 524,288 token |
| Modalità di input | Testo, immagini, audio, video |
| Input di file | Supportati tramite Responses API |
| Modalità di output | Testo |
| Livello di ragionamento | Minimal, Low, Medium, High, XHigh, Max |
| Livello di ragionamento predefinito | Max |
| Chiamata di strumenti | Supportata |
| Output strutturato | Supportato |
| Search grounding | Supportato tramite Model API |
Meta non ha rilasciato i pesi di Muse Ember né divulgato il numero di parametri. I limiti di richieste e token si applicano per team, con tutte le chiavi API del team che condividono la capacità del modello.
Contesto e input multimodali
Per workflow con PDF, Meta estrae il testo dalle prime 100 pagine e le immagini dalle prime 50, quindi suddividi i file più lunghi prima dell’elaborazione. Invia il materiale necessario per il task; i token di ragionamento condividono la quota di output da 524,288 token con la risposta finale.
Usa screenshot quando il layout conta, scansioni per l’estrazione documentale, audio per l’analisi di riunioni e video per eventi che si sviluppano nel tempo. Una trascrizione è sufficiente per un riassunto solo testuale. I file sono supportati tramite Responses API e i risultati vengono restituiti come testo.
Sforzo di ragionamento configurabile
Muse Ember offre sei livelli di ragionamento: Minimal, Low, Medium, High, XHigh e Max. Meta usa Max come impostazione predefinita; tutti i livelli sono supportati e un valore non supportato restituisce HTTP 400. Avvia instradamento e classificazione di routine a un livello più basso, poi aumentalo solo quando il guadagno nelle risposte accettate giustifica la latenza extra e il costo di token di output.
Chiamata di strumenti e output strutturato
Muse Ember supporta chiamata di strumenti e output strutturato. Le chiamate di strumenti collegano le decisioni del modello alle funzioni applicative, mentre l’output strutturato rende i campi estratti più facili da validare e passare allo step successivo.
Questo risultato esemplificativo per un ticket di supporto fornisce a un’applicazione di instradamento una categoria, una priorità e un flag di revisione:
{
  "category": "billing",
  "priority": "high",
  "requires_human_review": true
}
Meta Model API supporta anche search grounding e workflow di computer-use. L’applicazione connessa fornisce gli strumenti, esegue le azioni e controlla i permessi.
Come si comporta Muse Ember nei benchmark?
I risultati del lancio di Meta utilizzano il massimo sforzo di ragionamento. Agents’ Last Exam copre il subset Linux nella valutazione interna di Meta, mentre Terminal-Bench usa per ciascun modello il miglior harness pubblicato. Combinano i risultati di Artificial Analysis riportati esternamente con valutazioni interne di Meta; il Personal Superintelligence Index è un composito interno di Meta, non una leaderboard indipendente separata.
Risultati benchmark di Muse Ember
| Benchmark | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| AutomationBench-AA | 37.8 | 13.9 | 20.2 |
| Agents' Last Exam | 61.6 | 57.0 | 57.1 |
| Personal Superintelligence Index | 46.8 | 36.1 | 37.0 |
| Terminal-Bench 4.0 | 40.9 | 39.2 | 16.4 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA | 27.2 | 34.9 | 25.2 |
| GDP.pdf-AA | 22.8 | 20.8 | 22.8 |
| OSWorld 2.1 (partial score) | 69.5 | 68.9 | 50.5 |
| OSWorld 2.1 (binary score) | 33.8 | 27.8 | 17.0 |
| PerceptionBench (with tools) | 80.6 | 78.6 | 62.8 |
| Artificial Analysis Intelligence Index | 36 | 36 | 28 |
Terminal-Bench 4.0 usa mini-swe-agent per Muse Ember, Claude Code per Haiku 5.5 e Codex per GPT-6 Luna. Questi non sono ambienti di esecuzione identici. OSWorld 2.1 riporta sia punteggi con credito parziale sia binari, mentre PerceptionBench include strumenti. I risultati dell’Artificial Analysis Intelligence Index sono dalla versione 5 pubblicata il 9 novembre 2026.
Analisi dei benchmark di Muse Ember
Agent execution è l’area più forte di Muse Ember.
Su AutomationBench-AA, Muse Ember segna 37.8, rispetto a 13.9 per Haiku 5.5 e 20.2 per GPT-6 Luna. Questo supporta il posizionamento di Meta di Muse Ember come modello per workflow aziendali end-to-end e operazioni agentiche ripetute.
La performance di codifica è competitiva, ma non universalmente superiore.
Muse Ember segna 40.9 su Terminal-Bench 4.0 e 46 su Coding Agent Index-AA. Tuttavia, segna 27.2 su FrontierCode 2.0-AA, sotto il 34.9 di Haiku 5.5. Questo suggerisce che Muse Ember sia un candidato utile per sottotask di codifica con ambito limitato, mentre lavoro ingegneristico più difficile dovrebbe essere testato contro alternative più forti.
I risultati multimodali e di computer-use sono promettenti.
Muse Ember segna 80.6 su PerceptionBench con strumenti e 69.5 su OSWorld 2.1 con punteggio a credito parziale. Questi risultati supportano il suo posizionamento per workflow che coinvolgono comprensione visiva e interazione con il computer.
L’intelligenza generale è paragonabile a Haiku 5.5.
Muse Ember e Haiku 5.5 arrotondano entrambi a 36 sull’Artificial Analysis Intelligence Index, avanti rispetto a GPT-6 Luna a 28. Per una decisione di selezione, abbina quel confronto ampio ai risultati specifici per task sopra.
Intelligenza di Muse Ember vs costo per task
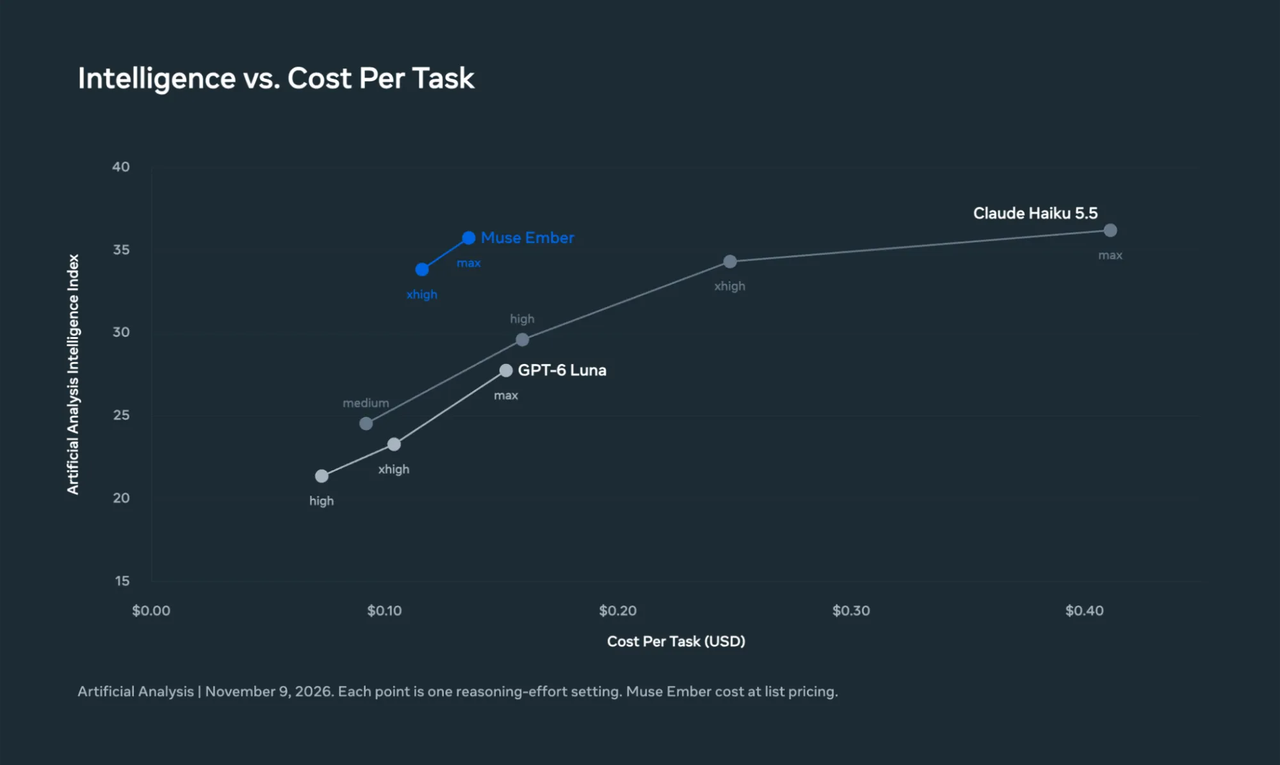
Il grafico di Meta confronta i punteggi dell’Artificial Analysis Intelligence Index con il costo stimato per task a diversi livelli di sforzo di ragionamento.
Al massimo sforzo di ragionamento, Muse Ember segna 35.8 sull’Artificial Analysis Intelligence Index con un costo stimato di $0.136 per task. Haiku 5.5 segna 36.2 a $0.411, mentre GPT-6 Luna segna 27.8 a $0.152. Su questo benchmark, Ember si avvicina al punteggio di Haiku a circa un terzo del costo per task ed eccede il punteggio di Luna a un costo leggermente inferiore.
Queste stime usano consumo di token del benchmark e prezzi di listino. La valutazione successiva mostra perché l’attività degli strumenti conta nella scelta di un modello per uno specifico workflow.
Risultati indipendenti di analisi dei dati
La valutazione di analisi dei dati di Plotly del 10 novembre 2026 ha testato 43 domande in Plotly Studio Embedded contro un dataset sintetico sull’energia eolica. Muse Ember è stato eseguito tramite OpenRouter; i costi riportati usano i prezzi disponibili quando ogni modello è stato eseguito. Sono risultati specifici per il carico di lavoro, non un test di fatturazione con API native Meta.
| Metrica di valutazione | Muse Ember | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
| Domande superate | 38/43 | 38/43 | 37/43 |
| Costo totale del test | $1.04 | $0.13 | $0.38 |
| Tempo mediano per domanda | 28 seconds | 18 seconds | 14 seconds |
Per questo workload di analisi dei dati, GPT-6 Luna ha fornito lo stesso conteggio di 38/43 di Ember a un ottavo del costo totale, con una latenza mediana inferiore. Haiku è stato il più veloce a 14 secondi per domanda, con 37/43 superate. Luna è il candidato di partenza più forte per un workflow di analytics sensibile al costo; il basso tasso per token di Ember da solo non lo rende la scelta più economica.
Plotly ha rilevato che Muse Ember ha effettuato in media 78 query su domande con pattern nascosti, rispetto a una mediana di 25 tra i modelli testati. L’attività aggiuntiva degli strumenti ha aumentato il consumo di token e il costo totale.
Il test ha mostrato anche punti di forza: Muse Ember ha risposto correttamente a tutte le 20 domande di analytics chiaramente definite, a tutte le cinque domande ambigue, a tutte le cinque richieste impossibili e a tutti e tre i controlli di qualità dei dati. Ha faticato maggiormente con pattern nascosti nei dati.
Plotly ha eseguito ciascun modello una volta e ha osservato variazioni fino a tre domande ripetendo altri modelli. Considera 38 contro 37 come vicini; la differenza più chiara qui è uso degli strumenti e costo totale.
Muse Ember vs Muse Wonder vs Muse Spark
Scegli un modello Muse in base alla responsabilità che assumerà: pianificazione, loop principale dell’agente o esecuzione ripetuta.
| Dimensione | Muse Wonder | Muse Spark 1.3 | Muse Ember |
|---|---|---|---|
| Ruolo primario | Ragionamento di frontiera e ingegneria complessa | Modello principale per coding e agenti | Esecuzione ad alto volume |
| Forza principale | Pianificazione, task di lunga durata, coding complesso | Workflow di coding e agentici | Sottotask ripetitivi e chiamate di strumenti |
| Carico di lavoro tipico | Ingegneria a scala di repository | Esecuzione principale dell’agente | Classificazione, instradamento, estrazione |
| API model ID | muse-wonder-1.0 | muse-spark-1.3 | muse-ember-1.0 |
| Finestra di contesto | 1M token | 1M token | 1M token |
| Ragionamento predefinito | Max | High | Max |
| Standard input price / 1M | $4.00 | $1.25 | $0.10 |
| Standard output price / 1M | $20.00 | $4.25 | $0.50 |
La tabella usa i prezzi dei token in modalità Standard di Meta. I prezzi di Ember qui si applicano a richieste fino a 200K token di input; Wonder e Spark non hanno il premium di contesto lungo di Ember.
Selezione del modello Muse
Scegli Wonder per pianificazione difficile, ingegneria a livello di repository e recupero su lunghe sequenze di passaggi. Scegli Spark per eseguire il loop principale di coding o dell’agente. Scegli Ember per sottotask ripetuti con output verificabili in modo indipendente, come instradamento, estrazione e modifiche mirate ai file.
Per esempio, una migrazione di repository può assegnare l’analisi delle dipendenze a un modello più grande e una modifica di file con ambito ridotto a Ember. Il passaggio di consegne dovrebbe nominare i file, il comportamento atteso e i controlli di accettazione. Quella divisione è utile solo quando il coordinamento e la revisione dei task più piccoli costano meno che completare l’intero lavoro con il modello principale.
Per scegliere tra loro, esegui gli stessi task rappresentativi sui candidati con gli stessi controlli di accettazione. Escludi innanzitutto configurazioni che non raggiungono il tasso di successo richiesto o la latenza obiettivo. Tra quelle che passano, confronta la spesa totale divisa per risultati accettati, includendo retry e chiamate di strumenti. Assegna a Ember i tipi di task in cui abbassa quel costo e instrada i casi irrisolti verso Spark o Wonder.
Quanto costa Muse Ember?
La tabella abbina le tariffe ufficiali di Meta a una stima con sconto del 20% per CometAPI, in USD per milione di token. Ogni cella mostra Meta / stima scontata. L’elenco di CometAPI non pubblica ancora una tariffa live; usa le cifre scontate per la pianificazione del budget.
| Costo per 1M token (Meta / stima -20%) | Fino a 200K token di input | Oltre 200K token di input |
|---|---|---|
| Input | $0.10 / $0.08 | $0.30 / $0.24 |
| Input in cache | $0.004 / $0.0032 | $0.012 / $0.0096 |
| Output | $0.50 / $0.40 | $1.50 / $1.20 |
Il totale dei token di input della richiesta, inclusi gli input in cache, determina la fascia. Una richiesta sopra i 200K token di input usa le tariffe più alte per l’intera richiesta, incluso l’output. Con previous_response_id di Meta, la cronologia di conversazione memorizzata contribuisce al totale di input.
Costi tipici delle richieste Muse Ember
Con input non in cache e 20K token di output fatturati, inclusi ragionamento, una richiesta con 200K input costa $0.0300 alle tariffe Meta, o $0.0240 nello scenario di sconto del 20%. Aumentare l’input a 220K sposta l’intera richiesta nella fascia superiore: gli stessi 20K di output portano il totale a $0.0960 alle tariffe Meta, o una stima di $0.0768 con lo sconto. Questi esempi escludono addebiti separati per strumenti. Mantenere il contesto rilevante entro la fascia più bassa può far risparmiare più del solo sconto del 20%.
| Scenario | Token di input | Token di output fatturati | Costo Meta | Costo CometAPI |
|---|---|---|---|---|
| Richiesta standard | 200K | 20K | $0.0300 | $0.0240 |
| Richiesta long-context | 220K | 20K | $0.0960 | $0.0768 |
I token di ragionamento contano come output fatturato. Per l’API nativa di Meta, il web search grounding costa $2.50 per 1,000 query, e Ember non ha una variante Contributor-mode. Il confronto dei prezzi dei token sopra non applica lo sconto del 20% agli addebiti separati per gli strumenti.
Come accedere a Muse Ember
CometAPI listing: la pagina del modello identifica il modello come muse-ember, ma il suo stato in catalogo è Coming soon al 16 novembre 2026. Segui quella pagina per attivazione e prezzi; per l’accesso ora, usa Meta Model API o Muse Code.
Through Meta Model API: usa muse-ember-1.0 con https://api.meta.ai/v1. L’API nativa supporta i formati Responses, Chat Completions e Messages. Gli input di file usano Responses. Tieni insieme endpoint e identificatore del modello del provider quando configuri il client.
Native API limits and other access: Meta elenca 3,000 richieste al minuto e 4,000,000 token al minuto per team, condivisi dalle chiavi API del team. Muse Ember è disponibile anche in Muse Code. Controlla i limiti della rotta scelta quando dimensioni un batch e usa la guida all’integrazione di Meta per la configurazione dell’API nativa.
Quali sono le limitazioni di Muse Ember?
Tre fattori determinano se Ember è adatto al tuo prossimo workflow:
- L’ingegneria complessa resta dipendente dal carico di lavoro. Ember è dietro Haiku 5.5 su FrontierCode 2.0-AA nonostante il risultato più forte su Terminal-Bench. Una vittoria ristretta nel coding non stabilisce l’idoneità per ogni modifica a scala di repository.
- Contesto lungo e prezzi token bassi non garantiscono un costo basso per task. Le richieste grandi passano a una fascia di prezzo superiore e l’uso ripetuto degli strumenti può consumare abbastanza token da compensare il basso prezzo per token.
- Il supporto degli strumenti richiede comunque un’applicazione. Il sistema circostante esegue le chiamate, controlla i permessi e valida i risultati. La capacità di un modello di richiedere un’azione non fornisce da sola un workflow affidabile.
Conclusione
Adotta Ember dove i criteri di accettazione sono abbastanza chiari da essere misurati. Un primo deployment utile è uno step ad alto volume che ha già un risultato noto, come instradare ticket etichettati o estrarre campi da documenti revisionati. Confronta il costo per task riuscito, i tassi di errore e la latenza rispetto al tuo modello attuale prima di espandere il suo ruolo. Quell’evidenza ti dirà se Ember riduce il costo del tuo workflow preservando la qualità necessaria.
FAQ
Come validare i risultati di estrazione di Muse Ember?
Costruisci un set di riferimento di documenti con risposte verificate dall’uomo, inclusi campi mancanti, scansioni illeggibili e valori conflittuali. Misura l’accuratezza per campo anziché trattare ogni risposta JSON valida come un successo. Verifica se ogni valore estratto è supportato dal passaggio di origine citato e invia le discrepanze in revisione. Questo separa l’affidabilità di formattazione da quella fattuale.
Quando un sottocompito di Muse Ember dovrebbe tornare all’agente principale?
Definisci condizioni di escalation prima dell’esecuzione: un file richiesto è fuori dall’ambito assegnato, le fonti non sono concordi, un controllo di accettazione fallisce ripetutamente o il task richiede una decisione che il worker non era autorizzato a prendere. Restituisci le evidenze, i passaggi tentati e la questione irrisolta all’agente principale. Un handoff chiaro è più utile che consentire al worker di ampliare indefinitamente il suo incarico.
Cosa registrare nei log quando testi Muse Ember in produzione?
Registra l’esatto provider e identificatore del modello, impostazione di ragionamento, token di input e di output fatturati, token in cache, conteggio delle chiamate di strumenti, retry, latenza e risultato finale di accettazione. Mantieni l’esito di validazione insieme al record di utilizzo per poter calcolare il costo per task accettato. Confronta separatamente tipologie di task simili; una media tra instradamento, coding e lavoro su documenti lunghi può nascondere dove il modello sta aiutando o aggiungendo costo.
Come evitare azioni duplicate in un workflow con Muse Ember?
Rendi l’applicazione responsabile dell’identità delle azioni e dello stato di completamento. Per un’operazione come la creazione di un ticket, assegna una chiave di operazione stabile, verifica se è già stata completata e usa il supporto di idempotenza dell’API di destinazione quando disponibile. Dopo un timeout, ispeziona lo stato dell’azione prima di ritentare. Questo design evita di trattare una risposta incerta come prova che l’azione originale non sia mai avvenuta.