
TL;DR
L’OpenAI Decisions API è un endpoint specializzato che trasforma testo e immagini in decisioni azionabili e leggibili dalla macchina, invece che in prosa generata. Usa GPT-6 Luna e supporta domande di tipo predicato, scelta e punteggio. OpenAI riporta prestazioni circa 10× più veloci rispetto alla Responses API per i task di decisione supportati e un prezzo standard di input di $0.10 per milione di token.
Key Takeaways
- Decisioni costruite ad hoc: domande predefinite invece di conversazione libera.
- Tre tipi di decisione: predicato, scelta e punteggio.
- Automazione consapevole della probabilità: instradare input ambigui o consequenziali alla revisione umana.
- Incrementi di velocità riportati dal fornitore e prezzo standard solo input di $0.10 per milione di token rendono l’endpoint rilevante per decisioni ad alto volume.
- Ideale per instradamento, classificazione, controlli visivi e gate decisionali per agenti AI.
What Is the OpenAI Decisions API?
L’OpenAI Decisions API valuta le informazioni e restituisce decisioni limitate e leggibili dalla macchina. OpenAI l’ha rilasciata in beta il 6 ottobre 2026. Questa guida è per sviluppatori che già comprendono chiavi API e JSON e vogliono valutare flussi di lavoro di classificazione o instradamento. I dettagli del prodotto sono stati verificati il 12 ottobre 2026.
Lo schema di richiesta POST /v1/decisions accetta un modello, input condivisi di testo o immagine e domande definite dallo sviluppatore. L’endpoint dedicato restituisce giudizi tipizzati invece di prosa esplicativa.
OpenAI Decisions API specifications
| Specification | Documented endpoint details |
|---|---|
| Product type | Endpoint API specializzato, non un modello di base standalone |
| Endpoint | POST /v1/decisions |
| Underlying model | gpt-6-luna |
| Inputs | Testo e immagini |
| Decision types | predicato, scelta, punteggio |
| Outputs | Decisioni tipizzate e informazioni di probabilità |
| Performance | Circa 10× più veloce della Responses API (dichiarazione del fornitore) |
| Standard input price | $0.10 / 1M token |
| Output charge | Nessun costo per i token di output nella Decisions API |
| Tool calling / streaming | Non supportati direttamente da questo endpoint |
Current availability and access
Al 15 ottobre 2026, la guida ufficiale indica accesso in beta pubblica, con gpt-6-luna come unico modello supportato. Invia richieste a POST /v1/decisions; lo stato beta non garantisce stabilità in produzione.
Usa un progetto API OpenAI e verifica accesso al modello, stato di fatturazione e limiti di rate prima della distribuzione. La guida indica Python SDK 3.26.0 o superiore; l’accesso specifico per account va confermato con una piccola richiesta di test.
I clienti idonei possono usare Zero Data Retention e accordi HIPAA. La guida indica elaborazione regionale negli Stati Uniti e in Europa; l’idoneità e i requisiti contrattuali continuano ad applicarsi. L’accesso tramite un’interfaccia Luna di terze parti non implica compatibilità con questo endpoint dedicato.
How Does the OpenAI Decisions API Work?
Una richiesta combina evidenza di input condivisa con domande definite dallo sviluppatore. L’API valuta l’input usando GPT-6 Luna e restituisce risposte che il codice applicativo può usare per automatizzare, revisionare o eseguire escalation. Più domande possono condividere lo stesso input, sebbene le domande dipendenti debbano essere sequenziate dall’applicazione.
Predicate evaluation
Un predicato valuta se una condizione specificata è soddisfatta. Un rivenditore potrebbe chiedere se una fotografia mostra danni visibili al prodotto; la risposta fornisce una probabilità tra 0 e 1.
Estratto illustrativo di risposta a un predicato.
{
  "type": "predicate",
  "name": "visible_damage",
  "probability": 0.92
}
Choice selection
Una domanda di scelta seleziona tra categorie fornite esplicitamente, come Billing, Technical Support o Account Access. Campi di distribuzione e confidenza supportano politiche di instradamento e escalation a valle.
Score evaluation
Una domanda di punteggio valuta l’input rispetto a una rubrica ordinata. Il punteggio atteso può riflettere gli indici pesati per probabilità dei livelli definiti; questo non rappresenta automaticamente un rischio reale calibrato.
| Index | Severity | Interpretation |
|---|---|---|
| 0 | Low | No immediate action |
| 1 | Moderate | Routine follow-up |
| 2 | High | Significant customer impact |
| 3 | Critical | Immediate escalation |
What Are the Main Features of the OpenAI Decisions API?
Fast, bounded execution
Gli output tipizzati eliminano gran parte della necessità di generare prosa, analizzare testo o ritentare risposte malformate. OpenAI descrive un miglioramento di velocità di circa dieci volte per i task di decisione supportati; i guadagni effettivi dipenderanno dalla lunghezza dell’input, dal sovraccarico di rete e dalla concorrenza.
Multiple questions over shared context
Un ticket di supporto può essere valutato per dipartimento, urgenza ed eleggibilità alla revisione in un’unica richiesta. Le applicazioni devono comunque applicare regole di business deterministiche e controlli di autorizzazione.
Text and image understanding
Testo e immagini supportano l’instradamento dei ticket, il triage di screenshot e l’ispezione visiva. Consulta la documentazione ufficiale per i formati di immagine supportati, i limiti di dimensione e le strutture di payload attualmente accettate.
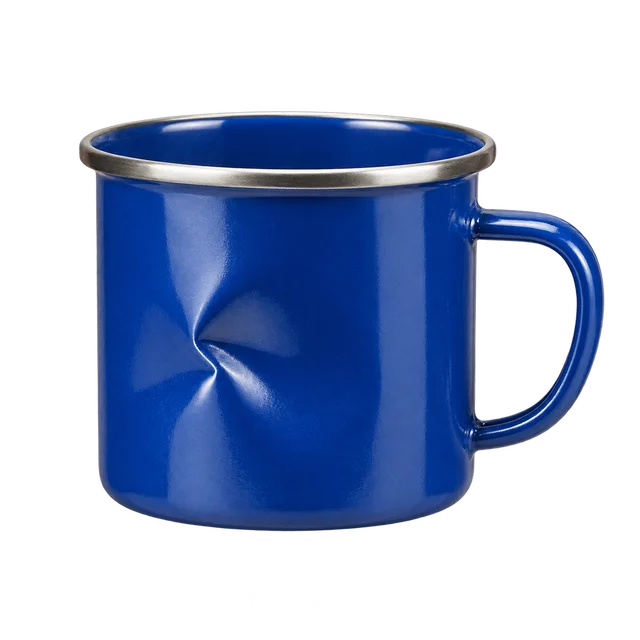
OpenAI usa questa tazza ammaccata nel suo esempio di decisione visiva. L’immagine illustra un danno osservabile; non è prova di un tasso di accuratezza misurato. Questo endpoint accetta URL di immagini inline in base64, non URL ospitati né ID di file.
Probability-aware automation
La confidenza riportata non è una garanzia di accuratezza. I team dovrebbero tarare le soglie contro dati di holdout etichettati, usando soglie separate per casi con alte conseguenze di falsi positivi o falsi negativi.
Security and data controls
Conservazione dei dati, elaborazione regionale e uso regolamentato dipendono dalla configurazione dell’account e dai requisiti contrattuali applicabili. Conferma l’idoneità prima di elaborare informazioni regolamentate o sensibili.
How Much Does the OpenAI Decisions API Cost?
La tariffa standard riportata è $0.10 per milione di token di input senza fatturazione dei token di output tramite l’endpoint dedicato Decisions. L’elaborazione regionale o i moltiplicatori di contesto lungo possono alterare la fattura finale.
| Component | Dedicated endpoint pricing |
|---|---|
| Standard input | $0.10 per 1M token |
| Output tokens | $0 |
| Cache reads / writes | $0 |
| Regional processing | Potrebbe applicarsi un premium |
| Long context | Potrebbe applicarsi un moltiplicatore |
| Billing unit | Token di input |
How much can Decisions API save versus Responses API?
Confronta task equivalenti sullo stesso modello. La guida Decisions indica $0.10 per milione di token di input e nessun costo di output o cache. La pagina del modello Luna indica il prezzo Standard per testo di $0.10/M per input non in cache e $0.50/M per output nell’uso generale del modello.
Calcolo illustrativo, non un benchmark: 1.000.000 richieste di testo, 500 token di input non in cache fatturabili per richiesta su ciascun endpoint, una classificazione per richiesta, e nessun premium regionale o di contesto lungo. Per Responses, usa il totale dei token di output fatturati, inclusi eventuali token di ragionamento fatturati, invece della sola lunghezza visibile della risposta.
A queste assunzioni: Decisions cost = N × I × $0.10 / 1,000,000. Responses cost = N × (I × $0.10 + O × $0.50) / 1,000,000. Savings percentage = (Responses cost − Decisions cost) / Responses cost × 100%, dove N è richieste, I token di input/richiesta, e O token di output fatturati/richiesta.
| Billed Responses output / request | Decisions cost / 1M requests | Responses cost / 1M requests | Estimated savings |
|---|---|---|---|
| 5 tokens | $50.00 | $52.50 | $2.50 (4.8%) |
| 20 tokens | $50.00 | $60.00 | $10.00 (16.7%) |
| 100 tokens | $50.00 | $100.00 | $50.00 (50.0%) |
I risparmi sopra derivano dal costo ipotizzato dell’output di Responses; non sono uno sconto fisso dell’endpoint. Ricalcola con uso di input misurato, hit di cache, scritture di cache, livello di elaborazione e retry. Input in cache o tariffe Batch/Flex possono cambiare il risultato. Aggiungi separatamente costi di strumenti, revisione umana e infrastruttura. Confronta il costo per decisione corretta accettata dopo aver verificato qualità e latenza; un’etichetta breve e una spiegazione più lunga sono carichi di lavoro diversi.
OpenAI Decisions API vs Responses API vs Jev and Aplomb 1
La tabella si concentra su servizi di decisione dedicati. Per spiegazioni generate, schemi di estrazione personalizzati o workflow di strumenti, usa la Responses API come descritto nella guida decisionale di OpenAI. Una decisione può selezionare un ramo di workflow, mentre Responses genera contenuti o richiede una chiamata a uno strumento, con il codice dell’applicazione che gestisce l’esecuzione dello strumento personalizzato.
Capabilities and pricing overview
| Dimension | OpenAI Decisions API | Jev 1.13 | Aplomb 1 |
|---|---|---|---|
| Inputs | Testo e immagini | Testo; immagini sperimentali con opt-in | Testo, JSON, immagini, video e audio |
| Standard input price / 1M tokens | $0.10 | $0.042 | $0.02 |
| Access | API OpenAI ospitata | Hosted TypeSafe API | API ospitata; pesi scaricabili sotto la EmpirioLabs Model License |
| Evaluation fit | Instradamento, filtraggio e punteggio nei workflow OpenAI | Classificazione e instradamento di intenti | Decisioni multimodali; distribuzione che richiede pesi |
Ambito di selezione: Jev e Aplomb sono inclusi per le loro capacità di decisione pubblicate, non come classifica di popolarità. Specifiche e prezzi standard di input sono stati verificati il 16 ottobre 2026. TypeSafe mappa ancora jev-latest a 1.13 e jev-preview a 1.14, quindi questo confronto fissa 1.13. Il supporto immagini di Jev è sperimentale. I pesi di Aplomb sono soggetti a licenza; verifica i termini per la distribuzione commerciale. I prezzi dei token pubblicati non sono una classifica di qualità né una stima del costo totale del workflow.
Workflow selection
Riduci la lista in base agli input richiesti e alle opzioni di distribuzione, poi testali sugli stessi casi etichettati. Allinea preparazione dell’input, rubriche decisionali, misure di latenza end-to-end e politiche di revisione umana. Confronta accuratezza di instradamento, casi mancati, carico di revisione e costo per decisione corretta accettata. Riporta questi dati insieme affinché un prezzo per token più basso o una risposta più veloce non nascondano errori aggiuntivi o costi di revisione.
How Can You Use the OpenAI Decisions API?
Step 1: Configure credentials
Crea una chiave API e forniscila come variabile d’ambiente OPENAI_API_KEY. Non inserire mai chiavi segrete nei repository o nelle applicazioni front-end.
Step 2: Send a request with cURL
La seguente richiesta segue lo schema di esempio per la scelta ufficiale. Imposta OPENAI_API_KEY prima di eseguirla; una risposta riuscita contiene un array answers. I comandi shell usano sintassi Bash.
Instradare una richiesta di supporto con cURL.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [
      {
        "type": "choice",
        "name": "department",
        "instructions": "Which department should handle this complaint?",
        "choices": [
          {"value": "billing", "description": "Payments and refunds"},
          {"value": "technical", "description": "Product issues"},
          {"value": "other", "description": "Everything else"}
        ]
      }
    ]
  }'
Step 3: Integrate with Python
Installa l’SDK Python richiesto.
pip install --upgrade "openai>=3.26.0"
Richiedi e ispeziona una decisione di tipo scelta.
from openai import OpenAI

client = OpenAI()
result = client.decisions.create(
    model="gpt-6-luna",
    input="I was charged twice for my order.",
    questions=[{
        "type": "choice",
        "name": "department",
        "instructions": "Which team should handle this request?",
        "choices": [
            {"value": "billing", "description": "Payments and refunds"},
            {"value": "technical", "description": "Product issues"},
            {"value": "other", "description": "Other requests"}
        ]
    }]
)
answer = result.answers[0]
if answer.type == "refusal":
    print("Decision refused")
elif answer.type == "choice":
    print(answer.choice, answer.confidence)
Step 4: Define an escalation rule
Applica una soglia di instradamento illustrativa.
if answer.type == "choice":
    if answer.choice != "other" and answer.confidence >= 0.90:
        print("Eligible for automatic routing")
    else:
        print("Send to human review")
La soglia 0.90 è illustrativa, non una garanzia del provider né un default ufficialmente raccomandato. Validala su esempi reali e rischio di business.
How Can You Access GPT-6 Luna Through CometAPI?
Gli sviluppatori possono usare la GPT-6 Luna API in CometAPI per task generici del modello. Questo non va confuso con il supporto per l’endpoint dedicato OpenAI Decisions, che richiede una verifica di compatibilità separata.
Classificare testo tramite CometAPI Responses.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)
response = client.responses.create(
    model="gpt-6-luna",
    input=(
        "Classify as billing, technical, or other. "
        "Return only the category. "
        "Request: I was charged twice for my order."
    )
)
print(response.output_text)
Questo esempio è una classificazione generica tramite l’interfaccia modello compatibile con CometAPI; non restituisce la struttura di probabilità nativa della Decisions API né eredita il prezzo solo input.
What Are the Best Use Cases for the OpenAI Decisions API?
Questi sono flussi di lavoro applicativi illustrativi, non deployment riportati o risultati di benchmark. Usano i tipi di domanda predicato, scelta e punteggio nella guida ufficiale Decisions. Il codice dell’applicazione esegue le azioni a valle.
Customer support classification
Fornisci il testo del ticket, la cronologia di conversazione rilevante e un elenco predefinito di team di supporto. Una domanda di scelta può selezionare Billing, Technical Support o Account Access; una domanda separata di punteggio può valutare l’urgenza rispetto a una rubrica scritta. Il codice dell’applicazione può assegnare la coda suggerita e inviare casi incerti o incompleti a un revisore.
Valuta il workflow su ticket etichettati dal personale di supporto, misurando l’accuratezza di instradamento per categoria, i casi urgenti mancati, i tassi di riassegnazione e il carico di revisione. Confronta questi risultati con il processo di instradamento esistente prima di ampliare la distribuzione.
Content moderation and review queues
Fornisci testo o immagini inviati insieme a categorie di revisione chiaramente definite. Le domande di predicato possono valutare se compaiono condizioni particolari nel contenuto, mentre una domanda di punteggio può prioritizzare la revisione secondo una rubrica di severità documentata. L’applicazione può quindi collocare gli elementi segnalati nella coda appropriata e presentare ai revisori il contenuto pertinente; l’endpoint in sé non rimuove contenuti né applica regole di piattaforma.
Valuta violazioni mancate, segnalazioni non necessarie, accordo tra revisori e ritardi di coda su esempi rappresentativi etichettati. Regola le soglie separatamente per categorie con conseguenze diverse.
E-commerce image inspection
Fornisci fotografie di prodotto e i criteri di ispezione rilevanti per l’articolo, come crepe visibili, strappi o imballaggio danneggiato. Le domande di predicato possono valutare se ciascuna condizione appare, e una domanda di punteggio può applicare una rubrica di severità definita quando le immagini contengono evidenza sufficiente. Il codice dell’applicazione può richiedere un’altra fotografia o creare un task di ispezione umana quando l’evidenza è poco chiara.
Valuta l’accuratezza di rilevamento rispetto ad articoli ispezionati, incluse danni mancati e falsi allarmi tra categorie di prodotto e condizioni di immagine. Mantieni le decisioni di rimborso o sostituzione nel workflow di approvazione esistente del rivenditore.
AI-agent action gating
Fornisci l’azione proposta, i suoi argomenti, la richiesta dell’utente pertinente e le regole di esecuzione scritte dell’applicazione. Le domande di predicato possono valutare se la proposta corrisponde al task richiesto o richiede revisione. Il codice dell’applicazione può usare il risultato per selezionare un ramo predefinito: continuare, richiedere chiarimenti o eseguire escalation. Controlli di autorizzazione indipendenti devono comunque determinare se l’esecuzione è autorizzata; il giudizio del modello è solo uno degli input.
Valuta il gate con proposte di azione etichettate, misurando azioni non autorizzate mancate, escalation non necessarie e sensibilità a contesto incompleto o conflittuale prima di collegarlo all’esecuzione.
Document and email triage
Fornisci il testo del documento o dell’email, metadati rilevanti e un set fisso di categorie come fattura, richiesta di supporto, richiesta di meeting o altro. Una domanda di scelta può selezionare la categoria, mentre domande di predicato possono identificare condizioni come informazioni obbligatorie mancanti. Il codice dell’applicazione può inviare l’elemento al workflow appropriato di estrazione, recupero o revisione senza chiedere all’endpoint di decisione di eseguire tali passaggi successivi.
Valuta accuratezza di categoria, instradamento downstream errato, volume di revisione e tempi di elaborazione usando record rappresentativi etichettati, inclusi elementi ambigui e formati non familiari.
What Are the OpenAI Decisions API’s Limitations?
L’API non genera contenuti esplicativi arbitrari, non esegue strumenti direttamente né elimina la necessità di testare le predizioni. Categorie mancanti e rubriche decisionali scritte male possono produrre risultati inappropriati. I valori di confidenza possono essere mal calibrati; l’automazione ad alto impatto necessita comunque di salvaguardie, revisione umana e logica di autorizzazione.
Conclusion
La Decisions API è promettente per giudizi limitati ad alto volume perché combina output di probabilità tipizzati con un modello semplificato di pricing dei token. I team dovrebbero confrontarla con Structured Outputs e modelli di decisione alternativi usando gli stessi casi etichettati, misure di latenza e costi dell’intero workflow. L’opportunità principale è identificare i passaggi in un’applicazione AI che richiedono una scelta invece di prosa generata.
FAQs
How should OpenAI Decisions API refusals be handled?
Tratta un rifiuto come un esito separato del workflow. Controlla answer.type prima di leggere i campi choice, score o probability. Registra il nome della domanda e instrada la richiesta a un percorso di revisione o recupero; non interpretare mai un rifiuto come un predicato negativo o uno zero di punteggio.
How can Decisions API thresholds be maintained over time?
Scegli soglie su esempi di holdout etichettati, poi monitora l’accuratezza tra le decisioni accettate e la quota inviata a revisione. Rivaluta dopo aver cambiato categorie, istruzioni, fonti di input o comportamento del modello. Mantieni una rubrica versionata in modo che i cambiamenti di instradamento possano essere ricondotti alla configurazione che li ha prodotti.
How should OpenAI Decisions API latency tests be reported?
Registra data, regione, identificatore del modello, numero di domande, lunghezza del testo, dimensione dell’immagine, concorrenza, versione del client, policy di retry e configurazione dell’endpoint di confronto. Riporta p50 e p95 end-to-end con conteggi di campioni e risultati di qualità, così che un guadagno di velocità non sia ottenuto semplicemente accettando più errori.
How should Decisions API categories evolve without breaking integrations?
Usa valori stabili leggibili dalla macchina e mantieni una mappatura esplicita verso le code a valle. Aggiungi una categoria di fallback e testa i casi limite storici prima di distribuire nuove descrizioni. Se una categoria viene rinominata, aggiorna la mappa di instradamento e la rubrica insieme invece di permettere che valori sconosciuti raggiungano azioni di produzione.
What should be logged for a Decisions API routing audit?
Registra la versione della rubrica, la categoria selezionata, probabilità o confidenza rilevanti, soglia, identificatore del modello, timestamp e azione intrapresa. Limita il contenuto di input archiviato a quanto richiesto dal workflow e applica la policy di conservazione dell’organizzazione. Un record di audit dovrebbe mostrare perché la logica dell’applicazione ha instradato o eseguito escalation del caso.