Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog Eleven v4 vs Eleven v4 Turbo:どちらを選ぶべきか?
ai-comparisons / CometAPIリサーチ
Eleven v4 vs Eleven v4 Turbo:どちらを選ぶべきか? 音声品質、レイテンシ、APIの料金、ストリーミング、CometAPIへのアクセスの観点からEleven v4とv4 Turboを比較してください。コンテンツ用またはエージェント用に適したモデルを選んでください。
Deon Goodwin AIモデルとAPIの調査チーム 音声品質、レイテンシ、APIの料金、ストリーミング、CometAPIへのアクセスの観点からEleven v4とv4 Turboを比較してください。コンテンツ用またはエージェント用に適したモデルを選んでください。
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)TL;DR
制作品質を優先するオーディオブック、ナレーション、キャラクター演技には Eleven v4 を選択。応答時間が重要なボイスエージェントやインタラクティブなアプリケーションには Eleven v4 Turbo を選択。ElevenLabs は、両者が同じ表現幅を共有するとしており、Turbo の公開 API 文字単価は 50% 低い。最終選択は、独自のスクリプト、試聴テスト、エンドツーエンドのレイテンシ測定に基づいて行う。
重要なポイント
制作音声向け: 標準バリアントから始め、表現、安定性、一貫性、編集工数を評価する。ライブ対話向け: Turbo から始め、ユーザー入力から可聴応答までの総時間を測定する。コスト: Turbo の公開文字単価は 50% 低価(リトライや他サービスの費用を考慮する前)。ベンチマーク: 公開された嗜好テストは標準モデルと競合の比較であり、Turbo に対する直接的な品質差を示すものではない。
明確性、出典の帰属、最新のAPI用語について確認済みです。
統合:
Eleven v4 と v4 Turbo の概要 主な用途 制作ナレーション、オーディオブック、キャラクター演技 リアルタイムエージェントとインタラクティブ音声 モデル ID eleven_v4 eleven_v4_turbo 対応言語 90+ 90+ ネイティブ価格 $0.08 / 1,000 文字 $0.04 / 1,000 文字 推論レイテンシ(中央値) 直接比較可能な数値は未提示 約100 ms 音声開始までの時間(中央値) 比較可能な数値は未提示 約150 ms(WebSocket によるリクエストから可聴音声開始までの中央値;測定済みネットワーク遅延は除外) Text to Dialogue WebSocket 接続あたりの登録ボイス数 最大10 1 固定
150 ms の数値は、同一スクリプトとデフォルト設定を用いた ElevenLabs による 2026 年 9 月の比較に基づく。これはボイスエージェント会話全体の遅延ではなく、可聴音声が開始されるまでの時間を測定したもの。ボイス登録の制限は Text to Dialogue WebSocket エンドポイントに適用される。
Eleven v4 と v4 Tu
Eleven v4 と v4 Turbo:概要と仕様
Eleven v4:制作音声とマルチスピーカー演技 標準モデルの公開されている位置づけ は、長編ナレーションや自然なマルチスピーカー対話を含む最高品質の音声制作。公開前に録音のレビューと編集が可能な場合、第一候補として合理的。重要なのは、まとまったパッセージや再生成したセリフを通して、表現が継続的に説得力を保つかどうか。
Eleven v4 Turbo:リアルタイムの表現的音声 Eleven v4 Turbo は、リアルタイムのエージェント、アシスタント、インタラクティブなキャラクター向けに設計。ElevenLabs によれば、Eleven v4 の完全な表現幅を保持しつつ、Professional Voice Clones に対応し、低レイテンシ生成を優先する。
音声がストリーミング再生されている最中に評価すること。説得力のある単独クリップが得られても、会話全体が迅速に応答することを保証するものではない。低い推論レイテンシは仕様値の出発点であり、アプリケーション全体の保証ではない。
短いインストラクションのボイスオーバーは両者で同程度に許容可能に聞こえる場合があるが、ドラマチックなシーンでは、より高価な生成を正当化する差が明らかになることがある。
アーキテクチャと評価範囲 公式のアーキテクチャ告知 では、Eleven v4 が全く新しいアーキテクチャ上に構築され、Turbo は同技術を低レイテンシ用途に持ち込むと説明されている。パラメータ数、レイヤ構造、学習計算量、速度差の具体的な要因を比較できるほどの詳細は非公開。Turbo が小型化や蒸留であると推測せず、未公開情報として扱う。
ネイティブの制限とボイス制御 長いスクリプトを分割する前に、使用予定のモデルとエンドポイントの入力制限を確認する。あるインターフェイスで公開された制限が他に自動適用されるとは限らず、制限の未記載が無制限を意味するわけでもない。
両バリアントは Stability と Similarity の制御を提供。Eleven v4 で Professional Voice Clone を選ぶと、追加の Clone Strength スライダー でクローンの学習音源にどれだけ厳密に追随するかを調整できる。値を下げると、わずかなボイスのスムージングを伴いつつ柔軟な表現が可能になり、値を上げるとアクセントなど元の演技や特徴的な声質をより保持する。ElevenLabs は多くのボイスで 0% からの開始を推奨。Style と Speed のスライダーはネイティブの v4 では利用できず、SSML には非対応。
移行への実務的な示唆は、既存のボイス指示の意味を保持しつつ、その表現方法を見直すこと。SSML に強く依存した旧スクリプトはそのままコピーせず、適応させて試聴する。
Eleven v4 と v4 Turbo:性能
公開ベンチマークと情報の範囲 重要なのはリスニング嗜好と応答レイテンシという 2 種の公式結果。これは異なる問いに答える。
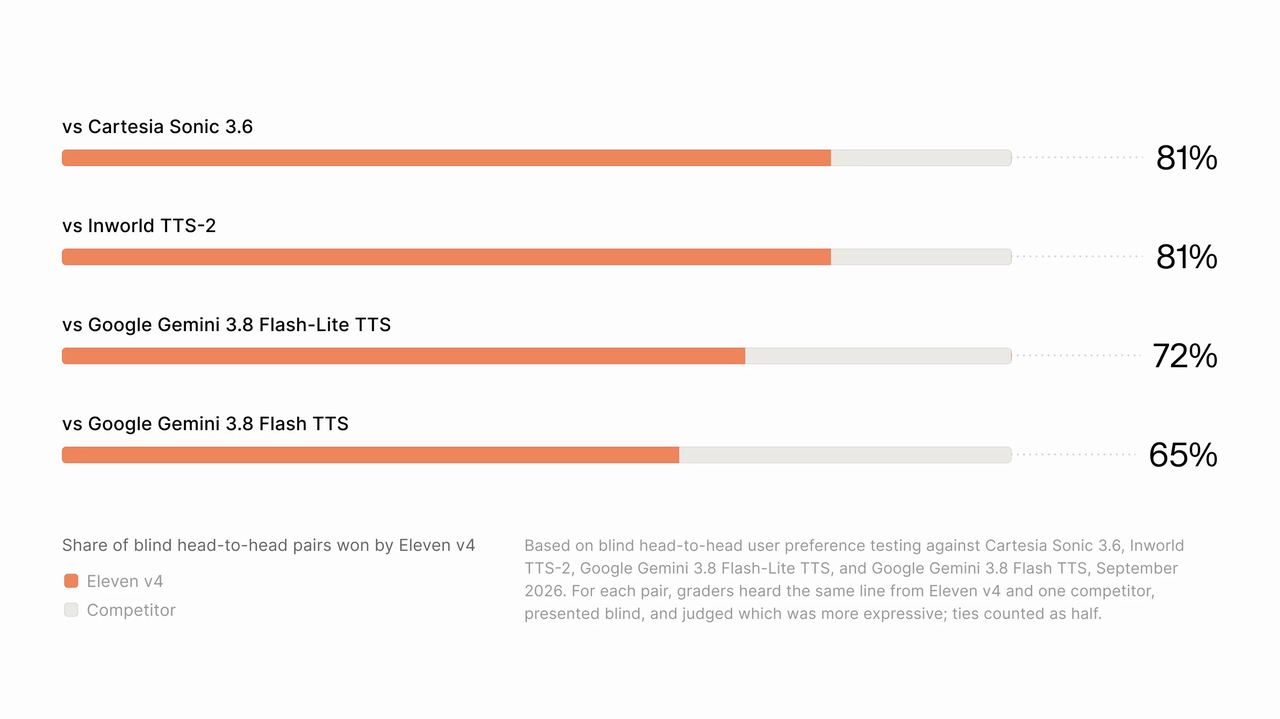
標準モデルのブラインド嗜好テスト 全体嗜好約75%;グラフでは 65%–81% の範囲 比較対象の競合音声モデルに対するリスナー嗜好 Turbo の推論レイテンシ中央値 約100 ms モデル推論時間に関する主張 Turbo の音声開始までの時間中央値 約150 ms 記載のテスト条件下における、リクエストから可聴音声開始までの時間
公開された試聴テストは Eleven v4 と競合する音声モデルの比較であり、Eleven v4 Turbo に対してどれほど(もし差があるなら)好まれるかは示さない。この選択については、同一スクリプトとボイスで両バリアントを使い、自分のブラインド試聴で比較する。
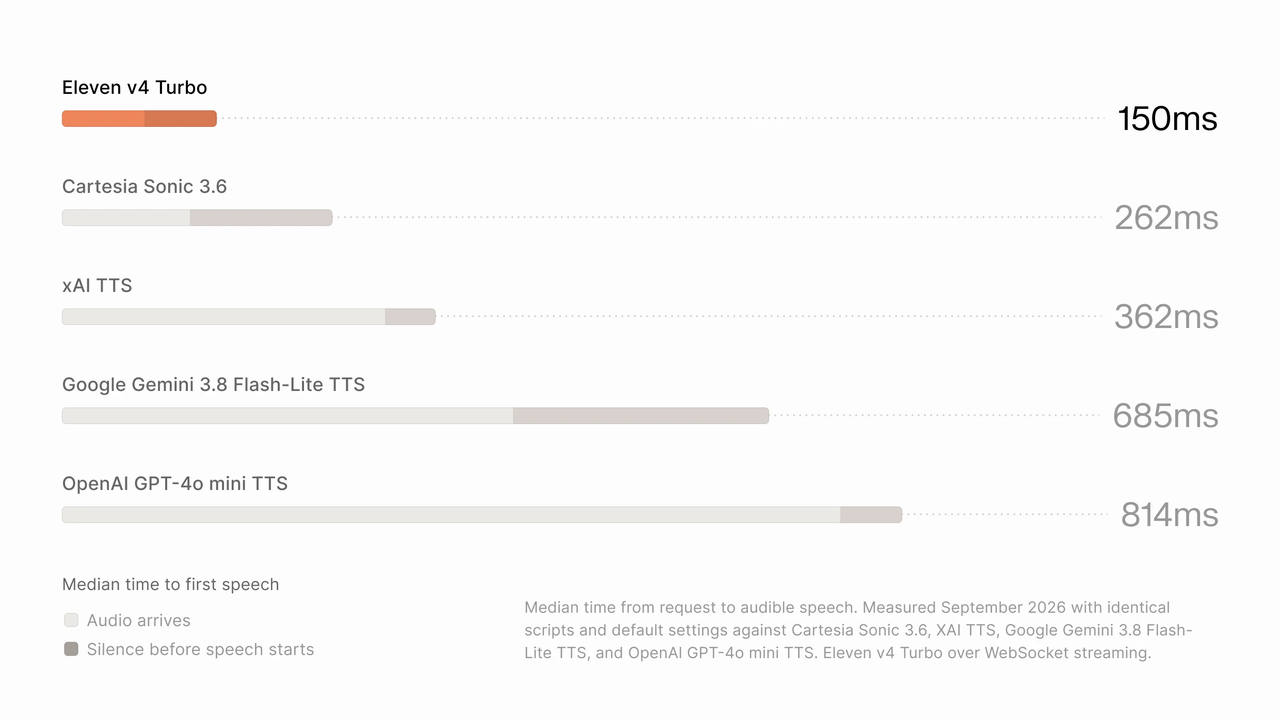
Official ElevenLabs latency chart. 報告されたタイミングは測定済みのネットワーク遅延を除外している。
評価条件 2026 年 9 月の公式試聴研究は、Eleven v4 と競合モデルで同一行のブラインドペア比較を用い、表現力と自然さを評価(同点は 0.5 として扱う)。比較対象のシステムとシステムごとの嗜好率は下記の公式チャートに記載。これらのベンダー報告の結果は Eleven v4 と競合システムの比較であり、Eleven v4 と Eleven v4 Turbo の間の試聴品質差を定量化するものではない。
2026 年 9 月のレイテンシ比較は、同一スクリプトとデフォルト設定を用い、各システムで測定済みのネットワーク遅延を除外し、Turbo は WebSocket ストリーミングで実行。報告された 150 ms はリクエストから可聴音声開始までを測るもので、約 100 ms の推論値とは異なる指標。記載の手法はハードウェア、リージョン、負荷、サンプル数の完全な内訳を提供しておらず、商用運用のレイテンシ保証を示すものではない。
音質と制作上の一貫性 ElevenLabs は Professional Voice Clone の対応、再生成行を跨ぐスピーカーの一貫性改善、長尺音声向けのリクエスト結合を強調。これらの主張は、まとまったパッセージと既存録音へ差し替えた一行で評価する。
録音音声では、表現の豊かさと制作上の一貫性を分けて評価する。強調、感情、発音、同一スピーカーがパッセージを通じて認識可能に保たれているかを聴く。標準モデルはベンダーの品質重視の選択肢だが、単純なインストラクションのスクリプトでは有用な差が現れない場合もある。より高価な生成のほうが常に編集が少なくて済むと仮定せず、受理テイクの比較で判断する。
ボイス指示と多言語化 両バリアントは表現的なデリバリーに対応するが、有用な表現はスクリプトと選ぶボイスに依存する。明確な少数の指示から始め、それが意図した意味に資するかを聴く。
安心感のあるサポート応答は、温かいトーンと短いポーズを組み合わせられる。
[warm, reassuring] I found your reservation.
[short pause] Let me confirm the arrival time with you.
これは説明目的のプロンプトであり、測定された性能結果ではない。タグなし版と並行してテストする。指示は出力を改善するときにのみ有用。
ローカリゼーションは別枠での試聴が望ましい。ネイティブ製品ガイド によれば、同言語生成では参照ボイスの元のアクセントを保持し、異言語生成ではソース言語のアクセントを持ち越さず、自然なターゲット言語の発音を採用する。
この挙動はローカライズされた製品チュートリアルに適するかもしれないが、意図的に認識可能な外国アクセントを持つ架空のキャラクターでは追加の指示が必要になる場合がある。発音、アイデンティティ、意図するアクセントを個別に評価すること。流暢に聞こえても、クリエイティブブリーフを満たさない可能性はある。
レイテンシと信頼性 商用のボイスエージェントでは、音声合成は遅延の一部に過ぎない。音声認識、ターン検出、言語モデルの出力、ネットワークの往復、音声バッファリングなどが、ユーザーが応答を聴くまでの時間に影響する。
自分のアプリケーションで、中央値と遅いテールの応答時間の両方を測定する。低い中央値でも、会話を苛立たせるときどきのポーズが共存する場合がある。
Eleven v4 と v4 Turbo:コスト
公式 API の文字単価 以下のネイティブ API 比較は、2026 年 10 月 19 日に確認した公開料金に基づく。ボリュームの合計はこれらの単価からの計算であり、別途のパッケージ見積ではない。
1,000 文字 $0.08 $0.04 $0.04 100,000 文字 $8.00 $4.00 $4.00 100 万文字 $80.00 $40.00 $40.00 1,000 万文字 $800.00 $400.00 $400.00
これらの数値は文字ベースの音声生成を示すもので、ボイスエージェント全体の料金ではない。サブスクリプションの枠、他サービス、適用される商用条件は別途考慮する。
CometAPI はトークン建ての料金表示であり、上記のネイティブ料金は文字単価。選んだエンドポイントが使用量をどのように計測・課金するかを確認した上でコスト比較を行う。Turbo が必要なら、選択した CometAPI 経路で当該モデルが利用可能かを統合前に確認する。
受理された録音/対話あたりのコスト 音声生成コスト = 課金対象文字数 ÷ 1,000 × 適用される文字単価
コンテンツ制作では、より実務的な指標は 受理された録音あたりのコスト 。再生成テイクと編集時間を含める。安価なバリアントが難しい演技で繰り返し外す場合、単価の優位は縮む可能性がある。
ライブエージェントでは、求める品質と応答時間で完了した対話のコストを比較する。合成の請求が低廉でも、遅いまたは混乱した会話でユーザーが離脱すれば価値は限定的。
Eleven v4 と v4 Turbo:比較と選定
機能とワークロードに基づく選定 以下の推奨は、公開されている位置づけと実務的な評価基準を組み合わせたもの。追加のベンチマーク結果ではなく、テストの出発点。
オーディオブック/ドキュメンタリー 標準バリアント パッセージと再生成行を跨ぐ一貫性 ドラマチックなキャラクターシーン 標準バリアント 感情表現とスピーカー間の掛け合い カスタマーサポートエージェント Turbo 可聴応答時間、発音、割り込み処理 インタラクティブなゲームキャラクター Turbo 短いターンでの応答性とパフォーマンス 簡易な解説クリップ 両方テスト 聴取者が意味のある品質差を認識するか 多言語制作 言語ごとに両方テスト 発音、アクセント、ボイスの同一性 録音とライブ音声を併用する製品 ワークロード別のルーティング分離 それぞれの経路が独自の受理基準を満たすか
オーディオブック、広告、ドラマシーンでは、Eleven v4 を中立的なパッセージ、感情的なパッセージ、既存録音に差し込む再生成行でテスト。結合部を跨いだボイスの同一性、テンポ、発音の一貫性を聴く。受理テイクや編集時間の削減が高い生成コストを正当化できる場合、標準バリアントを選ぶ。
サポートエージェントやインタラクティブキャラクターでは、ユーザー発話、ターン検出、応答生成、合成、再生までの会話全体で Turbo をテスト。遅い回線、接続失敗、割り込みも含める。ユーザーの割り込み時に再生が速やかに停止し、次の応答がきれいに始まることを確認する。試聴品質の基準を満たし、応答時間の目標も満たす場合に Turbo を選ぶ。
代表的なテストセットを作る:中立的な説明、安心感のある応答、感情的なパッセージ、固有名詞や略語、ユーザーが用いる多言語テキストを含める。
スクリプト、ボイス、出力設定は各インターフェイスが許す範囲で可及的に同等に保つ。
モデル名ラベルなしで録音をレビューする。発音誤り、ボイス同一性の不一致、各テイクに必要な修正を記録する。
ライブ応答時間は試聴品質と分けて測定する。中央値と遅いテール遅延の両方を含める。
選定前に受理基準を設定する:発音、ボイス一貫性、編集工数、応答時間の中央値、遅いテールの応答時間。
実際に導入予定のエンドポイントで代表的なトラフィックを流す。却下出力、リトライ、再生や接続失敗を追跡する。
再生成テイクと編集工数を含め、受理された録音/完了対話あたりのコストを比較する。
録音とライブ音声の両方がある製品では、経路を分けてテストし、それぞれの受理基準を満たすことを確認する。
Eleven v4 と v4 Turbo はどこで利用できるか
公式プロバイダでのアクセス ワークロードに合ったネイティブの経路を用いる:制作音声の生成と対話、そして Turbo のインタラクションには Text to Dialogue WebSocket ストリーミング。以下の公式例はストリーミング接続とボイス登録の制限を文書化。商用接続前に現在のエンドポイントスキーマ、認証要件、アカウント制限を確認する。
ElevenLabs の公式ストリーミング例 は Turbo の Text to Dialogue WebSocket エンドポイントを使用:
Eleven v4 Turbo の WebSocket エンドポイント:
wss://api.elevenlabs.io/v1/text-to-dialogue/stream-input?model_id=eleven_v4_turbo
同リファレンスでは、当該エンドポイントの Turbo 接続につき登録ボイスはちょうど 1、標準バリアントでは最大 10 と指定。これは接続レベルのルールであり、全インターフェイスに対する包括的な記述ではない。
Model ID eleven_v4 送信エンドポイント POST /runwayml/v1/text_to_speech 処理方式 非同期タスク送信 出力 MP3 音声 入力制限 1 リクエスト最大 2,500 文字 ボイス設定 プリセットボイス 追加で公開されている制御 話速の調整
これらはプロバイダ固有の統合詳細。ネイティブの 10,000 文字制限やネイティブ UI の制御を、このインターフェイスの文書化された挙動の代替とみなすべきではない。同様に、非同期ワークフローから Turbo のネイティブ WebSocket パフォーマンスが利用可能と結論しないこと。
実務的な統合手順は、短いスクリプトを送信し、文書化されたタスクステータスのワークフローに従い、結果を取得し、発音と出力の尺を確認してからボリュームを増やすこと。
結論 受理された録音が、より高い文字単価を正当化できる品質や制作の効率をもたらす場合は Eleven v4 を選ぶ。試聴の基準を満たし、ライブ会話に必要な応答性を達成する場合は Eleven v4 Turbo を選ぶ。最終決定は導入予定のエンドポイントで、代表的なスクリプト、リトライ、総運用コストを含めて行う。
FAQ
長い Eleven v4 のスクリプトは制作のためにどのように分割すべきか? 段落、文、シーンの境界で分割し、単語やスピーカーのターンの途中では分割しない。エンドポイントの許容入力内に指示テキストの余白を残し、各セグメントのスクリプトとボイス設定の記録を保持し、音声結合後に継ぎ目を試聴する。境界を跨いだラウドネス、テンポ、発音、ボイス同一性を比較する。各クリップを個別に受理しても、結合した録音がシームレスであることは保証されない。実際のプロバイダのエンドポイント制限を用いる(ネイティブと CometAPI のリクエスト制限は異なる)。
途中で中断された Eleven v4 のリクエストはどうリトライすべきか? 元のリクエスト/タスク ID を追跡し、同一テキストを再送する前に状態を確認する。非同期プロバイダのワークフローでは、元のタスクが完了しているか、結果が取得可能かを確認する。ライブストリームでは、すでに再生された音声を記録し、その発話を再生するか、きれいな境界で復帰するかを判断する。エンドポイントのリトライ、冪等性、課金ルールを確認し、同一リクエストの繰り返しが無料や同一音声を保証すると仮定しない。
チームは Eleven v4 のボイスリリースをどのように回帰テストできるか? ブランド名、略語、数字、難しい発音、感情的パッセージ、製品で使用される言語を含む固定の受理セットを維持する。スクリプト、モデル ID、ボイス ID、利用可能な設定、生成日、受理された参照録音を保存する。モデル、ボイス、統合が変わったら、新しいサンプルを参照と聴き比べ、必要な修正を文書化する。再現可能なテスト手順と、同一波形を仮定しないことを分けて考える。一つの録音が合格しても、後続のすべての生成が合格する保証にはならない。