Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog Gemini 4 Carbon vs Kimi K3.1 Pro:どちらを選ぶべきか? Gemini 4 Carbon vs Kimi K3.1 Pro:どちらを選ぶべきか? - CometAPI
ai-comparisons / CometAPIリサーチ
Gemini 4 Carbon vs Kimi K3.1 Pro:どちらを選ぶべきか? ワークフローに適したモデルを選ぶため、仕様、ベンチマーク、価格、デプロイオプション、API アクセスの観点から Gemini 4 Carbon と Kimi K3.1 Pro を比較してください。
ワークフローに適したモデルを選ぶため、仕様、ベンチマーク、価格、デプロイオプション、API アクセスの観点から Gemini 4 Carbon と Kimi K3.1 Pro を比較してください。
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)要約
Gemini 4 Carbon はサイバーセキュリティと長期的なエンジニアリングを対象としているが、アクセスは段階的に提供中。Kimi K3.1 Pro は Kimi のアプリケーションおよび API から利用でき、100 万トークンのコンテキストウィンドウ、マルチモーダル入力、公開ウェイトを備える。今日すぐに使える手段が必要なときは、デフォルトの出発点として Kimi を選ぶとよい。チームがアクセス権を持ち、ワークロードがセキュリティ検証や長時間のエンジニアリングに集中している場合は Carbon を評価する。本記事で引用した価格では、Carbon の導入期の入力・出力単価は Kimi の標準料金と一致するが、Carbon の後期料金が適用される場合は比較が変わる。
重要なポイント
Kimi はアプリケーションと API で利用可能。Carbon へのアクセスは段階的に提供中。
Kimi はコーディング、長文ドキュメント、マルチモーダル、セルフホスティング研究における実用的なデフォルト。Carbon は防御的セキュリティや長期的エンジニアリングで評価する価値がある。
Carbon は ExploitGym スコアが高い一方、Kimi はコーディング、ドキュメント、科学、3D タスクにわたる公開エビデンスが広い。これらは別個の評価である。
公式料金、キャッシュ課金、ツール費用、リトライ、人的レビュー時間を合わせて比較する。
明確性、出典の帰属、最新のAPI用語について確認済みです。
Gemini 4 Carbon と Kimi K3.1 Pro の比較:概要と仕様 Carbon は高難度のエンジニアリングと防御的セキュリティ作業を対象とする。Google は一般の開発者向けではなく、選定されたサイバー防御担当者と信頼できるパートナーに段階的ロールアウトを発表した。すぐにデプロイ可能な API ルートが必要なプロジェクトでは、この違いが重要になる。
Kimi は日常的な開発業務にマッピングしやすい。大規模リポジトリの理解、ドキュメント分析、ツールスクリプトの作成、マルチステップタスクの完遂などである。Moonshot は Kimi K3.1 Pro をアプリケーションおよび API で提供している。API へのアクセスには入金済みアカウントが必要で、アカウント単位のレート制限が適用される。
モデル仕様と API サポート Carbon はサイバーセキュリティや長時間のエンジニアリングタスクを対象とし、Kimi はコーディング、マルチモーダル、知識タスクに位置付けられている。
Architecture and parameters 今回の発表では非公開 MoE; 2.8T total parameters, 104B active Context window パブリック API の上限は未確認 1,048,576 tokens Inputs and outputs マルチモーダル対応に言及。最終的なパブリック API スキーマは未確認 テキスト・画像入力、テキスト出力。動画対応はサービスや API ルートに依存 Weight access 公開ウェイト提供についての記載なし モデル固有ライセンスの下でウェイトをダウンロード可能 Access 段階的ロールアウト アプリケーションおよび API(アカウント要件あり)
Kimi が公開しているパラメータ数はモデル規模を示すが、タスク品質や総提供コストを直接は予測しない。
Kimi のモデルカード はテキストと画像のモダリティを記載している。Kimi Code は動画入力にも対応。利用予定の API ルートでの動画サポートとフォーマットは要確認。Google の発表は Carbon のマルチモーダル対応を説明しているが、パブリック API スキーマは明記していない。
長いコンテキストはファイル間の依存関係を追跡するのに有用だが、取得品質はいぜん重要である。回答を原資料と照合できるように、入力にはファイル名、ドキュメントの日付、出典の場所を含めておくこと。
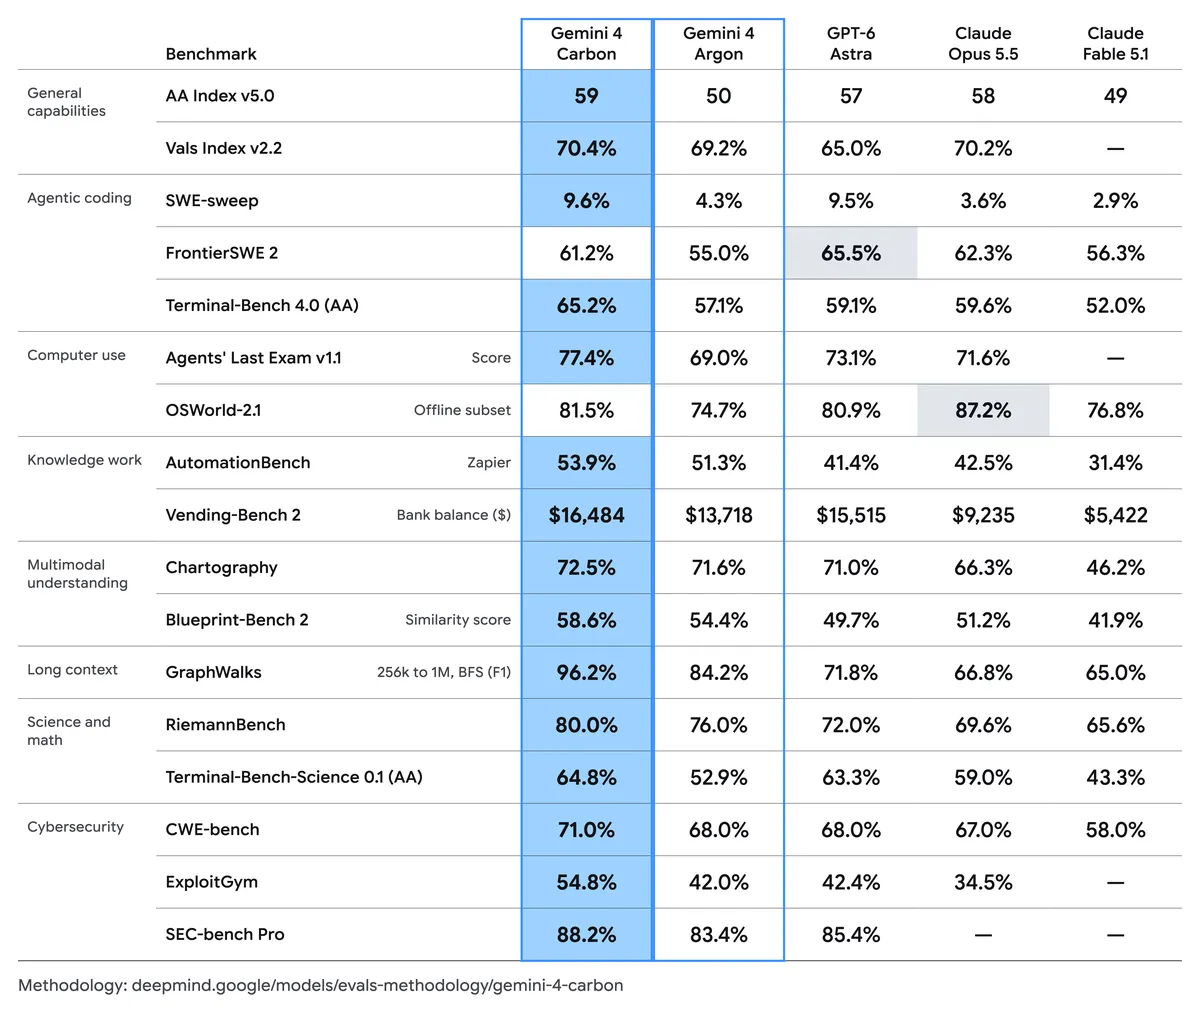
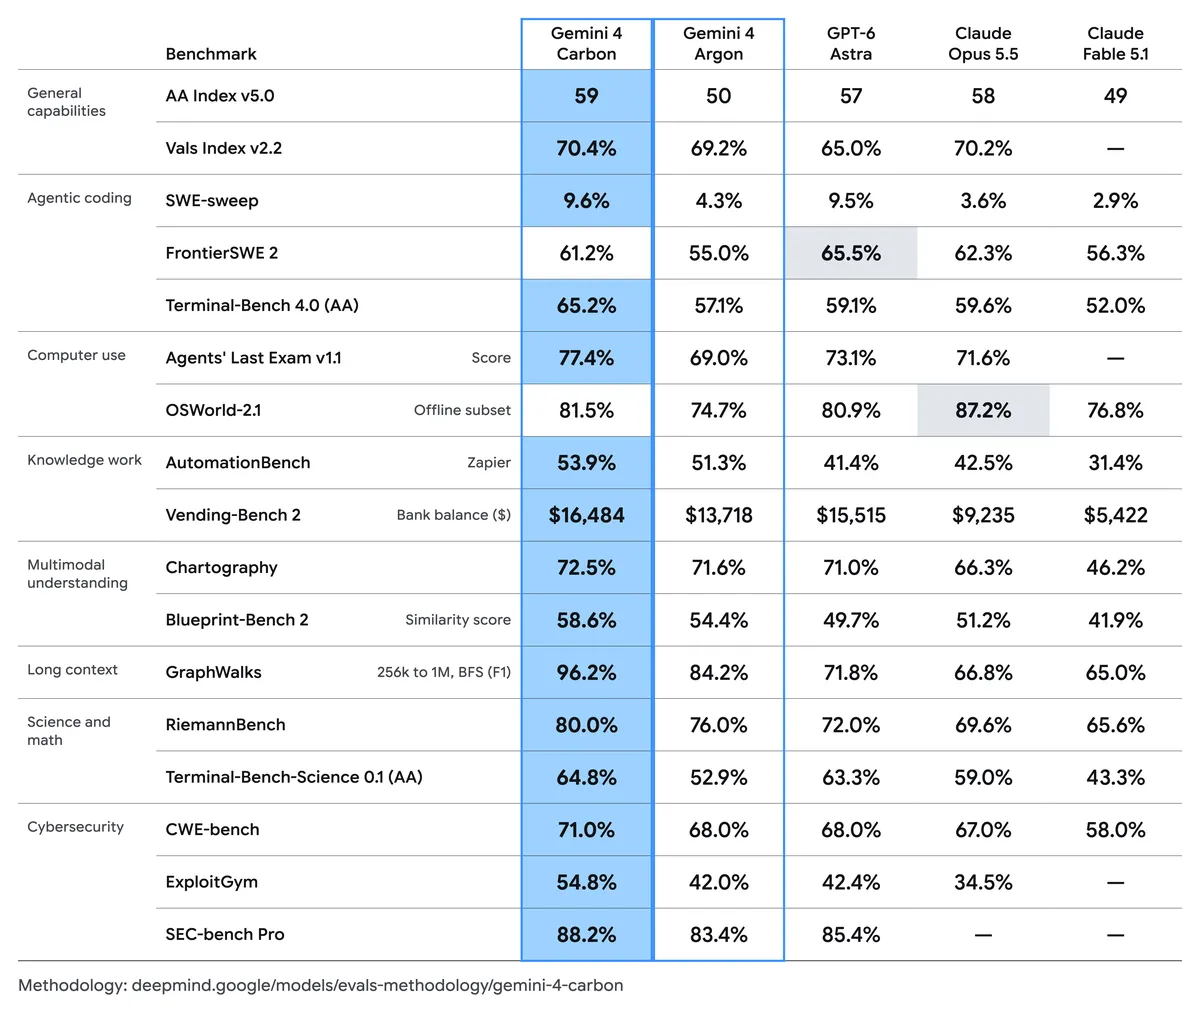
Gemini 4 Carbon と Kimi K3.1 Pro:性能 以下のスコアは Google の公式発表 および Moonshot の公式モデルカード による。Google の 手法文書 は、2 つのターミナル系ベンチマークの評価者を Artificial Analysis、CWE-bench の評価者を Collinear AI としている。表では各スコアに試験条件を併記し、ダッシュは情報源に対応する結果がないことを示す。
公開ベンチマーク結果と試験条件 これらのプロバイダー報告の結果は、異なるベンチマークと評価設定に基づく。厳密な同条件での一騎打ち比較ではない。
ExploitGym 54.80% 20.70% Carbon: Antigravity、mitigations off、no internet。Kimi: Kimi Code、タスクあたり 6 時間。Google の手法文書は 6 時間および 10 時間のバジェットに言及するが、どちらに対応かは未特定。 SEC-bench Pro 88.20% — Carbon: Antigravity。JavaScript エンジンの 183 タスク・サブセット。3 回の試行での pass@1。guardrails off。 CWE-bench v1 71.00% — Carbon: Collinear AI。programmatic pass@1。guardrails off。 Terminal-Bench 4.0 65.20% 65.70% Carbon: Artificial Analysis。Kimi: Claude Code。 Terminal-Bench-Science 0.1 64.80% 38.10% Carbon: Artificial Analysis。Kimi: Claude Code。 SWE-Marathon v1.1 — 51.70% Kimi: Claude Code。 GPQA-Diamond — 94.20% Kimi: max reasoning、temperature 1.0、top-p 0.95。 BenchCAD, with tools — 92.7 Kimi: 1,000 ケースの Vision2Code サブセット。Claude Code with tools。スコアは Voxel IoU。 OfficeQA Pro v2 — 64.4 Kimi: Claude Code。PDF コーパスを画像としてレンダリング。
特に断りがない限り、Moonshot は max reasoning、temperature 1.0、top-p 0.95 を使用している。
Google の公開ベンチマークチャート には、コーディング、科学、マルチモーダル、セキュリティの結果が含まれる。AA のラベルは Artificial Analysis による評価を示す。
サイバーセキュリティ Carbon の ExploitGym スコアの高さは、脆弱性の悪用やリスク検証における評価に値することを示唆する。セキュリティチームにとっての実務的な指標は、再現可能な所見、回帰テストを通過するパッチ、誤検知や修正失敗の解消に要した時間である。
コーディング、推論、ドキュメント分析 報告されている Terminal-Bench 4.0 のスコアは近い。コーディング用途では、各モデルが必要なリポジトリ変更を完了するか、結果のレビューや修正にどれだけ手間がかかるかを優先して評価する。
Carbon は Terminal-Bench-Science 0.1 でより高いスコアを報告している一方、Kimi の GPQA-Diamond の結果は科学的知識と推論に関する追加のエビデンスを提供する。ドキュメント中心のワークフローでは、Kimi の OfficeQA Pro v2 の結果が、文書横断的な分析や数値推論に特に関連する。
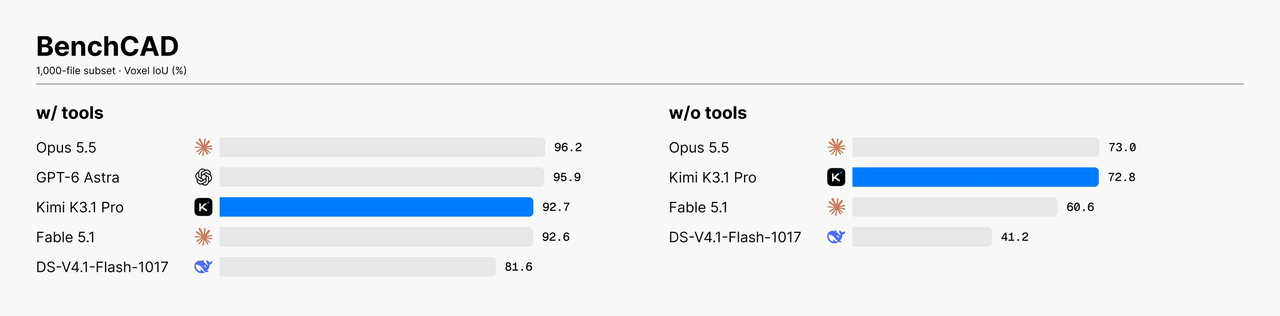
ツール支援 CAD と 3D 生成 Moonshot は、1,000 ケースの Vision2Code サブセットで、ツールなしで 72.8、ツールありで 92.7 の BenchCAD スコアを報告している。ツール有効の実行は Claude Code を使用し、もう一方は単発生成である。CAD アプリケーションでは、ツール支援を含むワークフロー全体を評価すること。スクリプトが実行でき、意図したジオメトリを再現し、編集可能な状態であるべきだ。
Moonshot の公式 BenchCAD 結果。Voxel IoU は再構成の重なりを測る指標であり、タスクの合格率ではない。
スピードと長文コンテキスト性能 対話型アプリケーションでは応答レイテンシが重要であり、エージェントでは生成速度だけでなくタスク完了までの総時間が有用だ。同様に、Kimi の文書化されたコンテキスト容量は大きな入力を収容する助けになるが、実務上の判断基準は、適切な根拠を取得し、タスク全体で依存関係を維持できるかどうかである。
Gemini 4 Carbon と Kimi K3.1 Pro:コスト 同一のトークン数と課金区分で価格を比較する。以下のレートは 100 万トークンあたりの米ドル(USD)。Kimi K3.1 Pro の公式料金は入力 $2、出力 $10。Gemini 4 Carbon の導入期レートはこれと同じである。
公式 API 料金 Uncached input 導入期 $2。導入期後は $4 $2 Output 導入期 $10。導入期後は $20 $10 Cached input 導入期 $0.10。導入期後は $0.20 キャッシュヒット・トークンあたり $0.20 Cache write Google の発表では未記載 100 万トークンあたり $2(別途課金)
Google は、Carbon のキャッシュ入力が入力レートから 95% 割引されると述べている。導入期の終了日は発表で明記されていない。Kimi はキャッシュヒット入力とは別にキャッシュ書き込みを課金する。
リポジトリ規模タスクのコスト例 タスクが 100,000 トークンの未キャッシュ入力と 20,000 トークンの出力を使用すると仮定する。
導入期レートの Carbon: $0.40
導入期後の Carbon: $0.80
公式レートの Kimi: $0.40
これらの合計は入力・出力トークンのみを含む。キャッシュ書き込み、ツール料金、リトライは含まない。これらの前提では、Carbon の導入期のトークンコストは Kimi と一致し、差は Carbon の導入期終了後に現れる。
CometAPI の Kimi K3.1 Pro API は、入力 100 万トークンあたり $1.60、出力 100 万トークンあたり $8 と掲載されている。上記の例では、これらのレートでトークンコストは $0.32 になる。掲載は CometAPI のルート向けであり、Moonshot の公式 API ではない。運用コストの見積もり前に、ルートの最新の価格とキャッシュ課金を確認すること。CometAPI では Gemini 4 Carbon は Coming soon とされており、比較可能な CometAPI の Carbon 価格はまだない。
成功タスクあたりの実効コスト トークン価格だけでは、タスクを完了するための実コストはわからない。まず成功の定義(例:パッチがテストに合格、ドキュメント回答が出典と正確性要件を満たす)を行う。
Cost per successful task = total model and tool charges across all attempts ÷ number of accepted tasks.
人的レビューや修正時間は別途記録する。総受理コストに大きく影響し得る。
どのモデルを選ぶべきか チームが出荷すべき仕事と利用可能なアクセスルートに基づいて選ぶ。API、長いコンテキスト、マルチモーダル入力、ダウンロード可能なウェイトが必要なチームには、Kimi K3.1 Pro が実用的な出発点となる。Gemini 4 Carbon は、チームがアクセス可能であれば、サイバーセキュリティや長時間のエンジニアリングタスク向けに評価する価値がある。Google は Carbon のアクセスを選定されたサイバー防御担当者と信頼できるパートナーに段階的に提供している。
今構築中のアプリで使うモデル API が必要 Kimi K3.1 Pro Moonshot の API で利用可能(アカウント要件とレート制限あり) 大規模リポジトリや長文ドキュメントを解析する Kimi K3.1 Pro API で 1,048,576 トークンのコンテキストウィンドウを明記 マルチモーダルやツール支援 CAD のワークフローを構築する Kimi K3.1 Pro 画像・動画・BenchCAD に関する公開された能力がある オープンウェイトの評価やセルフホスティングを行いたい Kimi K3.1 Pro モデル固有ライセンスの下でウェイトをダウンロード可能 主なワークロードが脆弱性の発見・検証・パッチ適用である Gemini 4 Carbon サイバーセキュリティ系ベンチマークで強い結果を報告している 長時間のエンジニアリングタスクを扱い、Carbon へのアクセスがある Gemini 4 Carbon Google が長期的エンジニアリング・ワークフロー向けに位置付けている 既存製品をアップグレードしている 利用可能なら両方をテスト 同一タスク、同一ツール、同一受け入れ基準で比較
この表で評価の優先順位を決め、次に自分たちの代表タスクで検証する。セルフホスティングではハードウェア、提供、保守、ライセンス要件を含めて判断する。ホスト型 API では、アカウント制限や総タスクコストをモデル性能と合わせて比較する。
Moonshot は Kimi の 1,048,576 トークンのコンテキストウィンドウ、API 提供、モデル固有ライセンスを文書化している。Google は Carbon をサイバーセキュリティと長期的エンジニアリングを対象とするとし、アクセスを段階的に提供している。
本番での評価方法 自分たちのワークロードを代表するタスクで両モデルを評価する。テスト前に成功の定義を行い、受理結果、完了時間、総コストを比較する。
代表タスクセットを作る。 日常業務と、エラーのコストが高いケース(コード変更、セキュリティ所見、ドキュメント分析、ツール支援ワークフロー)を含める。比較条件を一貫させる。 可能な範囲で同じタスク入力、ツール、権限、受け入れテストを用いる。各モデル ID、エンドポイント、推論設定、テスト日を記録する。採用結果を測る。 テスト合格、計算の検証、参照可能なソース、成果物の完備などを追跡する。エンドツーエンドの工数を記録する。 完了時間、課金トークン数、ツール料金、リトライ、人的レビューや修正時間を測る。テストを反復する。 タスクを複数回実行し、どちらが先に走るかを交互にすることで単一の応答に依存しない。 両モデルが利用可能なら、ワークロード別にルーティングする。Kimi で確実に完了できるタスクは Kimi に送り、Carbon はチームが評価済みのセキュリティ/エンジニアリングの承認ユースケースに限って送る。Kimi で失敗した全リクエストを自動で Carbon に回さない。エスカレーション条件を定義し、リトライ予算を設定し、受理タスク単価の計算にはすべての試行を含める。
Gemini 4 Carbon と Kimi K3.1 Pro はどこで利用できるか
公式プロバイダーのアクセス Google が発表した Carbon のロールアウトは、選定されたサイバー防御担当者と信頼できるパートナーを対象としている。統合を計画する前に、適格性と利用可能なインターフェースを確認すること。Moonshot は Kimi をアプリケーションと API で提供しており、ダウンロード可能なウェイトは別個の展開オプションを提供する(専用ライセンスとインフラ要件あり)。
Kimi については、アカウントで kimi-k3.1-pro が有効になっていること、エンドポイントが必要な入力、推論設定、ツール呼び出し形式をサポートしていることを確認する。本番ワークフローに接続する前に、小さな代表リクエストを実行する。
意図した両ルートが有効になったら、同じ評価セットと受け入れチェックを再利用する。後日のプロバイダーや設定変更が比較を不意に無効化しないよう、各結果に実際のエンドポイントと設定を記録する。
結論 次の一歩は、チームの主要な制約に合わせて選ぶ。締め切りが差し迫っているなら、すでにアカウントで使えるルートでベースラインを構築する。セキュリティ所見や難度の高いエンジニアリングタスクがワークロードの中心なら、アクセス可能になったときに Carbon の試験枠を確保する。パイロットの段階で移行の労力に見合う運用上のメリットが実証されてから、導入範囲を拡大する。